

ClickHouse: архитектура, загрузка и аналитика данных в современных системах - принципы, кейсы, риски и внедрение
Введение: контекст анализа и структура статьи
В условиях растущей потребности организаций в оперативной аналитике и бизнес-интеллекте крупные массивы данных требуют решений, способных сочетать скорость обработки, гибкость моделирования и управляемость операционных нагрузок. ClickHouseпредставляет собой распределённую систему онлайн-аналитической обработки (OLAP), ориентированную на низкую задержку запросов и высокую черезput-емкость при работе с колоночными хранилищами. В современном ИТ-ландшафте этот продукт рассматривается как критическая платформа для анализа потребительского поведения, финансо-экономических показателей, логистических процессов и любых сценариев, где требуется агрессивная агрегация больших объёмов данных в реальном времени.
Структура данной статьи выстроена по принципу «от общего к частному»: от концептуальных основ архитектуры и взаимосвязей подсистем к практическим аспектам загрузки и выборки данных, далее к теоретической базе, интеграциям со смежными технологическими стеками и, наконец, - к практическим кейсам и рискам внедрения. В ходе рассмотрения особое внимание уделено не только «что» делает ClickHouse, но и почемуименно такой подход эффективен в современных сценариях масштабной аналитики.
Известно, что данные для анализа могут поступать из самых разных источников: из финансовых систем, систем учёта и оплаты, логистических платформ, веб- и мобильной аналитики. В качестве иллюстрации можно рассмотреть кейс налоговых данных о вычетах на обучение: данные такого рода приходят в разных форматах, структурируются непоследовательно, требуют выверки и нормализации перед аналитикой. В рамках этой статьи мы приведём общие принципы загрузки и анализа таких наборов данных в ClickHouse, но сосредоточимся на архитектуре, подходах к загрузке и выборке, а также на рисках и практиках внедрения, которые применимы к любым доменам.
Структура статьи после введения позволяет охватить следующие аспекты: декомпозицию компонентов и их взаимодействие, архитектуру и принципы работы, методы загрузки и качество данных, механизмы потоковой и пакетной загрузки, основы запросов и оптимизации, примеры аналитических запросов, теоретическую базу и синергии технологических стеков, кейсы применения и отраслевые направления, риски и ограничения, сравнительный анализ с конкурентами, практические рекомендации по внедрению и заключение. В конце приведён блок «Вопрос-Ответ», суммирующий ключевые тезисы.
Декомпозиция технических компонентов и их взаимодействие в ClickHouse
ClickHouse оперирует несколькими основными слоями, которые образуют конвейер обработки данных - от источников входа до результатов запросов и интеграции с внешними системами. На верхнем уровне выделяют:
- клиентский интерфейс и коммуникации: протоколы TCP/IP, HTTP, gRPC, поддержка SQL-инициализации и отправки запросов;
- вычислительный движок: параллельная обработка, векторизированное исполнение, планирование и исполнение запросов, агрегации и оконные функции;
- система хранения данных и форматы: колоночное хранение, сжатие данных, индексы и механизмы отбора данных;
- подсистемы распределения и согласованности: шардирование, репликация, кластеризация и взаимодействие с сервисами координации (например, ZooKeeper);
- механизмы загрузки данных: вставки через SQL INSERT, файлы форматов CSV/TSV/JSON, форматы Parquet/ORC, конвейеры потоковой загрузки через Kafka и другие источники;
- системы управления метаданными и безопасностью: контроль доступа, аудит, шифрование и политики жизненного цикла данных;
- инструменты интеграции и мониторинга: коннекторы к BI-платформам, ETL/ELT-инструменты, метрики и алерты.
Эти подсистемы взаимодействуют следующим образом: данные поступают из источников в системах-источниках (лог-файлы, базы, очереди сообщений, API), проходят этапы валидации и нормализации на этапе загрузки, сохраняются в виде таблиц на диске в формате колоночного хранилища, затем запускаются запросы пользователей через вычислительный движок, который читает столбцы по требованию, применяет фильтры и агрегации, возвращает результат. Архитектура ClickHouse построена вокруг принципа разделения данных и вычислений: данные хранятся в частях (parts), которые могут мигрировать между узлами кластера, что обеспечивает масштабируемость и устойчивость к сбоям.
Ключевые принципы взаимодействия включают следующие моменты:
- разделение расчётных потоков и хранения данных позволяет масштабировать чтение и запись независимо;
- колоночная форма хранения ускоряет агрегации и сканирование больших диапазонов данных, снижая издержки ввода-вывода;
- использование репликации и распределённых таблиц обеспечивает отказоустойчивость и балансировку нагрузки;
- поддержка потоковой и пакетной загрузки позволяет гибко подбирать режим загрузки под характер данных и задержки;
- продвинутая система индексов и возможностей skip-индексации позволяет пропускать участки данных без необходимости полного чтения.
В контексте корпоративной аналитики это означает возможность проектирования архитектурного стека, где источники данных разграничены по типам нагрузок, а аналитика - по требуемым SLA и уровню точности. Важной характеристикой является способность ClickHouse сочетать высокую пропускную способность с детальной агрегацией и временным анализом, что критично для оперативной аналитики в больших организациях.
Архитектура ClickHouse: ключевые подсистемы и принципы работы
Архитектура ClickHouse опирается на несколько базовых подсистем, каждая из которых выполняет специфические функции в рамках единого процесса обработки запросов. Важнейшие из них:
- движок обработки запросов: парсер SQL, анализатор, планировщик, исполнительный движок и механизм оптимизации;
- хранение данных: семейство движков MergeTree и их предшественники/вариации (ReplicatedMergeTree, Distributed, Memory, Log, Wide и др.), а также индексы и механизмы сжатия;
- индексы и пропуск данных: первичный ключ (ключ сортировки в MergeTree), порядок сортировки, «skip indexes» и другие механизмы ускорения чтения;
- координация и управление кластером: системные таблицы, ZooKeeper (для репликации и координации), конфигурационные файлы;
- конвейеры загрузки и источники данных: вставки SQL, форматы файлов, конвейеры внешних источников (Kafka, RabbitMQ и др.), внешние таблицы;
- механизмы кэширования и планирования: кэш запросов, память для временных таблиц и буферов, распределённые вычисления;
- безопасность и аудит: аутентификация, роли, политики доступа, журналирование действий.

Глубокая концепция системы заключается в том, что данные хранятся в виде столбцов, что обеспечивает эффективное сжатие и быстрый доступ к нужным столбцам. Запросы разбиваются на этапы: чтение нужных столбцов, фильтрацию, агрегацию, сортировку, оконные функции и подготовку итогового вывода. В распределённых конфигурациях узлы кластера могут быть как репликами друг друга, так и работать над разношаренными фрагментами данных, что позволяет достигать горизонтального масштабирования и высокой устойчивости к сбоям оборудования.
С точки зрения жизненного цикла данных в ClickHouse критическими являются решения по репликации и консистентности. Репликация обеспечивает дублирование частей данных между узлами, снижая риск потери данных при выходе из строя узла. Консистентность достигается за счёт координационных протоколов и контроля версии, а также детерминированного поведения при инсертах, что особенно важно для аналитических нагрузок, где задержка консистентности может быть приемлемой по сравнению с необходимостью высокой доступности.
Непременным элементом архитектуры служит интеграция со внешними системами и экосистемами: источники потоков (Kafka, RabbitMQ), хранилища файлов (HDFS, S3), сервисы BI и аналитики (Tableau, Power BI, Superset), orchestrators (Airflow, Dagster) и каталоги данных. Это обеспечивает не только загрузку и агрегацию, но и каталогизацию, контроль качества и управление данными на протяжении всей цепочки их жизни.
Вставка данных в ClickHouse: методы загрузки, форматы и качество данных
Загрузка данных в ClickHouse может осуществляться различными способами в зависимости от характера источника, объёма данных и требуемой задержки. Основные подходы включают:
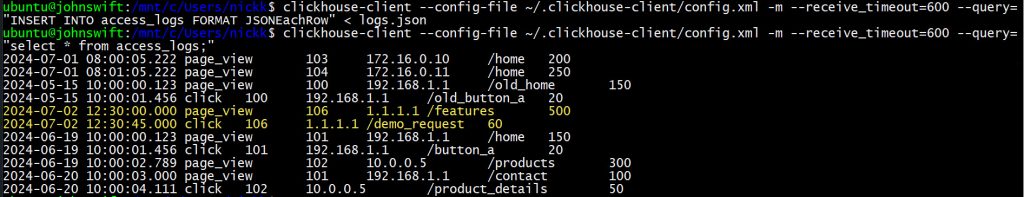
- вставки через SQL: команда INSERT INTO с указанием набора значений или источника;
- пакетная загрузка через форматы файлов: CSV, TSV, JSONEachRow, JSONCompact, Parquet, ORC и др.;
- потоковая загрузка через конвейеры: Kafka, RabbitMQ, MQTT с использованием специальных таблиц-движков (Kafka engine, RabbitMQ engine);
- внешние источники через таблицы-обёртки: URL-таблицы и внешние таблицы для прямого подключения к файлам в облачном хранилище.
Форматы имеют свои компрессионные и парсинговые особенности. Например, Parquet и ORC являются колоночными формами хранения, которые хорошо сочетаются с ClickHouse для импортно-выборочных задач, поскольку позволяют считывать только необходимые столбцы и эффективно сжимать данные. Форматы CSV/TSV удобны для простого импорта из файлов, но требуют дополнительных преобразований и контроля данных.
Качество данных является ключевым аспектом: корректность типов, валидация значений, обработка пропусков, устранение дубликатов при загрузке и согласование схемы. В этой связи следует различать задачи загрузки и задачи подготовки данных. Часто применяются подходы ETL (Extract-Transform-Load) и ELT (Extract-Load-Transform). В ClickHouse ELT широко используется за счёт возможностей быстрого загрузочного ввода и дальнейшей обработки непосредственно внутри базы.
В качестве примера рассмотрим сценарий анализа данных налоговых вычетов на обучение. Источники могут включать платежные ведомости, договоры, справки об оплате и выписки. Для обеспечения скорости аналитики можно:
- сначала загрузить данные в staging-таблицы в формате Parquet, затем выполнить трансформации и нормализацию в целевые таблицы;
- организовать потоковую загрузку через Kafka и создать таблицы-двойники: «сырьё» и «очищенное»;
- применить валидацию типов и проверку целостности ссылок между сущностями (пользователь, договор, учебное заведение);
- использовать MergeTree-движок с сортировкой по даты и идентификатору, чтобы ускорить временные шаги анализа.
Методы контроля качества данных включают:
- проверку соответствия схемы и ожиданий по типам;
- мониторинг доли пропусков и аномалий в значениях;
- обеспечение целостности ссылок между записями;
- тестирование загрузок на малых пайплайнах перед обработкой большого объёма.
Вставка данных: потоковая загрузка и пакетная загрузка; управление производительностью и консистентностью
Потоковая загрузка и пакетная загрузка представляют собой два базовых стиля интеграции в ClickHouse, которые не являются взаимоисключающими, а дополняют друг друга в зависимости от бизнес-случая и SLA. Потоковая загрузка через источники сообщений, такие как Kafka, обеспечивает минимальные задержки и близость к реальному времени, но требует учёта задержек в сетях и потенциальной деградации производительности при пиковых нагрузках. Пакетная загрузка - эффективна для больших объёмов данных, которые можно безопасно обрабатывать пакетами, внедрить в номенклатуру таблиц и выполнить последовательно.
Ключевые аспекты управления производительностью и консистентностью включают:
- настройка лимитов ingress и egress для предотвращения перегрузки узлов;
- подбор параметров для параллелизации загрузки: размер батча, уровень конвейера, количество потоков;
- использование репликации для обеспечения отбора и проверки данных между узлами;
- применение TTL (time to live) и политики удаления устаревших данных, чтобы поддерживать контроль над размером архивов;
- мониторинг задержек загрузки и точности данных в реальном времени, а также трекинг ошибок и повторных попыток;
- обеспечение консистентности на уровне реплик: после вставки новые данные должны быть доступны в репликах спустя минимальные задержки, при этом допускаются малые временные окна, в рамках которых данные еще синхронизируются.
Стратегия внедрения должна учитывать характер данных и требования бизнеса: для критичных к времени задержки аналитических задач применяется потоковая загрузка с минимальным временем от появления данных до их доступности в аналитике; для архива и полноты исторических анализов - пакетная загрузка с последующей агрегацией и архивированием.
Выборка данных в ClickHouse: основы запросов, синтаксис и структура
Основы SQL в ClickHouse остаются знакомыми аналитикам: SELECT, FROM, WHERE, GROUP BY, ORDER BY, LIMIT. Однако практическое применение требует учёта специфики движка:
- поддержка столбцового хранения как основа быстрого сканирования и агрегаций;
- векторизированное выполнение операций чтения и вычислений;
- оптимизация обработки через ранний фильтр (pushdown) и пропуск незначимых данных;
- поддержка функций для обработки временных рядов, строковых операций, работы с массивами и словарями.
Синтаксис ClickHouse продолжает развиваться, но базовые элементы остаются стабильными. Для эффективной аналитики важно понимать, что запросы лучше строить с акцентом на минимизацию чтения столбцов, ограничение количества возвращаемых строк и разумное использование фильтров и агрегаций, а также правильное применение временных функций и оконных функций там, где это требуется.
Понимание структуры таблиц и их схемы позволяет писать запросы, которые используют индексы сортировки и skip-индексы эффективнее. Важна постановка задач: какие столбцы необходимы для анализа, какие временные диапазоны и какие агрегаты. Для сложных аналитических задач полезно создавать денормализованные представления или агрегатные таблицы, которые служат материализованными представлениями статусов и итогов.
Следует отметить, что ClickHouse поддерживает некоторые характерные для OLAP операции, которые облегчают анализ временных рядов и больших популяций записей:
- агрегации по времени (группировки по день/месяц/квартал);
- оконные функции для анализа по ранжированию и переходам между группами;
- функции для работы с датами и временами, а также с типами данных, соответствующими финансовым и операционным данным;
- возможность применения функций-агрегаторов с учётом различных окон и подмножество данных, что позволяет строить комплексные аналитические сценарии.
Выборка данных: фильтры, сортировка, группировки и агрегации
Эффективность выборки во многом определяется правильным использованием фильтров и структуры таблиц. Ключевые принципы включают:
- проектирование схемы на основе типичной рабочей нагрузки: частые запросы должны использовать столбцы, которые чаще всего попадают в WHERE и JOIN-условия;
- использование сортировки в движке MergeTree для ускорения фильтрации и агрегаций. Правильно выбранный порядок сортировки может существенно снизить количество прочитанных данных;
- применение оконных функций там, где требуется итеративный анализ внутри групп, например, для расчета скользящих метрик, ранжирования или кумулятивной суммы;
- использование функций для агрегаций на уровне данных, агрегирования по времени и разложение по группам, что позволяет получить быстрые итоги без необходимости обращения к полному объему данных;
- применение лимитов и смещений (LIMIT/OFFSET), что помогает уменьшить объем возвращаемых данных и ускорить интеракцию с BI-инструментами.
Индексы и механизм пропуска данных играют критическую роль. В ClickHouse индекс по умолчанию связан с ORDER BY, но доступны и другие подходы: skip-индексы, которые позволяют отклонять части данных при выполнении запроса, если условия WHERE позволяют это не читать. Эффективность запросов возрастает, когда фильтры и агрегации применяются к подмножеству столбцов и диапазонов времени, что критично для сценариев анализа больших массивов данных.
В рамках примера анализа налоговых вычетов на обучение, выборка может выглядеть так: агрегирование расходов по годам и регионам, подсчёт среднего размера выплаты, построение временных рядов по видам обучения. Грамотно спроектированная выборка требует предварительного понимания того, какие столбцы и какие временные диапазоны будут критичны для анализа, а также как лучше применить агрегации для получения важных бизнес-метрик.
Выборка данных: индексы, оптимизация чтения и конфигурация кластера
Конфигурация кластера ClickHouse существенно влияет на производительность и устойчивость к нагрузкам. Основные аспекты:
- архитектура кластера: репликация и разделение на шарды для горизонтального масштабирования;
- использование Distributed-таблиц для выполнения запросов по кластерам и равномерного распределения нагрузки;
- выбор движков хранения (MergeTree-variants) и настройка параметров: количество копий, режим репликации, размер блоков чтения;
- настройка параметров чтения: ограничение памяти, размер буферов, лимиты на число одновременных запросов;
- конфигурация сетевых параметров и балансировщиков нагрузки для равномерного распределения запросов;
- мониторинг и алерты по метрикам производительности: задержки, потребление CPU, IO, трафик межузлового обмена.
Чтобы обеспечить эффективную работу системы, следует рассмотреть:
- распределение рабочих нагрузок между узлами и подбор оптимальных конфигураций для обработки пиковой нагрузки;
- настройку TTL и политики обновления в репликах, чтобы исключать устаревшие данные;
- стратегию архивации и удаления устаревших данных без нарушения аналитической доступности.
В контексте налогового анализа эти принципы помогают обеспечить доступность агрегированной информации по всем субъектам и регионам в нужные сроки, сохраняя корректность и управляемость данных.
Первые аналитические запросы в ClickHouse: примеры и интерпретация
Первые аналитические запросы в ClickHouse должны показывать принципы работы и типичные техники построения:
- примеры агрегаций по времени и группировок по ключам, например по месяцам и регионам;
- использование оконных функций для расчета скользящих метрик и накопительных сумм;
- базовые аналитические паттерны: подсчет мегабайтной агрегации, расчеты среднего значения и процентных долей;
- примеры трансформаций временных рядов, таких как изменение интенсивности событий во времени и сезонные паттерны.
Рассмотрим иллюстративный запрос: получить количество сделок и сумму выплат по годам и видам обучения. Такой запрос иллюстрирует сочетание группировок по времени и по категоризированным атрибутам. Продвинутый пример: расчёт кумулятивной суммы выплат по каждому году с использованием оконной функции, что позволяет анализировать динамику изменений. В этих примерах важно учитывать, что ClickHouse выполняет операции на стобцах, а не на строках, поэтому грамотная структуризация данных и выбор форматов позволяют сократить задержку и увеличить скорость вывода.
Первые аналитические запросы: агрегации, оконные функции и анализ времени
В рамках первых аналитических запросов следует рассмотреть:
- агрегации по периодам времени: год, квартал, месяц, недели и дни. Это позволяет быстро увидеть тренды и сезонные эффекты;
- оконные функции: ROW_NUMBER, RANK, и другие, которые применяются для анализа по группам и временным окнами;
- анализ времени: вычисление временных дельт, задержек между событиями, интервалы активности, интерполяции и сезонные деформации;
Эти техники позволяют переходить от простого суммирования к более глубокой интерпретации данных, что особенно важно в бизнес-аналитике, где смысл между строк и его временной контекст критичны.
Пояснительно: оконные функции в ClickHouse позволяют работать не только с агрегатами, но и с порядком внутри групп, что расширяет возможности анализа во времени и по сегментам. Для целей руководства архитектурой данных это означает возможность быстро строить аналитические паттерны без необходимости перемещать данные в отдельные внешние хранилища или выполнять сложные ausschreibungen.
Теоретическая база и объяснение основ
С точки зрения теории данных и систем обработки информации базовые принципы ClickHouse можно свести к нескольким ключевым концепциям:
- колоночная организация хранения и векторизированное выполнение: минимизация ввода-вывода, эффективная компрессия и ускорение сканирования;
- разделение данных и вычислений: горизонтальное масштабирование достигается за счёт шардинга и репликации, что обеспечивает доступность и производительность;
- временные и аналитические требования: поддержка функций и возможностей, ориентированных на анализ больших объемов данных в реальном времени;
- баланс между консистентностью и задержкой: для аналитических нагрузок часто допустима легкая задержка обновления реплик, если это обеспечивает устойчивость и масштабируемость;
- интеграция в экосистему: ClickHouse как часть конвейера данных, подключаемого к источникам, хранилищам и BI-инструментам.
Эти принципы закрепляются через практику моделирования данных, проектирование схем и подготовку инфраструктуры под конкретные бизнес‑задачи. В частности, для налоговых кейсов, как и в любых доменах с чувствительными данными, крайне важно обеспечить корректную обработку данных, соответствие регуляторным требованиям и прозрачность процессов анализа.
Интеграция технологических стеков и их синергия
ClickHouse не существует в изоляции: он интегрируется в полноценную экосистему данных, где важны:
- источники данных и конвейеры: файлы, базы данных, очереди сообщений, облачные хранилища;
- обработка и трансформации: ETL/ELT-пайплайны, чистка и нормализация, связь с бизнес-логикой и обработкой ошибок;
- каталоги и метаданные: управление схемами, версиями, lineage данных, соответствие требованиям аудита;
- BI и визуализация: подключение к Tableau, Power BI, Apache Superset и другим инструментам;
- оркестрация задач: планирование загрузок, обновление материализованных представлений, мониторинг и алертинг;
- безопасность и соответствие: аутентификация, авторизация, аудит доступа к данным, шифрование в покое и в транзите.
Синергия технологий достигается за счёт единого языка данных и согласованных контрактов на уровне схемы, форматов и контрактов доступа. В частности, для анализа налоговых вычетов можно организовать цепочку: источники данных - SQL-INSERT/пакетная загрузка - распределённые таблицы - агрегации и прозрачно-наглядные представления - BI-дашборды. Это обеспечивает единый источник истины и ускоряет принятие решений на уровне бизнеса.
Кейсы применения в реальных сценариях
Кейсы применения ClickHouse охватывают широкий диапазон отраслей и задач:
- финансовый анализ и риск-менеджмент: быстрое вычисление агрегаций по транзакциям, детерминированные меры безопасности и аудит;
- онлайн-ритейл: анализ поведения пользователей, сегментация, сезонные тренды и прогнозирование спроса;
- телекоммуникации: обработка логов, мониторинг качества связи, детальная диагностика проблем;
- производство и логистика: анализ временных рядов, оптимизация цепочек поставок и управление запасами;
- государственный сектор и налоговый учёт: анализ социально-экономических показателей и обеспечение прозрачности данных.
Каждый кейс требует планирования архитектуры и загрузочных пайплайнов под уникальные требования к задержке, точности и безопасности. В рамках налоговых кейсов это может включать хранение справок об оплате, договоров и данных о выплатах, декомпозицию по видам обучения и регионам, а также построение временных рядов и отчётности для регулятора.
Возможности применения в различных экономических секторах
- банки и финтех: аналитика транзакций, риск-моделирование, мониторинг мошенничества;
- ритейл и e-commerce: поведение покупателей, конверсия, сегментация и маркетинговая аналитика;
- промышленность и логистика: мониторинг производственных процессов, анализ цепочек поставок, оптимизация маршрутов;
- образование и государственные службы: анализ эффективности программ, учет финансирования и прозрачность распределения средств;
- телеком: обработка больших объемов логов, анализ пользовательских сценариев и сетевых паттернов.
Эти отраслевые сценарии обуславливают требования к архитектуре: скорости загрузки, глубокую агрегацию по временным диапазонам, гибкое моделирование данных и устойчивость к пиковым нагрузкам.
Анализ рисков, уязвимостей и ограничений с метриками эффективности
Любая внедряемая платформа сталкивается с рисками и ограничениями. В контексте ClickHouse ключевыми являются:
- стоимость инфраструктуры при больших кластерах: диск, сеть, вычислительные ресурсы;
- задержки репликации и консистентность в условиях сбоев;
- сложность планирования схем и поля совместимости между системами;
- риски загрузки данных из разных источников и качество данных;
- ограничения по поддержке некоторых видов оконных функций и сложных моделей внутри движка.
Метрики эффективности включают:
- время отклика на запросы, таргет SLA и уровень обслуживания (uptime);
- пропускная способность (queries per second, rows per second) и нагрузка на CPU/IO;
- доля пропусков и ошибок загрузки, время восстановления после сбоев;
- точность агрегаций и консистентность данных между репликами;
- стоимость владения и окупаемость внедрения.
План управления рисками должен включать превентивное тестирование, мониторинг в реальном времени и регуляторное соответствие, особенно в секторах с требованиями к аудиту и безопасности данных.
Конкурентный анализ конкурирующих решений и их дифференциация
На рынке OLAP-решений ClickHouse конкурирует с такими системами, как Apache Druid, Apache Pinot и облачными платформами Snowflake, Google BigQuery и другими. Ключевые дифференциаторы ClickHouse включают:
- высокая производительность агрегаций на больших объёмах данных за счёт колоночной архитектуры и векторизированного выполнения;
- гибкость в плане инфраструктурной конфигурации: собственный кластер на физических серверах, виртуальных машинах или в облаке, а также поддержка репликации и реплик;
- эффективная работа с потоками данных, включая интеграцию с Kafka и другими конвейерами;
- открытое сообщество и широкие возможности для адаптации под внутренние процессы, включая создание собственных движков и таблиц;
- баланс между Cost of Ownership (стоимость владения) и производительностью для широкого спектра задач.
С другой стороны, конкуренты могут предлагать более развитые функциональные возможности управления данными в рамках единой облачной экосистемы, интеграционные возможности с другими сервисами или особые оптимизации под конкретные сценарии. Поэтому выбор платформы следует делать исходя из требований бизнес‑процесса, технических ограничений и бюджета, а также учитывая перспективы масштабирования и развития архитектуры данных внутри организации.
Практические рекомендации по внедрению
- сформулируйте бизнес-задачи и определите SLA по задержке и точности;
- проведите детальный дизайн данных: схемы, типы данных, ключи сортировки, индексы, требования к архивированию и TTL;
- спланируйте архитектуру кластера: количество узлов, репликацию и шардинг, расположение кластера и сетевых сегментов;
- организуйте пайплайны загрузки данных с учётом характерных источников (batch vs streaming);
- настройте мониторинг и алерты по ключевым метрикам: задержки, пропускная способность, нагрузка на узлы;
- внедрите тестовые планы: нагрузочные тестирования, регрессионные тесты на консистентность, контроль качества данных;
- отделяйте рабочие нагрузки: выделяйте отдельные кластеры или виртуальные ресурсы для ETL, аналитики и BI-платформы;
- разработайте политику доступа, журналирования и аудита, чтобы обеспечить соответствие требованиям;
- планируйте миграции и миграции схем, чтобы уменьшить риск нарушения работы;
- продумайте стратегию резервного копирования и восстановления данных.
Заключение
ClickHouse представляет собой мощную платформу для анализа больших данных в реальном времени. Его архитектура, основанная на колоночном хранении, репликации и распределённой обработке, обеспечивает высокую производительность при больших объёмах информации. В контексте современных корпоративных требований к аналитике и цифровой трансформации ClickHouse может стать ядром решений для бизнес-аналитики, финансового анализа, операционных мониторингов и многих других сценариев. Важными аспектами успешного внедрения являются грамотное проектирование схем данных, продуманная архитектура кластера, эффективные пайплайны загрузки и продуманная интеграция со стековыми технологиями. При этом необходимо помнить о рисках, связанных с инфраструктурой, качеством данных и безопасностью, и заранее готовить планы реагирования и повышения устойчивости системы.
Вопрос-Ответ:
-
Вопрос: Какие ключевые подсистемы формируют архитектуру ClickHouse и как они взаимодействуют?
Ответ: Основу составляют движок обработки запросов, система хранения данных на базе MergeTree и его вариантов, механизм репликации и координации кластера, а также конвейеры загрузки и источники данных. Взаимодействие реализуется через обработку запросов клиента, чтение нужных столбцов с использованием сортировки и индексов, векторизированное выполнение и агрегирование, а затем возврат результатов. Репликация обеспечивает отказоустойчивость и масштабирование чтения, координация - согласованность и управление кластером, загрузчики - инпут данных и потоковую загрузку. -
Вопрос: Какие форматы данных лучше использовать для загрузки в ClickHouse?
Ответ: Для крупных объёмов чаще выбирают Parquet или ORC, поскольку это колоночные форматы с эффективной компрессией и поддержкой столбцового считывания. Для быстрого импорта и простоты интеграции подходят CSV/TSV и JSONEachRow. В зависимости от задачи можно комбинировать пакетную загрузку через Parquet/ORC и потоковую загрузку через Kafka с последующей трансформацией. -
Вопрос: Как обеспечить консистентность данных в репликах ClickHouse?
Ответ: Консистентность достигается через репликацию и координацию кластера, а также правильное проектирование схем и режимов выполнения. Время обновления реплик может включать небольшие задержки, но обеспечивается детерминированное поведение и согласованность после синхронизации. Важно мониторить задержки репликации и включать этапы в тестовые планы. -
Вопрос: Какие техники ускоряют выполнение аналитических запросов в ClickHouse?
Ответ: Эффективная сортировка данных (ORDER BY), использование skip-индексов, минимизация чтения столбцов, применение агрегаций и оконных функций, а также распределение нагрузки через Distributed-таблицы и шардирование. Правильная архитектура схемы и выбор форматов данных существенно влияют на скорость выполнения. -
Вопрос: Какие риски характерны для внедрения ClickHouse и как их минимизировать?
Ответ: Основные риски - инфраструктурные затраты, задержки репликации, сложности миграции данных, проблемы с качеством данных и безопасностью. Их минимизируют через продуманное проектирование архитектуры, пилотные запуски, мониторинг, регламент по миграциям и политикам доступа, а также через архитектуру с разделением рабочих нагрузок и резервными копиями. -
Вопрос: Как ClickHouse сравнивается с конкурентами и в чём его преимущество?
Ответ: ClickHouse отличается высокой скоростью обработки больших объёмов данных за счёт колоночного хранения и векторизированного исполнения, гибкостью развертывания, поддержкой потоковой загрузки и интеграций с экосистемой. Конкуренты могут предлагать другие преимущества в области управляемости, интеграций в облачную экосистему или уникальные функции, однако ClickHouse часто выигрывает по ценовой эффективности и скорости анализа на больших данных.


