

От MySQL к Greenplum: уроки и выводы, сделанные в процессе миграции от одной БД к другой
Переход от одной системы баз данных к другой – задача непростая, но это результат этого процесса дает организациям возможность использовать все мощь современных платформ данных. Совсем недавно мне посчастливилось принять участие в проекте по переходу с MySQL на Greenplum, безусловно этот процесс подразумевал ряд трудностей. В этой статье мы поговорим о подводных камнях и сложностях, которых можно избежать при переходе с MySQL (версия 5.7) на Greenplum (PostgreSQL 9.4). Мы рассмотрим ключевые моменты и инсайты, полученные в процессе выполнения данной задачи. По сути, данная статья – это подробная инструкция по обеспечению плавного и успешного процесса миграции с одной БД к другой.
Итак, приступим.
Урок 1: Влияние команд DDL на зависимости Greenplum
Трудность: В MySQL переименование какой-либо таблицы не приводит к изменению имени таблицы в представлениях, использующих эту таблицу. Однако в Greenplum, если Вы переименуете таблицу, все соответствующие представления также будут отражать обновленное имя таблицы. Это означает, что если Вам нужно создать новую таблицу с тем же именем, что и раньше, но с другой структурой, Вам придется либо сбросить текущее представление, либо использовать оператор CREATE или REPLACE VIEW для создания нового представления, использующего таблицу с новой структурой.
Причина разного подхода заключается в том, как каждая база данных поддерживает целостность структуры базы данных и управляет зависимостями между таблицами и представлениями. MySQL управляет зависимостями и представлениями более гибко, поскольку рассматривает представления и связанные с ними таблицы как отдельные сущности. Greenplum автоматически обновляет изменения в названиях таблиц в представлениях для поддержания согласованности данных, что позволяет избежать возможных проблем с тем, что представления становятся недействительными при обращении к несуществующим таблицам.
То же самое происходит и тогда, когда Вам нужно удалить таблицу. В MySQL удаление таблицы таблицы не зависит от представлений, связанных с этой таблицей. В Greenplum Вы не сможете удалить таблицу, пока в ней есть зависимые представления. Вам придется сначала удалить представления и только потом удалить таблицу для того чтобы обеспечить корректное удаление.

Урок 2: Обработка агрегированных запросов: MySQL vs Greenplum
Трудность: MySQL позволяет группировать данные без явного включения всех неагрегированных столбцов. Greenplum требует, чтобы все неагрегированные столбцы были включены в предложение GROUP BY. Если запрос неправильно структурирован, есть вероятность возникновения ошибок в Greenplum.
Предположим, у нас есть таблица Sales, содержащая данные о продаже трех различных товаров:
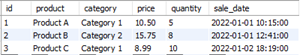
Описание каждого столбца:
- id: уникальный идентификатор каждой строчки
- product: наименование продукта
- category: категория, к которой принадлежит каждый продукт
- price: цена за единицу товара
- quantity: количества проданного товара.
- sale_date : дата и время транзакции
Предположим, мы хотим вычислить общую выручку от продаж каждого продукта.
В Greenplum мы можем сделать это при помощи следующей команды:
SELECT product,
SUM(price * quantity) AS total_revenue
FROM sales
GROUP BY product;
Приведенный выше запрос не только дает ожидаемый результат, но и является логически правильным.
В MySQL есть режим несоответстивя, который, позволяет включать в оператор SELECT столбцы, не являющиеся частью предложения GROUP BY или агрегатной функции. Например:
SELECT product, category, SUM(price * quantity) AS total_revenue
FROM sales
GROUP BY product;
В MySQL этот запрос выполнится без ошибок и также даст нужный нам результат, но столбец «category», который не является частью предложения GROUP BY, не всегда будет представлять правильную категорию для того или иного продукта. Добавление дополнительных записей в таблицу из всех категорий для каждого продукта приведет к тому, что столбец «category» будет содержать случайное название категории для каждого продукта.
Если мы попытаемся написать запрос, используя ту же логику в Greenplum, мы увидим следующее сообщение:

Причина заключается в том, что мы не можем группировать аналогичным образом в Greenplum. Пользователь обязан следовать практике SQL-совместимости и использовать все неагрегированные столбцы из запроса в предложении GROUP BY.
Урок 3: Навигация по различиям в функциональности: отсутствие схожих функций между MySQL и Greenplum
Трудность: стандартные функции MySQL, к сожалению, недоступны в Greenplum. Например, очень распространенной функцией, которая постоянно используется в MySQL, является DATEDIFF(date1, date2), которая возвращает количество дней между двумя значениями даты. Оказалось, что в Greenplum аналогичной функции нет.
Возможным решением может стать создание собственных пользовательских функций с логикой, лежащей в основе встроенной функции MySQL, которую мы упомянулиранее. Вот пример пользовательской функции для функции DATEDIFF() в Greenplum:
CREATE OR REPLACE FUNCTION my_schema.datediff($1 timestamp,$2 timestamp)
RETURNS int4
LANGUAGE sql
VOLATILE
AS $$
SELECT CAST($1 AS date) - CAST($2 AS date) as DateDifference
$$
EXECUTE ON ANY;
Урок 4: Определение ролей для новых таблиц
Трудность: допустим, у нас есть пользователь A и пользователь B. В MySQL, пока оба пользователя имеют доступ к определенной схеме, они могут получить доступ и к таблицам, созданным другими пользователем. ВGreenplumDB, если пользователь A создает таблицу, ему необходимо назначить права CRUD для имени пользователя USER B, чтобы тот получил доступ к таблицам.
Причина заключается в том, что Greenplum следует принципу наименьших привилегий, когда она не назначает автоматически другим пользователям права CRUD (Create, Read, Update, Delete) для таблицы, созданной конкретным пользователем. Такой подход обеспечивает более жесткий контроль над доступом к данным и безопасность данных. В отличие от этого, когда пользователь создает таблицу в MySQL, по умолчанию все остальные пользователи имеют доступ к этой таблице. Это происходит потому, что MySQL по умолчанию предоставляет необходимые привилегии всем аутентифицированным пользователям.
Урок 5: Упрощенная фильтрация / дедупликация в Greenplum: Использование оконных функций для эффективной очистки данных
Хотя с момента появления оконных функций в MySQL прошло уже пять лет, если Вы хотите перейти с версии MySQL 5.7 или предыдущих версий, Вы увидите что такие этапы очистки данных, как дедупликация, могут быть легко выполнены с помощью методологии row_number в нескольких строках кода в Greenplum по сравнению с ручными методами в MySQL.
Давайте рассмотрим конкретный пример, обратившись к таблице Sales (на этот раз с большим количеством записей):
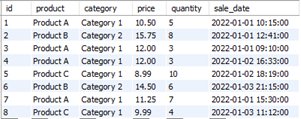
Просматривая данные, мы видим, что 01-01-2022 продукт A был продан несколько раз. Допустим, мы хотим просмотреть только последнюю продажу для каждого продукта на определенную дату. В MySQL нам придется реализовать технику номеров строк вручную с помощью определенных пользователем переменных:
-- Step 1: Initialize variables
SET @rown := 0, @rk1 := '', @rk2 :='';

-- Step 2: Create a temporary table to store deduplicated data
DROP TEMPORARY TABLE IF EXISTS my_schema.dedup_data;
CREATE TEMPORARY TABLE IF NOT EXISTS my_schema.dedup_data
SELECT *,
       @rown := CASE WHEN @rk1 = product AND @rk2 = DATE(sale_date) THEN @rown + 1 ELSE 1 END AS rownum,
       @rk1 := product AS dummy_rn1,
       @rk2 := sale_date AS dummy_rn2
FROM my_schema.sales
ORDER BY product, sale_date DESC;

-- Step 3: Cleanup table with irrelevant columns and records
DELETE FROM dedup_data
WHERE rownum > 1;

ALTER TABLE my_schema.dedup_data
DROP COLUMN dummy_rk1,
DROP COLUMN dummy_rk2;

-- Step 4: Finally Selecting the deduplicated data
SELECT *
FROM my_schema.dedup_data;
В отличие от этого, в Greenplum тот же процесс задействует несколько строк кода с использованием оконной функции ROW_NUMBER():
CREATE TEMPORARY TABLE IF NOT EXISTS gp_dedup_data AS (
    WITH cte_data AS (
        SELECT *,
        ROW_NUMBER() OVER (PARTITION BY product, DATE(sale_date) ORDER BY sale_date DESC) AS rn
        FROM sales
    )
    SELECT *
    FROM cte_data
    WHERE rn = 1
);

SELECT *
FROM gp_dedup_data;
Урок 6: Скрытые нюансы: преобразования времени в MySQL и Greenplum
В MySQL столбец datetime может непреднамеренно получить фиктивную дату при вставке в него значения, относящегося только ко времени. Это приводит к тому, что значение будет ассоциироваться со строкой даты по умолчанию - «01-01- 1970».
В Greenplum загрузка таких данных не допускает неявного преобразования, поскольку принудительно проверяется достоверность значения datetime.
Для того, чтобы справиться с данной задачей, можно воспользоваться конкатенацией фиктивной даты со значением времени и использовать функцию Greenplum to_timestamp(), необходимую для преобразования конкатенированной строки в действительное значение времени.
В процессе миграции из одной базы данных к другой крайне важно обратить внимание на все особенности, перечисленные выше.


