

Как ускорить процесс аналитики данных с помощью Greenplum и dbt
Подробное руководство, созданное для того, чтобы помочь Вам создать и развернуть свой первый проект dbt на базе хранилища данных Greenplum.
Dbt (Data Build Tool) — это инструмент трансформации данных в конвейере ELT, позволяющий командам преобразовывать данные, используя лучшие практики программной инженерии. Благодаря встроенной поддержке подключения ко многим хранилищам данных dbt выполняет SQL-запросы к платформам данных, а также к хранилищам данных, позволяя материализовать данные в виде таблиц и представлений.
Данный инструмент используется для написания модульного и централизованного кода хранилища данных, позволяя командам совместно работать над моделями данных, версионировать их, тестировать и документировать запросы, до того, как модели будут развернуты в производственной среде.
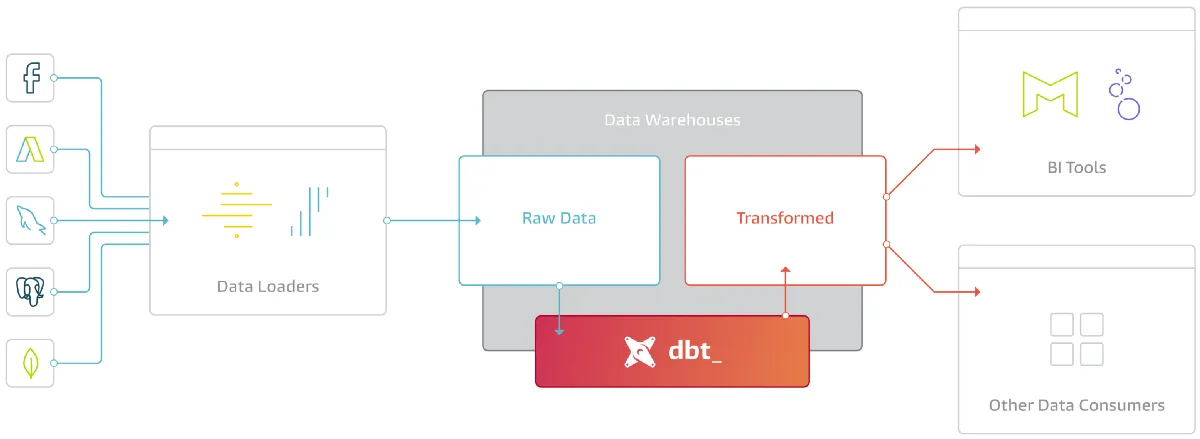
В этой статье мы рассмотрим, как тандем Greenplum и dbt может обеспечить надежную и эффективную работу с Big Data и c с легкостью трансформировать их благодаря адаптеру dbt-greenplum, созданному сообществом Greenplum.
Что такое хранилище данных Greenplum?
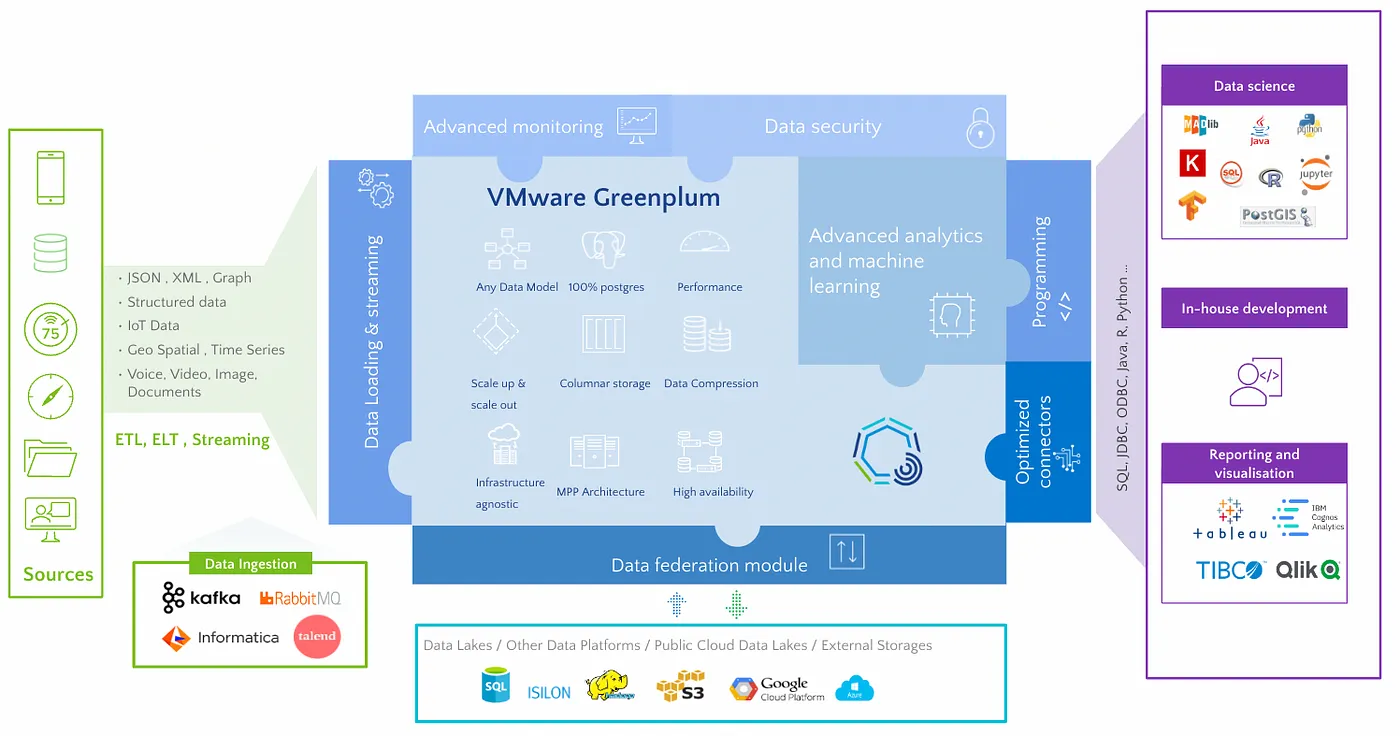
Greenplum - это передовое MPP-хранилище данных с открытым исходным кодом на базе PostgreSQL. Оно обеспечивает мощную и высокоэффективную аналитику Big Data.
В Greenplum используется самый передовой в мире оптимизатор запросов обеспечивающий высокую производительность выполнения аналитических запросов к Big Data.
Более подробная информация доступна по ссылке.
Ключевые характеристики Greenplum:
- Возможность развертывания в публичном или частном облаке, а также опция локального развертывания;
- Аналитика данных: от BI до ИИ;
- Простата при работе с потоковыми данными и корпоративным ETL;
- Гарантия целостности данных;
- Лучшие в отрасли показатели производительности;
- Обработка данных, исчисляемых петабайтами;
- Основан на проектах с открытым исходным кодом, таких как PostgreSQL, позволяющих интеграцию с популярными инструментами;
- Массивно-параллельная архитектура
- Поставляется с библиотеками, позволяющими обрабатывать геопространственные данные, текст, ML, графы, временные ряды и ИИ;
- Параллельный доступ к данным с высокой пропускной способностью и обработка запросов к различным источникам данных - от объектных хранилищ, таких как AWS S3, GCS и Azure Blob Storage, до внешних баз данных, таких как PostgreSQL, SQL Server и Oracle.
dbt + Greenplum
Использование Greenplum и dbt в комплексе позволяет организациям сосредоточиться на данных, не заботясь при этом о настройке производительности, распределении ресурсов, тестировании, управлении изменениями, составлении документации и т.д.
Поскольку Greenplum - это хранилище данных на базе PostgreSQL, клиенты могут использовать адаптер dbt-postgres, разработанный и поддерживаемый компанией dbt Labs. Также доступен адаптер dbt-greenplum: https://docs.getdbt.com/reference/warehouse-setups/greenplum-setup.
Именно он предоставляет доступ к одному из мощнейших хранилищ данных. Его достаточно легко настроить – поверьте, подключение к Greenplum еще никогда не было таким простым, в том числе благодаря большому количеству настроек, установленных по умолчанию.
Благодаря совмещению данных продуктов можно использовать все преимущества мощного хранилища данных. Его очень легко настроить - подключение к Greenplum еще никогда не было таким простым.

Итак, не будем медлить и приступим к работе:
Шаг 1: Настройка среды
Установка dbt-greenplum:
-
В первую очередь мы должны создать новое окружение Python, а затем установить dbt-greenplum с помощью pip3 - это самый простой способ установки адаптера. Установка dbt-greenplum потребует установки dbt-core, а также других зависимостей.
$ python3 -m venv dbt-env
$ source dbt-env/bin/activate
$ pip install dbt-greenplum
- Теперь Вы можете проверить, правильно ли Вы все сделали, запустив команду dbt - version.
$ dbt --version
Core:
  - installed: 1.2.0
  - latest:    1.4.1 - Update available!

  Your version of dbt-core is out of date!
  You can find instructions for upgrading here:
  https://docs.getdbt.com/docs/installation

Plugins:
  - postgres:  1.2.0 - Update available!
  - greenplum: 1.2.0 - Up to date!

  At least one plugin is out of date or incompatible with dbt-core.
  You can find instructions for upgrading here:
  https://docs.getdbt.com/docs/installation
- Запустите проект greenplum_demo с помощью команды init:
$ dbt init greenplum_demo
$ cd greenplum_demo
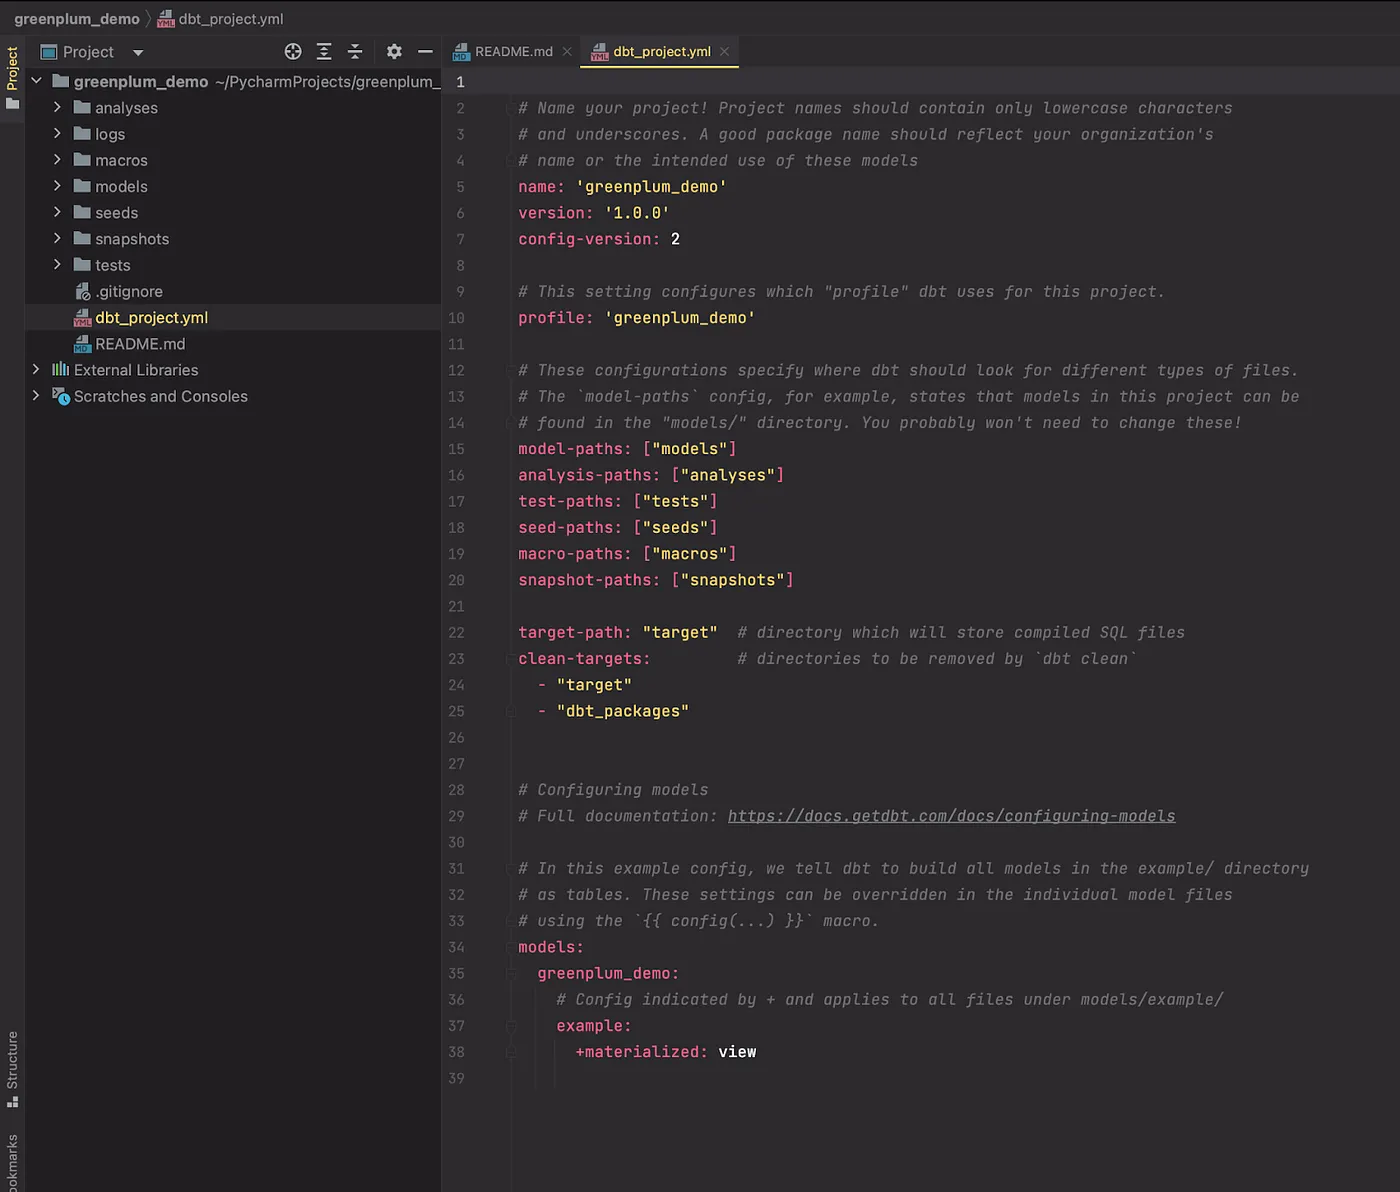
- В результате Вы увидите проект dbt, имеющий следующую структуру:
Подключение к конфигурации Greenplum:
На этом шаге мы настроим соединение между dbt и Greenplum с помощью профайла и YAML-файла, содержащего все деталями соединения с хранилищем данных Greenplum.
- Создайте файл в каталоге ~/.dbt/ и назовите его profiles.yml
$ vi ~/.dbt/profile.yml
- Скопируйте следующие строки и вставьте их в файл profiles.yml.
greenplum_demo:
  target: dev
  outputs:
    dev:
      type: greenplum
      host: [hostname]
      user: [username]
      password: [password]
      port: [port]
      database: [database name]
      schema: [dbt schema]
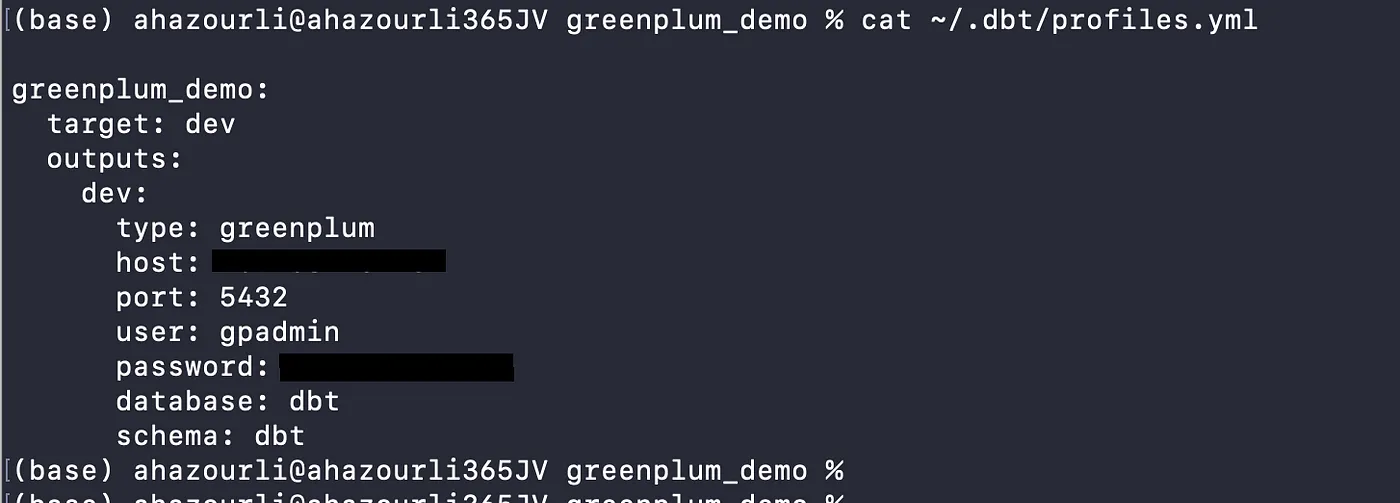
Файл профиля, используемого в данной статье:
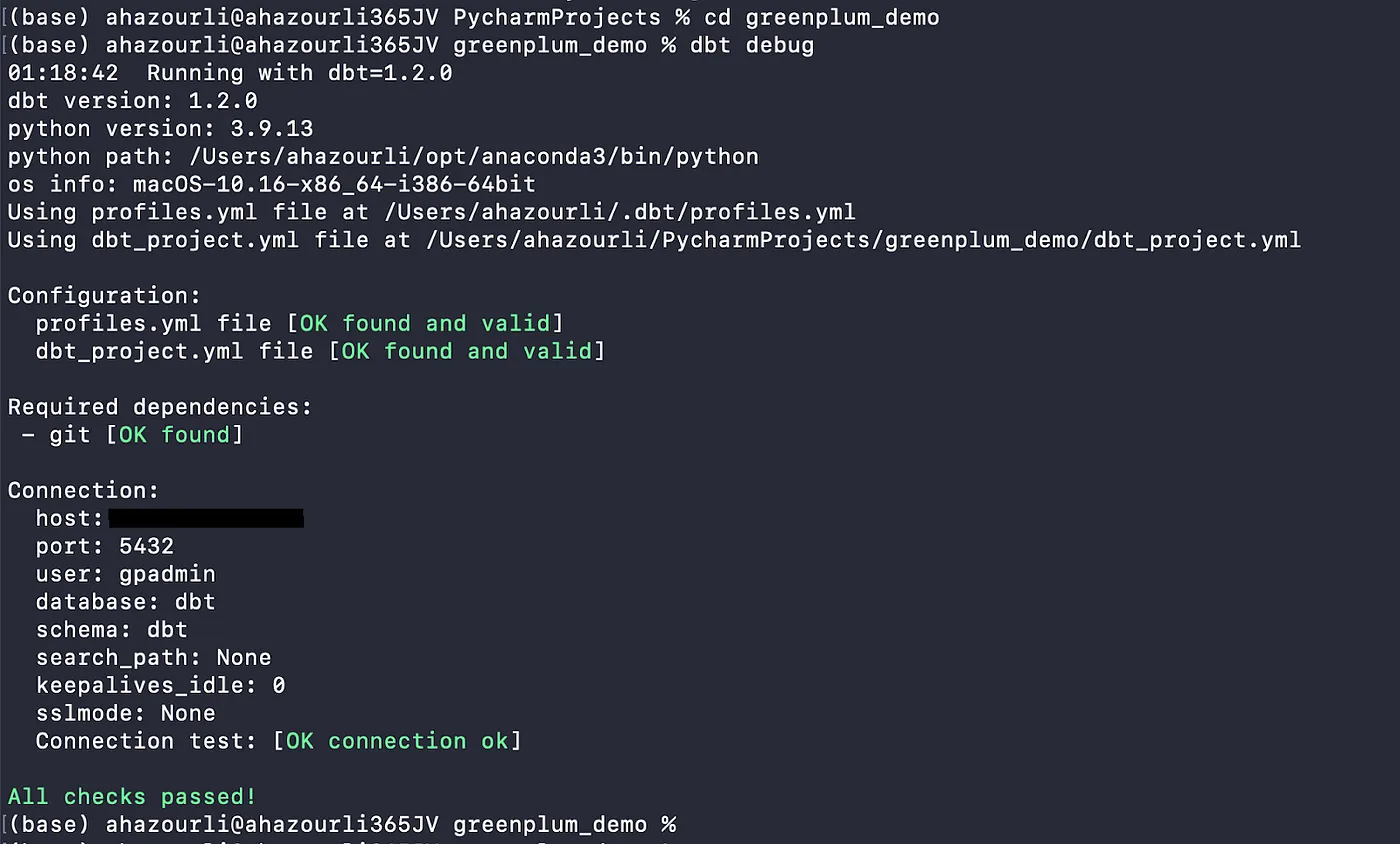
- Запустите команду debug для того, чтобы убедиться в том, что Вы можете установить подключение:
$ dbt debug
Шаг 2: Запуск dbt
В проекте dbt есть несколько примеров моделей. Для того, чтобы убедиться в том, что все в порядке, проверим, можно ли запустить эти модели.
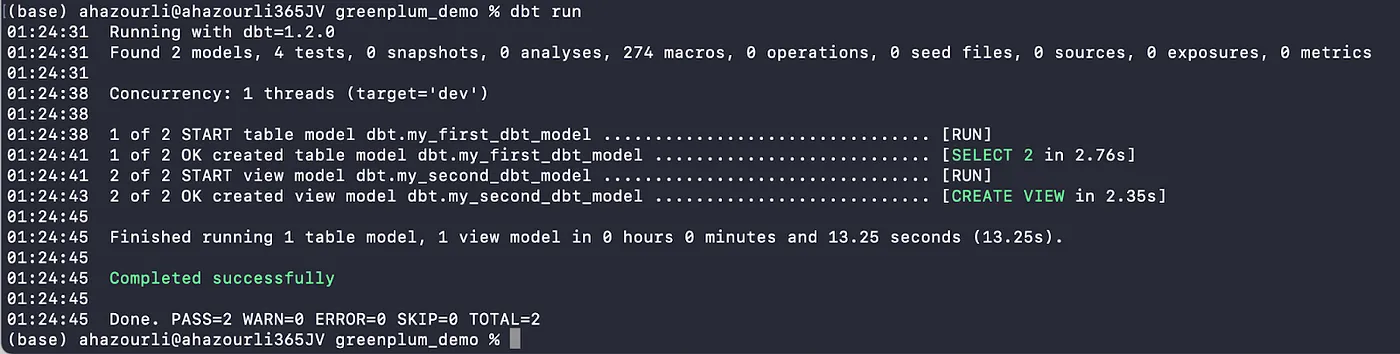
- Введите команду run:
$ dbt run
Если результат будет выглядеть следующим образом, это просто идеально!
Шаг 3: Построение dbt-greenplum моделей:
Адаптер dbt-greenplum поможет пользователям оптимизировать работу с таблицами. Пользователи могут выбрать подходящую им модель хранения (ориентированную на столбцы или строки, оптимизированную для таблиц с приложениями и т.д.), распределение, разделение и стратегию сжатия данных.
Настало время построить модель dbt-greenplum с более продвинутыми настройками!
- Откройте свой проект в предпочитаемом Вами редакторе кода и создайте первую модель dbt;
- Создайте два SQL-файла - classic_dbt_model.sql и greenplum_dbt_model.sql, в каталоге моделей.
Для того, чтобы создать большую таблицу, которая будет содержать около 265 миллионов строк (!), используем функции Greenplum, такие как generate_series и random.
SELECT time, device_id, random()*100 as cpu_usage
   FROM generate_series(
     now() - INTERVAL '6 months',
      now(),
      INTERVAL '1 minute'
     ) as time,
   generate_series(1,1000) device_id;
Создайте файл models/classic_dbt_model.sql и вставьте в него следующий код:
{{ config(materialized='table') }}

with source_data as (

  SELECT time, device_id, random()*100 as cpu_usage
  FROM generate_series(
    now() - INTERVAL '6 months',
     now(),
     INTERVAL '1 minute'
    ) as time,
  generate_series(1,1000) device_id

)
select *
from source_data
Эта модель создаст случайно распределенную таблицу Greenplum без расширенных функций.
Затем создайте еще один файл - models/greenplum_dbt_model.sql и вставьте в него следующий код:
{% set fields_string %}
    time timestamp NULL,
    device_id int null,
    cpu_usage double precision
{% endset %}

{% set raw_partition %}
   PARTITION BY RANGE (time)
   (
       START ('2022-06-01'::timestamp) INCLUSIVE
       END ('2024-01-01'::timestamp) EXCLUSIVE
       EVERY (INTERVAL '1 day'),
       DEFAULT PARTITION extra
   );
{% endset %}

{{
   config(
       materialized='table',
       distributed_by='device_id',
       appendonly='true',
       orientation='column',
       compresstype='ZLIB',
       compresslevel=3,
       fields_string=fields_string,
       raw_partition=raw_partition,
       default_partition_name='other_data'
   )
}}

with source_data as (

   SELECT time, device_id, random()*100 as cpu_usage
   FROM generate_series(
     now() - INTERVAL '6 months',
      now(),
      INTERVAL '1 minute'
     ) as time,
   generate_series(1,1000) device_id

)
select *
from source_data
Эта модель создаст таблицу Greenplum, ориентированную на столбцы и оптимизированную для приложений. Она будет разбита на столбцы по времени с ежедневным интервалом, что значительно упрощает управление данными и выполнение запросов. Также в ней будет использоваться алгоритм ZLIB с уровнем сжатия = 3.
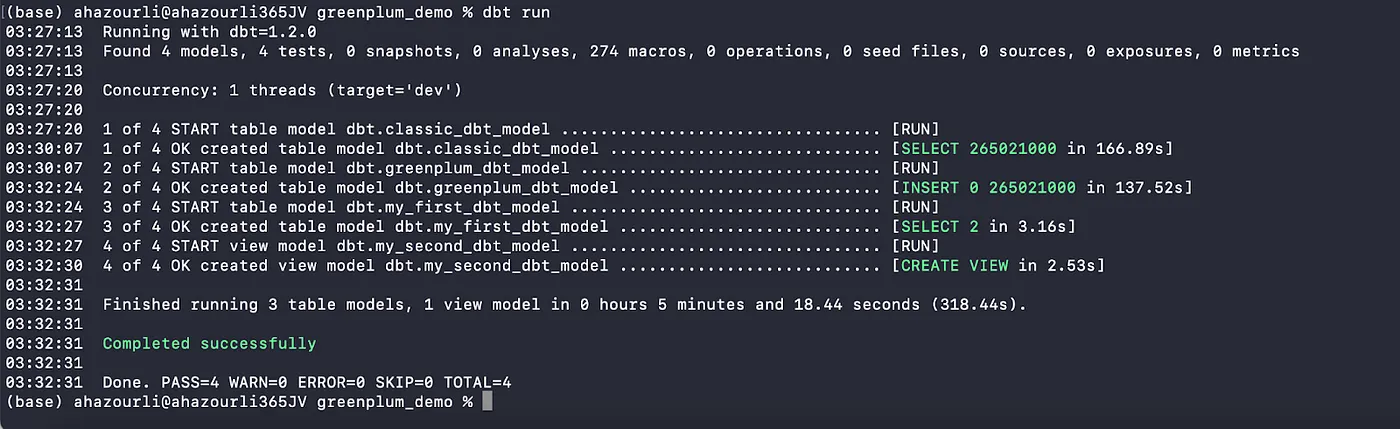
- Запустим модели dbt:
$ dbt run
4. Чтобы увидеть сгенерированный dbt SQL, который был запущен на Greenplum, перейдите в каталог /target/run:
- classic_dbt_model.sql:
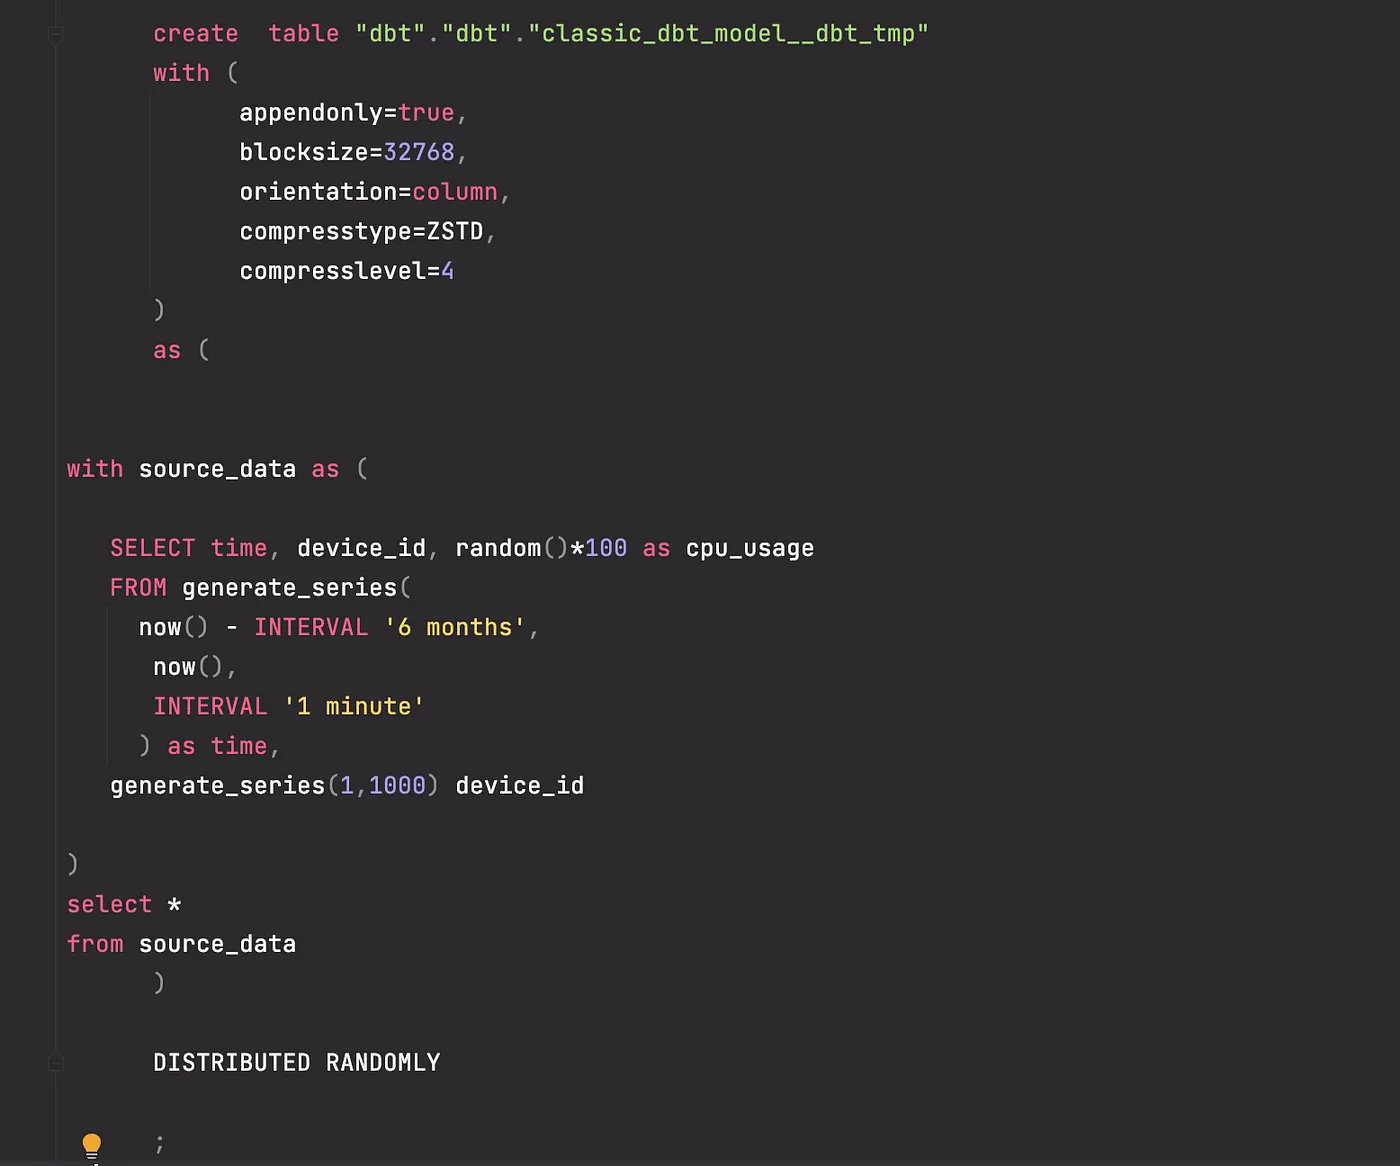
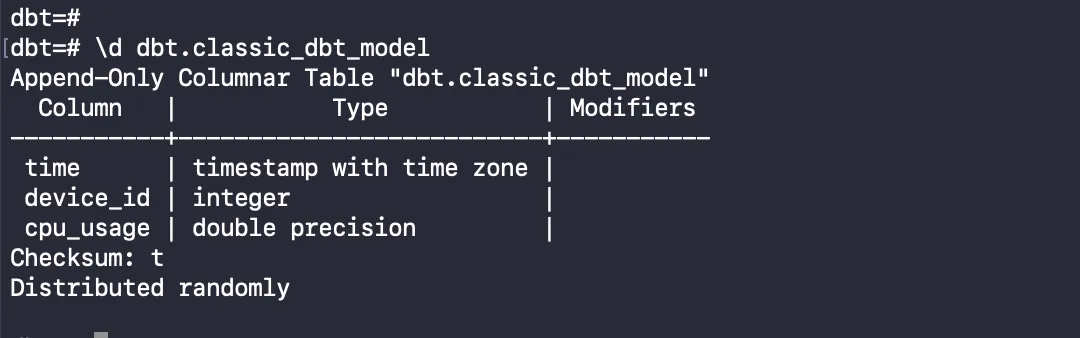
В этой модели была создана таблица с 265 миллионами строк, распределенных случайным образом, с параметрами Greenplum, установленными по умолчанию.
greenplum_dbt_model.sql:

Во второй таблице данные будут распределены по столбцу device_id. Данная таблица будет ориентирована на столбцы и разбита на разделы с помощью сжатия ZLIB.
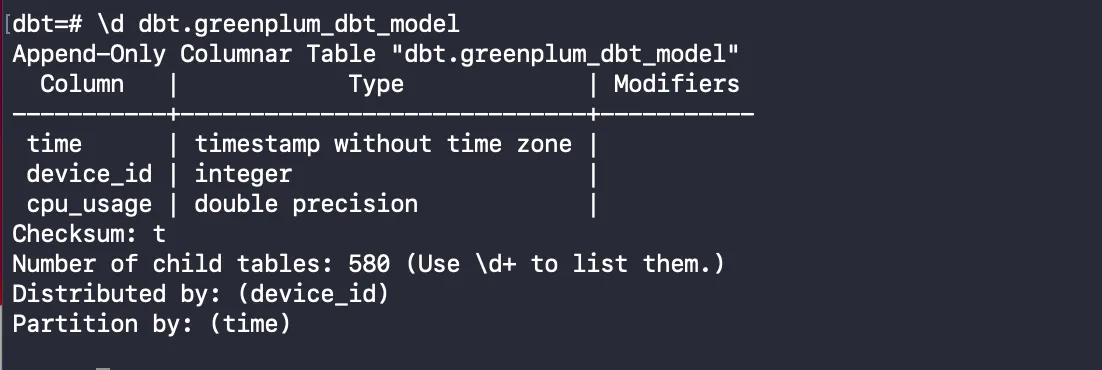
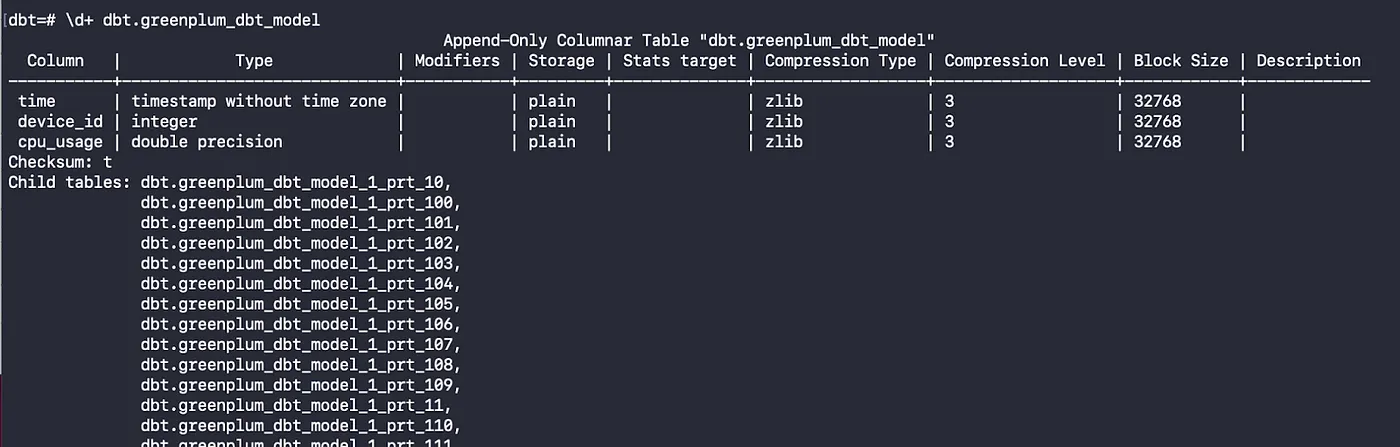
- Когда мы вернемся к консоли Greenplum, мы сможем выбрать одну из этих моделей:
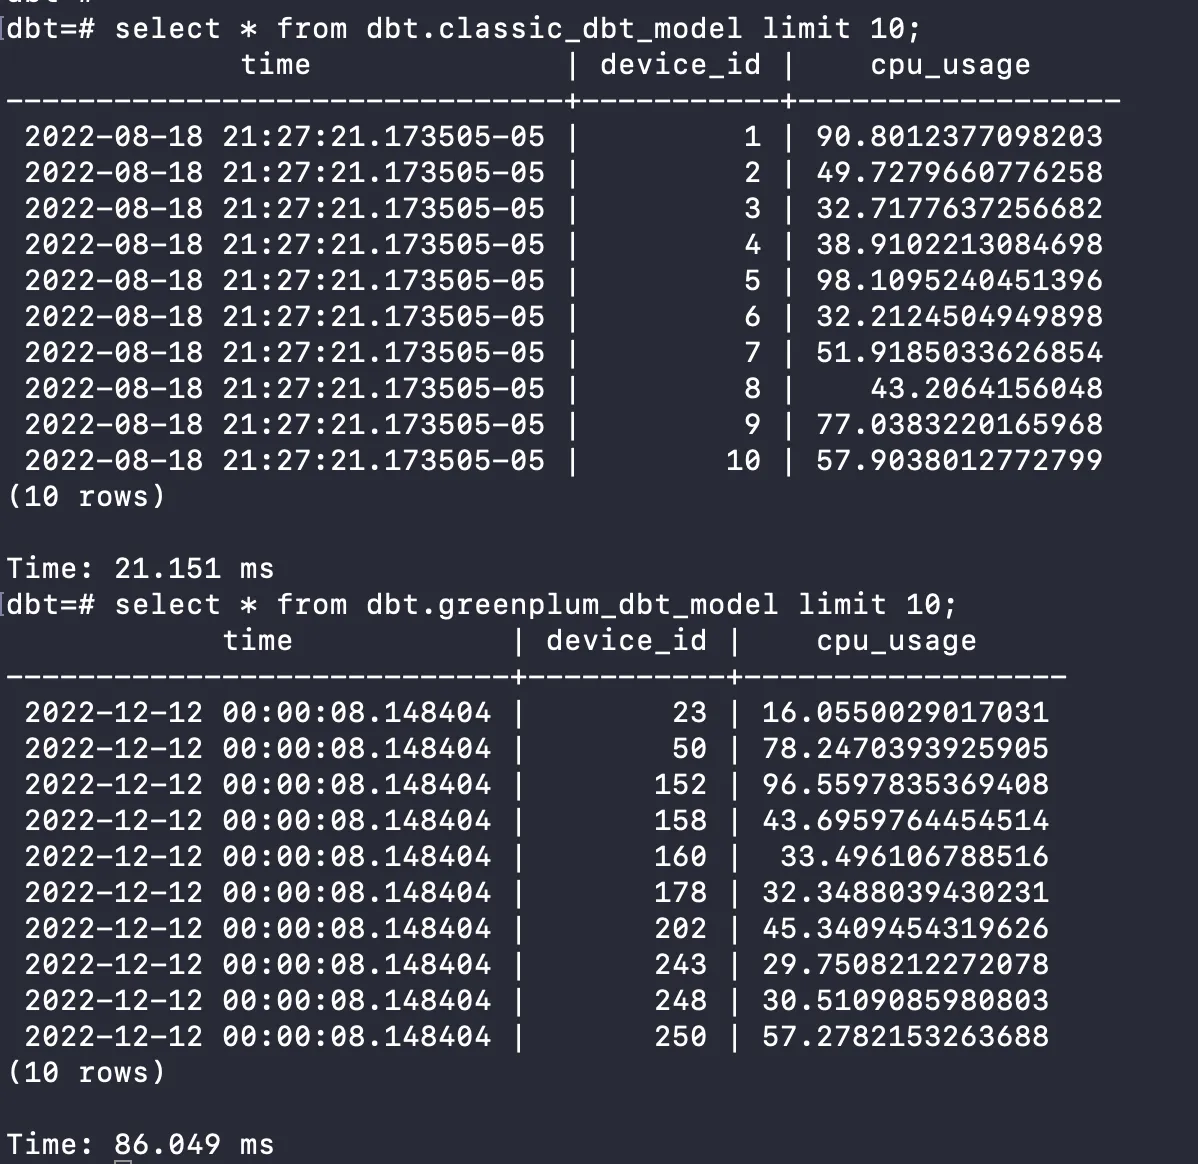
Анализ производительности и результатов запросов
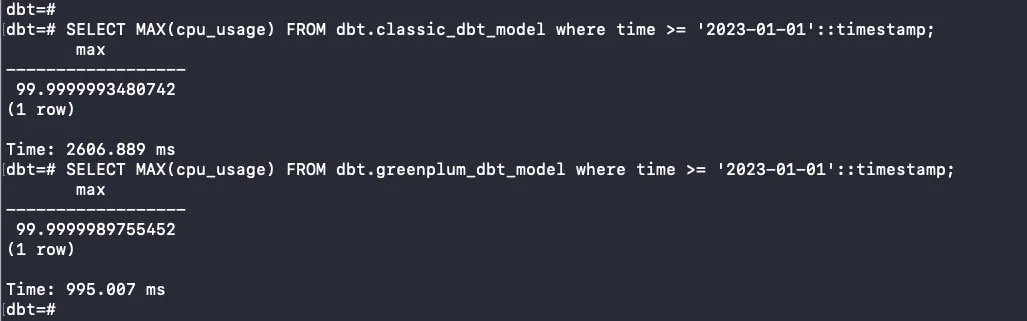
Как видите, таблицы в Greenplum имеют мощные конфигурации оптимизации, которые способны повысить производительность запросов в разы. Чтобы сравнить производительность запросов между нашими созданными таблицами dbt, мы запустим запросы к этим двум большим таблицам, содержащим 265 миллионов записей.
- SELECT MAX (cpu_usage) FROM dbt. ***_dbt_model где время >= '2023-01-01'::timestamp:
-
SELECT COUNT(*) FROM dbt.****_dbt_model WHERE cpu_usage >= 99 AND (время между ‘2023–02–18’::timestamp and ‘2023–02–20’::timestamp):
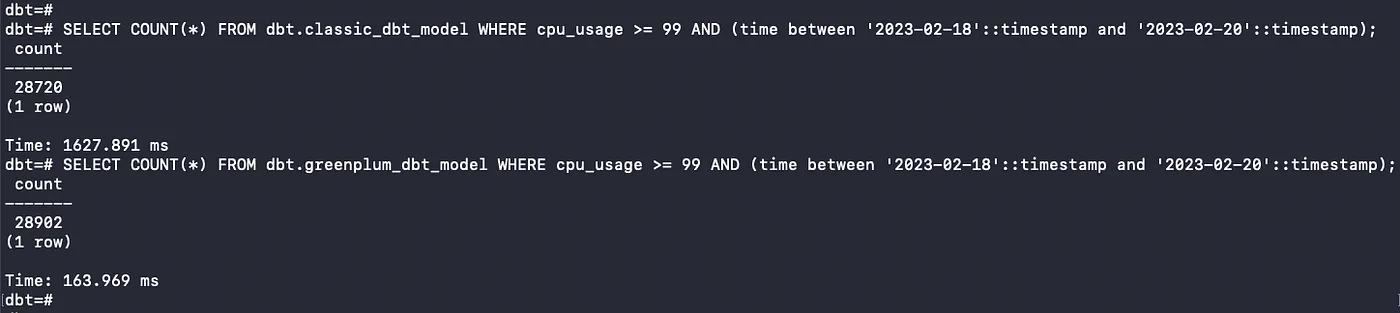
Как и ожидалось, благодаря расширенным возможностям Greenplum аналитические запросы к таблице greenplum_dbt_model, содержащей 265 записей, выполняются гораздо быстрее – выполнение нашего запроса заняло всего 0,163 секунды, что в десять раз быстрее по сравнению с временем выполнения запросов к таблице classic_dbt_model, которое заняло более 1 секунды.
Заключение
Выигрышное сочетание Greenplum и dbt значительно упрощают работу с Big Data, создавая централизованную среду на базе SQL для улучшенной трансформации данных.
Сообщества dbt и Greenplum, созданные для повышения производительности на базе технологий с открытым исходным кодом обеспечивают постоянную разработку и внедрение инноваций, а также минимизируют риски, связанные с блокировкой поставщиков.


