

Прокачиваем видеоаналитику с помощью ClickHouse
Данные об эффективности видеоматериала - это ключ к пониманию того, как зрители взаимодействуют с контентом, а также залог успеха деятельности разработчиков приложений. Эти данные включают в себя такие показатели, как количество просмотров, время просмотра, количество ошибок и буферизация.
Информация о вовлеченности зрителей помогает создателям контента удерживать свою аудиторию, а также разрабатывать эффективные стратегии по формированию содержания видео-материала. Показатели производительности позволяют выявлять технические пробелы, которые необходимо устранить для обеспечения бесперебойного воспроизведения видео-файлов.
Первая попытка оптимизировать видеоаналитику в Livepeer Studio оказалась слишком дорогостоящей и трудно масштабируемой. Нужно было придумать что-то более эффективное.
Оригинальное решение
Прежде чем перейти к главному герою нашей истории, давайте посмотрим, с чего мы начинали. Наша первая попытка была классическим подходом «использовать то, что имеешь», который работал хорошо до тех пор, пока количество просмотров наших видео не взлетело с 665 тыс до 108 млн (* 161 раз) всего за один месяц…

Краткий обзор нашей системы:
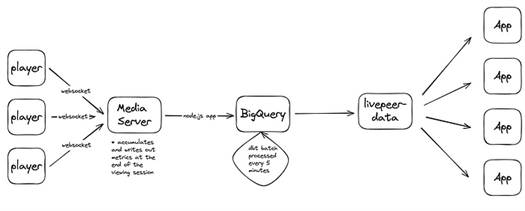
- Плеер отправляет обновления на наш медиасервер через WebSocket.
- Сервер собирает метрики в течение всего сеанса просмотра и отправляет их по окончании соединения.
- Данные попадают в приложение Node.js через UDP-соединение, которое загружает их в BigQuery.
- Каждые 5 минут данные обрабатываются в BigQuery в пакетном режиме с помощью модели dbt в задании Kubernetes cron.
- Наш API обрабатывает входящие запросы, извлекает данные из BigQuery и доставляет их конечным пользователям.
Минусы
Спустя год и миллиард просмотров недостатки этого подхода стали очевидны. Он оказался слишком медленным, дорогим и плохо масштабировался.
Два аспекта скорости, которые нас не устраивали:
- Задержка данных: Время между наступлением события и его подготовкой в базе данных равнялось длительности сеанса просмотра плюс 5 минут. Таким образом, если зритель смотрел программу в течение часа, соответствующие были доступны для анализа только через час и 5 минут. Такая задержка была критической, особенно при попытке оперативного обнаружения каких-либо проблем, например ошибок, которые могли возникнуть в первые несколько минут сеанса.
- Скорость обработки запросов: обработка некэшированных запросов в BigQuery занимали в среднем около 750 миллисекунд. В идеале этот показатель должен быть в 2-3 раза меньше. Медленная скорость запросов затрудняла своевременное предоставление данных нашим пользователям, что негативно сказывалось на возможности операвтивного реагирования на возникающие ситуации.
Слишком дорогое и при этом ограниченное масштабирование
Наш выбор в пользу BigQuery имел серьезные последствия в плане расходов, которые росли по мере увеличения количества видеоматериала.
- Тарификация на основе использования: Затраты на BigQuery растут по мере обработки большего количества данных, что приводит к линейному росту затрат. Около 90 % наших затрат на BigQuery приходилось на пакетную обработку входящих данных.
- Связанное использование: В идеале ресурсы, необходимые для запроса данных пользователя, должны зависеть только от их собственного использования. В идеале, индивидуальные пользователи должны обходиться дешевле, а крупные корпоративные заказчики - дороже, но по отдельности. Однако метод разбиения BigQuery работает по-другому. Он допускает разделение только по одному столбцу, обычно по временной метке, например, по каждому дню. Это означает, что данные каждого пользователя не разбиты на разделы, и «крупный» пользователь может сделать запрос ко всему разделу более дорогостоящим, что затрудняет разработку структуры вознаграждения, позволяющей переложить затраты на клиентов.
Несмотря на все эти трудности, наше финальное решение стало свидетельством нашей изобретательности и находчивости. Оно напомнило нам о том, что нет предела совершенству и его нельзя добиться сразу. В процессе работы над решением задачи мы учились, адаптировались и в итоге лучше поняли потребности наших пользователей.
Новое решение
А теперь - захватывающее продолжение нашей истории! В качестве главного героя мы пригласили ClickHouse.
Для тех, кто не знаком, ClickHouse - это колоночно-ориентированная система управления базами данных, известная своей высокой производительностью, масштабируемостью и способностью обрабатывать большие объемы данных с помощью сверхбыстрых запросов.
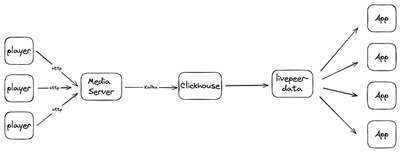
Вот как данные проходят через нашу новую систему, построенную вокруг ClickHouse:
- Плеер: Собирает метрики и события на стороне клиента, отправляя JSON-объект на наши медиасерверы каждые 5 секунд («сердцебиение»).
- Catalyst: Принимает входящие данные, дополняет их информацией с сервера и отправляет в Kafka.
- Kafka: Быстро переправляет данные между нашими серверами и ClickHouse.
- ClickHouse: Хранит входящие данные и предоставляет их для молниеносных запросов.
- API данных Livepeer Studio: Запрашивает ClickHouse и доставляет данные пользователям.
Сработала ли наша задумка?
Безусловно. Новая система полностью изменила правила игры. Вот как наше решение в пользу ClickHouse справилось с рядом первоначальных проблем:
Высокая скорость
Мы хотели решить сразу две основные проблемы со скоростью: задержка данных и скорость обработки запросов.
- Задержка данных: улучшение значения показателя на 98 %, снижение средней задержки с минимум 5 минут до 7 секунд (!). И это включает в себя время, необходимое плееру для запуска «сердцебиения.
- Скорость обработки запросов: увеличена на 90 %, среднее время обработки запроса сократилось с 750 миллисекунд до 82 миллисекунд. Это означает, что теперь наша система может обрабатывать гораздо больший объем запросов за более короткий промежуток времени, предоставляя пользователям практически мгновенный доступ к важным для них данным.
Приемлемое и эффективное масштабирование
Наша система на базе ClickHouse предлагает гораздо более доступную модель ценообразования благодаря отказу от тарификации на основе использования и переходу на кластерную тарификацию. Теперь мы платим исключительно за зарезервированные мощности, что оказалось гораздо выгоднее.
Во-вторых, подход ClickHouse к партицированию идеально подходит для нашего приложения, позволяя использовать каскадный и иерархический метод разделения, который сохраняет данные пользователей по отдельности. Это означает, что при резком увеличении нагрузки на одного клиента ресурсы, необходимые для запросов других пользователей, остаются неизменными.
И что в итоге?
Достигнутая низкая задержка и молниеносная скорость обработки запросов открыли совершенно новый мир возможностей. Теперь в режиме реального времени мы можем посчитывать точное количество просмотров, количество ошибок и многое-многое другое. С точки зрения производительности, мы обеспечили оперативное получение данных, благодаря чему наши клиенты могут быстрее принимать взвешенные решения!
Преимущества нашей новой архитектуры выходят далеко за рамки только этого продукта, закладывая основу для будущих инноваций в нашем аналитическом стеке. Продолжая совершенствовать собственные решения, мы делаем все от нас зависящее для того, чтобы предложить нашим пользователям еще более надежные и мощные инструменты, такие как углубленный конвейер «здоровья потока», позволяющий разработчикам получать четкое представление о состоянии потока в любую точку времени.
Благодарю Вас за уделенное внимание! Обязательно следите за наши обновлениями – мы всегда рады поделиться с Вами нашими открытиями в области аналитики данных в режиме реального времени.


