

Выбор клиента Python Kafka: сравнительный анализ
Оценка Python-клиентов для Kafka (kafka-python, потоки Confluent и Quix) с точки зрения DevEx, совместимости с брокерами и производительности.
Введение
Apache Kafka очень часто используется для разработки сценариев использования в режиме реального времени, таких как обнаружение случаев мошенничества, системы рекомендаций, а также мониторинг и профилактическое обслуживание. Все они подразумевают использование механизма обработки потоков с отслеживанием состояния, который работает в тандеме с Kafka, что часто приводит к усложнению архитектуры.
Kafka - это универсальный инструмент, который можно использовать самостоятельно, без использования дополнительной технологии обработки потока. Например, благодаря своим исключительным возможностям обмена сообщениями pub /sub Kafka является отличным вариантом для осуществления интеграции разрозненных систем. Подобно тому, как нервная система получает и посылает сигналы по всему телу для координации действий, Kafka может эффективно поглощать потоки данных из многих источников и перераспределять их в различные части системы (приложения, услуги, базы данных и т. д.) в режиме реального времени.

После приема данных из источников Вы можете выполнить легкую обработку данных перед их отправкой в целевые системы. Это может повлечь за собой общие операции, такие как фильтрация, отображение, очистка (очистка), обогащение и преобразование данных. Все эти преобразования без состояния необходимы для обеспечения того, чтобы данные были стандартизированными, чистыми, хорошо структурированными и подходящими для потребления нижестоящими системами.
Самое замечательное, что для таких базовых преобразований на потоковых данных можно использовать клиент Apache Kafka, что значительно упрощает архитектуру и уменьшает сложность системы.
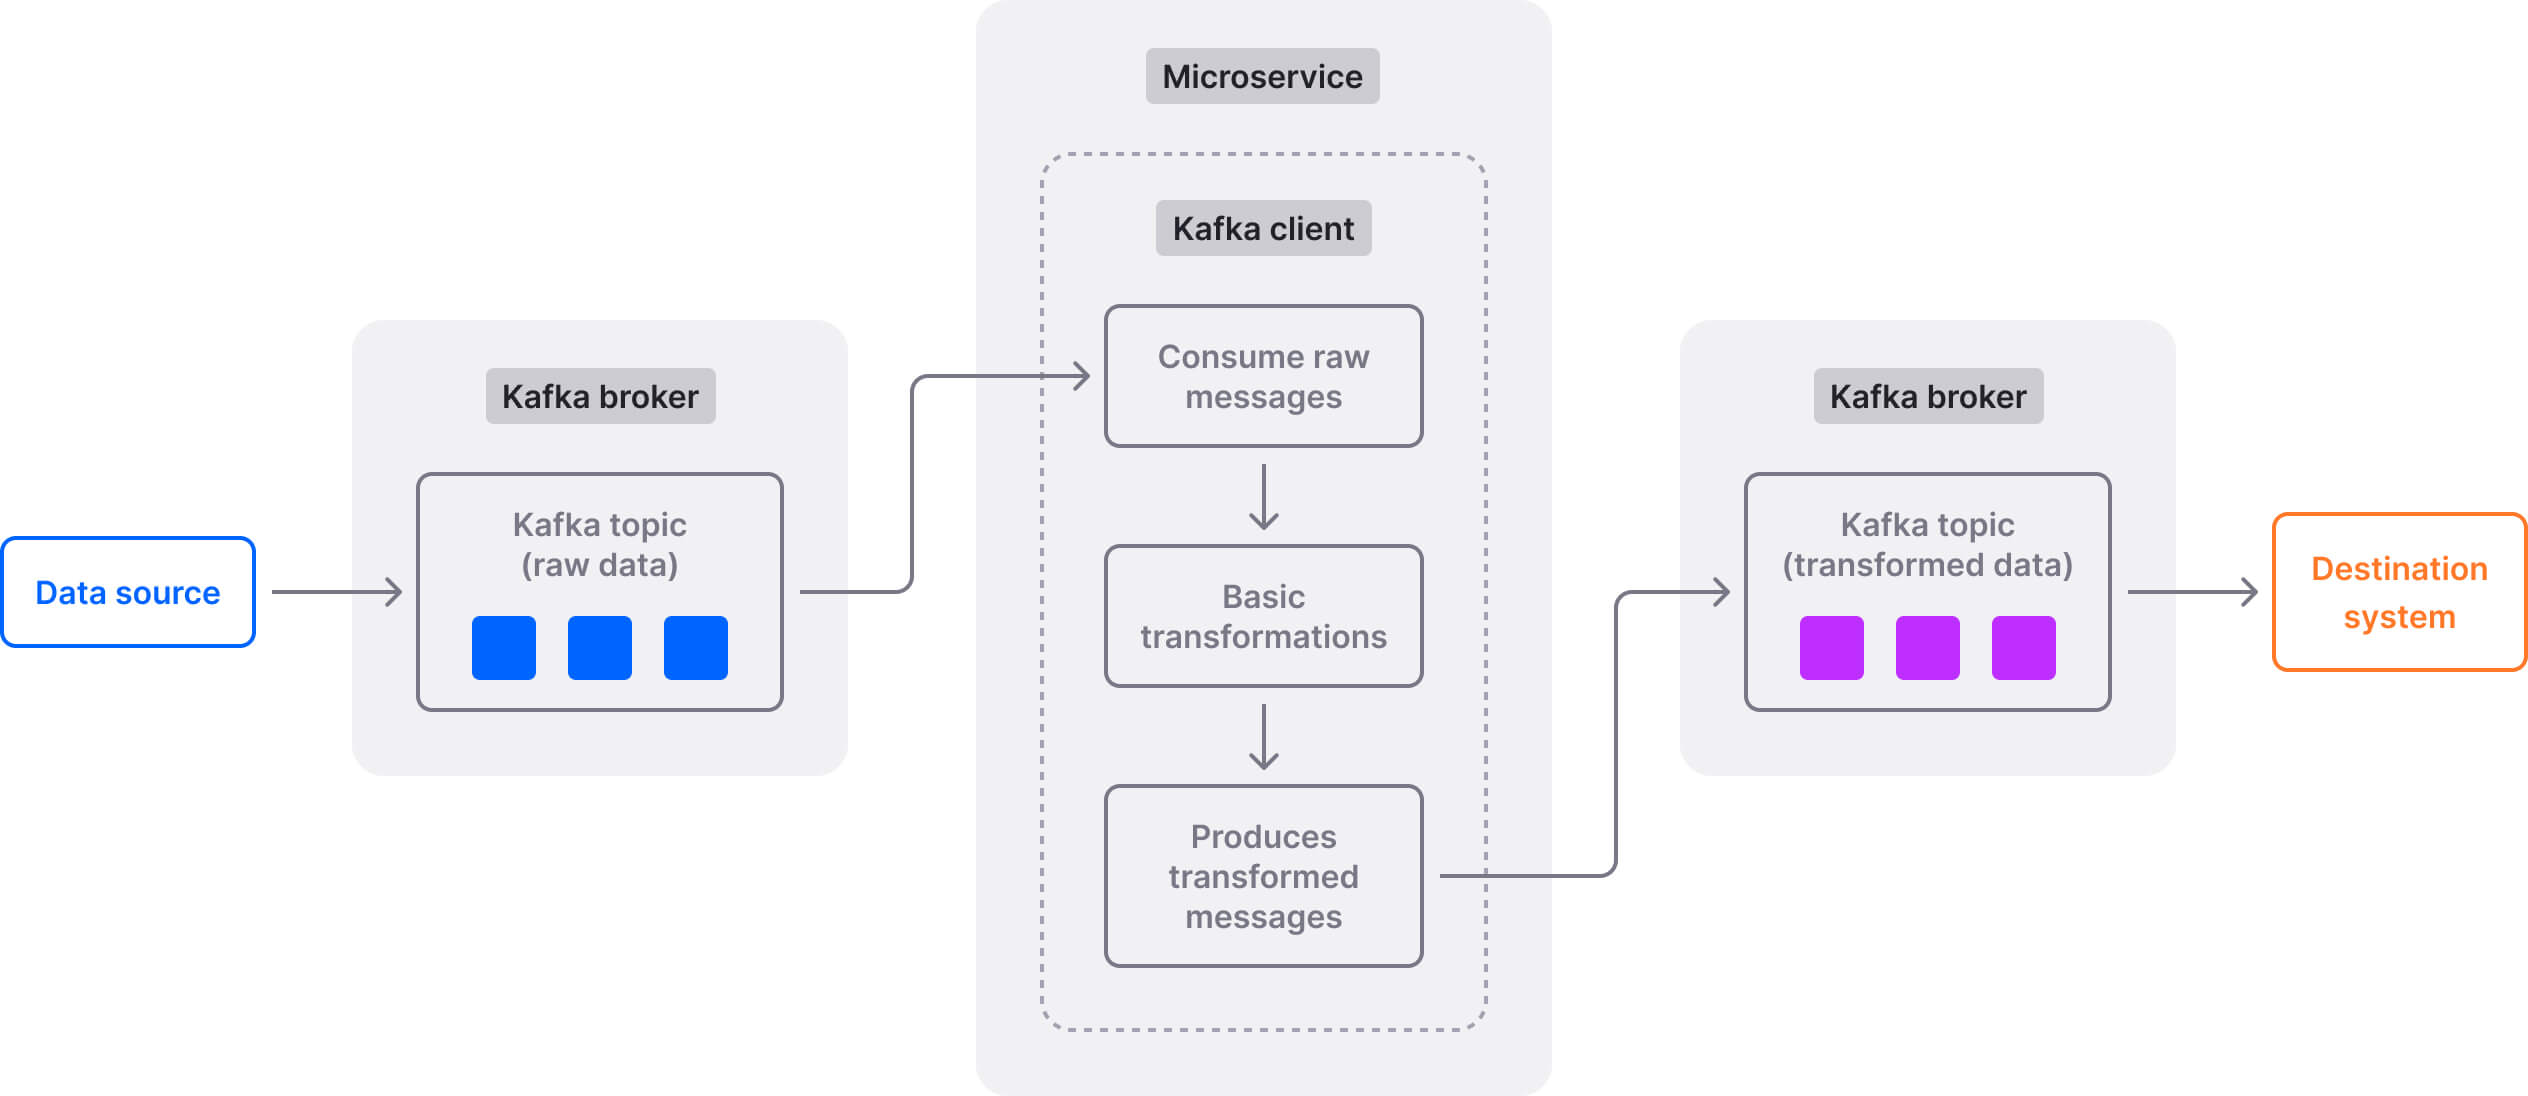
Но какие клиенты Python Kafka лучше использовать для этих целей? По каким параметрам их лучше сравнивать? Именно об этом я и хочу поговорить в этой статье
Почему Python и Kafka – «идеальная пара»?
Python, возможно, самый популярный язык, используемый в Data Science, инженерии данных и ML.
Все эти области работы с данными часто требуют сбора (и обработки) больших объемов потоковых данных, в то время как Kafka является отраслевым стандартом для работы с потоками данных масштабируемым, отказоустойчивым способом.
Поэтому неудивительно, что Kafka используется вместе с Python в производственных средах. Например, Robinhood зависит от архитектуры на основе микросервисов , которая использует Kafka иPython. Еще одним отличным примером является Netflix, стриминговый гигант полностью полагается на Python. Кроме того, Netflix также является одним из крупнейших и самых преданных пользователей Kafka в мире
Каких именно клиентов Python Kafka мы сравниваем?
Эта статья фокусируется на трех клиентах Python для Kafka: клиенте Kafka Python от Confluent, клиентской библиотеке kafka-python и Quix Streams. Первые два - самые популярные варианты, а Quix Streams - это более свежее решение, целью которого является упрощение работы с Kafka.
Я буду сравнивать их на основе таких критериев, как:
- Опыт разработчиков
- Лицензирование и совместимость с брокерами
- Вопросы производительности
Однако, прежде чем перейти к сравнению, давайте кратко пройдемся по всем трем клиентам Kafka.
Клиент Confluent Kafka Python
Confluent Kafka Python - облегчённая обертка вокруг высокопроизводительной библиотеки librdkafka, которая представляет собой C/C + + реализацию протокола Apache Kafka.
Ключевые возможности
- Предоставляет высокоуровневые классы продюсера, консюмера и AdminClient для чтения и записи сообщений, а также для управления топиками Kafka.
- Поддерживает расширенные функции и интеграции Confluent и Kafka, такие как Confluent Schema Registry.
- Может реализовать простые преобразования, такие как изменение формата сериализации или фильтрация сообщений, как часть процесса потребления.
Библиотека клиента kafka-python
kafka-python является библиотекой с открытым исходным кодом, которая предлагает Pythonic API для работы с Apache Kafka. В отличие от клиента Confluent Python, он не зависит от каких-либо базовых внешних библиотек и полностью реализован на Python.
Ключевые возможности
- Специально разработанные классы для создания сообщений на топики Kafka (KafkaProducer) и потребления сообщений из топиков Kafka (KafkaConsumer). Они предназначены для работы максимально аналогично Java-клиенту Kafka.
- Предлагает такие функции, как управление топиками, а также синхронные и асинхронные сообщения.
- Может выполнять преобразования во время потребления или производства сообщений, например, добавление заголовков, изменение значений сообщений или фильтрация на основе определенных критериев.
Quix Streams
Quix Streams является облачной библиотекой с открытым исходным кодом, предназначенной для потоковой передачи данных и обработки потоков с использованием Kafka и чистого Python.
Ключевые возможности
- Может использоваться в качестве клиента Kafka для создания и использования сообщений (для этой цели он оборачивает библиотеку Python Kafka от Confluent).
- Поддерживает как низкоуровневые преобразования без состояния, так и более сложные операции с учетом состояния. Предлагает API Streaming DataFrame (аналогичный pandas DataFrame) для табличных преобразований данных.
- Легко интегрируется со всей экосистемой Python (pandas, scikit-learn, TensorFlow, PyTorch и т.д.).
- Предназначен для устойчивой работы и масштабирования с помощью оркестрации контейнеров (Kubernetes).
Сравнение опыта разработчиков при работе с различными клиентами Python Kafka
Итак, сравним DevEx, предоставленный kafka-python, Quix Streams и пакетом Confluent Kafka Python. Сначала мы рассмотрим несколько примеров кода для того, чтобы лучше понять, каково это работать с этими клиентами Python Kafka. Затем по каждому из рассматриваемых вариантов мы рассмотрим такие вещи, как кривая обучения, документы и учебные ресурсы, а также зрелость проекта.
Демонстрация кода
Я расскажу о базовом примере использования, демонстрирующем, как использовать все три клиента Python Kafka для:
- Чтения данных из существующего топика Kafka
- Выполнения преобразований без состояния (например, перевести мили в час в километры в час).
- Отправления преобразованного вывода в другой существующий топик Kafka.
Пример кода клиента kafka-python
importjsonfromkafkaimportKafkaConsumer, KafkaProducerdef mph_to_kmph(mph):"""Convert miles per hour to kilometers per hour.""" returnmph *1.60934 # Consumer setup to consume JSON messages from source topic ('source_speed_mph')consumer = KafkaConsumer('source_speed_mph',bootstrap_servers=['localhost:9092'],auto_offset_reset='earliest',value_deserializer=lambdax: json.loads(x.decode('utf-8')))# Producer setup to produce JSON messages to destination topic ('destination_speed_kmph') # The messages are converted from miles/hour to kilometers/hourproducer = KafkaProducer(bootstrap_servers=['localhost:9092'],value_serializer=lambdax: json.dumps(x).encode('utf-8'))# Process and produce messages asynchronously try:formessageinconsumer:mph = message.value['speed']# Extracts speed in mph from the consumed messagekmph = mph_to_kmph(mph)# Converts mph to km/hprocessed_message = {'speed': kmph}producer.send('destination_speed_kmph', processed_message)# Sends the converted speed to 'destination_speed_kmph' topicproducer.flush()# Ensures all messages are sent
Это простая реализация с четким разделением проблем (отдельные настройки для консюмеров и продюсеров). Код должен быть простым для понимания разработчиками, знакомыми с Python и Kafka.
Пример кода Confluent Kafka Python
fromconfluent_kafkaimportConsumer, Producer, KafkaErrorimportjsondef mph_to_kmph(mph):"""Convert miles per hour to kilometers per hour.""" returnmph *1.60934 # Consumer setup to consume JSON messages from source topic ('source_speed_mph')consumer_config = {'bootstrap.servers': 'localhost:9092','group.id': 'group1','auto.offset.reset': 'earliest','enable.auto.commit': True,'value.deserializer': lambdax: json.loads(x.decode('utf-8'))}consumer = Consumer(consumer_config)consumer.subscribe(['≈'])# Producer setupproducer_config = {'bootstrap.servers': 'localhost:9092','value.serializer': lambdax: json.dumps(x).encode('utf-8')}producer = Producer(producer_config)# Function to transform miles per hour to kilometers per hour def process_message(msg):mph = msg['speed']kmph = mph_to_kmph(mph)return{'speed': kmph}try:while True:msg = consumer.poll(timeout=1.0)ifmsgis None:continue ifmsg.error():ifmsg.error().code() == KafkaError._PARTITION_EOF:# End of partition event continue elifmsg.error():print('KafkaError: {}'.format(msg.error()))else:# Message is a Python dictionarymph_value = process_message(msg.value())producer.produce('destination_speed_kmph', mph_value)# Sends the converted speed to 'destination_speed_kmph' topicproducer.flush()
По сравнению с фрагментом kafka-python (и с Quix Streams) данный чуть более «многословен» Это связано с дополнительными опциями конфигурации и обработкой ошибок. Имейте в виду, что фрагменты в данном случае являются лишь примерами. В реальных сценариях код, который Вы пишете при использовании клиента Kafka Python от Confluent, будет еще длиннее.
Пример кода Quix Streams
fromquixstreamsimportApplication# The 'Application' class consumes messages from an input topic, processes them, and then produces the result to an output topic.app = Application(broker_address="localhost:9092")input_topic = app.topic("source_speed_mph")output_topic = app.topic("destination_speed_kmph")# Reads JSON messages from input topic and converts them to Streaming DataFrame (SDF) tabular formatsdf = app.dataframe(input_topic)# Transforms miles per hour to kilometers per hoursdf["speed_km_h"] = sdf["speed_mph"] *1.60934 # Send rows from SDF back to the output topic as JSON messagessdf = sdf.to_topic(output_topic)
Quix Streams предлагает высокоуровневую абстракцию над Kafka с операциями, подобными pandas. Этот декларативный синтаксис уменьшает длину кода, что более удобно для разработчиков Python.
В приведенном выше фрагменте показано, как использовать Quix Streams для потребления данных из топика Kafka, преобразования ее и записи выходных данных в другой топик. Вы также можете использовать Quix Streams для загрузки данных из источника, отличного от Kafka (например, файла CSV или фиксированного словаря), преобразования его в топик Kafka. Пример:
fromquixstreamsimportApplication# import additional modules as needed importrandomimportosimportjson# create an Applicationapp = Application(consumer_group="data_source", auto_create_topics=True)# define the topic using the "output" environment variabletopic_name = os.environ["output"]topic = app.topic(topic_name)# this function loads the file and sends each row to the publisher def get_data():""" A function to generate data from a hardcoded dataset in an endless manner. It returns a list of tuples with a message_key and rows """ # define the hardcoded dataset, representing vehicle sensor readingsdata = [{"sensor": "speed","vehicle_id": "vehicle1","speed_kmh": "55.5","time": "1577836800000000000"},{"sensor": "speed","vehicle_id": "vehicle2","speed_kmh": "62.1","time": "1577836801000000000"},{"sensor": "speed","vehicle_id": "vehicle1","speed_kmh": "53.7","time": "1577836803000000000"},{"sensor": "speed","vehicle_id": "vehicle2","speed_kmh": "64.3","time": "1577836804000000000"},{"sensor": "speed","vehicle_id": "vehicle1","speed_kmh": "52.8","time": "1577836806000000000"},{"sensor": "speed","vehicle_id": "vehicle2","speed_kmh": "66.2","time": "1577836808000000000"},{"sensor": "speed","vehicle_id": "vehicle1","speed_kmh": "57.4","time": "1577836810000000000"},{"sensor": "speed","vehicle_id": "vehicle2","speed_kmh": "61.9","time": "1577836812000000000"},{"sensor": "speed","vehicle_id": "vehicle1","speed_kmh": "56.0","time": "1577836814000000000"},{"sensor": "speed","vehicle_id": "vehicle2","speed_kmh": "63.5","time": "1577836816000000000"},{"sensor": "speed","vehicle_id": "vehicle1","speed_kmh": "54.9","time": "1577836818000000000"},{"sensor": "speed","vehicle_id": "vehicle2","speed_kmh": "64.8","time": "1577836820000000000"}]# create a list of tuples with row_datadata_with_id = [(row_data)forrow_dataindata]returndata_with_iddef main():""" Read data from the hardcoded dataset and publish it to Kafka """ # create a pre-configured Producer object. withapp.get_producer()asproducer:# iterate over the data from the hardcoded datasetdata_with_id = get_data()forrow_dataindata_with_id:json_data = json.dumps(row_data)# convert the row to JSON # publish the data to the topicproducer.produce(topic=topic.name,key=row_data['vehicle_id'],value=json_data,)print("All rows published")if__name__ =="__main__":try:main()exceptKeyboardInterrupt:print("Exiting.")
Обратите внимание на использование app.get_producer () в качестве продюсера. Это также известно как менеджер контекста - механизм, который автоматически управляет ресурсами в блоке кода. В нашем случае менеджер контекста гарантирует, что продюсер Kafka был создан в начале блока правильно, а затем был должным образом закрыт и очищен после выполнения блока. Это помогает обеспечить эффективное управление ресурсами, предотвращая утечки ресурсов. Это также делает Ваш код более кратким, читабельным и простым в обслуживании. Отметим, что контекстные менеджеры эксклюзивны для Quix Streams - они изначально не поддерживаются kafka-python и Python-клиентом Confluent. В этих клиентах необходимо явно закрыть соединение с producer.close ().
Кривая обучения, ресурсы и зрелость проекта
Кривая обучения, качество и глубина документации, а также уровень зрелости проекта - все это важные факторы, которые необходимо учитывать при выборе программного решения. Итак, сравним трех клиентов Python Kafka по всем этим критериям?
|
Критерий |
Confluent Kafka Python |
Библиотека kafka-python |
Quix Streams |
|
Официальная документация и обучающие ресурсы |
Хорошая документация, руокводство для начинающих и несколько постов в блоге |
Подробное описание API. Остальная документация сильно обобщена, других официальных учебных ресурсов нет. |
Подробная документация, дополненная множеством учебных пособий, сообщений в блогах и галереей паттернов (готовых проектов), что позволяет быстро начать разработку приложений. |
|
Кривая обучения |
Крутая кривая обучения (до нескольких недель) |
По сравнению с 1 вариантом кривая обучения более пологая (около нескольких дней) |
По сравнению с 1 вариантом кривая обучения более пологая (около нескольких дней) |
|
Зрелость проекта (по состоянию на 8 мая 2024 года) |
|
|
|
И Confluent, и Quix Streams предлагают своим пользователям достаточно хорошую и подробную (хотя и не исчерпывающую) документацию. Помимо документов, Confluent предлагает учебные ресурсы для своего клиента Python Kafka (всего пара постов в блоге и небольшой учебник). Quix предлагает гораздо лучшие тарифы в этом отношении, с большим количеством сообщений в блоге, учебных пособий и готовых проектов, которые помогут Вам начать работу гораздо. Между тем, kafka-python предлагает подробное описание API. Остальная часть документации состоит всего из нескольких базовых кратких страниц. kafka-python не предоставляет никаких дополнительных учебных ресурсов (таких как учебные пособия или сообщения в блоге).
У клиента Confluent Kafka Python самая крутая кривая обучения. Это потому, что Вы должны не только научиться использовать клиента, но и получить хорошее представление о более широкой экосистеме Confluent. Однако, если Вы уже знакомы с продуктами Confluent и Вам нужно только научиться использовать клиент Kafka Python, для Вас кривая будет намного короче (возможно, всего несколько дней). kafka-python и Quix Streams имеют схожую кривую обучения длиною в несколько дней. Первый предлагает простые API, но отсутствие примеров, учебных пособий и руководств означает, что Вы потратите несколько дней на тестирование и понимание клиента. Несмотря на то, что Quix сложнее, чем kafka-python, тот факт, что он предлагает более обширную документацию и дополнительные учебные ресурсы, означает, что Вы будете тратить меньше времени на то, чтобы разбираться в себе. Кроме того, сообщество Quix (Streams) очень отзывчиво, если Вам понадобится помощь, Вы ее быстро получите.
kafka-python - старейший Python-клиент для Kafka (существует уже десять лет). Похоже, что он регулярно поддерживался до 2020 года. Тем не менее, в период с сентября 2020 года по март 2024 года новых выпусков не было. Для программного продукта это очень длительный перерыв. Возможно, у специалистов были другие приоритеты, и они не могли позволить себе вкладывать больше времени в его развитие, что часто случается с проектами с открытым исходным кодом без коммерческой поддержки. В отличие от этого, клиент Confluent Python Kafka и Quix Streams получают значительную коммерческую поддержку и активно поддерживаются с регулярной каденцией новых выпусков.
Сравнение клиентов Python Kafka с точки зрения лицензирования и совместимости с брокерами
Чуть выше мы сравнили клиентов Quix Streams, kafka-python и Kafka Python от Confluent с точки зрения удобства работы для разработчиков. Безусловно, DevEx – аспект очень важный, но далеко не единственный. Помимо него необходимо учесть и лицензирование, и совместимость с брокерами.
Сравнительная таблица:
|
Критерий |
Confluent Kafka Python |
Библиотека kafka-python |
Quix Streams |
|
Лицензирование |
Лицензия Apache v2.0 |
Лицензия Apache v2.0 |
Лицензия Apache v2.0 |
|
Совместимость с брокером Kafka |
Брокеры Apache Kafka (версия 0.8 и новее), Confluent Cloud и платформа Confluent |
Брокеры Apache Kafka (версия 0.8 и новее) |
Брокеры Apache Kafka (версия 0.10 и новее), облачный брокеры Quix Cloud и Confluent Cloud, а также брокеры Redpanda, Aiven и Upstash |
Ключевые выводы:
- Все три клиента Kafka Python поставляются с open-source лиценизией, что значит то, что Вы вправе свободно использовать и изменять их по воему усмотрению совершенно бесплатно.
- Теоретически kafka-python совместим с любым брокером Kafka (версия 0.8 и новее). Но все же практика показывает, что для того, чтобы убедиться в том, что клиент действительно хорошо работает с тем или иным решением, необходимо предварительное тестирование. На сегодняшний момент kafka-python не совсем подходит для работы с брокером Cloud Kafka от ConfluentЮ поскольку ему не хватает ряда важных продвинутых функций, необходимых для эффективного взаимодейтсвия с облачной экосистемой Confluent.
- Клиент Python от Confluent практически идеально подходит для работы с платформой Confluent и Confluent Cloud. Кроме того, по аналогии с kafka-python, в теории он подходит для любого брокера Kafka (версия 0.8 или новее). Однако на практике я не встречал ни одной компании, совмещающей этого клиента с брокером Kafka, управляемым сторонним вендором.
- Если kafka-python и клиент Python от Confluent cовместимы с брокерами Kafka 0.8 и новее, то Quix Streams поддерживает более поздние версии kafka (0,10 и новее). Quix Streams будет гарантированно работать с брокерами Kafka, размещенными на локально или управляемыми сторонними вендорами. В случае двух других клиентов Python Kafka потребуется дополнительное тестирование.
Сравнение производительности 3 клиентов Python Kafka
Как уже было сказано ранее, пакет клиента Python Kafka от Confluent является внешней оберткой библиотеки librdkafka C/C++. Обратите внимание на то, что язык C/C++ более эффективен по сравнению с Python. Это означает то, что по сравнению с kafka-python (который работает исключительно на Python) клиент Python от Confluent является более производительным.
Согласно информации на GitHub , librdkafka «была разработана с учетом возможности доставки сообщений и обеспечения высокой производительности, текущие показатели превышают 1 млн миллисекунд для продюсера и 3 млн миллисекунд для консюмера». Цифры действительно впечатляют, и, соответственно, клиент Kafka Python от Confluent также может ими похвастаться. Как я не старлася, я так и не смог найти ничего подобного для библиотеки kafka-python.
Посколько Quix Streams является оберткой клиента Python Kafka от Confluent, его характеристики производительности касательно продюсера и консюмера близки к характеристикам клиента Python от Confluent. Созданный высококлассными дата-инженерами, прекрасно владеющими всеми тонкостями пакетной обработки данных, Quix Streams может с легкостью обрабатывать миллионы сообщений/несколько ГБ данных в секунду с низкой задержкой (исчисляемой в миллисекундах).
Таким образом, если Вы ищете максимальную производительность в больших масштабах, то Ваш выбор должен пасть на клиента Python или Quix Streams. kafka-python хорошо проявил себя при средних рабочих нагрузках, где нет необходимости в запредельной производительности. Однако, как показывает практика, оптимальный выбор клиента зависит от каждого конкретного случая. Поэтому я настоятельно рекомендую Вам тестировать всех 3 клиентов Python Kafka для того, чтобы своими глазами увидеть то, насколько хорошо они справляются с поставленными задачами в условиях, продиктованных Вами.
Прокачка до пакетной обработки данных
Как правило, многие организации начинают с Kafka. Например, в сфере электронной коммерции для обработки заказов очень часто используют именно Kafka. Ее возможности pub/sub в купе с другими важными функциями могут быть с легкостью обработаны любым клиентом Kafka client (ннапрмер, если Вам нужно дополнить описание заказа более подробной информацией или изменить формат данных).
Однако со временем потребности становятся более сложными и изощренными. В какой-то момент времени Вам обязательно захочется проанализировать поступающие к Вам данные в режиме реального времени и создать персонализированные предложения для клиентов, посещающих Ваш Интернет-магазин. Или Вы захотите проанализировать транзакции оплаты на предмет мошеннических действий.
Конечно, Kafka может помочь и в этом случае, но все же для должной обработки данных нужны более продвинутые решения. Выявление фактов мошенничества подразумевает использование таких операций, как создание окон и агрегирование.
Такие операции не входят в функционал клиента Python от Confluent и библиотеки клиента kafka-python. Поэтому, если Вы используете какой-либо из этих двух клиентов, для выполнения подобных задач Вам понадобится дополнительный компонент , а именно процессор потоковой обработки данных, работающий на Python.
PyFlink (интерфейс Python для Apache Flink) и PySpark (интерфейс Python для Apache Spark) – два наиболее известных движка потоковой обработки. Это две весьма мощные распределенные системы с широким функционалом – как раз то, что Вам нужно для совершенствования Вашей экосистемы.

PyFlink иPySpark – сами по себе достаточно сложные решения, которыми помимо всего прочего трудно управлять. В частности, при работе с PyFlink Вы можете столкнуться со следующими трудностями:
- По большому счету, это обертка вокруг Java API от Flink, что означает то, что Вам могут потребоваться глубокие знания Java ( в дополнение к Python).
- Для работы с этим инструментов Вам понадобятся сложные длинные коды.
- Сложное и длительное обучение (несколько месяцев), включая DSL.
- Настройка PyFlink – это сложный, дорогой и времязатратный процесс, с которой может справиться только команда высококлассных специалистов. Например, команда инженеров компании Contentsquare работала над миграцией от Spark к Flink в течение 1 года (!) ; это был тернистый путь с кучей нюансов и подводных камней, о которых они даже и не предполагали.
С другой стороны, если Вы используете Quix Streams, то для пакетной обработки данных Вам не нужен никакой дополнительный компонент, поскольку данное решение уже само по мебе в состоянии справиться с рядом сложных операций с данными.
Кроме того, в сравнении с таким чудовищем, как (Py)Flink, Quix Streams гораздо проще в обучении и управлении. В нем нет JVM иDSL. Далее, если Вы развертываете приложения Quix Streams в Quix Cloud, Вам не нужно использовать сложные настройки, как в случае работы с Flink.

Какой клиент Python Kafka лучше всего подходит именно мне?
Все зависит только от Ваших персональных требований.
kafka-python идеально подходит для сравнительно небольших проектов, так как предоставляет прямой доступ к возможностям продюсера и консюмера Kafka.
Клиент Kafka Python от Confluent в первую очередь предназначен для разработчиков, которые стремятся использовать весь потенциал возможностей, предлагаемых Confluent. Он отлично интегрируется с такими элементами, как регистр схемы, Kafka Streams и т.д. данное решение идеально подходит для построения корпоративных приложений и базовых преобразований данных.
Quix Streams предлагает своим пользователям самое “питонское” решение из всех 3 возможных. Если ранее Вы работали с pandas, то с Quix Streams Вы будете чувствовать себя, как дома. И все это благодаря DataFrame API, позволяющему потреблять, преобразовывать и производить данные Kafka. По аналогии с клиентом Confluent Quix поддерживает возможность потоковой обработки данных в больших масштабах.


