

Оптимизация работы с базами данных: Моделирование данных с помощью Dbeaver
Если Вы ищите ответы на следующие вопросы, то эта статья – именно для Вас:
- Стремлюсь к оптимальному написанию запросов;
- Не знаю, что на самом деле делают внешние / вторичные ключи;
- Пробовал моделировать данные, по крайней мере, в 2 многотабличных наборах данных и разочаровался в этом процессе;
- Боюсь вводить данные в таблицы базы данных.
Из этой статьи Вы узнаете ответы на все эти вопросы и узнаете еще много нового и интересного.

Требования
- Два многотабличных набора данных для тренировки, расположенные в Вашей локальной папке. Для объяснения я буду использовать набор данных мировых показателей (набор из 3 таблиц). Вы также можете попрактиковаться на наборе данных от Kaggle и наборе данных от Microsoft , состоящем из 5 таблиц. Если Вы - настоящий энтузиаст, обратите внимание на набор данных snldb (ищите каталог вывода), состоящий из 11 таблиц и созданный Хендриком Хиллекесом.
- Желание познакомиться с Dbeaver - самой прогрессивной IDE для работы с запросами к базам данных. Прежде чем перейти к следующему приложению, установите его, воспользовавшись данной ссылкой …
- Поэкспериментировать с базой данных «in-memory» под названием DuckDB, которую нужно, как Вы уже догадались, установить, прежде чем читать дальше.
- Готовность выделить 2,5 часа своего драгоценного времени на то, чтобы понять и отработать все описанные ниже шаги.
Обзор нескольких «почему»
Почему именно DuckDB? В основном потому, что Вам не нужно иметь PostgreSQL/ MySQL db, запущенную на Вашей машине. Никакого Python или Javascript. Только чистый запрос к базе данных. Вам понадобится лишь рабочий командный интерпретатор для wget/ curl бинарного файла duckdb. (Мы не используем Duckdb из Python).
Почему Dbeaver? Это Vs-код для работы с базами данных. Dbeaver позволяет подключаться к базам данных duckdb в памяти и создавать на их базе различные таблицы. Он позволяет писать SQL-запросы в файле query_script.sql и сохранять их для последующего использования. Самое приятное это то, что если Вы захотите перенести вышеупомянутые csv-файлы в базу данных PostgreSQL, все, что Вам нужно будет сделать, это всего лишь изменить источник данных в DBeaver.
Почему именно эти наборы данных? Все три набора данных смоделированы на моей Linux-машине с Dbeaver и DuckDB. Вы должны быть в состоянии пройти весь процесс обучения без особых проблем. Эти наборы данных не являются слишком сложными или любительскими, они имеют как раз тот уровень, который позволит нам улучшить Ваше мастерство.
Настройка подключения к In- Memory БД в Dbeaver
После загрузки IDE Dbeaver (в дальнейшем именуемой ide) Вам потребуется некоторое время для того, чтобы сориентироваться в различных опциях меню и иконках ide. Чтобы настроить подключение к БД, Вам нужно найти значок «plug» в левом верхнем углу ide.
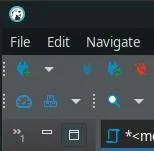
Щелкните на него, и перед Вами появится диалоговое окно для выбора базы данных. Выберите в нем duckdb и нажмите кнопку Next. В результате появится следующее диалоговое окно. Обратите внимание на красные многоточия!
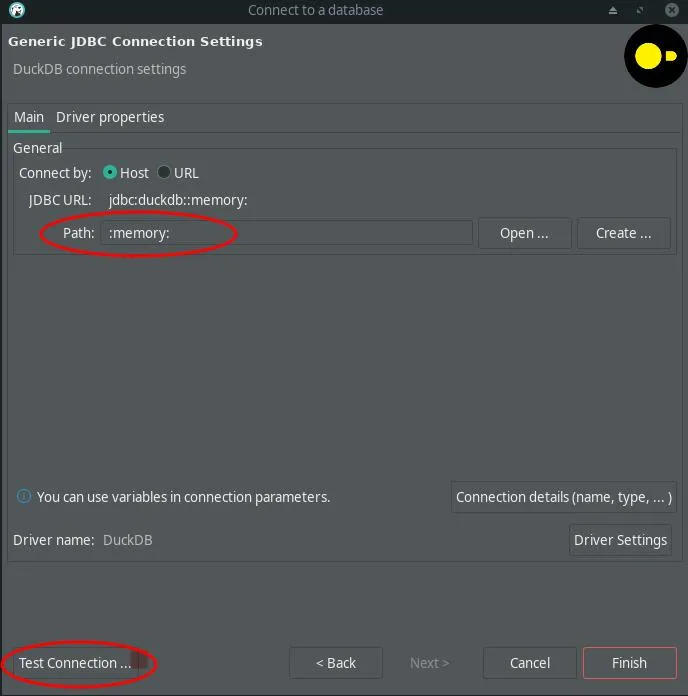
В поле «Path» введите «:memory:», а затем нажмите на кнопку «Test Connection», находящуюся внизу. Убедитесь, что у Вас есть подключение к Интернету. Если драйвер загружен и установлен правильно, Вы должны увидеть следующее всплывающее окно.
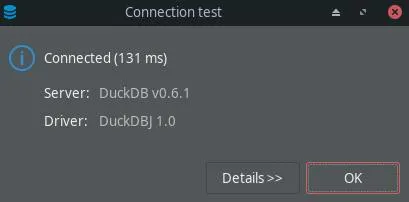
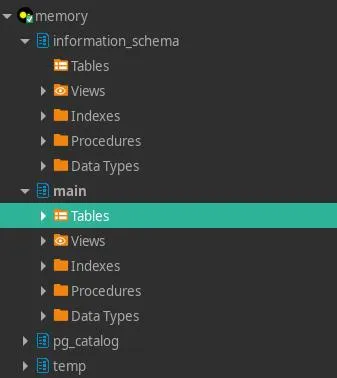
После успешного выполнения теста просто нажмите на кнопку «Finish» и Вы вернетесь в корневой пользовательский интерфейс ide. В нем появится подключение к базе данных, и Вы сможете открыть дерево под этим подключением. Там не будет никаких таблиц.
Что делать, если при подключении к duckdb Вы столкнулись с ошибкой? В первую очередь, проверьте свой Интернет. Проверьте правильность написания «:memory:» в поле path. Если ошибка связана с тем, что драйвер не загружается, перейдите в Window > Preferences. Появится следующее диалоговое окно, в котором Вам нужно выбрать Connections > Drivers > Maven:
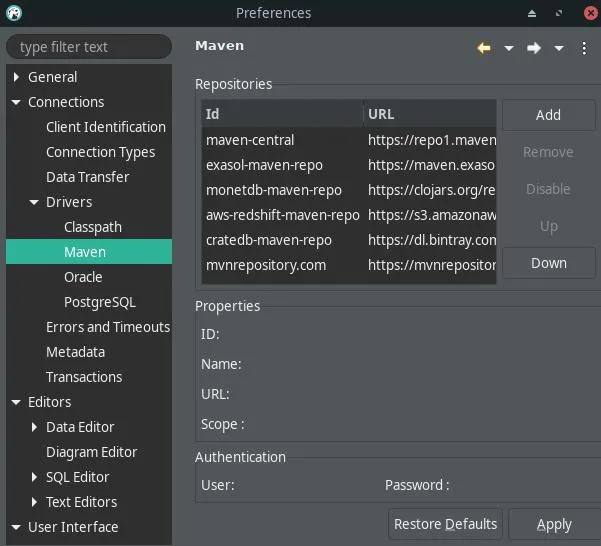
В приведенном выше диалоговом окне нажмите кнопку «Add» и вставьте https://mvnrepository.com/ . Затем попробуйте создать подключение к базе данных. Должно сработать.
Соединение IDE с БД
В ide перейдите в меню SQL Editor > New SQL Script для того, чтобы открыть совершенно новый скрипт. По умолчанию он не будет иметь никаких подключений к базе данных, связанных с ним. Сначала нужно назначить скрипту подключение к базе данных.
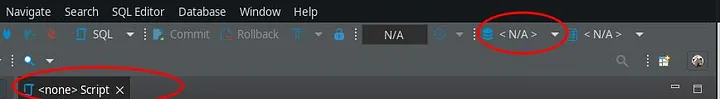
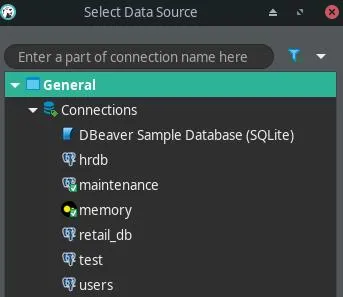
После успешного назначения соединения с базой данных Ваш скрипт будет выглядеть следующим образом:
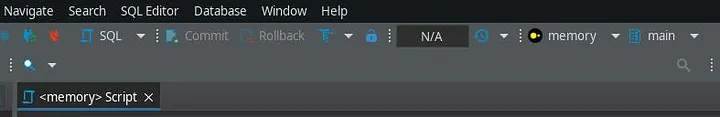
Подождите. Мы не использовали Duckdb. Так как же мы подключаемся к базе данных? Если Вы подумали об этом, то Вы - молодец. Помните о драйвере, который загружается на этапе подключения к базе данных, этот драйвер позаботится о создании «In memory db» внутри ide.
Тогда почему Вы заставили нас скачать duckdb? У меня были проблемы с тем, что ide иногда «падала» из-за некоторых непредвиденных проблем. В это время Вы можете просто продолжить обучение с помощью интерфейса duckdb, создав следующие команды:
# At your commmand prompt or shell
$ wget https://github.com/duckdb/duckdb/releases/download/v0.6.1/duckdb_cli-linux-i386.zip
$ ls

  duckdb
# preferebly move it to /usr/bin directory, or add the directory where you have
# duckdb to the system path

$ mv duckdb /usr/bin

or

$ export PATH=$PATH:/path/to/directory/having/duckdb/

# change directory to folder containing the downloaded dataset

$ ls
dimensions_country.csv dimensions_indicator.csv facttable.csv

$ ./duckdb

# that command will yeild

D.

# that D is the prompt of duckdb... Yeah, can be confusing to some.
Создание таблиц и их заселение данными
Мы будем работать с файлом SQLScript. Я предполагаю, что Вы ниндзя уровня Data-hacker и получили супер идею для создания соединения. Вы готовы ко всему. Пожалуйста, введите следующие команды в редакторе. Автодополнение в dbeaver ide просто феноменально. Могу поспорить, что с этого момента Вы никогда больше не будете вставлять SQL-запросы самостоятельно:
/*Please **type** the below code into the SQL script and change the path*/

/*We are using the wealth indicator dataset from kaggle.*/
/*https://www.kaggle.com/datasets/robertolofaro/selected-indicators-from-world-bank-20002019?select=dimension_country.csv */

drop table if exists fact_table

CREATE TABLE fact_table AS SELECT * FROM read_csv_auto('/path/to/data/facttable.csv', header=True)

drop table if exists dimension_country

CREATE TABLE dimension_country AS SELECT * FROM read_csv_auto('/path/to/data/dimension_country.csv', header=True)

drop table if exists dim_indicator

CREATE TABLE dim_indicator AS SELECT * FROM read_csv_auto('/path/to/data/dimension_indicator.csv', header=True)

/*The above commands are executed after the in memory database is connected in
dbeaver
Note: if the dbeaver instance is closed the in_memory tables are lost
in the database.*/

select *
from fact_table ft
limit 5

/*output will be as below. I copy pasted the outputfrom the ide*/
Country Code|Indicator Code   |2000             |2001             |2002             |
------------+-----------------+-----------------+-----------------+-----------------+
AFE         |IC.BUS.DISC.XQ   |                 |                 |                 |
AFE         |IC.CRD.INFO.XQ   |                 |                 |                 |
AFE         |FS.AST.PRVT.GD.ZS| 74.9798926334367|  77.003129903379| 62.4323760940614|
AFE         |EG.USE.ELEC.KH.PC| 780.702623963529| 743.916043970902| 769.080854071567|
AFE         |EG.IMP.CONS.ZS   |-31.3910700728529|-29.1363228434745|-32.9108840507047|

/*you can check for other tables also*/
Если у Вас все получилось, посмотрите на время. Сколько времени это заняло? Теперь попробуйте сделать это на обычной базе данных. Теперь мы можем поставить галочку напротив слов «оптимальное составление запросов и ввод данных». Мы увидим всю мощь изучаемого нами инструмента только тогда, когда начнем моделировать данные...
Диаграмма ER : Набор данных «Индикаторы благосостояния»:
Давайте немного повеселимся... Найдите таблицы под «DataBase Navigator» на боковой панели внутри ide.
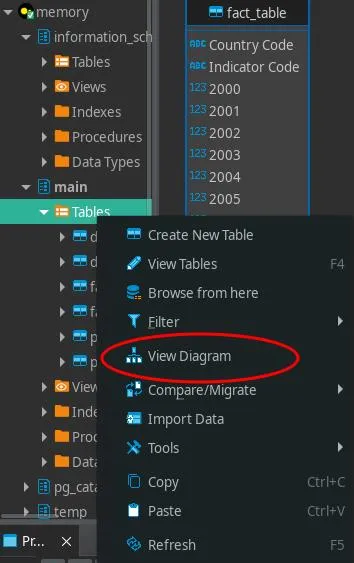
Щелкните правой кнопкой мыши gj этой таблице и найдите опцию «View Diagram». Нажмите на нее, и Вы увидите заветную диаграмма «ERD».
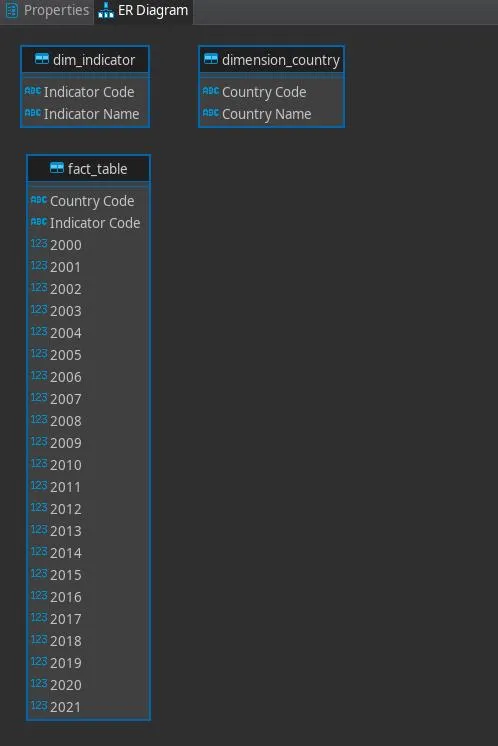
Эта диаграмма дает полное представление о наборе данных. Предположим, что в наборе данных имеется 10 ~ 15 таблиц. Вам нужно смоделировать и проанализировать их. Насколько полезной может быть эта ER-диаграмма? Теперь давайте перейдем к моделированию данных. ide не моделирует данные за Вас...
Время страшилок
Когда я решил написать эту статью, я думал, что при анализе данных моделирование данных не требуется. Я анализировал наборы данных, которые «не были смоделированы». Я соединял 5 разных таблиц, и количество строк увеличивалось до 1 000 000!!! Максимальное значение max_rows составляло 870 000 строк. Работа с последней таблицей занимала более 15 минут, а запись все никак не хотела заканчиваться...
Вот запрос к используемому мной набору данных «. Взгляните на файл telemetry.csv в этом наборе данных. Я удвоил усилия и занялся моделированием данных.
select t.machine_id , t.volt ,t.rotate, t.pressure ,t.vibration ,
 e.errorid ,f.failure , mc.comp , m."age", m.model  from telemetry t join errors e  on t.machine_id = e.machineid  right outer join failures f  on t.machine_id = f.machine_id  right outer join maint_comp mc  on t.machine_id = mc.machine_id  right outer join machines m  on t.machine_id = m.machine_id
Хорошая страшилка. Возьмем наш набор данных из 3 таблиц, который выглядит достаточно обыденным. У Вас есть таблицы, и у Вас есть dbeaver, который позволяет соединять таблицы без особых усилий. Выполнив следующее соединение, Вы завершите процесс создания данных. Действительно ли это самый оптимальный способ?
Зачем создавать модели данных для таблиц?
Ответ: для того, чтобы получить уверенность в данных внутри объединенных таблиц.
# query explanation is not provided...
 select ft."2000" , dc."Country Name" , di."Indicator Name" , ft."Country Code" , dc."Country Code"  from dim_indicator di left outer join fact_table ft  on ft."Indicator Code" = di."Indicator Code"  join dimension_country dc  on ft."Country Code" = dc."Country Code" # output is truncated 2000             |Country Name                  |Indicator Name                           -----------------+------------------------------+----------------------------------------                  |Africa Eastern and Southern   |Business extent of disclosure index (0=l                  |Africa Eastern and Southern   |Depth of credit information index (0=low  74.9798926334367|Africa Eastern and Southern   |Domestic credit to private sector (% of   780.702623963529|Africa Eastern and Southern   |Electric power consumption (kWh per capi -31.3910700728529|Africa Eastern and Southern   |Energy imports, net (% of energy use)                     |Africa Eastern and Southern   |Expense (% of GDP)                                        |Africa Eastern and Southern   |Fixed broadband subscriptions (per 100 p  1.86083099700546|Africa Eastern and Southern   |Fixed telephone subscriptions (per 100 p  3.35077349562722|Africa Eastern and Southern   |GDP growth (annual %)                                     |Africa Eastern and Southern   |Gini index                                3.76910996437073|Africa Eastern and Southern   |Government expenditure on education, tot # Ensure the row count is not more than largest row count, in this case 8778 select count(*)  from dim_indicator di left outer join fact_table ft  on ft."Indicator Code" = di."Indicator Code"  join dimension_country dc  on ft."Country Code" = dc."Country Code" row_count 8778
После объединения таблиц Вы прокручиваете и проверяете код_страны из fact_table и dimension_country. Они совпадают. Итоговая таблица, созданная в результате, является абсолютно надежной и достоверной. Разве это не идеально?
Недостатки отсутствия моделирования данных: Вы понимаете, что вместо того, чтобы доверять серверу базы данных, Вы проверяете итоговую объединенную таблицу вручную. Люди не должны делать ту работу, которую могут и должны делать машины. Ручная проверка вредит производительности работы разработчиков и команды в целом, приводит к неожиданным ошибкам, а также к неоптимальному использованию вычислительной мощности, которая находится в Вашем распоряжении.
Что такое моделирование данных?
Ответ: Набор ограничений, фиксируемых в таблице базы данных до того, как в нее будут скопированы данные. Пример может лучше прояснить ситуацию.
На ER-диаграмме Вы видите линии от столбца к имени другого столбца. Эти линии означают ограничения, накладываемые одним столбцом на другой столбец в другой таблице.
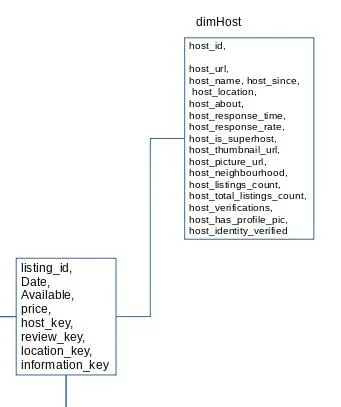
Обратите внимание на то, что модель данных «заносится» в центральную таблицу fact_table до того, как в нее будут помещены данные. Так что если нам нужно смоделировать данные в fact_table wealth_indicators, то мы должны создать таблицу с этими ограничениями. Код будет выглядеть так:
## Recreating the fact_table as fact_data with the foreign key constraints
 CREATE TABLE fact_data(country_code varchar references dimension_country("country code"),   indicator_code varchar references dimension_indicator("indicator code"),   year2000 NUMERIC ,year2001 NUMERIC ,year2002 NUMERIC ,year2003 NUMERIC,  year2004 NUMERIC ,year2005 NUMERIC ,year2006 NUMERIC ,year2007 NUMERIC,  year2008 NUMERIC ,year2009 NUMERIC,  year2010 NUMERIC ,year2011 NUMERIC ,year2012 NUMERIC ,year2013 NUMERIC,  year2014 NUMERIC ,year2015 NUMERIC ,year2016 NUMERIC ,year2017 NUMERIC,  year2018 NUMERIC ,year2019 NUMERIC ,year2020 NUMERIC ,year2021 NUMERIC  )
Эти условия внешнего ключа вместе с условиями ссылки накладывают ограничение на таблицу fact_data. Аналогичные ограничения можно добавить и к существующим таблицам внутри обычных баз данных SQL с помощью команды Alter table + add foreign key.
Некоторые проблемы, связанные с In - Memory базами данных
Если Вы запустите приведенный выше код, ide «пожалуется», что столбец country_code ссылается на столбец в таблице country_code, который не является первичным ключом и не уникален.
Это происходит потому, что мы создали таблицу in-memory, просто импортировав CSV. Столбцы в этой таблице были созданы duckdb. Существует и другой способ импорта данных с помощью команды COPY:
create table primary_country(country_code varchar primary key unique,
        country_name varchar)

create table primary_indicator(indicator_code varchar primary key unique,
        indicator_name varchar)

COPY primary_country FROM '/path/to/data/dimension_country.csv' (DELIMITER ',', HEADER);

COPY primary_indicator FROM '/path/to/data/dimension_indicator.csv' (DELIMITER ',', HEADER);
Вышеописанный метод, при котором сначала создаются таблицы, а затем в них загружаются данные, может показаться не самым оптимальным. Но его польза станет очевидной очень скоро. После того, как Вы получили вышеуказанные таблицы, таблицу fact_data можно переписать:
CREATE TABLE fact_data(country_code varchar references primary_country(country_code),
  indicator_code varchar references primary_indicator(indicator_code),   year2000 NUMERIC ,year2001 NUMERIC ,year2002 NUMERIC ,year2003 NUMERIC,  year2004 NUMERIC ,year2005 NUMERIC ,year2006 NUMERIC ,year2007 NUMERIC,  year2008 NUMERIC ,year2009 NUMERIC,  year2010 NUMERIC ,year2011 NUMERIC ,year2012 NUMERIC ,year2013 NUMERIC,  year2014 NUMERIC ,year2015 NUMERIC ,year2016 NUMERIC ,year2017 NUMERIC,  year2018 NUMERIC ,year2019 NUMERIC ,year2020 NUMERIC ,year2021 NUMERIC  )
На этот раз ide примет создание таблицы, поскольку ключи, используемые в таблице, ссылаются на первичные ключи в таблицах Primary_country и Primary_indicator. Таким образом, данные будут загружены в таблицу.
Заключительный этап
COPY fact_data FROM '/path/to/data/facttable.csv' (DELIMITER ',', HEADER);
При выполнении указанной выше команды COPY данные будут скопированы из csv в таблицу базы данных fact_data. Если в файле «facttable.csv» есть данные, которые не соответствуют «ограничениям», установленным в таблице fact_data, то сервер базы данных ide/ выдаст ошибку и остановит процесс копирования. При этом Вы можете быть уверены, что данные в таблице fact_data не содержат дубликатов или ошибочных данных.
Что дальше???
Последний раздел должен развеять Ваш страх перед «вводом данных» в таблицу базы данных. Предоставить рабочие знания о внешних ключах и, наконец, сделать процесс моделирования данных таким же «горячим», как «заливка раскаленного металла в штамп».
В промежутках между шагами модифицируйте код и изучайте ide, команды SQL join и where. Делайте запросы и смотрите, что происходит с данными. Попробуйте поработать с набором данных snl, состоящим из 11 таблиц дл того, чтобы четкое представление о моделировании данных. После этого, если Вы изучаете Data Science, выполните то же самое упражнение, но уже с помощью pyspark, а затем попробуйте создать модель линейной регрессии или прогностическую модель.
Полезные ссылки:
- https://duckdb.org/docs/installation/index
- https://dbeaver.io/download/
- https://www.youtube.com/@DarshilParmar
- https://www.guru99.com/
- https://docs.rilldata.com/
- https://www.kaggle.com/datasets/
Надеюсь, мой опыт будет Вам полезен. Спасибо за внимание!


