

Решите проблемы data governance с помощью продуктов данных
Что именно делает данные управляемыми, чем именно нужно управлять, куда интегрировать ИИ и многое-многое другое!
Мы заметили одну интересную особенность, особенно за последние пару лет. На всех конференциях, обсуждениях в сообществе лидеров или на мероприятиях, посвященных основным данным, на которых мы бывали, каждый раз поднимался вопрос data governance. Всегда.
Data governance всегда оказывалось в центре внимания, когда лидеры и практики из числа участников начинали задавать вопросы о своих проблемах или описывали болевые точки в поисках наиболее оптимальных решений.
Тема управления данными стала одной из центральной тем, особенно с учетом того факта, что команды по работе с данными переросли рамки небольшого бэк-офиса и превратились в огромные «человеческие» сети, в которых взаимодействуют аналитики, инженеры, персонал по работе с данными на стороне клиента, домены, руководители высшего звена и многие другие структуры.
Мы твердо верим в продуктовый подход к разработке данных. В 2018 году (более шести лет назад) мы начали соединять части воедино, это вылилось в надежное решение не только для данных для бизнеса, но и для действительно сложных вещей: базовых операций, таких как управляемое управление, водопровод и оптимизированные по стоимости «золотые пути».
Вот наш подход к управлению данными, включающий рекомендации, лучшие практики и советы. Данные как продукт – вот наш приговор.
Что мы рассматриваем как data governance?
Governance - это обширная тема, и мы заметили, что разные организации и эксперты определяют ее по-разному. Каждому свое, но нам, как команде разработчиков корпоративных платформ, необходимо понимать более широкую и комплексную картину.
Поэтому для нас governance - это «зонтичный» термин, покрывающий множество мелких аспектов.
Управлять данными - значит следить за здоровым функционированием стека данных или руководить им.
Сюда же входят такие очевидные элементы, такие как управление безопасностью и доступом. Но что еще более интересно, каждая из этих широких вертикалей состоит из множества элементов, которые чаще всего исключаются из разговоров об управлении данными:
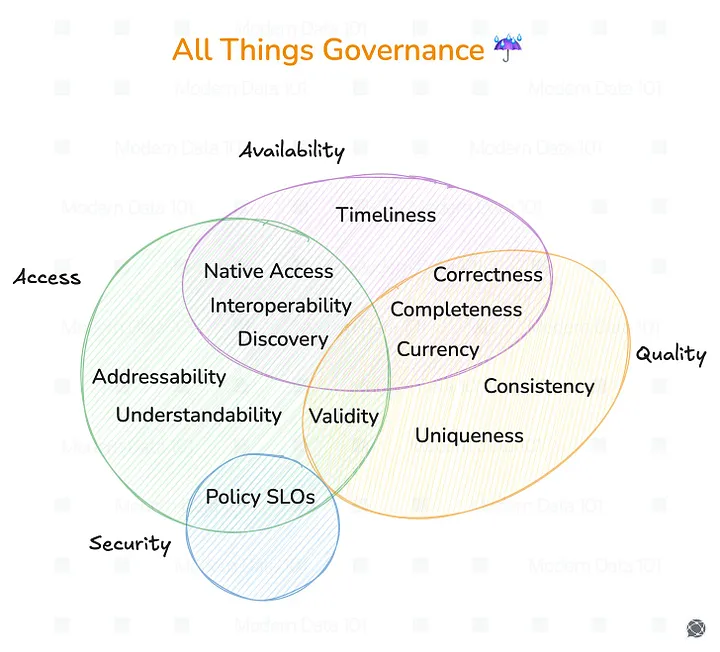
Доступ и наличие
Что действительно интересно , так это то, что доступ - это не только безопасность или управление метками пользователей. Если курьер не может разобраться адресе, он никогда не сможет найти Ваш дом.
Поэтому обеспечение доступа как один из столпов управления данными включает в себя обеспечение всех нижеперечисленных аспектов:
- Обнаружение: Могут ли граждане, пользующиеся моими данными, найти то, что им нужно?
- Адресность: Обнаружения недостаточно для удобства использования. Технически Вы лишены доступа, если не можете использовать данные. Могут ли граждане, пользующиеся моими данными, легко обращаться к активам, чтобы использовать их в дальнейшем?
- Понятность: То же самое, что и выше. Не понимая данных, Вы не сможете их использовать (получить к ним доступ).
- Доступность: Могут ли граждане, пользующиеся моими данными, использовать их с помощью доступных им средств?
- Интегрированность: Могут ли мои граждане получать доступ к данным в рамках интегрированной экосистемы данных?

Доступ и безопасность
- Доступ на основе политики: Имеют ли граждане адекватный доступ и нужные ограничения?
- Соответствие требованиям безопасности: Защищен ли стек данных от нежелательного доступа и потенциальных угроз?
Качество и наличие
- Корректность: Достаточно ли точны данные, предназначенные для использования?
- Полнота: Имеются ли все необходимые точки данных?
- Актуальность: Являются ли данные актуальными?
- Своевременность: Своевременно ли данные доступны для использования?
- Последовательность: Единообразно ли регистрируются и используются данные в разных точках?
- Уникальность: Существуют ли в данных дубликаты или дублирование?
- Пригодность: доступны ли данные в соответствии с удобными для бизнеса форматами или требованиями?
Управлять данными или не управлять данными?
Хитрость управления данными заключается в том, чтобы не управлять ими. Да-да, Вы не ослышались. Давайте разберем это безумие, чтобы понять суть вещей.
Каждый источник данных имеет свое собственное управление (политики доступа и другие SLO). Управление в основном становится проблемой, когда возникает необходимость унифицировать управление, разрешая конфликты на одних и тех же данных (когда данные попадают в одни и те же бакеты для последующей обработки или доставки).
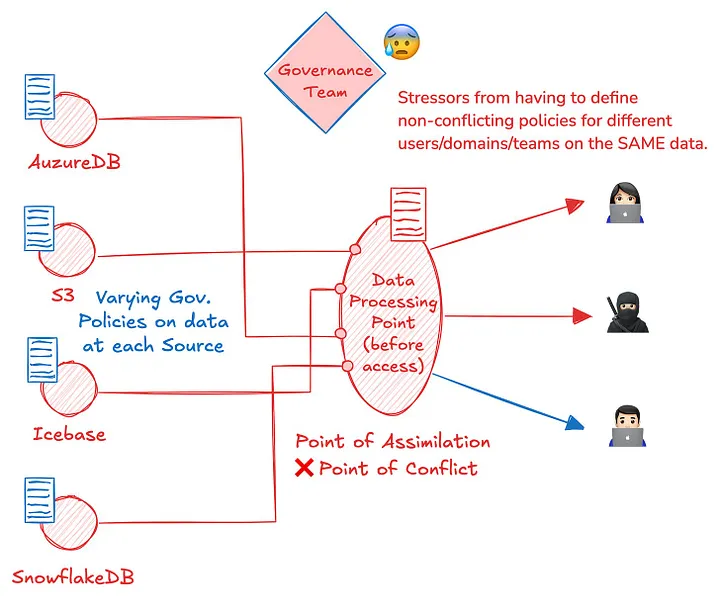
Когда исходные данные попадают в общий бакет для обработки, ответственность за обеспечение правильного доступа и условного качества после преобразования ложится как на разработчиков данных, так и на управляющие органы. А это означает противоречивые SLO.
Каждая область имеет свои приоритеты и требования к аналогичным данным. Например, отделу продаж может потребоваться ежедневное обновление данных о лидах в отделе маркетинга, в то время как маркетинг установил ежемесячную периодичность обновлений.
Маркетинг может не захотеть устанавливать гранулярность «ежедневно» вместо «ежемесячно», поскольку это влечет за собой более высокие затраты со стороны маркетинга. Разрешение конфликта должно происходить на бизнес-уровне, где стратегические роли должны быть итеративными = более длительные циклы решения.
Теперь рассмотрим такую ситуация, когда оба домена имеют разные конечные точки потребления одних и тех же данных, а стоимость требуемых SLO отнесена непосредственно на счет требующей стороны.
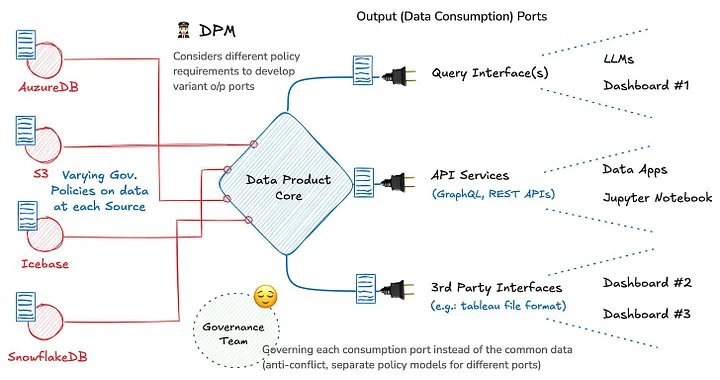
Стратегия: Не управляйте данными; управляйте доставкой данных в точках потребления.
Вот краткое описание того, почему данный подход сработал в стеках продуктов данных:
Разрешение конфликта
При возникновении конфликтов (например, проблем с доступом к данным или их качеством) их разрешение ближе к месту потребления обеспечивает более быстрое устранение последствий без воздействия на вышестоящие источники данных. Такой локализованный подход позволяет сбалансировать потребности различных заинтересованных сторон, сохраняя гибкость и сводя к минимуму задержки, вызванные централизованной политикой.
Распределенное выполнение политики из центральной точки принятия решений
Центральная точка принятия решений о политике создает единый набор правил управления, однако эти самые правила применяются в различных точках потребления в зависимости от конкретных потребностей потребителя данных. Такая структура обеспечивает последовательность применения политик, позволяя при этом вносить коррективы в зависимости от контекста, обеспечивать сквозную видимость и оптимизировать управление данными в соответствии с местными и глобальными требованиями.
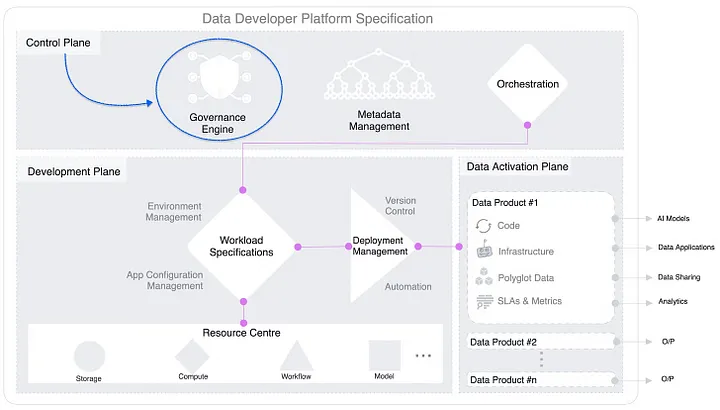
Вот почему в платформе для разработчиков данных механизм управления размещается в центральной точке для управления доступом на основе политик и целей к различным точкам доступа в облачных средах с приоритетом локального владения.
Гибкость
Управление портами позволяет быстрее адаптироваться к изменяющимся потребностям бизнеса, поскольку потребители данных могут получить доступ к тому, что им нужно, не будучи ограниченными жесткими политиками управления, применяемыми ко всем источникам данных.
Фокус на ценности
Управление данными в точке потребления гарантирует, что ресурсы будут направлены на предоставление высококачественных данных там, где они оказывают наибольшее влияние на бизнес, оптимизируя пользовательский опыт и процесс принятия решений. Обработка данных по целевому принципу также помогает в управлении FinOps, как мы видели на примере продаж и маркетинга выше.
Эффективность
Уменьшает накладные расходы на управление политиками управления огромными объемами необработанных данных, вместо этого концентрируя усилия на том, чтобы только релевантные, курируемые данные доходили до целевой аудитории с требуемым качеством и соответствием требованиям.
Оптимизированное потребление данных
Приспосабливая data governance к точкам потребления, организации повышают удобство использования данных, делая их более согласованными с бизнес-целями, аналитическими потребностями и нормативными требованиями на момент использования.
Управлять или не управлять метаданными?
В течение долгого времени существовал консенсус относительно того, что метаданные не нуждаются в ограничениях доступа. Метаданные должны быть открыты для всех для выполнения основных задач, таких как обнаружение данных и принятие решений об их использовании. Протоколы доступа и управления появились позже.
Однако предприятия осознали, что со временем это может привести к фатальным последствиям. Например, недобросовестный агент, имеющий доступ к метаданным безобидного на первый взгляд актива, может также знать, что он находится в том же регионе, что и более конфиденциальный актив. Агент может запросить разрешение на доступ к пути безобидного файла и при этом унаследовать доступ к промежуточным путям или облегчить доступ к конфиденциальным элементам.
В результате под угрозой оказываются такие активы, как данные о сотрудниках, о клиентах, о продажах и финансовые данные.
Поэтому управление метаданными имеет решающее значение наряду с управлением данными. Однако управление метаданными должно осуществляться иначе, чем управление данными.
Метаданные выступают в качестве интерфейса доступа: они позволяют пользователям определить, нужен ли им доступ к данным и если да, то в какой степени.
Стратегия: Сохраняйте метаданные настолько открытыми, насколько это возможно, и ограничивайте их там, где это необходимо.
ИИ-агент для повышения оперативности управления данными
Прежде чем мы углубимся в эту тему, вот несколько очень важных замечаний:
- НЕ делегируйте стратегию искусственному интеллекту
- НЕ предоставляйте ИИ доступ к изменению (например, для адаптивного управления данными, когда агенты ИИ изменяют элементы управления доступом или проверки качества данных в режиме реального времени)
- Используйте ИИ для управления ТОЛЬКО в качестве вспомогательного средства
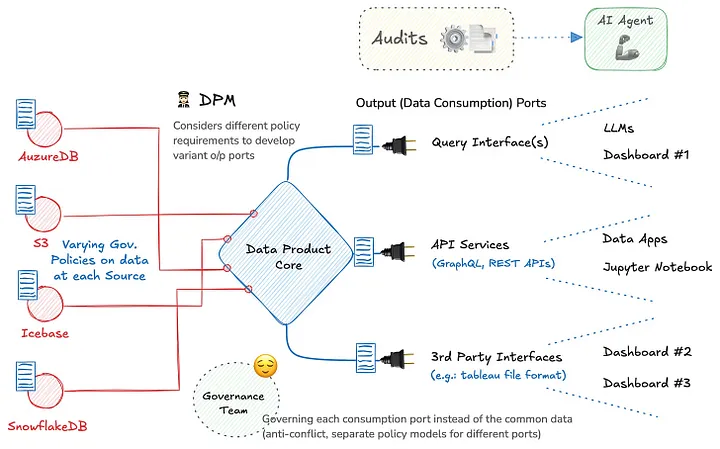
Хотя на точках потребления данных применяются различные модели политик, результаты проверок регистрируются централизованно и передаются агенту искусственного интеллекта, который позволяет упростить мониторинг и управление.
Автоматизированный мониторинг
Агенты искусственного интеллекта анализируют аудиты управления для того, чтобы убедиться, что использование данных в точках потребления соответствует политике организации и нормативным требованиям (например, GDPR, HIPAA). Постоянно сканируя журналы аудита, ИИ обнаруживает нарушения или отклонения от стандартов и предупреждает ответственных за управление данными или автоматически применяет корректирующие действия.
Обнаружение аномалий
Агенты искусственного интеллекта используют журналы аудита для выявления аномалий в схемах доступа к данным, отмечая необычные действия, такие как попытки несанкционированного доступа, утечка данных или непоследовательное поведение пользователей. Такое обнаружение в режиме реального времени повышает безопасность данных и помогает предотвратить потенциальные утечки информации.
Оптимизация доставки данных или шаблонов использования продуктов данных
Анализируя модели потребления данных, полученные в ходе аудита, агенты ИИ предсказывают, к каким наборам данных обращаются чаще всего, и оптимизируют конвейеры данных для повышения производительности. Они обнаруживают закономерности в том, как различные заинтересованные стороны используют продукты данных. Это помогает более эффективно распределять ресурсы, сокращать задержки и улучшать доставку данных конечным пользователям.
Анализ коренных причин проблем data governance
Агенты искусственного интеллекта могут сопоставлять данные аудита управления с другими системными журналами для анализа первопричин проблем управления, таких как проблемы целостности данных или повторяющиеся нарушения нормативных требований.
Автоматизированная отчетность
Агенты искусственного интеллекта регулярно генерируют отчеты о состоянии управления данными и ключевых показателях, таких как соответствие требованиям, запросы на доступ и инциденты, связанные с качеством данных. Эти отчеты помогают командам управления и руководителям оставаться в курсе событий без необходимости просматривать журналы вручную.


