

Производительность Python и Parquet
В Pandas, PyArrow, fastparquet, AWS Data Wrangler, PySpark и Dask.
В этом посте мы рассказываем о том, как использовать распространенные библиотеки Python для чтения и записи формата Parquet, используя все преимущества столбцового хранения, сжатия и разбиения данных. Используемые вместе, эти три оптимизации могут значительно ускорить ввод-вывод для приложений на Python по сравнению с CSV, JSON, HDF или другими форматами, основанными на строках. Parquet делает возможной работу приложений, которые не воспринимают текстовые форматы, такиекак JSON или CSV.
Примечание: этот пост был написан в октябре 2020 года. Он устареет, если в комментариях Вы не укажете на ошибки. Спасибо!
P.S.На сайте Apache Parquet появилась довольно хорошая документация по формату Parquet.
Введение
В последнее время я стал лучше понимать, как работать с наборами данных Parquet с помощью шести инструментов, используемых для чтения и записи из Parquet в экосистеме Python: Pandas, PyArrow, fastparquet, AWS Data Wrangler, PySpark и Dask. Моя работа в последнее время в области алгоритмической торговли предполагает частое переключение между этими инструментами, и, как я уже говорил, я часто путаю API. Я использую Pandas и PyArrow для вычислений в оперативной памяти и машинного обучения, PySpark для ETL, Dask для параллельных вычислений с numpy.arrays и AWS Data Wrangler с Pandas и Amazon S3. Я также использовал fastparquet с pandas, когда у его движка PyArrow возникали проблемы.
Самое первое, что я делаю, когда работаю с новым набором колоночных данных любого размера, - это конвертирую его в формат Parquet... и при этом постоянно забываю API, поскольку работаю с разными библиотеками и вычислительными платформами. Мне надоело искать разные инструменты и их API, поэтому я решил составить инструкции для всех них в одном месте. Как итог, я написал обзор формата Parquet, а также руководство и чек-лист для инструментов Pythonic, которые используют Parquet, чтобы мне (и, надеюсь, Вам) больше никогда не пришлось их искать.
Формат Parquet оптимизирован тремя основными способами: хранение по столбцам, сжатие по столбцам и разбиение данных. Четвертый способ - группы строк, но я не буду рассматривать его сегодня, поскольку большинство инструментов не поддерживают ассоциацию ключей с определенными группами строк без взлома. Ниже я подробнее расскажу о каждой из этих оптимизаций, а затем покажу, как воспользоваться преимуществами каждой из них с помощью наиболее популярных инструментов для работы с данными Pythonic.

Хранение и сжатие данных с ориентацией на столбцы
Человекочитаемые форматы данных, такие как CSV, JSON, а также большинство распространенных транзакционных баз данных SQL, хранятся в строках. Когда Вы прокручиваете строки в файле, ориентированном на строки, столбцы располагаются в зависимости от формата по всей строке. В наши дни текст довольно хорошо сжимается, так что Вы можете обойтись довольно небольшим количеством вычислений, используя эти форматы. Однако в какой-то момент, когда размер Ваших данных перейдет в гигабайтный диапазон, загрузка и запись данных на одной машине сойдет на нет и займет целую вечность. Это становится серьезным препятствием для науки о данных и машинного обучения, которые по своей сути являются итеративными. Длительное время итераций - это первое препятствие на пути эффективного программиста. Нужно что-то делать!
Вводим форматы данных, ориентированные на столбцы. Эти форматы хранят каждый столбец данных вместе и могут загружать их по одному за раз. Это приводит к двум оптимизациям производительности:
1. Вы платите только за те столбцы, которые загружаете. Это называется колоночным хранением.
Пусть m - общее количество колонок в файле, а n - количество колонок, запрошенных пользователем. Загрузка n столбцов приводит к увеличению объема необработанного ввода-вывода всего на n/m.
2. Сходство значений в отдельных столбцах приводит к более эффективному сжатию. Это называется колоночным сжатием.
Обратите внимание на столбец event_type в формате, ориентированном как на строки, так и на столбцы, на диаграмме ниже. Алгоритму сжатия будет гораздо проще сжать повторы значения party в этом столбце, если они составляют все значение для данной строки, как в формате, ориентированном на столбец. В отличие от этого, формат, ориентированный на строки, требует, чтобы алгоритм сжатия определил, что повторы в строке встречаются с некоторым смещением, которое будет зависеть от значений в предыдущих столбцах. Это гораздо более сложная задача.
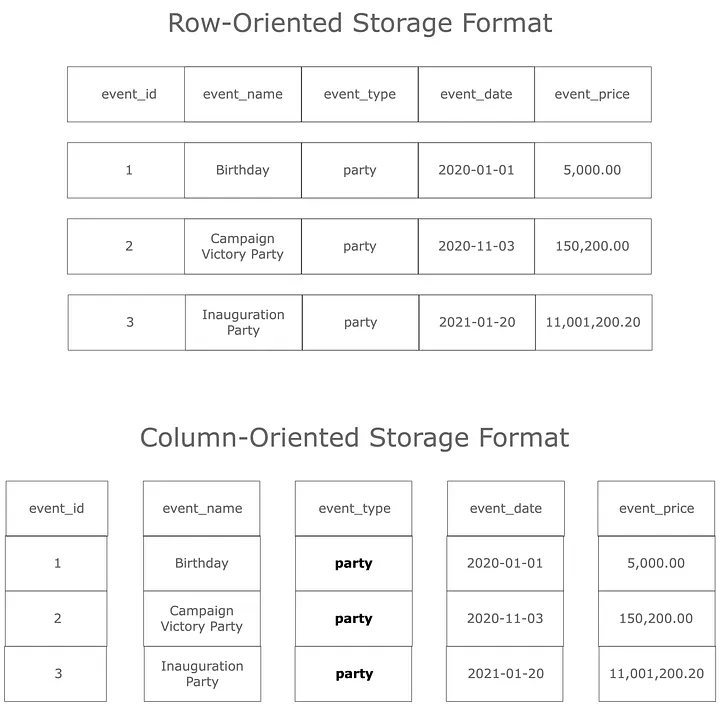
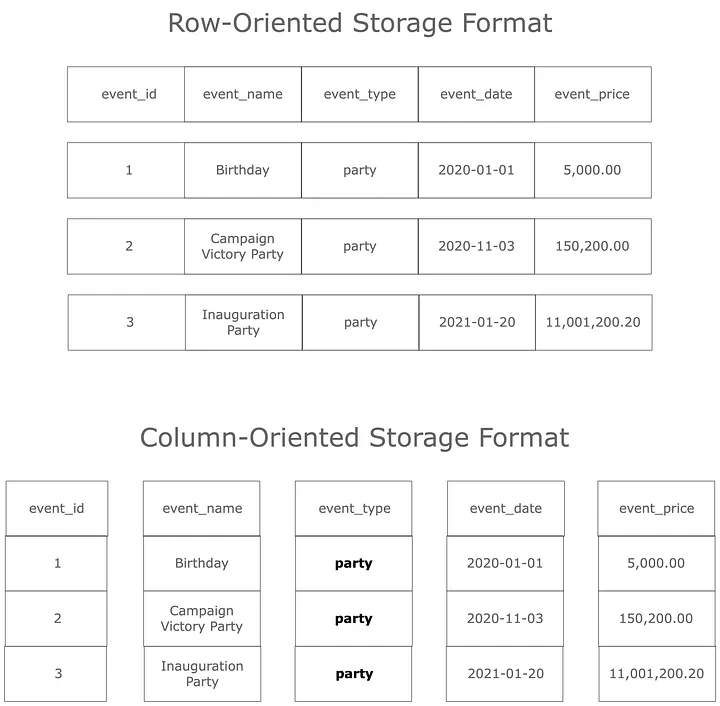
Колоночное хранение в сочетании с колоночным сжатием дает значительное повышение производительности для большинства приложений, которым не требуется каждый столбец в файле. Я часто использовал PySpark для загрузки данных CSV или JSON, которые долго загружались, и преобразовывал их в формат Parquet, после чего их использование с PySpark или даже на одном компьютере в Pandas становилось более быстрым и безболезненным.
Колоночное партиционирование
Другой способ, с помощью которого Parquet делает данные более эффективными, - это разбиение данных на уникальные значения в одном или нескольких столбцах. Каждое уникальное значение в схеме разделения по столбцам называется ключом. Используя формат, изначально определенный Apache Hive, для каждого ключа создается одна папка, а дополнительные ключи хранятся во вложенных папках. Это называется колоночным партиционированием, и в сочетании со столбцовым хранением и столбцовым сжатием оно позволяет значительно повысить производительность ввода-вывода при загрузке части набора данных, соответствующей ключу раздела.
Набор данных Parquet, разделенный по полу и стране, будет выглядеть так:
path └── to └── table ├── gender=male │ ├── … │ │ │ ├── country=US │ │ └── data.parquet │ ├── country=CN │ │ └── data.parquet │ └── …
Каждое уникальное значение для столбцов «пол» и «страна» получает папку и подпапку соответственно. Листья этих деревьев папок-разделов содержат файлы Parquet, использующие столбцовое хранение и столбцовое сжатие, поэтому любое улучшение эффективности происходит за счет этих оптимизаций!
Колоночное партиционирование оптимизирует загрузку данных следующим образом:
- Пусть l - все ключи в столбце. Пусть k - количество ключей, представляющих интерес. Загрузка k ключей требует всего лишь k/l необработанных операций ввода-вывода.
Разбиение на группы строк
Существует также разбиение на группы строки (если Вам нужно разделить данные логически), но большинство инструментов поддерживают только указание размера группы строк, и Вам придется самостоятельно выполнять поиск `ключ → группа строк`. Это ограничивает его применение. Недавно я использовал финансовые данные, в которых отдельные активы были разделены по их идентификаторам с помощью групп рядов, но поскольку инструменты не поддерживают эту функцию, загрузка нескольких ключей происходила со скрипом, поскольку для того, чтобы сопоставить ключ с соответствующей группой рядов, приходилось разбирать метаданные Parquet вручную.
Для получения дополнительной информации о том, как работает формат Parquet, ознакомьтесь с документацией PySpark Parquet.
Разделы Parquet с помощью Pandas и PyArrow
Pandas интегрируется с двумя библиотеками, поддерживающими Parquet: PyArrow и fastparquet. Они указываются через аргумент engine в команде pandas.read_parquet() и pandas.DataFrame.to_parquet() соответственно.
Чтобы хранить определенные столбцы Pandas.DataFrame с помощью разделения данных с помощью Pandas и PyArrow, используйте аргументы compression='snappy', engine='pyarrow' и partition_cols=[]. Сжатие Snappy необходимо в том случае, если Вы хотите добавить данные.
df.to_parquet(
    path='analytics',      engine='pyarrow',     compression='snappy',     partition_cols=['event_name', 'event_category']  )
В результате дерево папок и файлов выглядит следующим образом:
analytics.xxx/event_name=SomeEvent/event_category=SomeCategory/part-1.snappy.parquet
analytics.xxx/event_name=SomeEvent/event_category=OtherCategory/part-1.snappy.parquet analytics.xxx/event_name=OtherEvent/event_category=SomeCategory/part-1.snappy.parquet analytics/event_name=OtherEvent/event_category=OtherCategory/part-1.snappy.parquet
Теперь, когда файлы Parquet разложены таким образом, мы можем использовать ключи столбцов разделов в фильтре, чтобы ограничить загружаемые данные. Метод pandas.read_parquet() принимает аргументы engine, columns и filters. Аргумент columns использует преимущества колоночного хранения и сжатия колонок, эффективно загружая только файлы, соответствующие тем колонкам, которые мы запрашиваем. Аргумент filters использует преимущества разделения данных, ограничивая загружаемые данные определенными папками, соответствующими одному или нескольким ключам в столбце разделения. Ниже мы загрузим сжатые столбцы event_name и other_column из папки раздела event_name папки SomeEvent.
df = pd.read_parquet(
    path='analytics',     engine='pyarrow',      columns=['event_name', 'other_column'],     filters=[('event_name', '=', 'SomeEvent')] )
Чтение разделов Parquet с помощью PyArrow
У PyArrow есть свой собственный API, который можно использовать напрямую. Чтобы загрузить записи из одного или нескольких разделов набора данных Parquet с помощью PyArrow на основе их ключей разделов, мы создадим экземпляр pyarrow.parquet. parquetDataset, используя аргумент filters с кортежным фильтром внутри списка (подробнее об этом сказано ниже).
ParquetDatasets порождают таблицы, которые в свою очередь порождают pandas.DataFrames. Для преобразования определенных столбцов ParquetDataset в pyarrow.Table мы используем ParquetDataset.to_table(columns=[]). to_table() получает свои аргументы из метода scan(). Затем следует to_pandas() для создания pandas.DataFrame. Не волнуйтесь, ввод-вывод происходит только в конце.
Здесь мы загружаем столбцы event_name и other_column из раздела Parquet на S3, соответствующие значению event_name SomeEvent из аналитики. И to_table(), и to_pandas() имеют параметр use_threads, который следует использовать для ускорения производительности.
import pyarrow.parquet as pq
import s3fsfs = s3fs.S3FileSystem()dataset = pq.ParquetDataset(     's3://analytics',      filesystem=fs,      filters=[('event_name', '=', 'SomeEvent')],      use_threads=True ) df = dataset.to_table(     columns=['event_name', 'other_column'],      use_threads=True ).to_pandas()
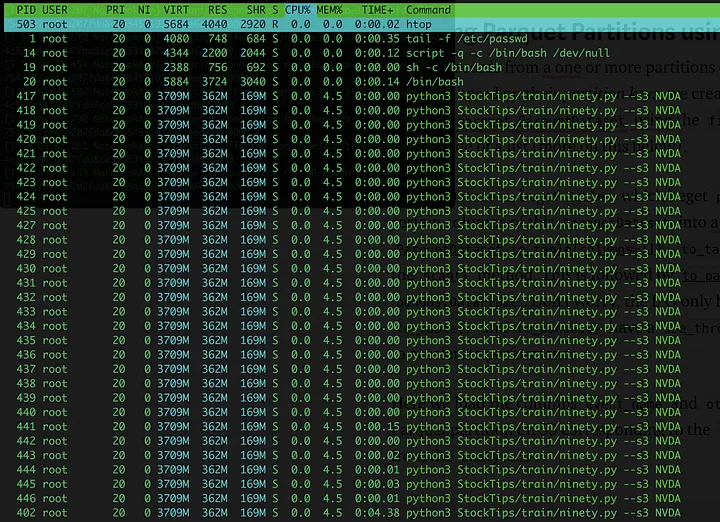
Таким образом, использование потоков приводит к одновременному чтению из S3 в домашней сети.
Вы можете загрузить отдельный файл или локальную папку непосредственно в apyarrow.Table с помощью pyarrow.parquet.read_table(), но это пока не поддерживает S3.
import pyarrow.parquet as pqdf = pq.read_table(
     path='analytics.parquet',     columns=['event_name', 'other_column'] ).to_pandas()
Фильтрация разделов PyArrow
Документация по фильтрации разделов с помощью аргумента filters довольно сложна, но в итоге сводится к следующему: кортежи нужно вложить в список для OR и во внешний список для AND.
filters (List[Tuple] or List[List[Tuple]] or None (default))Rows which do not match the filter predicate will be removed from scanned data. Partition keys embedded in a nested directory structure will be exploited to avoid loading files at all if they contain no matching rows. If use_legacy_dataset is True, filters can only reference partition keys and only a hive-style directory structure is supported. When setting use_legacy_dataset to False, also within-file level filtering and different partitioning schemes are supported.Predicates are expressed in disjunctive normal form (DNF), like [[('x', '=', 0), ...], ...]. DNF allows arbitrary boolean logical combinations of single column predicates. The innermost tuples each describe a single column predicate. The list of inner predicates is interpreted as a conjunction (AND), forming a more selective and multiple column predicate. Finally, the most outer list combines these filters as a disjunction (OR).Predicates may also be passed as List[Tuple]. This form is interpreted as a single conjunction. To express OR in predicates, one must use the (preferred) List[List[Tuple]] notation.Чтобы использовать оба ключа раздела для захвата записей, соответствующих ключу event_name SomeEvent и его подразделу event_category SomeCategory, мы используем логику булевых AND - единый список из двух кортежей фильтра.
dataset = pq.ParquetDataset(
     's3://analytics',      filesystem=fs,      filters=[          ('event_name', '=', 'SomeEvent'),         ('event_category', '=', 'SomeCategory')     ] ) df = dataset.to_table(     columns=['event_name', 'other_column'] ).to_pandas()
Чтобы загрузить записи из ключей SomeEvent и OtherEvent раздела event_name, мы используем логику булева OR - вложение кортежей фильтра в собственные внутренние списки AND внутри внешнего списка OR.
dataset = pq.ParquetDataset(
     's3://analytics',      filesystem=fs,      validate_schema=False,      filters=[          [('event_name', '=', 'SomeEvent')],         [('event_name', '=', 'OtherEvent')]     ] ) df = dataset.to_table(     columns=['event_name', 'other_column'] ).to_pandas()
Запись наборов данных Parquet с помощью PyArrow
PyArrow записывает наборы данных Parquet с помощью pyarrow.parquet.write_table().
import pyarrow
 import pyarrow.parquet as pqtable = pyarrow.Table.from_pandas(df) pq.write_to_dataset(     table,     'analytics',     partition_cols=['event_name', 'other_column'],      use_legacy_dataset=False )
Для записи наборов данных Parquet в Amazon S3 с помощью PyArrow необходимо использовать класс s3fs пакета s3fs.S3Filesystem (который при необходимости можно сконфигурировать с учетными данными через параметры key и secret, или использовать ~/.aws/credentials):
import pyarrow
 import pyarrow.parquet as pq import s3fss3 = s3fs.S3FileSystem()table = pyarrow.Table.from_pandas(df) pq.write_to_dataset(     table,     's3://analytics',     partition_cols=['event_name', 'other_column'],      use_legacy_dataset=False,     filesystem=s3 )
Разделы Parquet на S3 с помощью AWS Data Wrangler
Самый простой способ работать с разделенными на части наборами данных Parquet на Amazon S3 с помощью Pandas – это AWS Data Wrangler через PyPi пакет awswrangler через методы awswrangler.s3.to_parquet() и awswrangler.s3.read_parquet().AWS приводит отличные примеры в этом блокноте. Обратите внимание, что Wrangler работает на основе PyArrow, но предлагает простой интерфейс с большими возможностями.
Чтобы записать разделенные данные в S3, установите dataset=True и partition_columns=[]. Для повышения производительности необходимо установить use_threads=True.
import awswrangler as wrwr.s3.to_parquet(
     df=df,     path='s3://analytics',     dataset=True,     partition_cols=['event_name', 'event_category'],     use_threads=True,     compression='snappy',     mode='overwrite' )
Чтение данных Parquet с фильтрацией по разделам работает иначе, чем в PyArrow. В awswrangler Вы используете функции для фильтрации по определенным ключам разделов.
df = wr.s3.read_parquet(
     path='s3://analytics',     dataset=True,     columns=['event_name', 'other_column'],       partition_filter=lambda x: x['event_name'] == 'SomeEvent',     use_threads=True )
Обратите внимание, что в любом из этих методов Вы можете передать свой собственный boto3_session, если Вам нужно аутентифицироваться или установить другие параметры S3.
Разделение Parquet с помощью Google Cloud Storage
Как и в случае с AWS, panads.read_parquet() не будет работать с папкой parquet, состоящей из одного или нескольких файлов (разбитых на разделы или нет) на GCS.
import gcsfs
 import pyarrow.parquet as pq# Add credentials or rely on gcloud CLI setup gs = gcsfs.GCSFileSystem()ds = pq.ParquetDataset("gs://analytics", filesystem=gs)df = ds.read_pandas().to_pandas()
Партиционирование Parquet с помощью fastparquet
Fastparquet- это библиотека Parquet, созданная людьми, которые подарили нам Dask, замечательный движок для распределенных вычислений, о котором я расскажу ниже. До написания этого поста я не использовал FastParquet напрямую, и мне было интересно попробовать его. Чтобы записать данные из pandas DataFrame в формат Parquet, используйте fastparquet.write.
import fastparquetfastparquet.write(
     df,     compression='SNAPPY',     partition_on=['event_name', 'event_category'] )
Для загрузки определенных столбцов разделенной коллекции используются fastparquet.ParquetFile и ParquetFile.to_pandas(). ParquetFile не принимает имя каталога в качестве аргумента path, поэтому вам придется пройтись по пути каталога Вашей коллекции и извлечь все имена файлов Parquet. Затем Вы указываете в качестве аргумента корневой каталог, и FastParquet может прочитать Вашу схему разбиения. Фильтры кортежей работают так же, как и PyArrow.
import os
 from glob import glob import fastparquet# Walk the directory and find all the parquet files within parquet_root = 'analytics' parquet_files = [y for x in os.walk(parquet_root) for y in glob(os.path.join(x[0], '*.parquet'))]# The root argument lets it know where to look for partitions pf = fastparquet.ParquetFile(parquet_files, root=parquet_root)# Now we convert to pd.DataFrame specifying columns and filters df = pf.to_pandas(     columns=['event_name', 'other_column'],      filters=('event_name', '=', 'SomeEvent') )
Вот и все! В конечном итоге я не смог заставить FastParquet работать, потому что мои данные были сжаты PySpark с помощью сжатия snappy, которое fastparquet не поддерживает. Однако я не сомневаюсь, что он все-таки работает, поскольку я много раз использовал его в Pandas через аргумент engine='fastparquet' всякий раз, когда в движке PyArrow возникали ошибки :)
Партиционирование Parquet с помощью PySpark
Существует жесткое ограничение на объем данных, который можно обработать на одной машине с помощью Pandas. За его пределами Вам придется использовать такие инструменты, как PySpark или Dask. Как евангелист Hadoop я научился мыслить на языке map/reduce/iterate и свободно владею PySpark, поэтому часто использую именно его. PySpark использует API pyspark.sql.DataFrame для работы с наборами данных Parquet. Чтобы создать разбитый на части набор данных Parquet из DataFrame, используйте класс pyspark.sql.DataFrameWriter, доступ к которому обычно осуществляется через свойство Write DataFrame с помощью метода parquet() и его аргумента partitionBy=[].
df.write.mode('overwrite').parquet(
     path='s3://analytics',     partitionBy=['event_type', 'event_category'],     compression='snappy' )
Чтобы прочитать этот разбитый на разделы набор данных Parquet обратно в PySpark, используйте pyspark.sql.DataFrameReader.read_parquet(), доступ к которому осуществляется через свойство SparkSession.read. Цепочка метода pyspark.sql.DataFrame.select() для выбора определенных столбцов и метода pyspark.sql.DataFrame.filter() для фильтрации по определенным разделам.
import pyspark.sql.functions as F
 from pyspark.sql import SparkSessionspark = SparkSession \     .builder \     .appName('Analytics Application') \     .getOrCreate()df = spark.read.parquet('s3://analytics') \           .select('event_type', 'other_column') \            .filter(F.column('event_type') == 'SomeEvent')
Вам не нужно ничего рассказывать Spark об оптимизациях Parquet, он сам разберется, как использовать преимущества столбцового хранения, столбцового сжатия и разделения данных. Круто же?
Партиционирование Parquet с помощью Dask
Dask - это фреймворк распределенных вычислений для Python, который Вы захотите использовать, если Вам нужно будет перемещаться по массивам numpy.arrays - что часто случается в машинном обучении или GPU-вычислениях в целом (см.: RAPIDS). Это то, что PySpark просто не может сделать, и именно поэтому у него есть свой собственный независимый набор инструментов для всего, что связано с машинным обучением. Чтобы использовать PySpark для своих конвейеров машинного обучения, Вам придется использовать Spark ML (MLlib). Но только не для Dask! Вы можете использовать стандартные инструменты Python. До того как я нашел HuggingFace Tokenizers (который настолько быстр, что достаточно одного Rust pid), для параллельной токенизации данных я использовал Dask. Я также использовал его и в поисковых приложениях для массового кодирования документов с помощью точно настроенных моделей BERT и Sentence-BERT.
На первых порах мне было трудно работать с Dask, но с тех пор, как я начал запускать свои собственные рабочие машины, я полюбил его (Вам не стоит этого делать, я начинал с автоматизации QA и, как следствие, ломал все со скоростьсветаю). Если Вы используете Dask, то, скорее всего, захотите использовать одну или несколько машин для параллельной обработки наборов данных, поэтому захотите загружать файлы Parquet с помощью собственных API Dask, а не использовать Pandas и затем преобразовывать их в dask.dataframe.DataFrame.
Разработана прекрасная документация на тему записи и чтения Dask DataFrames. Для этого используются функции dask.dataframe.read_parquet() и dask.dataframe.to_parquet(). Чтобы прочитать Dask DataFrame из Amazon S3, укажите путь, лямбда-фильтр, любые параметры хранения и количество потоков, которые нужно использовать. Вы можете выбрать между движками fastparquet и PyArrow. read_parquet() возвращает столько разделов, сколько существует файлов Parquet, поэтому имейте в виду, что вам может потребоваться переразметка() после загрузки, чтобы использовать все ядра вашего компьютера (компьютеров).
import dask.dataframe as dd
 import s3fs from dask.distributed import Clientclient = Client('127.0.0.1:8786')# Setup AWS configuration and credentials storage_options = {     "client_kwargs": {         "region_name": "us-east-1",     },     "key": aws_access_key_id,     "secret": aws_secret_access_key }ddf = dask.dataframe.read_parquet(     path='s3://analytics',     columns=['event_name', 'other_column'],     filter=lambda x: x['event_name'] in TICKERS,     storage_options=storage_options,     engine='pyarrow',      nthreads=8, )
Для записи сразу же запишите Dask DataFrame в формат Parquet с разбиением на разделы dask.dataframe.to_parquet(). Обратите внимание, что Dask будет записывать по одному файлу на раздел, поэтому, возможно, Вам захочется переразбить его на столько файлов, сколько Вы хотите читать параллельно, не забывая о том, сколько ключей разделов имеют Ваши столбцы разделов, поскольку каждый из них будет иметь свой собственный каталог.
import dask.dataframe as dd
 import s3fsdask.dataframe.to_parquet(     ddf,     's3://analytics',     compression='snappy',     partition_on=['event_name', 'event_type'],      compute=True, )
Заключение
Ну вот и все! Мы рассмотрели все способы чтения и записи наборов данных Parquet в Python с использованием столбцового хранения, столбцового сжатия и разбиения данных. При совместном использовании эти три оптимизации обеспечивают быстрый доступ к данным.
Надеюсь, это поможет Вам при работе с Parquet.


