

Apache Iceberg: Hadoop современного стека данных?
В начале 2010-х годов Apache Hadoop занимал лидирующие позиции в области Big Data. Организации спешили внедрить его, рассматривая как краеугольный камень для масштабируемого, распределенного хранения и обработки данных. Сегодня среди современных Data Lake и Data Lakehouse на первый план постепенно выходит Apache Iceberg .
Однако те, кто пережил «эру больших данных», при более глубоком рассмотрении обнаруживают поразительное сходство между траекторией развития Iceberg и историей Hadoop.
Давайте рассмотрим эти параллели и попробуем понять, что именно они означают для будущего инженерии данных.
Преемственность: Решение правильной проблемы в правильное время
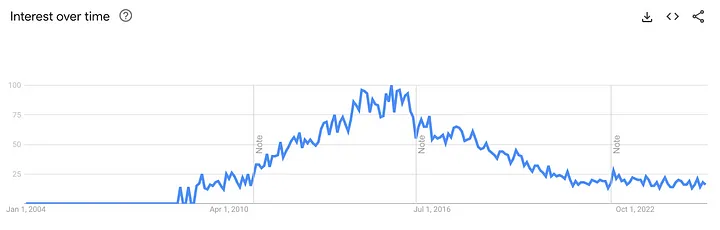
Появление Hadoop было вызвано острой необходимостью в распределенном хранении и обработке файлов, что позволило решить проблему «потопа больших данных». Аналогичным образом Iceberg решает основную проблему озер данных: управление большими, постоянно меняющимися наборами данных с соблюдением ACID и эволюцией схем.
Однако внедрение технологий часто происходит по принципу маятника: обещание решить серьезную проблему способствует слишком быстрому внедрению. Стремительный взлет Hadoop привел к тому, что многие организации стали внедрять его, не понимая всех его сложностей, что часто приводит к «недоиспользованию» кластеров или чрезмерной инженерии архитектур. Iceberg идет по аналогичному пути. Возможность объединения пакетных и потоковых рабочих нагрузок в сочетании с такими функциями, как эволюция схем, сделала его достаточно привлекательным вариантом. Однако распространение Iceberg часто опережает возможности организаций по его эффективному внедрению.
Важно: Внедрение должно быть обусловлено организационной зрелостью. Прыжок в Iceberg без четкой стратегии работы с данными может привести к техническому долгу и неудовлетворенным ожиданиям. Например, финансовая компания может принять Iceberg для обеспечения ACID-гарантий в своих конвейерах по выявлению мошенничества, но при этом она будет испытывать трудности со стратегиями уплотнения данных, поскольку ее потоковая система генерирует слишком много маленьких файлов.
Успешное внедрение Iceberg требует такого же внимания, как и Hadoop, - а именно сосредоточения на развитии навыков, согласовании рабочих нагрузок и поэтапной интеграции.

Проблема маленьких файлов
Одной из самых распространенных проблем Hadoop является «проблема маленьких файлов». HDFS не была рассчитана на эффективную обработку большого количества маленьких файлов, что приводило к снижению производительности. Организации часто прибегали к ночным заданиям по уплотнению или сложным конвейерам ETL для объединения данных.
В этом плане Iceberg не является исключением. Хотя он и абстрагирует большую часть уровня хранения, небольшие файлы все же остаются заметной проблемой. Например, конвейеры потоковых данных или частые инкрементные записи могут привести к снижению производительности вследствие чрезмерной нагрузки на метаданные. Такие инструменты, как Apache Spark и Flink, широко используемые с Iceberg, только усугубляют эту проблему, если их не настроить должным образом.
Однако на этом проблемы не заканчиваются: проблема маленьких файлов значительно влияет на стоимость хранения объектов (вспомните количество запросов к S3), для уплотнения данных требуются экспоненциальные дополнительные вычисления и так далее.
Например, рассмотрим компанию, занимающуюся розничной торговлей и собирающую данные о потоке кликов. Плохо настроенное задание Flink записывает данные в таблицы Iceberg с размером файла по умолчанию 10 МБ. Со временем эти маленькие файлы накапливаются, раздувая каталог метаданных и замедляя производительность запросов. Внедрение периодических заданий уплотнения и настройка пороговых значений размера файлов в Flink могли бы решить эту проблему.
В качестве еще одного примера рассмотрим компанию Estuary Flow, которая использует сразу несколько трюков для эффективной передачи данных в файлы Parquet. Она позволяет пользователям распределять материализацию данных по времени даже в потоковой среде, чтобы затем согласовать ее с расписанием уплотнения.
Настройка размера файла и стратегии записи очень важны. Для этого мы настоятельно рекомендуем использовать такие инструменты, как адаптивное выполнение запросов Apache Spark, для оптимизации разбиения на разделы или встроенные в Iceberg утилиты уплотнения для периодического объединения небольших файлов. Игнорирование этих задач может превратить многообещающее развертывание Iceberg в кошмар.
Слишком сложный технологический стек
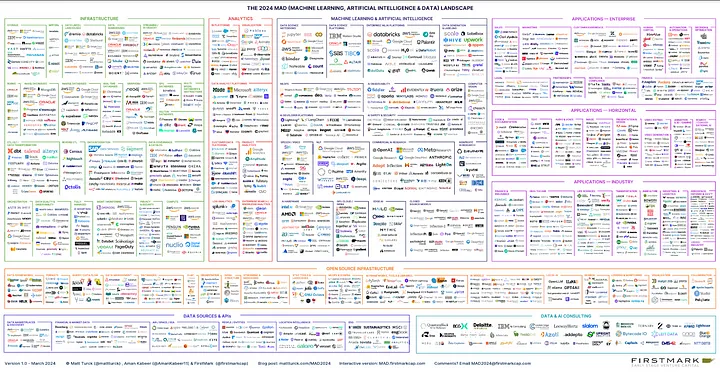
Hadoop никогда не был самостоятельным продуктом. Он требовал наличия целого ряда инструментов - HBase для чтения в реальном времени, Hive для SQL-запросов и Spark для расширенной аналитики. Управление этой сложной системой требовало специальных навыков и сложной оркестровки.
Iceberg, несмотря на все свои упрощения, по сути точно такой же. Но его сила заключается в экосистеме: движки запросов (Trino, Spark, Flink), бэкенды хранилищ (S3, GCS, HDFS) и каталоги (Hive, Glue, Nessie, Polaris, Unity, REST Catalog и, вероятно, многие другие...). Возможности конфигурирования просто ошеломляющие. Например, стратегии разбиения могут существенно повлиять на производительность запросов, а выбор неправильной реализации каталога может ограничить масштабируемость системы.
Эта сложность подчеркивает простую истину: ни один инструмент не является островом, существующим сам по себе. Успех Iceberg зависит не только от его возможностей, но и от экосистемы, которая его окружает. Компании, преуспевающие в работе с Iceberg, часто придерживаются подхода «инженерии платформы», создавая внутренние инструменты и автоматизацию для управления метаданными, мониторинга производительности и оркестровки рабочих нагрузок.
Оверхеды метаданных: новый уровень сложности технологического стека
Узкое место NameNode в Hadoop стало примером того, как управление метаданными может снизить производительность системы. Благодаря распределенной модели метаданных на основе моментальных снимков Iceberg позволяет избежать единой точки отказа. По мере роста размеров таблиц увеличивается количество снимков и манифестов, что приводит к разрастанию хранилищ метаданных.
Одна многие медиакомпании довольно успешно используют Iceberg для управления петабайтами данных видеоаналитики. Со временем история моментальных снимков бесконтрольно разрастается, что приводит к увеличению времени планирования запросов. Благодаря периодическому истечению срока действия моментальных снимков и уплотнению манифеста они поддерживают постоянную производительность запросов, контролируя тем самым рост метаданных.
Мой совет: относитесь к метаданным как к гражданам первого класса. Автоматизируйте задачи обрезки и уплотнения моментальных снимков и инвестируйте в решения для мониторинга, которые позволяют выявлять узкие места в метаданных на самых ранних стадиях.
Создать vs. Купить
На ранних этапах развития Hadoop организациям приходилось создавать все с нуля. Управляемые сервисы, такие как Cloudera и AWS EMR, в конечном счете упростили внедрение, но при этом были достигнуты определенные компромиссы в плане стоимости и гибкости.
Перед пользователями Iceberg стоит аналогичная задача. Самостоятельное размещение предлагает максимальный контроль и требует опыта в масштабировании и настройке. Управляемые решения, такие как Iceberg tables от Snowflake или Starburst Galaxy, снижают операционные расходы, но могут ограничить гибкость системы и привести к привязке к поставщику.
Решение сводится к ключевым компетенциям Вашей организации. Если Ваша команда уже преуспела в DevOps, самостоятельное размещение может обеспечить наилучшую рентабельность инвестиций. И наоборот, небольшим командам или тем, кто еще только начинает осваивать Iceberg, для ускорения внедрения лучше воспользоваться управляемыми услугами сторонних производителей.
Эффект сообщества: живой, но разрозненный
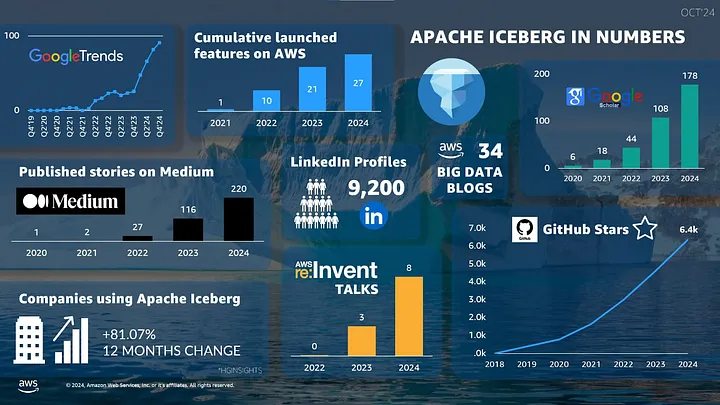
Hadoop расцвел благодаря сотрудничеству с открытыми источниками, но его раздробленность - Spark vs MapReduce, Hive vs Impala - привела к путанице. Iceberg выигрывает от активного сообщества разработчиков с открытым исходным кодом. Однако конкурирующие форматы таблиц, такие как Delta Lake и Hudi, также отражают эту фрагментацию.
Хотя конкуренция стимулирует инновации, она также может и затормозить внедрение. Усилия по стандартизации - например, более глубокая интеграция Iceberg с механизмами запросов - будут иметь решающее значение для его долгосрочного успеха. Появление слоев функциональной совместимости, аналогичных эре метахранилищ Hive, может определить следующую главу в истории развития Iceberg.
Что Next значит для Iceberg?
Несмотря на все параллели с Hadoop, Iceberg выигрывает за счет ретроспективного подхода. Сообщество разработчиков данных научилось отдавать предпочтение простоте, масштабируемости и облачным архитектурам. Вот ключевые тенденции:
1. Консолидация
Подобно тому, как Spark стал доминирующим движком в экосистеме Hadoop, в эпоху Iceberg может появиться доминирующий формат и каталог таблиц. Эта консолидация будет способствовать стандартизации, будь то сам Iceberg или какое-либо другое решение.
Такие проекты, как Apache XTable работают над тем, чтобы сделать взаимодействие между форматами таблиц максимально простым.
2. Операционная зрелость
Следующая волна инструментов Iceberg будет направлена на снижение операционной сложности. Уже сейчас появляются различные управляемые сервисы и фреймворки оркестровки, которые идут по стопам Databricks и Snowflake.
Недавно анонсированная компанией Amazon система S3 Tables является отличным тому примером. Она абстрагируется от сложностей, связанных с поддержкой таблиц Iceberg, и предлагает встроенный каталог. Побочным эффектом от всего этого является снижение совместимости с остальными компонентами экосистемы.
3. Аналитика и не только
Поддержка Iceberg потоковых и транзакционных рабочих нагрузок позволяет использовать его не только в целях аналитики. Iceberg успешно используется для создания архитектур, управляемых событиями, а также построения пайплайнов машинного обучения в режиме реального времени - сценариев, которые выходят за рамки традиционной пакетной обработки данных.
Заключение
На сегодняшний день Apache Iceberg, как и Hadoop десять лет назад, несомненно, является революционным решением. Но большая мощь неразрывно связана с большой сложностью. Как и в случае с любым другим инструментом в современном стеке данных, успех заключается в согласовании технологии с готовностью, набором навыков и стратегическими целями Вашей организации.
Параллели развития Iceberg с Hadoop поразительны, по этому давайте постараемся избежать уже известных нам подводных камней. Извлекая уроки из прошлого, мы можем гарантировать, что Iceberg будет не просто Hadoop современного стека данных - это именно та эволюция, которую мы так долго ждали.


