

От архитектуры Lakehouse к data mesh
Развитие в направлении создания информационных продуктов и автоматизированного управления в Адевинте, Испания
За последние три года команда разработчиков платформы обработки данных в Адевинте, Испания (CompaaS), которой я имел удовольствие руководить, претерпела глубокие изменения в своей инфраструктуре обработки данных. Этот процесс был основан на внедрении архитектуры lakehouse с использованием блоков данных, а также на разработке нескольких ключевых инициатив, таких как контракты на передачу данных, фреймворки продуктов для обработки данных и т.д. Эти инициативы превратили платформу в среду, которая не только использует принципы data mesh, но и выступает в качестве настоящего катализатора для создания информационных продуктов.
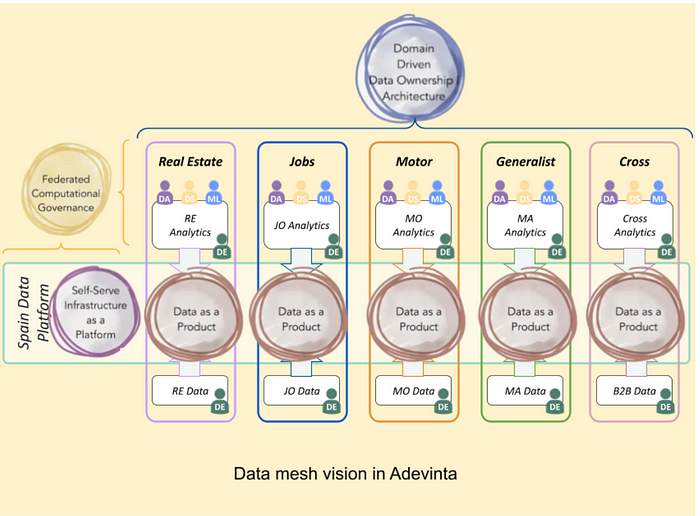
Мы должны представить себя в контексте платформы, которая некоторое время назад превратилась в мультимодальную, многоузловую и многодоменную архитектуру. Это уникальная платформа, используемая разными командами для удовлетворения потребностей различных профилей. Эта структура идеально вписывается в парадигму data mesh. Четыре основных элемента data mesh, как показано на рисунке выше, соответствуют концепции общей, но распределенной платформы, обеспечивающей уникальную рабочую экосистему для различных доменов и предоставляющей им большую автономию.
Эта сеть стала связующим звеном, объединяющим все наши домены в единую платформу. Однако для преобразования его в сетку требовалось не только увидеть соответствие, но и найти преобразующие инициативы, которые позволили бы это осуществить.

Переход от архитектуры lakehouse к data mesh
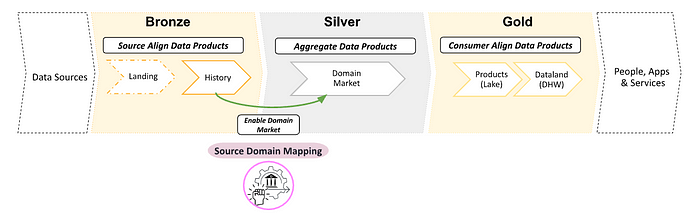
Команда CompaaS начала с существующей многоуровневой архитектуры, которую мы адаптировали и развили в соответствии с архитектурой Medallion. В этой первоначальной архитектуре уже было разделение на уровни, но мы приложили значительные усилия, чтобы преобразовать ее в структуру, которая не только соответствовала бы lakehouse, но и служила основой для реализации принципов data mesh. Таким образом, каждый уровень стал специализированным рабочим пространством для различных типов информационных продуктов, что способствовало большей автономии и специализации в рамках платформы.
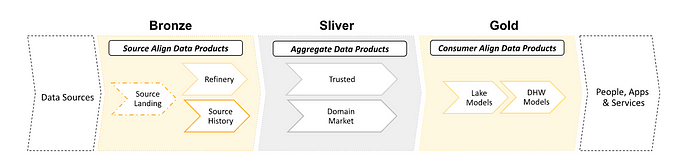
Эти усилия позволили нам адаптировать lakehouse к принципам data mesh, что представляет собой значительный сдвиг в том, как мы управляли данными и информационными продуктами. Каждый слой был переопределен таким образом, чтобы он служил координационным центром для различных функций:
- Слой Bronze стал пространством для ориентированных на источник данных продуктов
- Слой Silver - это пространство для агрегированных продуктов данных
- Слой Gold - это пространство для продуктов данных, ориентированных на потребителя
На диаграмме выше показана эволюция архитектуры Medallion до структуры, которая соответствует принципам data mesh.
Эти слои не обязательно должны быть последовательными. Вместо этого они взаимосвязаны, образуя сетчатую структуру, которая обеспечивает большую гибкость и эффективность использования данных. Ниже вы можете ознакомиться с различными инициативами, которые сыграли фундаментальную роль в этом преобразовании, и с тем, как каждая из них помогает сделать платформу lakehouse надежной основой для различных типов информационных продуктов и конкретных областей нашей компании.
Ключевые инициативы по преобразованию
Описанные ниже инициативы по преобразованию сыграли основополагающую роль в преобразовании архитектуры Adevinta Spain lakehouse в распределенную инфраструктуру, основанную на принципах data mesh. Эти инициативы позволили переосмыслить каждый уровень платформы для улучшения управления, эффективности и автономии команды, способствуя созданию продуктов данных децентрализованным и гибким способом.
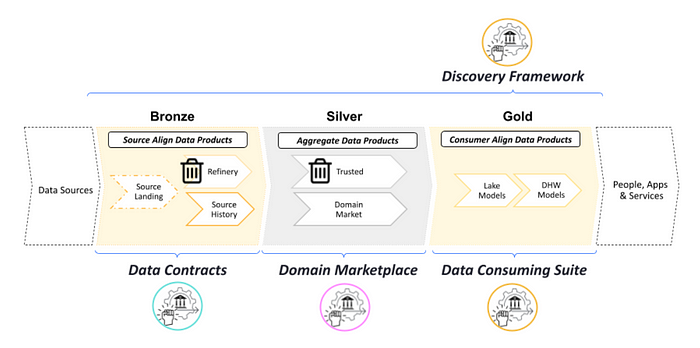
К числу ключевых инициатив относятся:
- Пакет для сбора данных с внедрением контрактов на обработку данных для преобразования уровня bronze в контейнер для продуктов данных, ориентированных на исходные данные
- Domain marketplace для преобразования уровня silver в продукты агрегированных данных
- Пакет для обработки данных и платформа discovery framework преобразуют слой gold в зону информационных продуктов, ориентированную на потребителя
Из слоя bronze в зону информационных продуктов, ориентированную на источник, благодаря контрактам на передачу данных
Для создания надлежащего уровня bronze мы создали декларативную структуру, которая позволяет пользователю создавать контракты на обработку данных, которые процесс будет использовать для получения данных. Эти контракты обрабатывают и выполняют проверку качества на основе событий, создавая необработанный и ориентированный на события слой bronze с индивидуальными событиями.
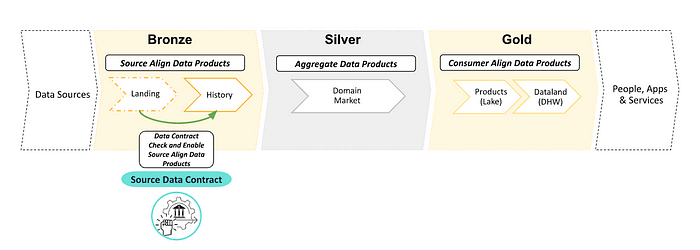
Этот слой обеспечивает основу для информационных продуктов, ориентированных на источник, обеспечивая прослеживаемость и качество с момента их создания. Такой подход облегчает создание информационных продуктов с высокой степенью согласованности и четким механизмом мониторинга и проверки качества.
В этой статье подробно описаны все детали внедрения контрактов на передачу данных в качестве основы декларативного ввода данных для the lakehouse. Эти контракты на передачу данных были основополагающими для обеспечения качества и согласованности данных, облегчения взаимодействия и повторного использования между различными командами. Как видно из диаграммы, события, объекты или входящие данные используются и управляются автоматически на основе информации и инструкций, содержащихся в контракте на передачу данных. Контракт может в режиме реального времени определять, верны ли данные, вызывать ошибки и оповещения, а также обрабатывать полученные данные для контроля и классификации личных данных, автоматизируя соблюдение требований GDPR.
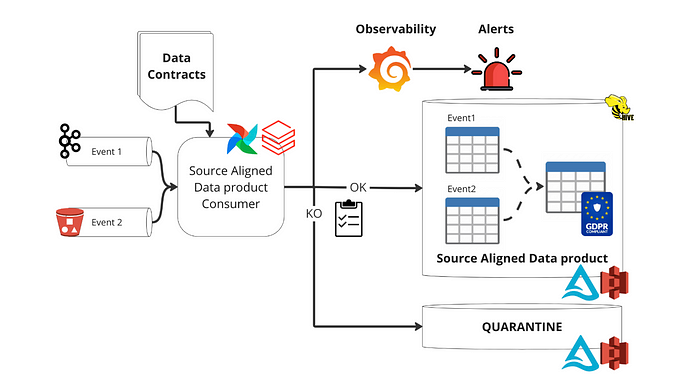
В статье подробно рассказывается о том, как контракты на обработку данных предоставляют структурированные средства для определения четких соглашений между производителями и потребителями данных, устанавливая спецификации в отношении качества, структуры и условий использования данных. Это имеет решающее значение для обеспечения соответствия управления данными стандартам качества и прослеживаемости от источника, гарантируя согласованную и надежную информацию для всех команд.
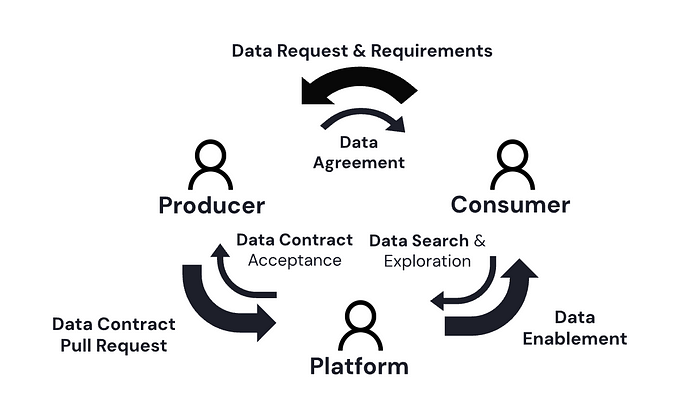
Внедрение этого метода позволило нам изменить процессы приема данных и рабочие потоки. Мы устранили классическое "узкое место" сторонних интеграторов, которые недостаточно хорошо знают данные, чтобы правильно их интегрировать, и не могут масштабироваться из-за большого количества источников интеграции.
Декларативная структура, не требующая кода для интеграции новых данных в lakehouse, упрощает доступ и гарантирует, что у каждого источника есть кто-то, способный создать контракт. Этот человек будет прямым владельцем входящих данных, а производитель будет напрямую взаимодействовать с потребителем. Это позволяет им согласовывать и обсуждать наилучшие данные, которые можно извлечь из источника и интегрировать в lakehouse. Такое распределение задач переносит усилия по интеграции на каждый источник, позволяя масштабировать интеграцию так, как это было бы невозможно при централизованном подходе. Эти два эффекта позволяют начать выполнение аналитических задач и задач по обеспечению качества еще до интеграции данных. Это определяет качество исходного материала для всей последующей аналитики. Таким образом, эта структура обеспечивает большую уверенность в качестве данных, улучшает взаимодействие между доменами и облегчает повторное использование данных — важные элементы для успешной реализации архитектуры data mesh.
От уровня silver до зоны агрегированных продуктов данных благодаря большим таблицам semantic one (или большим объектам).
Мы преобразовали уровень silver в область продуктов с агрегированными данными, чтобы затем преобразовать его в семантический уровень, где агрегация данных основана на семантике предметной области, а не на конкретных вариантах использования. Этот подход позволяет классифицировать и организовывать данные в соответствии с бизнес-моделью, так что каждая агрегация соответствует определенному объекту предметной области. Мы приняли концепцию одной большой таблицы, или больших объектов, чтобы обеспечить соответствие агрегированных данных объектам бизнес-области.
Эти таблицы являются обширными. Они могут содержать несколько столбцов и быть довольно разреженными, поскольку не все столбцы всегда заполнены. Каждая таблица содержит все объекты определенной предметной области в единой структуре, объединяя несколько более детализированных данных, выровненных по источникам, в объект домена. В распределенной архитектуре такой подход оптимизирует доступ к данным, устраняя необходимость в сложных объединениях, поскольку вся необходимая информация для домена содержится в одной таблице. Это обеспечивает большую гибкость в управлении данными, а также создает дополнительные проблемы с конфиденциальностью и управлением по мере роста таблицы.
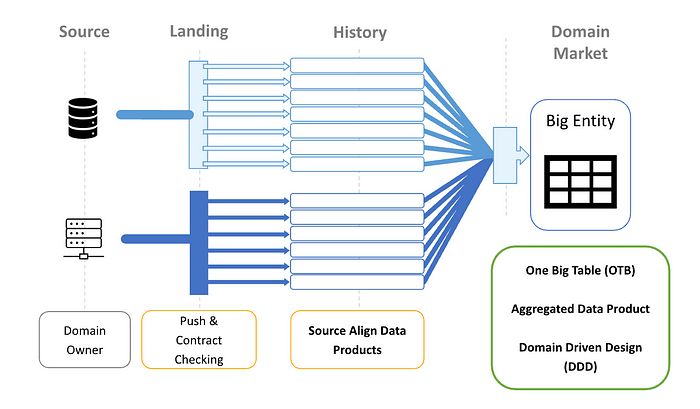
Использование одной большой таблицы значительно облегчает поиск и повторное использование данных. Интеграция семантического уровня в качестве посредника между сложными структурами данных и конечными пользователями позволяет использовать терминологию, соответствующую бизнесу, что упрощает работу как технических, так и нетехнических пользователей. Этот семантический уровень помогает улучшить процесс принятия решений и обеспечивает эффективное управление, обеспечивая единый источник достоверной информации для всей организации.
Что касается концепции семантического уровня, то создание крупных сущностей позволило разработать бизнес-онтологию, которая сопоставляет основные концепции предметной области с моделированием данных. Вместо онтологии с низкой степенью детализации, которая соответствовала бы более конкретным объектам слоя bronze, мы работаем с онтологией среднего или высокого уровня. В ней представлены основные бизнес-концепции, соответствующие организационной структуре Adevinta. Каждая большая таблица отображает одну из этих концепций предметной области, обеспечивая четкое и последовательное представление о наиболее важных для организации объектах, таких как пользователь, клиент, поведение пользователя, покупатель, продавец, публикации и т.д.
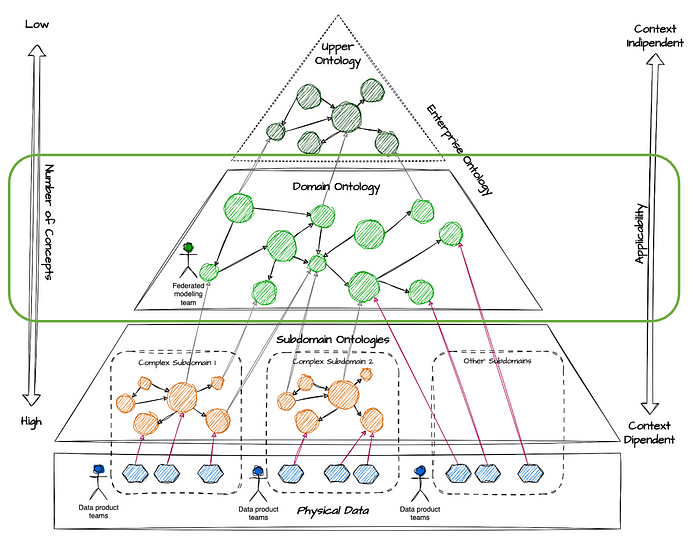
Эта комбинация одной большой таблицы и семантического уровня формирует рынок данных, ориентированный на домены внутри организации. Это облегчает обмен данными и их доступность в разных доменах, обеспечивая структурированную среду для создания новых информационных продуктов и способствуя децентрализованному управлению. Платформа data marketplace также выступает в качестве катализатора инноваций, предлагая платформу, в которой команды могут экспериментировать в безопасной и контролируемой среде. Эта функциональность основана на онлайн-платформе, где команды могут легко находить и повторно использовать доступные информационные продукты, что способствует прозрачности и подотчетности в Adevinta.
Для создания больших объектов была разработана декларативная структура, которая позволяет определять и заполнять эти таблицы аналогично контрактам с данными. Эта структура сопоставления доменов определяет в конфигурационном файле, какие таблицы и атрибуты из уровня bronze (продукты данных с выравниванием по источнику) принадлежат какому домену и как они интегрированы. Например, все таблицы объектов отслеживания поведения в приложениях и на веб-сайтах содержат файл конфигурации, который сопоставляет их с объектом поведения, где все атрибуты, определяющие отслеживание поведения, можно найти в одной таблице.
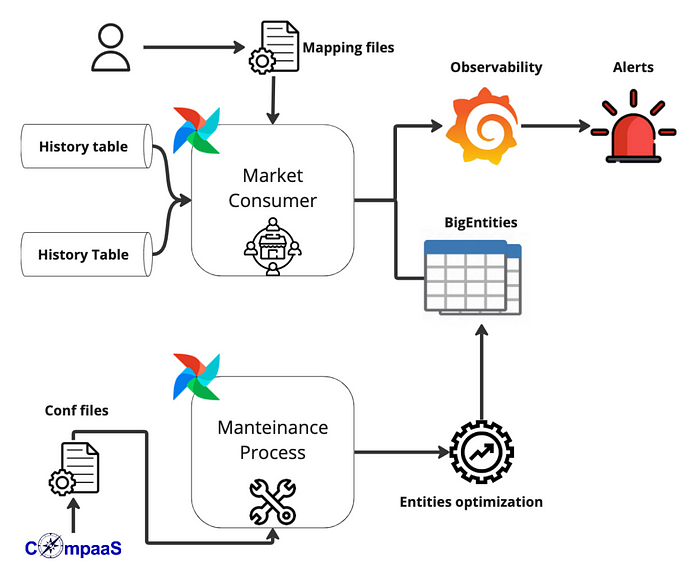
Эта платформа также автоматизирует аспекты управления, включая автоматические оповещения для проверки правил качества и другие проверки, которым должны соответствовать поступающие данные. Кроме того, она позволяет автоматизировать задачи обслуживания, индексации и оптимизации таблиц. что делает ее использование более эффективным, безопасным и экономичным. В этой статье подробно описываются применяемые стратегии оптимизации и преимущества в плане производительности и безопасности.
Эта архитектура создает единую экосистему данных, которая облегчает доступ и удобство использования на разных уровнях пользователей. Пользователи могут самостоятельно и эффективно принимать решения, основанные на данных, в управляемой среде, соответствующей целям Adevinta.
От уровня gold до ориентированных на потребителя продуктов обработки данных и далее до потребительского набора
Уровень gold является наиболее используемым и разнообразным, поскольку он должен поддерживать все аналитические варианты использования от BI до AI. По этой причине мы преобразовали его в уровень размещения продуктов данных, ориентированных на потребителя, внедрив набор фреймворков, известный как consuming suite. Этот набор создает гибкую среду, в которой продукты данных могут разрабатываться с высоким уровнем управления, для производства продуктов данных и создания прототипов.
Вместо рабочего пространства для аналитических ресурсов мы предоставили платформу для создания продуктов данных со всеми ее атрибутами [DAUTNIVS]: обнаруживаемыми, адресуемыми, понятными, заслуживающими доверия, изначально доступными, совместимыми, ценными (сами по себе) и безопасными.
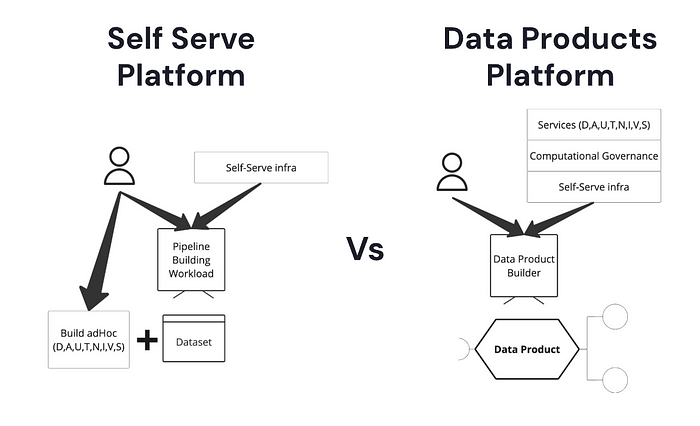
Потребительский пакет состоит из нескольких фреймворков, разделенных на две основные категории: фреймворки для производства и индустриализации информационных продуктов и фреймворки для прототипирования.
Фреймворки для производства и индустриализации информационных продуктов
У нас есть три ключевые платформы для эффективного создания информационных продуктов с автоматизированным управлением: Poseidon, Hermes и Transform It Yourself (TIY):
- Poseidon: Извлечение и построение распределенных конвейеров на основе блоков данных. Она включает в себя интегрированное управление, поддержку и компоненты качества.
- Hermes: Создание нераспределенных конвейеров. Он идеально подходит для случаев, когда для обработки данных не требуется распределенная архитектура.
- Преобразуйте это самостоятельно (TIY): Разработанный для работы с данными, хранящимися в хранилищах данных, TIY позволяет командам создавать конвейеры преобразования с использованием SQL/DBT. Это облегчает управление и управляемое преобразование данных.
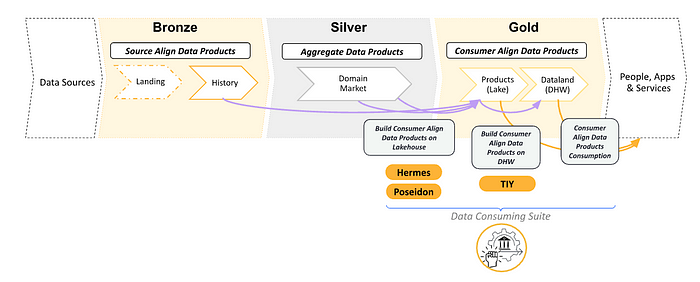
Различные платформы имеют возможности и разрешения для перемещения данных между слоями. Ключевым преимуществом предоставления полных фреймворков, а не просто инструментов и конфигураций, является то, что эти фреймворки уже включают правила управления, определяющие, какие данные доступны и кому, а также идентификацию пользователя. Это позволяет использовать governance as code, автоматизируя применение политик управления.
Кроме того, эти платформы адаптированы к различным возможностям и профилям пользователей, обеспечивая гибкость, которая гарантирует, что различные методы работы дают согласованный результат. При развертывании в производственной среде конечные результаты имеют одинаковый внешний вид и функционируют одинаково благодаря унифицированному мониторингу, поддержке и устранению неполадок. Это позволяет одной и той же команде поддержки обслуживать различные приложения с экономией за счет масштаба, повышая скорость развертывания в производственной среде при обеспечении безопасности и сокращая количество инцидентов.
В этих статьях “Как мы перешли от локальных скриптов и электронных таблиц, которыми можно обмениваться по электронной почте, к продуктам обработки данных” и “Lakehouse и Warehouse: обмен данными между средами” показано, как эти платформы демократизировали использование приложений, которые ранее считались теневыми ИТ, и перенесли их в производственные условия. Кроме того, они объясняют, как consumer suite служит связующим звеном между lakehouse и хранилищем данных, способствуя взаимодействию между этими двумя рабочими областями аналитики.
Платформа для прототипирования продуктов обработки данных
Платформа прототипирования в составе consumer suite, известная как Atenea, предназначена для облегчения создания прототипов информационных продуктов с уделением особого внимания стандартам качества, что обеспечивает большую гибкость на этапе тестирования. В отличие от производственных сред, Atenea обеспечивает гибкость для высокоскоростного анализа данных, обеспечивая доступ ко всем системным уровням (бронзовому, серебряному и золотому), включая как продуктивные, так и непроизводительные данные. Результаты прототипирования могут быть сохранены, но всегда в среде предварительного производства или игровой площадки, без прямого влияния на производство. Эта среда позволяет проектам быть масштабируемыми и временно работать, помогая проверять идеи, не требуя полной обработки всех данных. Это идеальное решение для аналитических сценариев, таких как информационные панели, машинное обучение (ML) или искусственный интеллект (AI), где идеи могут быть протестированы быстро и эффективно.
Одним из ключевых преимуществ Atenea является то, что, если в прототипах используются существующие производственные ресурсы и данные, переход к производству будет более плавным. Однако, если используемые данные недостаточно индустриализированы, фреймворк по-прежнему позволяет провести проверку концепции, но для запуска прототипа в производство потребуется дополнительное время.
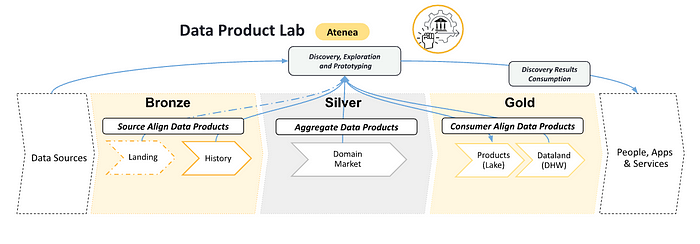
Atenea имеет доступ ко всем уровням системы, от исходных источников данных до хранилища данных lakehouse. Результаты хранятся на уровне gold (ориентированные на потребителя информационные продукты). Это позволяет Atenea предлагать централизованный интерфейс для поиска и изучения данных.
Atenea в основном основана на технологии Databricks, использующей записные книжки и рабочие процессы, которые улучшают работу пользователей и упрощают доступ к прототипированию данных для всех. В то время как на производстве компания работает только с конвейерами и заданиями, среда прототипирования с Databricks предоставляет высокодоступный и гибкий интерфейс для ноутбуков, который особенно полезен для быстрого создания и проверки прототипов. Такая интеграция с Databricks делает платформу удобной для использования командами с различными техническими возможностями, тем самым способствуя созданию инновационных информационных продуктов без высоких барьеров для входа.
Влияние Atenea особенно заметно, когда необходимо ускорить разработку или протестировать идеи, прежде чем инвестировать в промышленное использование конкретных данных, которые могут не использоваться повторно. Эта структура позволяет проводить одноразовый анализ (“one-shot”) или быструю проверку гипотез, тем самым ускоряя начальные этапы разработки. Хотя разработка Atenea носит временный характер (проекты не могут быть постоянными), а поддержка ограничена (ей не хватает поддержки на производственном уровне и она не может напрямую подключаться к производству), эти ограничения гарантируют, что прототипы, демонстрирующие ценность, пройдут соответствующую индустриализацию и производственный процесс. Это позволяет им масштабироваться, снижать затраты и расширять возможности повторного использования.
Вывод: Автоматизация управления и масштабируемость
Автоматизация управления была одним из основных элементов этой трансформации. Команда разработчиков платформы обработки данных в Adevinta Spain (CompaaS) работала над тем, чтобы обеспечить автоматическое применение политик качества, безопасности и соответствия требованиям, что сокращает необходимость ручного вмешательства и сводит к минимуму риск человеческих ошибок.
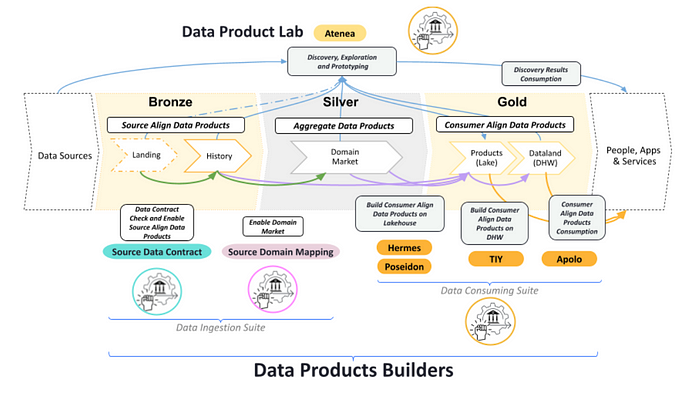
На диаграмме представлены все уровни и потоки данных платформы обработки данных, а также инициативы, которые сыграли ключевую роль в этом преобразовании, такие как строительство дома у озера и последующее внедрение концепций data mesh. Это позволило lakehouse функционировать в качестве “хостинговой” среды для информационных продуктов, оснащенной полным набором инструментов для их создания на различных этапах: прием, эксплуатация, прототипирование и производство. В совокупности эти инициативы представляют собой надежное предложение по внедрению data mesh и объединению хранилища данных и набора инструментов, которые облегчают децентрализованное внедрение, ориентированное на информационные продукты.
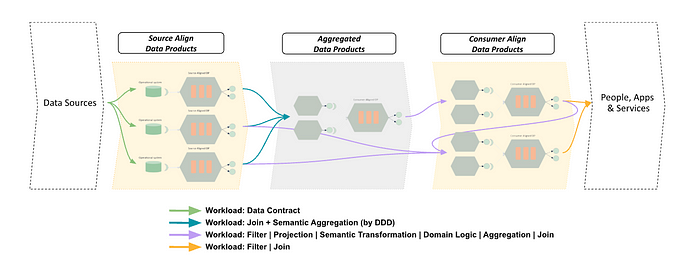
Одним из наиболее важных нововведений этой архитектуры является возможность преобразования последовательных потоков данных архитектуры medallion the lakehouse в сетчатую структуру с узлами и соединениями, распределенными во всех направлениях. Вместо того, чтобы рассматривать потоки данных как однонаправленный процесс, мы рассматриваем их как сеть, в которой каждая область имеет свою специализацию. Например, существует специализированный ввод данных для обработки, специализированный уровень данных для агрегации доменов и потоки данных, ориентированные на потребление и создание конкретных вариантов использования.
Эта комбинация различных потоков использует стандартные инструменты, такие как lakehouse и data warehouse, позволяя создать сетевую реализацию данных, которая поддерживает четыре основных компонента: данные как продукт, федеративное автоматизированное управление, платформу самообслуживания и доменную архитектуру владения данными.
В этой статье более подробно рассказывается о том, как инициативы, реализованные на этой платформе, способствовали переходу от платформы данных к платформе информационных продуктов.
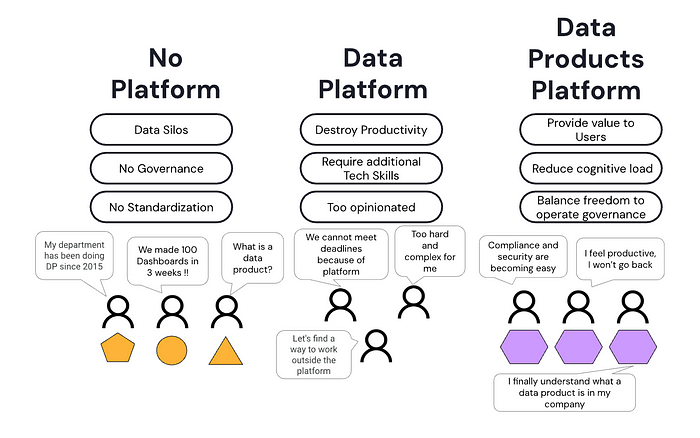
В заключение мы рассмотрим различия между отсутствием платформы, технологией без управления и платформой для продуктов обработки данных. В сценарии без платформы компания сталкивается с большим количеством теневых ИТ-технологий и отсутствием контроля. Централизованная платформа позволяет избежать технических расхождений, но все же могут быть недостатки в гибкости и автономии команды. И, наконец, платформа data products позволяет избежать не только технических расхождений, но и стандартизировать процессы, методы работы и культуру.
Этот опыт показал, что необходимо не только предоставлять качественные технологии и сервис, но и рассматривать платформу обработки данных как целостный продукт. Аналитическое рабочее пространство становится общей, масштабируемой, демократичной, безопасной, экономичной и высококачественной средой, позволяющей компании внедрять инновации и развиваться в области управления данными согласованным и устойчивым образом.


