

Внедрение Lakehouse
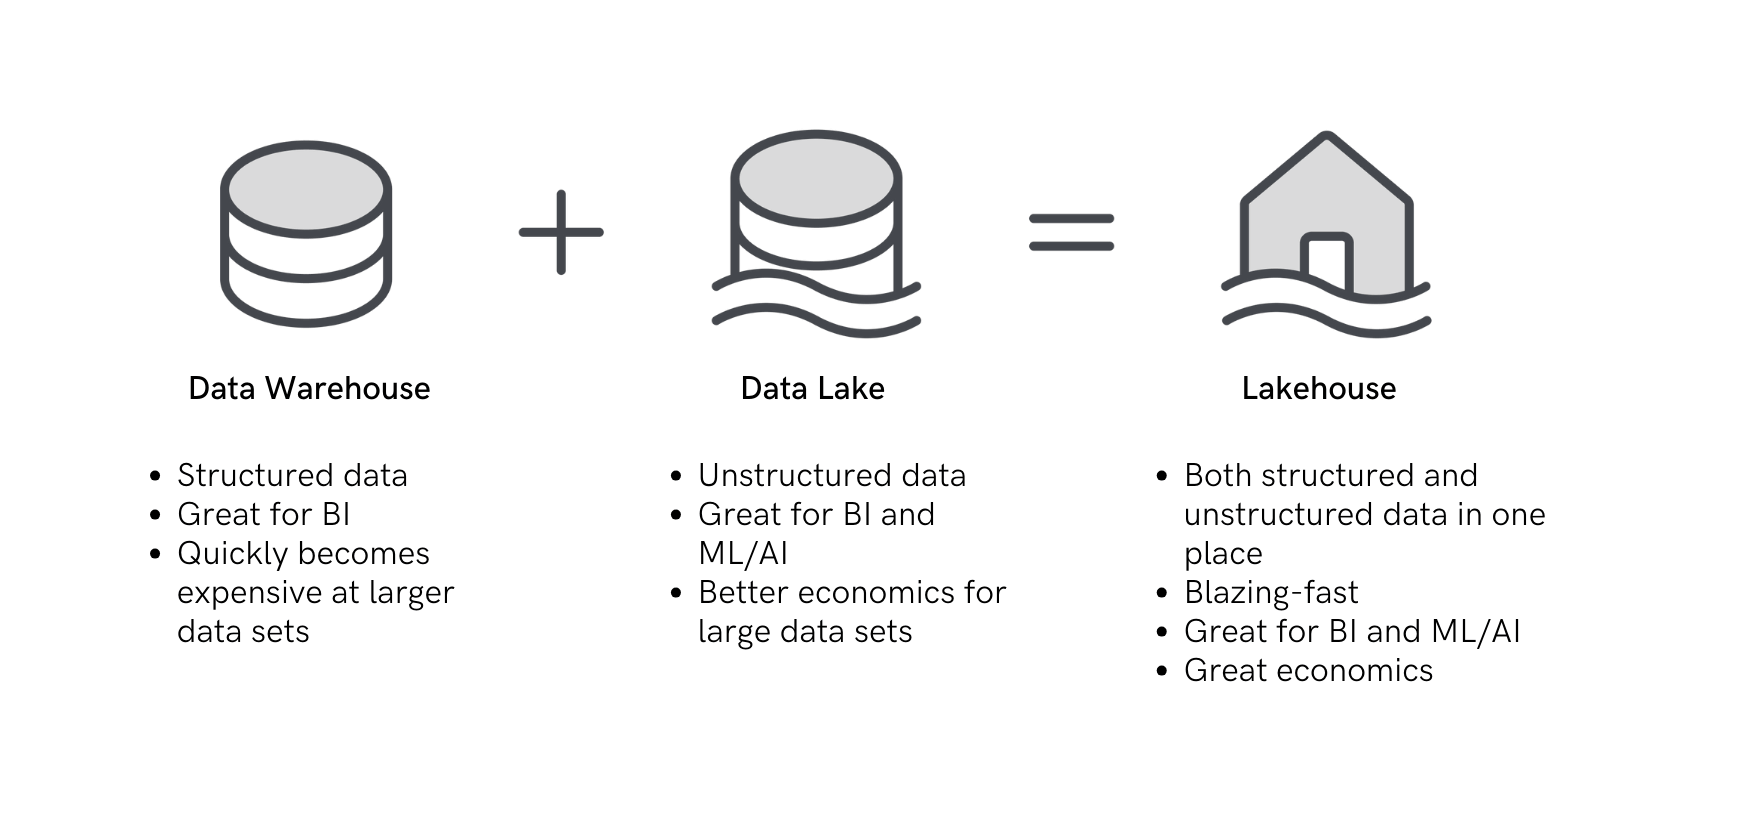
Современные организации ежедневно сталкиваются с необходимостью обрабатывать огромные объёмы информации. При этом далеко не все традиционные подходы к работе с данными позволяют сделать это эффективно и гибко. Мы в BI Consult предлагаем нашим клиентам современные архитектурные решения, способные не только справиться с текущими вызовами, но и создать прочную основу для будущего масштабирования, автоматизации и применения искусственного интеллекта. Одним из таких решений становится архитектура Lakehouse.
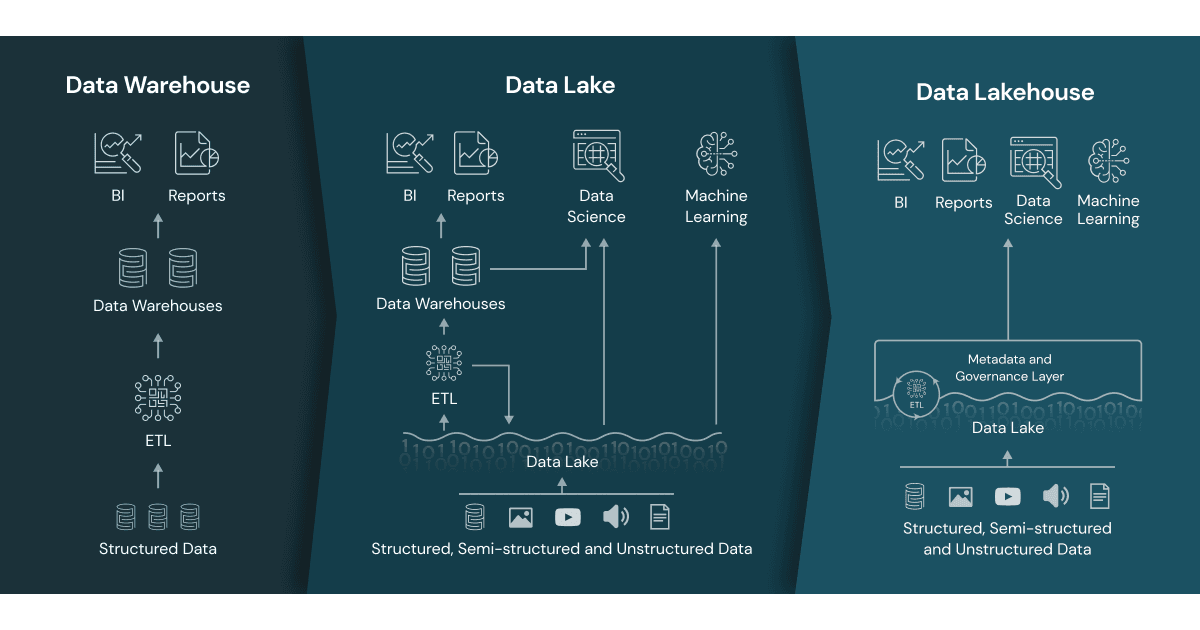
Архитектура Lakehouse — это эволюционное объединение лучших сторон двух предыдущих подходов: классического хранилища данных (Data Warehouse) и озера данных (Data Lake). С одной стороны, мы получаем структурированность, управляемость и поддержку аналитики в реальном времени, с другой — гибкость, масштабируемость и возможность работать с данными любого типа в их исходной форме. Это позволяет нашим клиентам сосредоточиться на ценности данных, а не на ограничениях архитектуры.
В основе архитектуры лежит идея хранения всех данных — от транзакционных до неструктурированных — в едином пространстве. Мы реализуем систему поэтапно: сначала настраиваем процесс приёма данных из различных источников, обеспечиваем хранение "сырых" данных (так называемый bronze layer), затем очищаем и обогащаем их, формируя серебряный слой (silver), и, наконец, преобразуем данные в бизнес-значимые витрины — золотой слой (gold). Вся цепочка контролируется, версионируется и документируется. Мы используем только проверенные форматы хранения: Parquet, Delta Lake, Iceberg и Hudi. Эти форматы обеспечивают надежную транзакционность, time travel, поддержку эволюции схем и масштабируемость на уровне petabyte-scale.
Мы реализуем систему поэтапно:
- Настраиваем приём и потоковую/пакетную загрузку данных из различных источников (ETL, CDC, Kafka, API и др.).
- Сохраняем их в "сырую" зону хранения — bronze layer, где данные представлены в исходном виде, пригодном для аудита и переобработки.
- Проводим очистку, стандартизацию, валидацию и обогащение — данные переходят в silver layer.
- Формируем бизнес-ориентированные витрины — gold layer — пригодные для аналитики, отчётности, дэшбордов и обучения ML-моделей.
Все эти этапы сопровождаются версионированием, контролем качества и отслеживанием lineage. Мы используем только проверенные форматы хранения: Parquet, Delta Lake, Apache Iceberg и Apache Hudi. Они обеспечивают:
- ACID-транзакции поверх object storage;
- поддержку time travel и rollback;
- автоматическую эволюцию схем;
- масштабируемость до десятков петабайт данных.
Огромное внимание мы уделяем метаданным и управлению доступом. Благодаря инструментам вроде Arenadata Catalog мы обеспечиваем прозрачность схем, контроль доступа и соответствие политике безопасности на уровне строк, столбцов и даже операций.
Это позволяют централизованно контролировать схемы, разграничивать доступ по ролям, строить политики безопасности и отслеживать использование данных. По выбору клиента архитектура может быть реализована полностью on-premises (например, с использованием MinIO, Trino, ClickHouse), в облаке (Arenadata ONE) или в гибридном режиме. Мы успешно внедряем решения на базе Arenadata ONE, Apache Iceberg с Trino, Apache Hudi с Flink и Spark, ClickHouse с S3 и другими современными технологиями.
Ключевая особенность Lakehouse-подхода — это поддержка и аналитических, и дата-сайенс сценариев. На одних и тех же данных можно строить BI-отчеты и обучать ML-модели. Мы интегрируем в платформу пайплайны данных, MLflow, Feature Store, orchestration-инструменты (Airflow, Dagster, Argo) и системы мониторинга качества (Great Expectations, Soda и другие). Такой подход позволяет нашим клиентам выстраивать end-to-end data-процессы: от загрузки до предсказательной аналитики.
Мы строим единую инфраструктуру, в которую входят:
- инструменты оркестрации пайплайнов (Airflow, Argo, Dagster);
- пайплайны подготовки признаков и хранения фичей (Feast, MLflow Feature Store);
- автоматизация обучения моделей (MLflow, Weights & Biases);
- мониторинг качества данных (Soda, Great Expectations, Monte Carlo);
- CI/CD пайплайны для аналитики и моделей (DBT, GitHub Actions, Jenkins).
Наши команды имеют богатый опыт миграции существующих DWH и Data Lake решений в Lakehouse-архитектуру. Мы:
- проводим технический и бизнес-аудит;
- проектируем целевую архитектуру и план миграции;
- реализуем MVP на приоритетных доменах (например, финансы, продажи, запасы);
- поэтапно подключаем остальные бизнес-направления;
- обучаем команды клиентов работе в новой экосистеме.
Среди реализованных нами кейсов:
- ритейл-компании с миллионами чеков и персонализацией предложений;
- банки с внедрением скоринговых моделей и комплаенс-отчётностью на одной платформе;
- промышленные предприятия, использующие IIoT-аналитику и контроль качества;
- госструктуры и телеком-операторы, обрабатывающие телеметрию, логи, обращения граждан и прочие большие данные.
Мы также обеспечиваем методологическую основу всей платформы. В рамках внедрения Lakehouse мы помогаем:
- выстроить Data Governance по фреймворку DAMA-DMBOK;
- внедрить подходы Data Mesh (распределённое владение доменами);
- разработать BI-стратегию, обеспечивающую единый слой показателей и демократизацию доступа к аналитике;
- подготовить данные и архитектуру к внедрению AI и LLM-моделей в масштабах организации.
Lakehouse — это больше, чем технология. Это фундамент, на котором можно выстроить культуру управления данными, ускорить принятие решений и заложить прочную основу для будущих инноваций. Обратитесь к нам, если хотите построить масштабируемую и интеллектуальную data-платформу, готовую к вызовам завтрашнего дня.
Мы предлагаем не просто архитектуру, а полноценную data platform, готовую к применению искусственного интеллекта, масштабированию и самообслуживанию бизнес-пользователей. Мы понимаем, как выстроить правильный CI/CD для данных, как объединить BI и AI, как внедрить подходы DataOps, MLOps, Data Mesh и Data Governance на единой технологической базе.
Если вы хотите перевести свою компанию на качественно новый уровень работы с данными, снизить издержки, повысить прозрачность, автоматизировать аналитику и подготовиться к внедрению AI — Lakehouse это то, что вам нужно. А наша команда готова стать вашим проводником в этом переходе. Обратитесь к нам — и мы вместе построим архитектуру данных, достойную будущего.
StarRocks — это высокопроизводительная аналитическая MPP-база данных, оптимизированная для интерактивной аналитики и построения BI-дашбордов в реальном времени. Система поддерживает подключение к data lake-хранилищам (Iceberg, Hudi, Delta Lake, Hive), позволяя выполнять быстрые SQL-запросы поверх данных в S3, HDFS или других объектных хранилищах без необходимости их полной загрузки в собственное хранилище. Благодаря векторизованному исполнению запросов, продвинутым механизмам кеширования и оптимизации агрегаций StarRocks часто используется как вычислительный слой Lakehouse-архитектуры для ускорения аналитических запросов и обеспечения высокой скорости работы BI-инструментов.
Apache Doris — распределенная аналитическая СУБД с архитектурой MPP, предназначенная для выполнения быстрых SQL-запросов по большим объемам данных. Система поддерживает как хранение данных внутри собственного движка, так и выполнение запросов к внешним источникам — включая data lake-форматы Iceberg, Hive, Hudi и различные файловые системы. Doris активно используется в Lakehouse-архитектурах как универсальный SQL-движок для аналитики, позволяющий объединять данные из различных источников и выполнять сложные аналитические запросы с минимальными задержками.
Trino — это распределенный SQL-движок для выполнения запросов к данным, расположенным в различных системах хранения. В Lakehouse-архитектурах Trino часто выступает в роли универсального слоя запросов, позволяя выполнять единые SQL-запросы к данным из data lake (Iceberg, Hive, Delta Lake), реляционных баз данных, NoSQL-систем и других источников. Благодаря архитектуре федеративных запросов и большому количеству коннекторов Trino используется для построения аналитических платформ, где необходимо объединять данные из множества систем без физического перемещения данных.
1. Архитектура Lakehouse
1.1. Принципы архитектуры
Lakehouse строится на трёх ключевых принципах:
- Хранение всех типов данных в едином формате и пространстве (object storage)
- Поддержка транзакционности и версионирования (ACID) поверх файловых систем
- Унификация аналитики и машинного обучения на одних и тех же данных
1.2. Слои и компоненты:
- Data Ingestion Layer (batch / streaming)
- Raw Layer (bronze)
- Cleansed / Validated Layer (silver)
- Business Layer (gold)
- Semantic Layer
-
ML Layer (feature store, notebooks, model registry)
1.3. Форматы хранения: Parquet, Delta Lake, Iceberg, Hudi
1.4. Метаданные и каталоги: Hive Metastore, Unity Catalog, Glue Catalog
1.5. Поддержка ACID и time travel
1.6. Примеры архитектур (Databricks, Dremio, AWS Lakehouse, Snowflake, ClickHouse-based)
Слои и компоненты архитектуры:
- Ingestion Layer: загрузка данных из различных источников (batch, stream, CDC)
- Bronze Layer: сырые, немодифицированные данные
- Silver Layer: очищенные и валидированные данные
- Gold Layer: агрегированные бизнес-данные
- Semantic Layer: метаданные, бизнес-логика, модели
- ML Layer: Feature Store, модельные артефакты, окружения
2. Технические аспекты внедрения
2.1. Выбор стека: Databricks, Delta Lake, Apache Iceberg, Apache Hudi, Snowflake, Trino + MinIO + Hive Metastore
2.2. Развертывание компонентов: on-premises, cloud, hybrid
2.3. Интеграция источников данных:
- CDC (Change Data Capture)
- Брокеры сообщений (Kafka, Pulsar)
- Традиционные ETL/ELT
2.4. Хранение: object storage (S3, Azure Blob, GCS, MinIO)
2.5. Query engines: Trino, Presto, Spark SQL, DuckDB
2.6. Каталоги и управление схемами
2.7. Управление версиями данных
2.8. Безопасность: авторизация, шифрование, аудит
2.9. Обеспечение качества данных (Data Quality / Observability)
2.10. Инструменты CI/CD для Lakehouse
Форматы хранения:
- Parquet — стандартный columnar-формат
- Delta Lake — слой ACID над Parquet (Databricks)
- Apache Iceberg — открытый формат с поддержкой schema evolution
- Apache Hudi — оптимизирован для стриминговых и инкрементальных обновлений
Каталоги и метаданные: Hive Metastore, AWS Glue Catalog, Unity Catalog от Databricks.
ACID и Time Travel: поддержка версионирования, rollback и lineage.
3. Реализация DataOps и MLops в Lakehouse
3.1. Пайплайны для подготовки данных
3.2. Обработка в реальном времени
3.3. Интеграция с ML-лабораториями
3.4. Feature Store
3.5. Автоматизация экспериментов и контроль качества моделей
Lakehouse позволяет выстроить полный цикл подготовки, обработки и использования данных:
- Автоматизация пайплайнов (Airflow, DBT)
- Поддержка CI/CD
- Feature Store (Feast, MLflow)
- Обработка данных в реальном времени (Kafka, Flink)
- Автоматизация экспериментов и деплой моделей (MLflow, Argo, W&B)
4. Подходы к миграции и внедрению
5.1. Аудит и выбор целевой архитектуры
5.2. Сценарии миграции с DWH / Data Lake
5.3. Построение MVP
5.4. Постепенное добавление доменов
5.5. Обучение команд и DevOps-практики
5.6. Тестирование и сопровождение
Мы внедряем Lakehouse с использованием как open-source, так и enterprise-решений:
- Arenadata One (AD.ONE)
- Databricks + Delta Lake
- Apache Iceberg + Trino / Spark / Dremio
- Apache Hudi + Flink / Spark
- ClickHouse + S3 + Hive
Реализация может быть on-premises, в облаке или гибридной. Мы интегрируем все источники данных — от 1С и PostgreSQL до Kafka и API. Используем брокеры событий, CDC (например, Debezium), инструменты оркестрации (Airflow, Dagster), и качественные системы контроля данных (Great Expectations, Soda).
Безопасность обеспечивается через шифрование, row-level security, управление доступом на основе ролей и подробное журналирование.
Технологическое сравнение
|
Формат |
ACID |
Time Travel |
Schema Evolution |
Streaming |
|
Delta |
Да |
Да |
Да |
Частично |
|
Iceberg |
Да |
Да |
Да |
Нет |
|
Hudi |
Да |
Да |
Да |
Да |
|
Движок |
Особенности |
|
ANSI SQL, масштабируемость |
|
|
Spark |
Универсальность, ML, batch и stream |
|
ClickHouse |
Скорость, OLAP |
|
Dremio |
Self-service BI, Iceberg-оптимизация |
6. Сравнение технологий и платформ
- Delta Lake vs Iceberg vs Hudi
- Trino vs Spark vs Dremio vs ClickHouse
- AWS Lake Formation vs Databricks vs Snowflake
- On-premises vs Cloud Lakehouse
7. Потенциальные проблемы и как их решать
- Медленные запросы и оптимизация
- Проблемы с метаданными
- Версионирование и очистка данных
- Конфликт форматов
- Конфиденциальность и безопасность
8. Будущее Lakehouse
- Data Fabric и Data Mesh в контексте Lakehouse
- Единые data-каталоги и governance
- Lakehouse как основа AI Strategy
- Интеграция с LLM и agent-based архитектурами
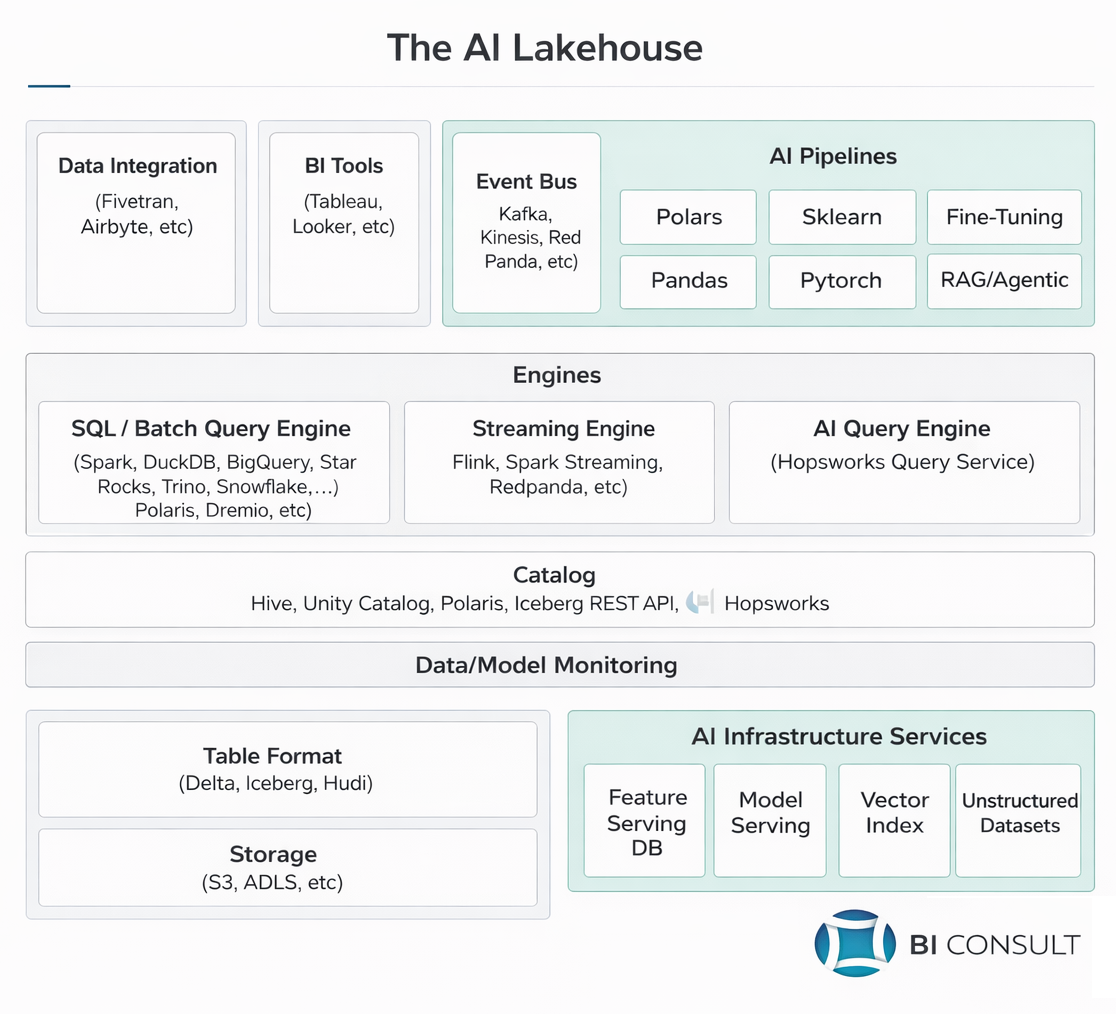
Lakehouse становится ядром новой data-платформы: совместимой с Data Mesh, готовой к AI, поддерживающей Data Governance и self-service подходы. Мы уже сегодня внедряем такие решения и готовы помочь вам сделать следующий шаг.
Мы не просто внедряем очередную технологию — мы выстраиваем архитектуру, которая объединяет бизнес, аналитику и технологии в единую экосистему. Обратитесь к нам, чтобы построить data platform, способную решать задачи завтрашнего дня уже сегодня.
- Что такое Lakehouse?
- Внедрение архитектуры Lakehouse в компании из сегмента retail DIY: практический кейс
- Учебный курс: StarRocks — полный практический гид по внедрению и эксплуатации
- Ускорение выполнения аналитических SQL-запросов в Data Lakehouse на базе Trino + Iceberg + S3
- Data Lakehouse: опыт, технические нюансы и как избежать рисков
- Trino и традиционные СУБД: сравнительный анализ и особенности внедрения
- Опыт внедрения Lakehouse: Trino + Iceberg поверх S3, с GitOps, мониторингом и отделением compute от storage
- Представляем Lakehouse 2.0: Что изменится?
- Миграция с монолитного Greenplum на Lakehouse-архитектуру с Iceberg и S3: опыт страховой компании
- Lakehouse: концептуальная рамка унифицированной архитектуры данных - принципы, компоненты, управление и перспективы развития
- Настройка и использование каталогов для Iceberg Lakehouse
- Iceberg Lakehouse: архитектура, управление данными и дорожная карта внедрения в современной экосистеме открытых форматов данных (2024–2025)
Arenadata One — это унифицированная аналитическая платформа, объединяющая в себе возможности работы с большими данными, традиционной реляционной аналитики и распределённой обработки. Она предоставляет единый интерфейс доступа к разнородным источникам данных, включая Hadoop, ClickHouse, PostgreSQL, Greenplum и другие, обеспечивая гибкую архитектуру и высокую производительность запросов. Решение ориентировано на корпоративный сегмент и поддерживает как SQL-запросы, так и интеграцию с BI-инструментами, позволяя построить масштабируемую систему аналитики с централизованным управлением.


