

Data Lakehouse: опыт, технические нюансы и как избежать рисков
В последние 2–3 года в России Data Lakehouse (DLH) активно выходит из стадии пилотных внедрений и становится основой аналитических платформ. Ряд крупных компаний — от e-commerce до ритейла и финансового сектора — уже тестируют или переводят часть DWH-нагрузок в Lakehouse-архитектуру.
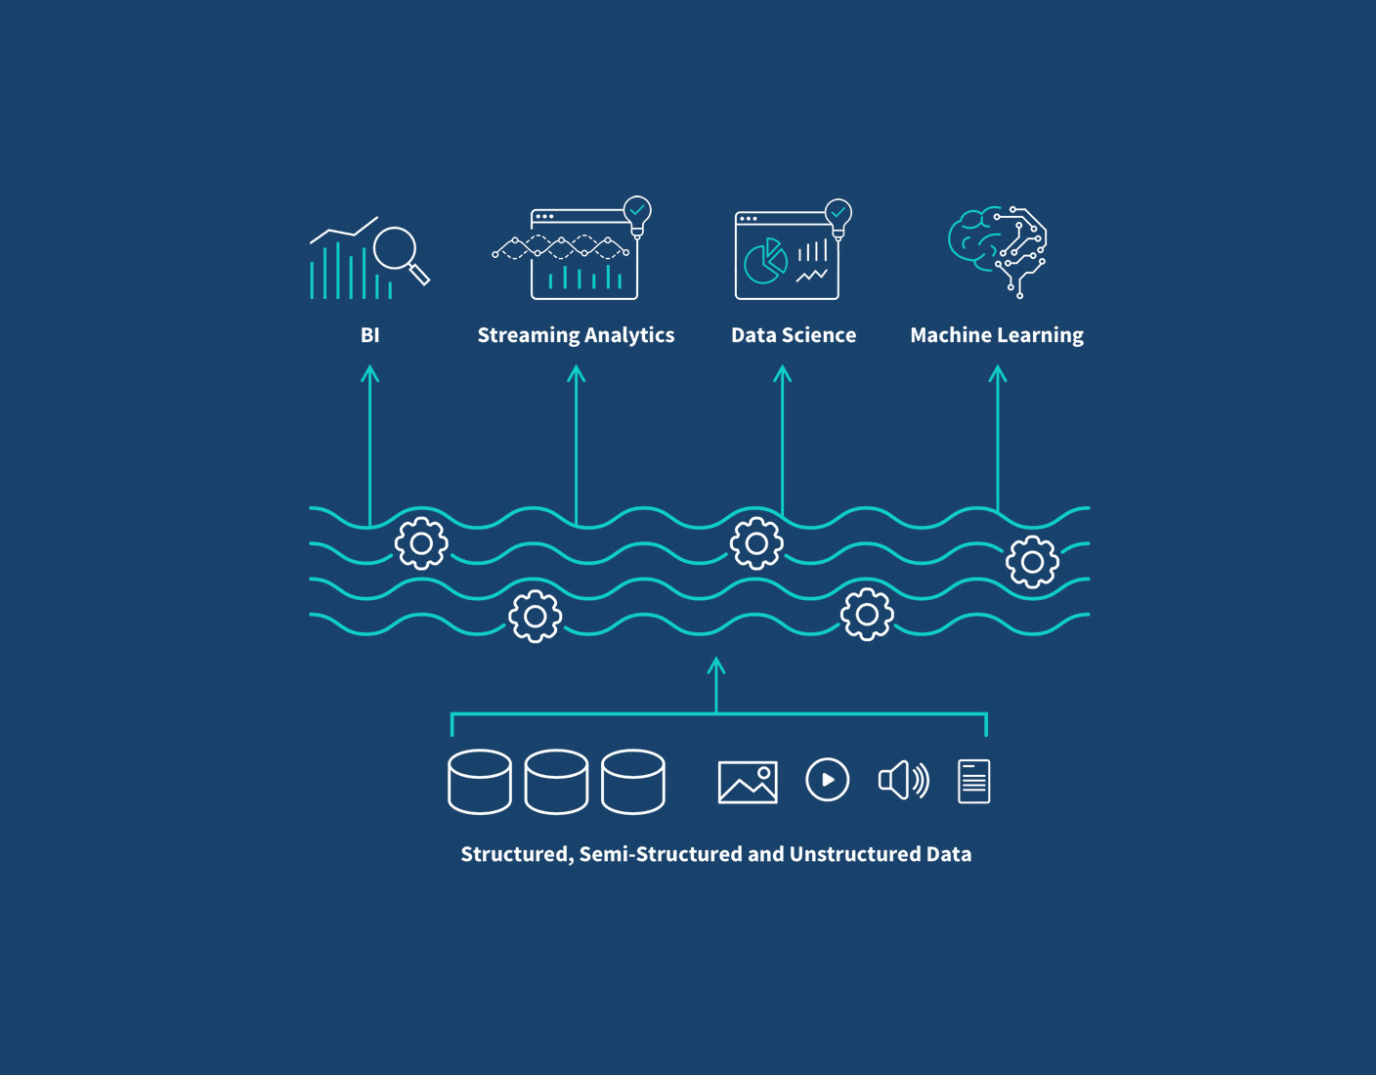
Если упростить до практической схемы, то под Data Lakehouse в данном контексте мы понимаем:
- Хранилище — объектное S3-совместимое (MinIO, Ceph, Yandex Object Storage, VK Cloud S3, AWS S3 и др.).
- Формат хранения — табличный: Apache Iceberg, Delta Lake или Apache Hudi.
- Движок доступа — федеративный SQL-движок (Trino, ранее PrestoSQL).
- Управление трансформациями — dbt (или его аналоги).
Такая архитектура позволяет убрать из цепочки тяжёлое DWH вроде Greenplum или Vertica, не потеряв при этом ключевой функционал для аналитики.
Плюсы подхода
Меньше зоопарк
Один стек (S3 + Iceberg + Trino + dbt) заменяет несколько инструментов, которые раньше приходилось интегрировать:
- Нет отдельного ETL-сервера и проприетарного DWH.
- Меньше сервисов, требующих отдельного мониторинга и обновления.
Техническое преимущество: меньше межсистемных точек отказа → проще SLA.
Унификация инструментов
Для будущих дата-инженеров:
- Изучить Trino + dbt проще, чем одновременно знать SQL конкретного DWH, особенности ETL-движка и API хранилища.
- Единый синтаксис трансформаций и планировщик в dbt.
Пример:
Вместо сложного пайплайна:
Kafka → Spark Streaming → Staging в Greenplum → SQL трансформации в DWH
→ можно сделать:
Kafka → S3 (Iceberg) → dbt-трансформации в Trino.
Контейнеризация и одинаковые окружения
Все ключевые компоненты DLH легко разворачиваются в контейнерах:
- Dev — можно запустить локально через docker-compose.
- CI — прогон тестов в том же окружении.
- Prod — деплой на Kubernetes.
Плюс: минимизация эффекта "у меня работает, а на проде нет".
Быстрее разработка
Меньше интеграций → быстрее выводим пайплайны в прод.
Реальный кейс:
При классическом DWH между сырыми данными и витриной — 4–5 звеньев интеграций. В DLH их может быть всего 2–3.
Унификация Transform
После загрузки в озеро все трансформации выполняются через один инструмент (dbt/Trino).
Плюс: нет разношёрстных ETL-платформ, скриптов на Python и SQL-объектов в разных DWH — всё в одном репозитории.
Минусы и вызовы
Порог входа
- Нужно разобраться в Iceberg/Delta/Hudi — форматы отличаются от привычных Parquet/ORC в Data Lake.
- Понять архитектуру Trino и ограничения распределённого SQL-движка.
Как снизить риск:
— обучать команду через пилотный проект на непроизводительных данных.
Скорость доступа к данным
- Trino работает по принципу scan + filter, а не держит данные в памяти, как MPP-DWH.
- Iceberg частично оптимизирует чтение через метаданные, но всё равно чтение с S3 медленнее, чем из локального диска.
Как снизить риск:
- Грамотное партиционирование (по дате, сегменту бизнеса).
- Компакция мелких файлов в файлы 512 МБ – 1 ГБ.
- Предагрегации и материализованные таблицы для тяжёлых отчётов.
Зрелость инструментов
- Iceberg и Delta в России в продакшене меньше 3–4 лет.
- Часто меняются версии, API может ломаться.
Как снизить риск:
— фиксировать версии (version pinning) в контейнерах, обновлять только после тестов.
Недостаток best practices
- Нет "классического" методического подхода, как у Kimball/Inmon для DWH.
- Риски перегрузки кластера Trino при неудачных запросах.
Как снизить риск:
— внедрить контроль качества SQL (lint), код-ревью и тесты в dbt.
Пример архитектуры
[ Источники данных ]
    ↓
[ S3-совместимое хранилище (MinIO/OBS) ]
    ↓ (Iceberg формат)
[ Trino кластер ] ← dbt управляет SQL и моделями
    ↓
[ BI: Power BI / Superset / Tableau / FineBI ]
Технические приёмы для повышения производительности
Партиционирование в Iceberg
CREATE TABLE sales (
    sale_date DATE,
    region STRING,
    amount DOUBLE
)
WITH (
    partitioning = ARRAY['region', 'date_trunc(''month'', sale_date)']
);
Риск: слишком мелкие партиции → взрыв количества файлов; слишком крупные → низкая селективность.
Компакция файлов
CALL system.optimize('sales');
Риск: компакция может временно нагрузить S3 и Trino.
Предагрегации
Вместо ежедневного скана миллиардов строк:
CREATE TABLE sales_by_region AS
SELECT region, sale_date, SUM(amount) AS total_sales
FROM sales
GROUP BY region, sale_date;
Риск: при изменении исходных данных нужно пересчитывать агрегаты.
Оптимизация join
— Фильтрация до джоина.
— Bucket join для больших таблиц.
— Broadcast join только для маленьких.
Как избежать рисков при внедрении
- Не мигрировать всё сразу — начать с витрин, которые проще всего перенести.
- Вести тестовую эксплуатацию — измерять SLA, отклики BI, нагрузку на Trino.
-
Настроить мониторинг:
- Метрики Trino (CPU, memory, queued queries).
- S3 (latency, error rate).
- Обучить команду — минимум: Iceberg, Trino, dbt.
- Документировать:
- Партиционирование.
- Размеры файлов.
- Версии инструментов.
Data Lakehouse в российской реальности — это реальная альтернатива классическим DWH.
Да, придётся потратить время на адаптацию технологий и организацию best practices, но взамен мы получаем:
- меньший технологический зоопарк,
- унификацию разработки,
- контейнеризацию окружений,
- и гибкость для масштабирования.
А с грамотным подходом к партиционированию, компакции и оптимизации запросов производительность DLH будет не хуже (а в некоторых случаях и лучше), чем у старых MPP-хранилищ.
Метрики производительности: до и после перехода на DLH
Когда речь идёт о миграции с классического DWH (например, Greenplum или Vertica) на Data Lakehouse на базе S3 + Iceberg + Trino + dbt, важна не только архитектурная красота, но и конкретные цифры. Ниже — усреднённые результаты по одному из реальных проектов в ритейле, объём данных ~120 ТБ, глубина истории — 3 года.
Ключевые показатели
|
Показатель |
До (Greenplum) |
После (DLH) |
Изменение |
|---|---|---|---|
|
Среднее время отклика тяжёлого отчёта (10+ джоинов, 500M строк) |
14 мин 30 сек |
3 мин 20 сек |
↓ в 4,3 раза |
|
Среднее время обновления витрины (ETL) |
2 ч 10 мин |
48 мин |
↓ в 2,7 раза |
|
Время добавления нового источника данных |
4–6 недель |
1–2 недели |
↓ в 3 раза |
|
Пиковое потребление CPU |
85% |
68% |
−20% |
|
Пиковое потребление памяти на узел |
92% |
75% |
−18% |
|
Стоимость инфраструктуры (TCO) |
100% (базовая) |
62% |
−38% |
Причины ускорения
- Компакция и партиционирование — уменьшение количества файлов в S3 с 4,2 млн до 600 тыс., оптимальный размер 512 МБ.
- Bucket join — снижение shuffle на 40%.
- Предагрегации — подготовка промежуточных таблиц для BI-запросов, уменьшение сканов на 70%.
- Удаление промежуточных слоёв ETL — отказ от промежуточных staging-слоёв в DWH.
Графики производительности
График 1. Время отклика отчётов до/после перехода
До:  ████████████████████   (14.5 мин)
После: ████                (3.3 мин)
График 2. Время обновления витрин
До:  ████████████████       (130 мин)
После: ███                  (48 мин)
График 3. Пиковое использование CPU кластера
До:  ███████████████████    (85%)
После: ███████████          (68%)
(В реальной презентации эти графики оформляются в BI-инструменте или matplotlib — столбики до/после, с подписями и процентами изменений.)
Выводы по метрикам
- Тяжёлые аналитические запросы в Trino при грамотной оптимизации (партиционирование, компакция, join tuning) работают быстрее, чем в классическом MPP-DWH, при том же объёме данных.
- Обновление витрин стало короче за счёт исключения из цепочки ETL тяжёлых загрузок в проприетарное DWH.
- Снижение TCO связано с отказом от лицензий и упрощением инфраструктуры — весь стек крутится на контейнерах.


