

Модуль 2. Архитектура и принципы работы StarRocks
Зачем понимать архитектуру
Внедрять StarRocks «вслепую» — рискованно. Это не просто «SQL-сервер с парой настроек», а распределённая система, где:
- Запрос, который на тестовом стенде летал за 0,2 сек, может в продакшне упасть в 30 сек из-за неправильной дистрибуции.
- Ошибка в планировании партиций приведёт к тому, что BE-нодам не хватит памяти при агрегации.
- Неверно выбранный тип таблицы (PK/Aggregate/Duplicate Key) изменит поведение upsert и приведёт к неконсистентности.
Методологически, понимание архитектуры StarRocks — это:
- Основа моделирования (как данные хранятся и обрабатываются).
- База для оптимизации (где мы можем ускорить, а где нет).
- Ключ к отказоустойчивости (какие компоненты критичны и как их дублировать).
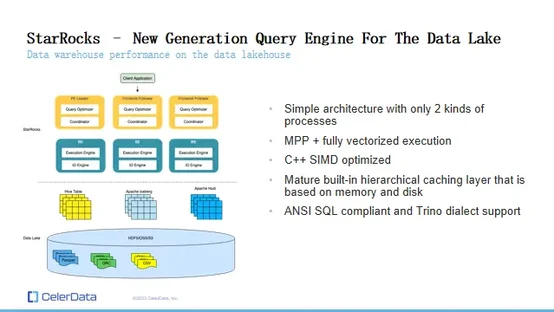
Общая архитектура
StarRocks состоит из двух основных типов узлов:
Frontend (FE)
-
Функции:
- Приём SQL-запросов от клиентов (JDBC/ODBC/MySQL-порт).
- Парсинг, лексический и синтаксический анализ.
- Логическая оптимизация запросов.
- Генерация плана выполнения (Query Plan).
- Управление метаданными (схемы, партиции, пользователи, права).
- Координация работы Backends.
- Особенности:
- Несколько FE-нод могут работать в HA-режиме.
- Один FE — лидер, остальные — фолловеры.
- Метаданные синхронизируются через EditLog + Journal.
-
Пример конфигурации:
Для кластера на 6 BE обычно хватает 3 FE (1 лидер + 2 фолловера) с SSD и ≥16 ГБ RAM.
Backend (BE)
-
Функции:
- Хранение данных в колоночном формате.
- Выполнение физических операций: сканирование, фильтрация, join, агрегации.
- Локальное кэширование и репликация сегментов.
- Особенности:
- BE — вычислительные узлы. Чем их больше, тем выше параллелизм.
- Данные хранятся в сегментах (segment files), оптимизированных под векторное чтение.
- Для отказоустойчивости данные реплицируются на несколько BE.
Принцип работы запроса
- BI-клиент отправляет SQL в FE.
- FE парсит запрос, строит логический план, оптимизирует его (CBO).
- FE генерирует физический план с разбиением на подзапросы (фрагменты).
- FE отправляет фрагменты на BE-ноды, где выполняются операции.
- BE возвращают частичные результаты в FE.
- FE агрегирует результат и отправляет обратно в BI.
Схема:
[BI Client] → FE (parse/optimize) → BE (scan/aggregate/join) → FE (merge) → BI
Модель хранения данных
StarRocks использует колоночное хранение с сегментами фиксированного размера.
- Преимущества: быстрее при агрегациях, экономит I/O.
- Файловая структура:
/storage/data/<tablet_id>/<rowset_id>/segment_<n>.dat
-
Партиционирование:
- Range (по дате, числовому диапазону).
- List (по значению).
- Composite (составное).
- Дистрибуция:
- Hash (по ключу, например, customer_id).
- Random (редко используется).
- Обычно factor=3 (каждый сегмент на трёх BE для HA).
- Репликация:
Типы таблиц и влияние на архитектуру
-
Duplicate Key — полная копия вставленных данных (без агрегаций и upsert).
- Применение: сырые логи, историю не меняем.
- Aggregate Key — агрегирует по ключам, хранит агрегированные значения.
- Применение: предагрегированные витрины.
- Применение: витрины, где данные обновляются.
- Primary Key — поддерживает upsert/delete, как в OLTP, но в аналитике.
Методологический совет: выбор типа таблицы делаем в ТЗ на DWH, иначе потом миграция — это пересоздание и перезагрузка данных.
Механизм векторизированного выполнения
StarRocks обрабатывает данные пачками (batch size обычно 4K–8K строк), а не построчно.
Это даёт:
- Уменьшение числа вызовов функций CPU.
- Оптимизацию под SIMD-инструкции.
- Лучшую кэш-локальность.
Влияние на проектирование:
- Чем шире пачка, тем меньше overhead, но больше память на BE.
- При join больших таблиц — правильный выбор batch size критичен.
Практические кейсы архитектурного проектирования
Кейс 1. Финансовая отчётность в банке
- Проблема: отчёт на 50+ джойнах, 200 млн строк в каждой таблице.
- Решение: вынести часть агрегаций в MVs, BE распределить по дате отчёта, join сделать по партиции.
- Результат: время запроса снизилось с 180 до 12 секунд.
- Риск: рост времени обновления MVs.
- Защита: использовать инкрементальное обновление MVs.
Кейс 2. Real-time мониторинг IoT
- Проблема: 1 млн записей в минуту из Kafka.
- Решение: Routine Load с партицией по дате+часу, PK-таблицы для upsert по device_id.
- Результат: задержка 2–3 секунды.
- Риск: перегрузка при суточных пиках.
- Защита: лимитировать Kafka batch size, масштабировать BE.
Риски и защита
|
Риск |
Как проявляется |
Как избежать |
|---|---|---|
|
FE перегружен запросами |
Высокая задержка при планировании |
Несколько FE в HA, балансировщик на входе |
|
Неравномерная дистрибуция данных |
BE с перегрузкой, а другие простаивают |
Хороший выбор hash key, анализ сегментов |
|
Падение BE и потеря сегментов |
Пропуски данных в запросах |
Репликация ≥3, мониторинг состояния BE |
|
MVs не обновляются вовремя |
BI видит старые данные |
Инкрементальное обновление, триггеры обновлений |
|
Большие джойны на сырых таблицах |
Взрыв памяти BE |
Предагрегация, разделение на витрины |
Методологические рекомендации по эксплуатации архитектуры
-
На этапе проектирования:
- Определить роль StarRocks (витрины или весь DWH).
- Выбрать тип таблиц под сценарий.
- Продумать партиционирование и дистрибуцию.
- На этапе внедрения:
- Настроить HA для FE.
- Заложить резерв в CPU/RAM на BE.
- Протестировать ingestion при пиковых нагрузках.
- Мониторить загрузку FE/BE и время ответа запросов.
- Ревизовать MVs и TTL.
- Периодически балансировать данные по BE.


