

Business Use Cases in Data Vault — Практическое руководство с примерами и рисками
Data Vault — это методология моделирования и интеграции данных, которая появилась как ответ на реальные проблемы бизнеса: множественность источников, быстро меняющиеся правила, требования к соблюдению нормативных актов, а также необходимость масштабируемости.
Если в традиционных подходах (Inmon, Kimball) ключевой упор делается на формирование единой структуры витрин, то в Data Vault — на гибкость архитектуры и возможность легко адаптировать модель к изменениям источников и бизнес-правил.
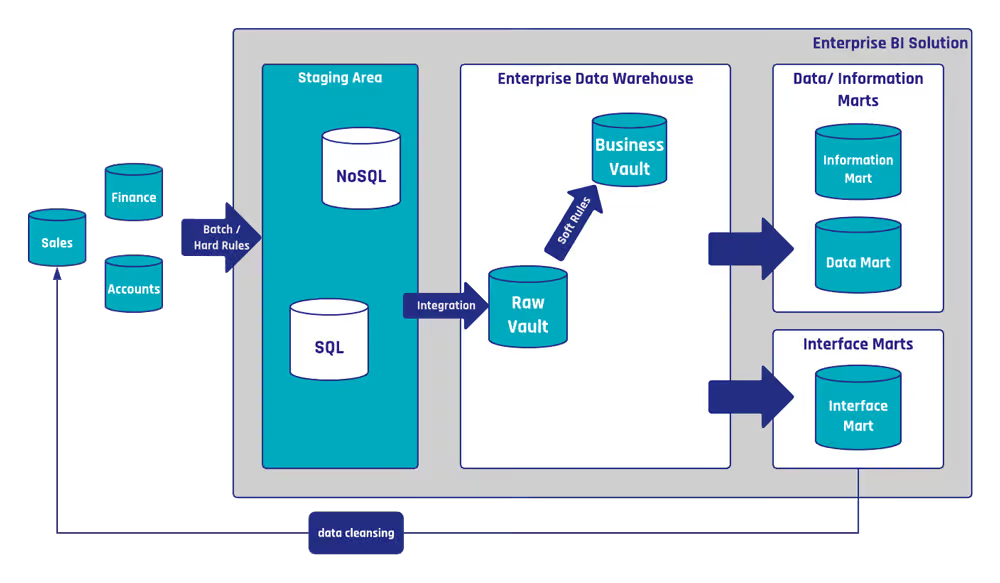
Понимание болевых точек бизнеса
Прежде чем выбрать Data Vault, важно понять, какие именно задачи он должен решать. Как говорил Michael Olschimke (Scalefree), если нет выраженной проблемы — не нужно изобретать сложное решение.
Типовые боли:
- Разрозненные источники данных (ERP, CRM, MES, веб-аналитика, API поставщиков и пр.).
- Отсутствие единого способа интеграции — разные форматы, разные бизнес-ключи, разные частоты обновлений.
- Требования регуляторов (GDPR, HIPAA, 152-ФЗ).
- Постоянно меняющиеся бизнес-правила — особенно в сложных отраслях (банки, фарма, e-commerce).
Пример из практики:
В крупной розничной сети было 17 систем-источников (от POS-терминалов до маркетинговых CRM). Интеграция шла через ETL в хранилище на star schema. Каждое изменение источника требовало полной переработки ETL и витрин, что тормозило вывод новых отчётов на месяцы. После перехода на Data Vault время адаптации под новый источник сократилось с 3 месяцев до 2 недель.
Основная сила Data Vault — интеграция данных
Data Vault строится на разделении информации на Hubs (ключи бизнес-сущностей), Links (связи между сущностями) и Satellites (контекст и история).
Это даёт возможность:
- Подключать новый источник без переработки всей модели.
- Хранить и обрабатывать сырые данные параллельно с очищенными.
- Интегрировать данные с несовпадающими бизнес-ключами через «переходные» хабы.
Техническая деталь:
Например, в системе CRM клиент может идентифицироваться по e-mail, а в ERP — по внутреннему ID. Data Vault позволяет завести Hub_Customer с обоими ключами и связать их через Link. Это снимает проблему единых ключей на уровне источников.
Соответствие требованиям регуляторов и приватности
В Data Vault легко реализовать требования по:
- Маскированию персональных данных в сателлитах.
- Физическому удалению или анонимизации PII-атрибутов.
- Разграничению доступа на уровне таблиц/столбцов (Column-Level Security).
Кейс:
Банк в ЕС использует Data Vault для хранения истории транзакций. При запросе на удаление клиента (GDPR) удаляется/анонимизируется только сателлит с PII, при этом ключи и связи в хабах/линках остаются для аналитики обезличенных данных.
Риск: если не внедрить чёткую политику версионирования сателлитов, можно случайно нарушить регламент (например, PII останется в старой версии сателлита).
Работа с изменяющимися бизнес-правилами
В традиционных DWH любое изменение логики расчётов может потребовать пересчёта исторических данных. Data Vault решает это через разделение:
- Raw Vault — слой сырых данных (без бизнес-логики).
- Business Vault — слой с применением бизнес-правил (в том числе версионных).
Пример:
В телеком-компании изменился расчёт KPI «Активный клиент» (теперь учитываются только клиенты с тарифом не ниже X). В Business Vault добавили новый сателлит с новым правилом, а старый остался для исторических отчётов.
Риск: если хранить бизнес-логику только в BI-слое, при смене инструмента придётся переносить и тестировать всю логику заново.
Масштабируемость и гибкость
Data Vault масштабируется:
- Вертикально — можно увеличивать мощность кластера БД.
- Горизонтально — распределять загрузку по узлам (особенно в MPP и облачных DWH).
- Функционально — добавлять новые хабы/сателлиты/линки без переработки других.
Технический момент:
Data Vault «дробит» входящие данные на базовые строительные блоки. Это даёт возможность из одной модели формировать и звёздочки, и плоские таблицы, и OLAP-кубы — под конкретные BI-задачи.
Data Vault и Business Intelligence
Data Vault обеспечивает Single Source of Truth для BI:
- Источник для витрин в star schema (Kimball-стиль).
- Источник для оперативных отчётов.
- Источник для продвинутой аналитики (ML, прогнозирование).
Кейс:
В фармацевтической компании BI-система (Power BI) получает данные из Data Vault. Для маркетинга формируется витрина в виде звезды, для регуляторов — таблица транзакций, для Data Science — полный набор исторических данных.
Риск: если Data Vault проектируется без учёта downstream-потребителей, можно получить «архивную» базу, из которой сложно строить быстрые витрины.
Работа со сложными моделями данных
Когда источники содержат «грязные» данные, дубликаты или разные ключи — Data Vault позволяет:
- Завести отдельный хаб для ключей каждого источника.
- Создать link для связи и кросс-маппинга ключей.
- Использовать computed satellites для очистки и нормализации.
Пример:
Два источника содержат данные о продуктах, но в одном SKU — это строка с буквами, в другом — только цифры. Создаётся Hub_Product с двумя наборами ключей и Link для их связи, а в computed satellite выполняется нормализация.
Когда применять Data Vault
Data Vault стоит применять, если:
- Много источников, которые постоянно меняются.
- Требуется строгая история изменений (full audit trail).
- Есть регуляторные требования к хранению и удалению данных.
- Нужно быстро масштабировать модель без переделки ETL.
Когда не стоит:
- Если источников мало и они стабильны.
- Если нет требований по аудиту и версии бизнес-правил.
- Если команда не готова к повышенной сложности модели.
Data Vault — это не просто ещё один способ моделирования данных. Это архитектурная философия, которая решает задачи интеграции, масштабируемости и гибкой адаптации под изменения.
В правильно спроектированном Data Vault бизнес получает:
- Единый источник правды.
- Возможность быстро адаптироваться к новым источникам и правилам.
- Готовность к аудиту и регуляторным проверкам.
Но как и любая методология, Data Vault эффективен только там, где есть реальные боли и потребность в гибкости.
Технический конвейер загрузки: пошагово и с примерами
Предпосылки и соглашения
- Все бизнес-ключи (BK) нормализуем одинаково (trim, upper, null→’’).
- Хеши считаем на нормализованных полях (например, SHA-256).
- Аудит-поля: record_source, load_dt, batch_id, effective_from, effective_to (для SAT), is_current.
- Idempotency: каждая джоба безопасна к повторному запуску (по batch_id/checksum).
Шаг 0. Landing / Raw Ingest
Что делаем: копируем сырьё в неизменяемое хранилище (S3/HDFS/таблицы стадирования), фиксируем source_ts, file_id, контрольные суммы.
Зачем: воспроизводимость и аудит «что прилетело».
Шаг 1. Staging Normalize
Что делаем: приводим типы, чистим пробелы и регистр, убираем дубль в пределах батча, формируем batch_id, load_dt, record_source.
Зачем: стандартизация перед хешированием и загрузкой в Raw Vault.
Псевдо-SQL:
CREATE TEMP TABLE stg_customer AS
SELECT
  UPPER(TRIM(src.customer_id))    AS bk_customer_id_norm,
  UPPER(TRIM(src.email))          AS email_norm,
  COALESCE(src.name, '')          AS name_norm,
  CURRENT_TIMESTAMP               AS load_dt,
  'CRM'                           AS record_source,
  :batch_id                       AS batch_id
FROM landing_crm_customers src
QUALIFY ROW_NUMBER() OVER (PARTITION BY bk_customer_id_norm ORDER BY load_dt DESC) = 1;
Шаг 2. HUB (новые бизнес-ключи)
Что делаем: считаем hk_customer как хеш от нормализованного BK; вставляем только новые BK.
-- Хеш ключа
WITH keys AS (
  SELECT
    stg.bk_customer_id_norm,
    TO_HEX(SHA256(stg.bk_customer_id_norm)) AS hk_customer,
    stg.load_dt, stg.record_source
  FROM stg_customer stg
)
INSERT INTO hub_customer (hk_customer, bk_customer_id, load_dt, record_source)
SELECT k.hk_customer, k.bk_customer_id_norm, k.load_dt, k.record_source
FROM keys k
LEFT JOIN hub_customer h ON h.hk_customer = k.hk_customer
WHERE h.hk_customer IS NULL;
Шаг 3. LINK (связи между HUB'ами)
Что делаем: строим связь, хеш-ключ линка — от набора участвующих hk_*. Вставляем, если такой связи ещё не было.
WITH pairs AS (
  SELECT
    c.hk_customer,
    a.hk_account,
    TO_HEX(SHA256(CONCAT(c.hk_customer, '|', a.hk_account))) AS hl_customer_account,
    CURRENT_TIMESTAMP AS load_dt, 'CRM' AS record_source
  FROM hub_customer c
  JOIN stg_account s ON s.customer_id_norm = c.bk_customer_id
  JOIN hub_account a ON a.bk_account_id = s.account_id_norm
)
INSERT INTO link_customer_account (hl_customer_account, hk_customer, hk_account, load_dt, record_source)
SELECT p.hl_customer_account, p.hk_customer, p.hk_account, p.load_dt, p.record_source
FROM pairs p
LEFT JOIN link_customer_account l ON l.hl_customer_account = p.hl_customer_account
WHERE l.hl_customer_account IS NULL;
Шаг 4. SAT (история описательных атрибутов)
Что делаем: считаем hashdiff от описательных полей; если изменилось — закрываем предыдущую строку (effective_to) и вставляем новую.
WITH sat_src AS (
  SELECT
    h.hk_customer,
    TO_HEX(SHA256(CONCAT(name_norm, '|', email_norm))) AS hashdiff,
    name_norm, email_norm,
    s.load_dt, s.record_source
  FROM stg_customer s
  JOIN hub_customer h ON h.bk_customer_id = s.bk_customer_id_norm
),
changed AS (
  SELECT s.*
  FROM sat_src s
  LEFT JOIN sat_customer sc
    ON sc.hk_customer = s.hk_customer
   AND sc.is_current = 1
  WHERE sc.hashdiff IS NULL OR sc.hashdiff <> s.hashdiff
)
-- закрываем предыдущую версию
UPDATE sat_customer sc
SET effective_to = c.load_dt, is_current = 0
FROM changed c
WHERE sc.hk_customer = c.hk_customer AND sc.is_current = 1;
-- вставляем новую
INSERT INTO sat_customer
(hk_customer, hashdiff, name, email, effective_from, effective_to, is_current, load_dt, record_source)
SELECT hk_customer, hashdiff, name_norm, email_norm,
       load_dt, NULL, 1, load_dt, record_source
FROM changed;
Поздно пришедшие записи: вычисляйте effective_from по бизнес-времени (as_of_date из источника), а не по load_dt.
Шаг 5. PIT (Point-in-Time)
Что делаем: для быстрого джойна выбираем актуальные на дату (as_of) строки SAT по каждому HUB; материализуем PIT.
CREATE OR REPLACE TABLE pit_customer AS
SELECT
  h.hk_customer,
  s.name, s.email,
  s.effective_from, s.effective_to,
  CURRENT_DATE AS as_of_date
FROM hub_customer h
JOIN LATERAL (
  SELECT *
  FROM sat_customer s
  WHERE s.hk_customer = h.hk_customer
    AND (s.effective_to IS NULL OR s.effective_to > CURRENT_DATE)
    AND s.effective_from <= CURRENT_DATE
  ORDER BY s.effective_from DESC
  LIMIT 1
) s ON TRUE;
Шаг 6. BRIDGE
Что делаем: предрасчёт сложных иерархий/многие-ко-многим, чтобы ускорить BI-запросы.
CREATE OR REPLACE TABLE bridge_customer_account AS
SELECT
  l.hk_customer, l.hk_account,
  MIN(l.load_dt) AS rel_since,
  COUNT(*)       AS rel_count
FROM link_customer_account l
GROUP BY 1,2;
Шаг 7. Business Vault (версии правил)
Что делаем: применяем бизнес-правила (калькуляции, фильтры) в вычисляемых сателлитах и версируем эти правила.
-- Пример: правило "активный клиент v2"
INSERT INTO sat_customer_flags
(hk_customer, rule_version, is_active, effective_from, load_dt, record_source)
SELECT
  p.hk_customer,
  'active_v2',
  CASE WHEN COALESCE(f.total_txn_90d,0) >= 3 THEN 1 ELSE 0 END,
  CURRENT_DATE, CURRENT_TIMESTAMP, 'RULES_ENGINE'
FROM pit_customer p
LEFT JOIN fct_txn_agg_90d f ON f.hk_customer = p.hk_customer;
Храните артефакты правила (SQL/код, хэш, описание) и ссылку на rule_version в линейдже.
Шаг 8. Information Marts
Что делаем: публикуем под потребителей. Обычно это:
- DIM (SCD2) — из PIT/BRIDGE/конформных справочников.
- FACT — из LINK/событий, с денормализацией измерений через PIT.
CREATE VIEW dim_customer AS
SELECT
  p.hk_customer AS sk_customer,
  p.name, p.email,
  p.effective_from, p.effective_to,
  CASE WHEN p.effective_to IS NULL THEN 1 ELSE 0 END AS is_current
FROM pit_customer p;
CREATE VIEW fct_sales AS
SELECT
  l.hl_customer_account AS sk_rel,
  s.txn_id, s.amount, s.txn_ts,
  dc.sk_customer
FROM link_customer_account l
JOIN src_sales s ON s.customer_id = l.hk_customer
JOIN dim_customer dc ON dc.sk_customer = l.hk_customer
WHERE dc.is_current = 1;
Оркестрация и эксплуатация
- Порядок и параллелизм: HUB → LINK → SAT; разные сущности — параллельно, внутри сущности — по зависимостям.
- Идемпотентность: дедуп по batch_id и контрольным суммам; повтор запуска безопасен.
- CDC: где возможно — используйте ленты изменений; снижает нагрузку SAT.
- DQ-контроллинг: completeness, uniqueness BK, referential integrity, drift схемы.
- Тесты: контрактные на входе, юнит-тесты правил Business Vault, регресс-набор для витрин.
- СЛА: мониторьте «время до витрины», количество изменённых строк, отставание PIT, ретраи.
Риски и как их закрыть
- Волатильные BK: если бизнес-ключ меняется — добавляйте стабильный технический идентификатор (или согласованный суррогат), фиксируйте смены в LINK.
- Коллизии хешей: используйте крипто-хеши (SHA-256), нормализуйте входные строки и логируйте длину/состав.
- Поздние/искажённые данные: отделяйте business_time и load_time, стройте PIT «на дату», делайте backfill-джобы.
- Переусложнение модели: начинайте с минимально жизнеспособного набора H/L/S, расширяйте только под конкретный кейс BI/регулятора.
- PII/комплаенс: храните PII в отдельных SAT, применяйте маскирование/шифрование, разграничение доступа по столбцам.
- Производительность: материализуйте PIT/BRIDGE, ставьте индексы по hk_* и effective_*, используйте кластерные ключи/партиции по дате загрузки.
Чек-лист запуска Data Vault проекта
1. Подготовительный этап (Before you start)
- Определены бизнес-боли, которые решает Data Vault (сложная интеграция, регуляторка, меняющиеся правила, аудит).
- Проведена оценка целесообразности: нет ли простого решения (например, Kimball для 2–3 стабильных источников).
- Назначен Product Owner и Data Architect, которые будут держать целостность архитектуры.
- Определён бюджет и выделены ресурсы (люди, железо, лицензии).
- Согласована методология моделирования: классический DV 2.0, DV + PIT/Bridge, расширения.
- Выбран технологический стек: СУБД (Snowflake, Greenplum, Postgres, BigQuery и т.д.), оркестратор (Airflow, Dagster), DQ, Data Catalog.
- Оценены интеграционные ограничения: VPN, API-лимиты, доступы, форматы файлов.
2. Анализ и проектирование (Design)
- Проведена инвентаризация источников: система, тип данных, объём, частота обновления, SLA, доступ.
- Определены бизнес-ключи (BK) для всех сущностей, зафиксированы правила нормализации.
- Согласованы правила хеширования (алгоритм, порядок полей, кодировка).
- Спроектированы Hubs, Links, Satellites для первой итерации (MVP).
- Выбрана стратегия построения PIT/Bridge для оптимизации BI-запросов.
- Описана архитектура Business Vault: какие бизнес-правила будут версионироваться.
- Определены зоны хранения: Landing, Staging, Raw Vault, Business Vault, Marts.
- Согласован подход к CDC и обработке late-arriving data.
- Определена политика DQ: completeness, uniqueness BK, referential integrity, drift схемы.
- Спроектированы механизмы PII-маскирования и разграничения доступа (Column-Level Security).
3. Инфраструктура и DevOps (Build Foundation)
- Развернута среда разработки, теста и продуктив (dev/test/prod).
- Настроен CI/CD для ETL/ELT-процессов и SQL-скриптов.
- Настроен оркестратор (Airflow, Dagster и др.) с логированием и ретраями.
- Реализовано хранилище метаданных для линейджа и технической информации.
- Настроены мониторинг и алерты (время выполнения джоб, ошибки, SLA).
- Подготовлены шаблоны ETL-джоб (HUB/LINK/SAT загрузки, PIT, BRIDGE).
4. Разработка MVP (Implement)
- Реализованы джобы Landing/Staging с нормализацией BK.
- Построены HUB-таблицы с хеш-ключами.
- Построены LINK-таблицы для связей.
- Построены SAT-таблицы с хеш-диффами атрибутов и историей.
- Реализованы PIT/BRIDGE для ускорения BI-запросов.
- Реализован Business Vault с первой версией бизнес-правил.
- Построены витрины (Information Marts) под первые бизнес-отчёты.
- Настроены тесты ETL (проверка ключей, DQ, referential integrity).
5. Тестирование и валидация (Test & Validate)
- Проверена полнота загрузки (row count vs источники).
- Проверена уникальность BK в HUB.
- Проверена референтная целостность HUB-LINK и LINK-SAT.
- Протестирована обработка поздних данных.
- Протестированы PII-политики (маскирование, удаление).
- Проведена производительная проверка (объём, параллелизм).
- Получено подтверждение бизнеса, что витрины соответствуют требованиям.
6. Вывод в продуктив (Go-Live)
- Настроено ежедневное/часовое расписание загрузок с SLA.
- Настроены ретраи и алерты на сбои.
- Документация (архитектура, схемы, описание BK, правила трансформаций) передана в эксплуатацию.
- Обучена эксплуатационная команда.
- Установлены метрики успеха (время внедрения нового источника, стабильность загрузки, время ответа витрин).
7. Эксплуатация и развитие (Run & Evolve)
- Проводятся регулярные ревью модели на предмет упрощения/оптимизации.
- Добавляются новые источники без нарушения текущей архитектуры.
- Версионируются и документируются новые бизнес-правила в Business Vault.
- Поддерживается актуальность PIT/BRIDGE для BI.
- Обновляются политики безопасности и DQ.
- Отслеживается стоимость владения и эффективность.


