

Управление данными в современном бизнесе: как избежать хаоса с помощью платформы dbt
В современном мире данные стали ключевым активом для любой компании. Однако их объем и сложность растут экспоненциально, а требования бизнеса меняются ежедневно. Традиционные подходы к построению хранилищ данных часто не справляются с этими вызовами, приводя к хаосу, ручному труду и критическим ошибкам. Гибкие методологии, такие как Data Vault, предлагают решение проблем масштабируемости и адаптивности, но одновременно порождают новые сложности: лавинообразный рост количества таблиц, необходимость бесчисленных соединений (joins) и ручное, трудоемкое наполнение этих структур.
Наша компания предлагает комплексное решение этих проблем с помощью внедрения современной платформы dbt (data build tool). Это не просто инструмент, а целая экосистема, которая превращает ваше хранилище данных в надежный, документированный и легко управляемый актив. Мы не просто передаем вам инструмент — мы внедряем культуру работы с данными, основанную на автоматизации, контроле версий и коллаборации.
Представьте себе типичную ситуацию: ваша команда инженеров данных тратит до 80% времени не на анализ и извлечение ценных инсайтов, а на рутинную, ручную работу. Каждое новое требование от аналитиков влечет за собой написание десятков однотипных SQL-запросов для инкрементального обновления таблиц - это не только медленно, но и крайне подвержено ошибкам. У каждого инженера свой стиль написания кода. Отсутствие единых правил делает код непонятным, его поддержку — невозможной, а адаптацию новых сотрудников — длительной. Изменение логики в одной таблице может привести к каскадному падению десятков зависимых отчетов. Отследить эти зависимости без специальных инструментов практически нереально. В итоге со временем никто в компании не может точно сказать, что означает та или иная колонка в таблице, откуда в ней берутся данные и насколько им можно доверять.
dbt отлично справляется со всеми этими проблемами, переводя работу с данными на качественно новый уровень.
dbt — это фреймворк, который позволяет инженерам данных безопасно, предсказуемо и эффективно трансформировать данные в хранилище, используя привычный SQL, но с мощью современной разработки. Он берет на себя всю рутину: инкрементальные обновления, создание представлений, управление зависимостями и документацию. Ваша команда фокусируется на бизнес-логике, а dbt заботится о ее исполнении.
Быстрый старт: настройка проекта
Внедрение начинается с инициализации проекта.
В качество целевой базы данных выбираем postgres (настроена локально на машине). Далее создаем папку проекта и настраиваем окружение python3:
pip install dbt-core==1.1.0 dbt-postgres==1.1.0
Инициализируем dbt проект:
(venv) ➜  PostgresDBTIntro dbt init
11:32:18  Running with dbt=1.1.0
Enter a name for your project (letters, digits, underscore): dbt_postgres_intro
Which database would you like to use?
[1] postgres
(Don\'t see the one you want? https://docs.getdbt.com/docs/available-adapters)
Enter a number: 1
11:33:04
Your new dbt project "dbt_postgres_intro" was created!
У вас в проекте должна появиться папка с таким же названием, как и имя проекта.
Рассмотрим файлы, которые должны были появиться после инициализации проекта.
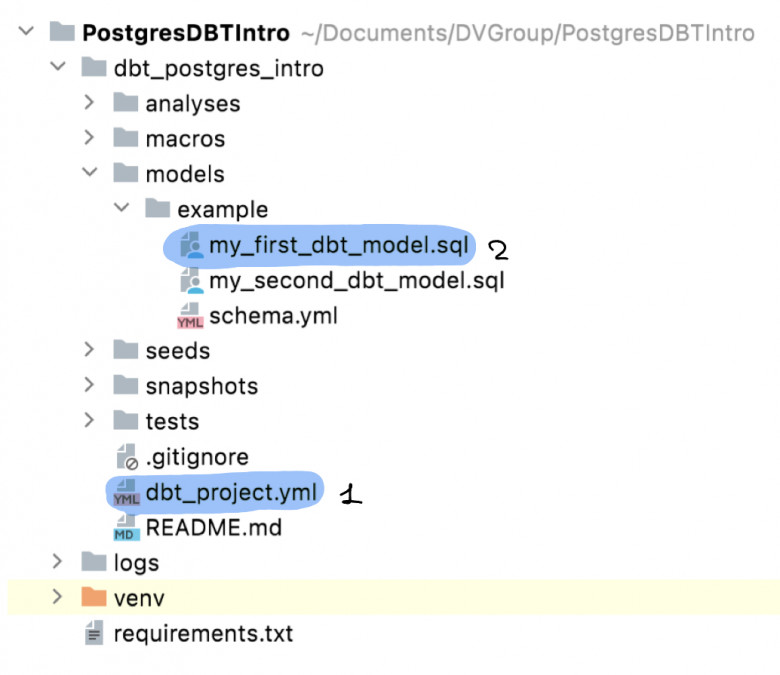
Под номером один - файл dbt_project.yml, в котором мы описываем структуру проекта. Также сюда можно добавть хуки on-run-start, on-run-end. К этому вернемся чуть позже, а сейчас рассмотрим файл № 2 - my_first_dbt_model.sql:
/*
    Welcome to your first dbt model!
    Did you know that you can also configure models directly within SQL files?
    This will override configurations stated in dbt_project.yml
    Try changing "table" to "view" below
*/
{{
    config(materialized='table')
}}
with source_data as (
    select 1 as id
    union all
    select null as id
)
select *
from source_data
/*
    Uncomment the line below to remove records with null `id` values
*/
-- where id is not null
Пропускаем блок комментариев (/* ... */) и видим:
{{
    config(materialized='table')
}}
DBT построен на основе Jinja, поэтому {{ ... }} используются для экранирования кода. В нем вызываем функцию config, в которую передаем аргументы для конфигурации модели. У нас всего лишь один аргумент materialized со значением 'table'. Это значит, что по окончании запуска модели “my_first_dbt_model”,должна быть создана таблица с таким же названием, как и название файла.
Далее идет sql код для выбора данных:
select *
from source_data
Рассмотрим файл profiles.yml:
config:
  send_anonymous_usage_stats: False
  use_colors: True
  partial_parse: True
dbt_postgres_intro:
  outputs:
    dev:
      type: postgres
      threads: 3
      host: localhost
      port: 5432
      user: markporoshin
      pass: "<password>"
      dbname: dbt_intro_db
      schema: public
  target: dev
Я разместил этот файл на одном уровне с файлом dbt_project.yml. DBT предлагает стандартное расположение файла со всеми конфигурациями (/Users/<user>/.dbt/profiles.yml на mac os). Чтобы узнать дефолтное расположение, нужно попробовать запустить модель- в логах dbt напишет, где он ищет файл с конфигами подключения:
dbt run --project-dir ./ -m my_first_dbt_model
Если расположить profiles.yml также как и мы, вызов модели будет выглядеть так:
dbt run --project-dir ./ --profiles-dir ./ --profile dbt_postgres_intro -m my_first_dbt_model
В данном случае мы указываем расположением dbt проекта --project-dir ./; путь к папке с файлом profiles.yml - --profiles-dir ./; а также название профиля --profile dbt_postgres_intro.
При запуске модели Postgres dbt дополнит его create table ... as ... и мы получим следующий код для создания таблицы:
create  table "dbt_intro_db"."public"."my_first_dbt_model__dbt_tmp" as (
                with source_data as (
                    select 1 as id
                    union all
                    select null as id
                )
                select *
                from source_data
);
DBT создал нам табличку, но в названии присутствует постфикс __dbt_tmp. Это связано с тем, что dbt создает таблицу поэтапно:
-- создание новой таблицы
create  table "dbt_intro_db"."public"."my_first_dbt_model__dbt_tmp" as (
with source_data as (
    select 1 as id
    union all
    select null as id
)
select *
from source_data
);
 -- если целевая таблица уже есть, переименуем ее в backup
alter table "dbt_intro_db"."public"."my_first_dbt_model" rename to "my_first_dbt_model__dbt_backup";
 -- теперь переименуем новую таблицу в целевую
alter table "dbt_intro_db"."public"."my_first_dbt_model__dbt_tmp" rename to "my_first_dbt_model"
-- после того, как все предыдущие этапы прошли успешно, можем удалять backup
drop table if exists "dbt_intro_db"."public"."my_first_dbt_model__dbt_backup" cascade
dbt отслеживает успешность обновления таблицы, и если что-то идет не так, то он вернет все к “статусу кво”.
Проследить за тем, что делает dbt при вызове модели, можно с помощью добавления флага –d:
dbt -d run --profiles-dir ./ --profile dbt_postgres_intro -m my_first_dbt_model
Как работает магия dbt?
Процесс работы dbt состоит из двух ключевых фаз:
- Парсинг и компиляция - dbt считывает все файлы моделей, макросов и тестов, преобразуя встроенный код на Jinja (шаблонизатор) в чистый, готовый к выполнению SQL.
- Выполнение - скомпилированные SQL-запросы выполняются в целевой базе данных.
Это разделение критически важно для понимания и отладки. Например, на этапе компиляции можно увидеть итоговый SQL-код, который уйдет в базу, что исключает множество потенциальных ошибок.
Ваша первая модель в dbt — это обычный SQL-файл с небольшим добавлением:
{{
  config(materialized='table')
}}
select 1 as id
Директива config указывает dbt, как материализовать результат — в данном случае в виде таблицы. При запуске dbt run инструмент самостоятельно сгенерирует оптимальный SQL-код для создания или замены этой таблицы, используя транзакции и временные объекты для обеспечения целостности данных. Если в процессе обновления возникнет ошибка, dbt автоматически откатит изменения, предотвращая частичное обновление и простои.
Мощь Jinja
Настоящая сила dbt раскрывается при использовании шаблонизатора Jinja, который превращает статический SQL в динамический, легко переиспользуемый код.
Создадим новую dbt модель для того, чтобы немного наполнить нашу базу данными:
{{
    config(
        materialized='table',
    )
}}
select 1 as id, 'Nikita' as name, 'Analytics' as type
union
select 2 as id, 'Stanislav' as name, 'Analytics' as type
union
select 3 as id, 'Alex' as name, 'CTO' as type
union
select 4 as id, 'Artem' as name, 'DevOps' as type
union
select 5 as id, 'Artem' as name, 'DataScience' as type
union
select 6 as id, 'Victor' as name, 'Backend' as type
union
select 7 as id, 'Mark' as name, 'DataEngineer' as type
Переменные позволяют централизованно управлять параметрами.
В dbt есть 2 способа работать с переменными.
Во-первых, можно указать их в файле dbt_projects.yml:
vars:
  developer_name: "Nikita"
А дальше использовать в модели:
{{
    config(
        materialized='view',
    )
}}
select
    id,
    type
from {{ ref('developers') }} d
where d.name = '{{ var('developer_name') }}'
Здесь мы видим сразу несколько интересных моментов. В качестве материализации мы выбрали тип 'view', что приводет нас к созданию не таблицы, а view. Дальше в качестве источника данных указываем {{ ref('developers') }}. В условии where с помощью макроса var обращаемся к глобальным переменным dbt и вытягиваем значение переменной developer_name.
Во 2 случае мы можем использовать локальные переменные:
{{
    config(
        materialized='view',
    )
}}
{% set type = 'DevOps' %}
select
    id,
    name
from {{ ref('developers') }} d
where type = '{{ type }}'
Создаем переменную с помощью set и экранизируем это все с помощью {% … %}.
Вообще в dbt существует 3 типа “экранизации”:
- {{ ... }} — для вывода переменных или результатов выполнения макросов в скомпилированный файл;
- {% ... %} — для объявления переменных, циклов, условных операторов и т.д.;
- {# ... #} — комментарии.
Далее поговорим о циклах, которые позволяют избежать многострочных конструкций UNION ALL или длинных условий IN.
Ниже - пример модели, в которой используются массив и цикл:
{{
    config(
        materialized='table',
    )
}}
{%- set types = ['Analytics', 'DataScience'] -%}
select
    id,
    name
from
    {{ ref('developers') }}
where type in (
    {%- for type in types -%}
        '{{ type }}'
        {%- if not loop.last %},{% endif -%}
    {%- endfor -%}
)
Расширенные возможности: выполнение вспомогательных запросов и макросы
Иногда логика преобразования данных требует предварительного выполнения запроса. Например, нужно получить список актуальных идентификаторов для фильтрации.
Рассмотрим использование вспомогательных запросов на следующем примере:
{{
    config(
        materialized='table'
    )
}}
{% set names_start_with_a_query %}
    select
        name
    from
        {{ ref('developers') }}
    where lower(name) like 'a%'
{% endset %}
{% set names_start_with_a = [] %}
{% if execute %}
    {% set names_start_with_a = run_query(names_start_with_a_query).columns[0].values() %}
{% endif %}
{{ log(names_start_with_a, info=True) }}
select
    id,
    name,
    type
from
    {{ ref('developers') }}
{% if names_start_with_a != () %}
    where name in (
        {%- for name in names_start_with_a %}
            '{{ name }}'
            {%- if not loop.last %},{% endif -%}
        {%- endfor -%}
    )
{% endif %}
После блока с конфигурацией модели мы определяем переменные, names_start_with_a_query, names_start_with_a в которые записываем вспомогательный запрос и пустой массив.
Следом указываем условный оператор, где выполняем запрос находящийся в переменной names_start_with_a_queryи записываем результат в переменную names_start_with_a.
Макросы— это еще одни пользовательские функции на Jinja, которые позволяют выносить повторяющуюся логику в отдельные модули. Это краеугольный камень для соблюдения принципа DRY (Don't Repeat Yourself) в вашем проекте.
Создадим в папке macros файл so_important_macro.sql:
{% macro so_important_macro(number) %}
    {% set so_important_query %}
        select 1 as info
        union
        select 2 as info
    {% endset %}
    {%- set info = run_query(so_important_query).columns[0].values() -%}
    {{ log('number ' + number|string, info=True) }}
    {{ return(info) }}
{% endmacro %}
Можем использовать его в нашей модели:
{{
    config(
        materialized='table'
    )
}}
{% if execute %}
    {% set info =  so_important_macro(4) %}
    {{ log(' info: ' + info|string, info=True) }}
{% endif %}
select 1 as id
В логах мы получим следующее:
Running with dbt=1.1.0
Found 8 models, 4 tests, 0 snapshots, 0 analyses, 168 macros, 0 operations, 0 seed files, 0 sources, 0 exposures, 0 metrics

Concurrency: 3 threads (target='dev')
1 of 1 START table model public.test_macro ..................................... [RUN]
number 4
info: (Decimal('1'), Decimal('2'))
1 of 1 OK created table model public.test_macro ................................ [SELECT 1 in 0.15s]

Finished running 1 table model in 0.24s.

Completed successfully

Done. PASS=1 WARN=0 ERROR=0 SKIP=0 TOTAL=1
Инкрементальная материализация: сердце эффективного ETL
Одна из самых востребованных функций dbt — это возможность инкрементального обновления таблиц. Вместо полной пересборки огромной таблицы каждый раз dbt добавляет в нее только новые или измененные данные.
Рассмотрим следующий пример: предположим, что мы хотим на каждый запуск модели добавлять в нее максимальное значение в таблице +1, если в таблице нет данных, тогда вставляем 1.
{{
    config(
        materialized='incremental'
    )
}}
{% set data_to_insert = 1 %}
{% if is_incremental() %}
    {% set max_number_query %}
        select max(num) from {{ this }}
    {% endset %}
    {% set data_to_insert = run_query(max_number_query).columns[0].values()[0]|int + 1 %}
{% endif %}
{{ log('number to insert: ' + data_to_insert|string, info=True)}}
select {{ data_to_insert }} as num
is_incremental доступен для моделей с типом incremental, он возвращает True, если таблица уже существует (это необходимо в случае наличия рекурсии в запросе).
Рассмотрим, что произойдет, если мы запустим модель - is_incremental() вернет False и в результате будет создана таблица с одной строчкой со значением 1.
Если после этого мы попробуем запустить модель еще раз, is_incremental() вернет True. Внутри условного оператора мы определим sql запрос, который возвращает максимальное значение из текущей таблицы(this — специальная переменная dbt, которая возвращает Relation на текущую таблицу). Таким образом, при втором запуске в таблицу будет вставлено значение 2, в третий раз - 3 и так далее.
Теперь рассмотрим пример использования инкрементальной материализации с дедубликацией.
Предположим, у вас есть таблица-источник raw_source, в которую периодически вставляются данные, но в ней могут встречаться и дубликаты строчек. Предположим, что существует поле id, которое уникально для набора остальных атрибутов. Мы хотим создать таблицу, в которой будут храниться только уникальные значения.
Создадим в папке models файл source.yml, в котором мы опишем источники данных (таблицы, которые наполняются из внешних источников и не являются моделями dbt):
version: 2
sources:
  - name: raw
    schema: public
    tables:
      - name: raw_source
Опишем модель stage_source.sql:
{{
    config(
        materialized='incremental'
    )
}}
select distinct on (src.id)
    src.*
from
    {{ source('raw', 'raw_source') }} src
{% if is_incremental() %}
    left join
    {{ this }} dst
    on src.id = dst.id
where dst.id is null
{% endif %}
При первичным запуске select будет выглядеть следующим образом:
select distinct on (src.id)
    src.*
from
    "dbt_intro_db"."public"."raw_source" src
Видно, что мы выбираем все данные из raw_source и дедублицируем их по src.id
Если мы попробуем запустить второй раз:
select distinct on (src.id)
    src.*
from
    "dbt_intro_db"."public"."raw_source" src
    left join
    "dbt_intro_db"."public"."stage_source" dst
    on src.id = dst.id
where dst.id is null
То сначала попытаемся найти данные, которых еще нет в stage_source и после этого дедублицируем их по ключу src.id.
Документация
Приятным дополнением в dbt является автоматическая генерация документации. Сгенерировать документацию и запустить сервер с ui можно следующим образом:
dbt docs generate --profiles-dir ./ --profile dbt_postgres_intro
dbt docs serve --profiles-dir ./ --profile dbt_postgres_intro
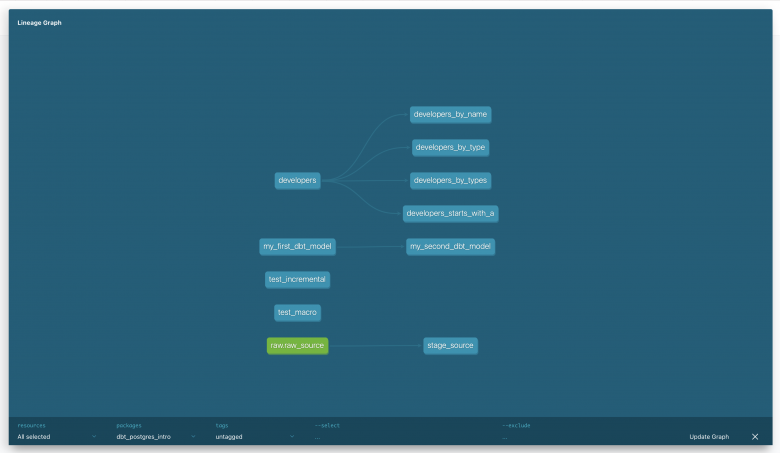
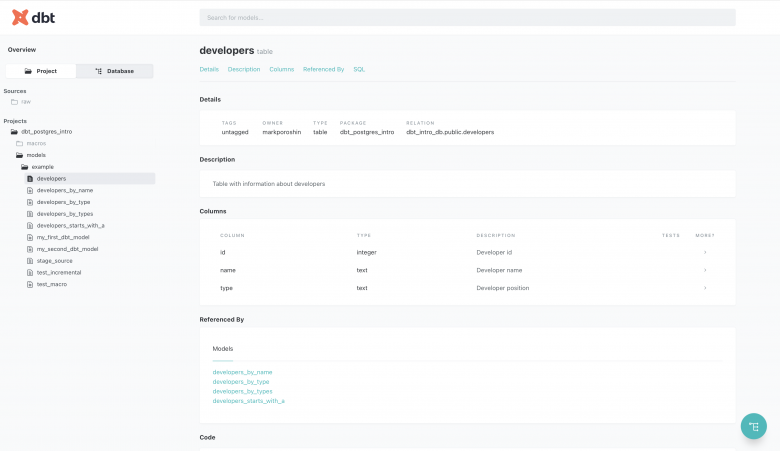
Так же можно писать документацию моделей в schema.yml, лежащим на уровне моделей, тогда все это тоже будет оформлено в ui:
Потенциальные риски и ошибки при внедрении dbt
- Неправильная организация проекта: хаотичная структура папок и моделей быстро приводит к бардаку. Наше решение: мы помогаем разработать и внедрить понячную и масштабируемую структуру проекта (например, разделение на слои staging, mart, core), которая интуитивно понятна всей команде;
- Злоупотребление сложными Jinja-конструкциями: слишком сложная логика в шаблонах может сделать код неподдерживаемым. Наше решение: принцип "простота и читаемость прежде всего" помогает выносить сложную логику в макросы и тестировать их.
- Ошибки производительности: неоптимальный SQL, сгенерированный в результате компиляции, может "положить" базу. Наше решение: на этапе внедрения мы проводим тщательный анализ и тестирование скомпилированного кода, учим вашу команду использовать инструменты анализа выполнения запросов (EXPLAIN ANALYZE в Postgres).
- Безопасность: хранение чувствительных данных в репозитории (например, в виде сидов). Наше решение: мы помогаем настроить интеграцию с системами управления секретами (HashiCorp Vault, AWS Secrets Manager) и применяем практики шифрования и маскирования данных.
- Отсутствие тестирования: развертывание непроверенных моделей в прод. Наше решение: внедряем культуру тестирования с использованием встроенных в dbt тестов (уникальность, ссылочная целостность, допустимость значений) и кастомных тестов для проверки сложной бизнес-логики.
Итак, dbt это не следующий шаг в эволюции ETL, это скачок в новое измерение эффективности, надежности и сотрудничества в работе с данными. Это платформа, которая позволяет вашей команде перейти от борьбы с техническим долгом и рутиной к созданию реальной бизнес-ценности.


