

Создание сквозных конвейеров машинного обучения на базе DBT и BigQuery
В современном мире, управляемом данными, способность быстро внедрять и масштабировать решения в области машинного обучения (ML) становится ключевым конкурентным преимуществом. Однако большинство компаний сталкиваются с одними и теми же проблемами: разрозненность данных, сложность организации процессов Feature Engineering, длительные циклы разработки моделей и высокая стоимость инфраструктуры.
Мы предлагаем комплексное решение для построения сквозных конвейеров машинного обучения, полностью интегрированных в ваше хранилище данных. Наша методология, основанная на синергии dbt (data build tool) и Google BigQuery ML, позволяет автоматизировать весь жизненный цикл ML — от подготовки данных и инженерии признаков до обучения моделей и инференса — без необходимости перемещения данных и создания сложной инфраструктуры.
Почему традиционные ML-пайплайны терпят неудачу?
Классический подход к машинному обучению часто предполагает выгрузку данных из хранилища в локальные файлы (CSV, Parquet), обработку и Feature Engineering на отдельных серверах или в кластерах Spark, обучение моделей на выделенных GPU/CPU-инстансах, а также развертывание модели в продакшен-среде и организацию инференса.
Этот процесс чреват множеством скрытых проблем. Во-первых, это касается безопасности - многократное копирование и перемещение чувствительных данных увеличивает риски утечек. Во – вторых, это задержки - данные быстро устаревают. Модель, обученная на данных недельной давности, часто теряет свою актуальность и точность. В – третьих, это стоимость. Содержание отдельной инфраструктуры для ML (Spark-кластеры, GPU-серверы) обходится чрезвычайно дорого. И, в- четвертых, это конечно же сложность - для поддержки такого пайплайна требуется большая команда разноплановых специалистов: инженеры данных, ML-инженеры, DevOps.
Наше решение - ML-пайплайны внутри облачного хранилища данных.
Мы предлагаем принципиально иной подход, который использует мощность и масштабируемость современного облачного DWH. В нашем случае — это Google BigQuery.
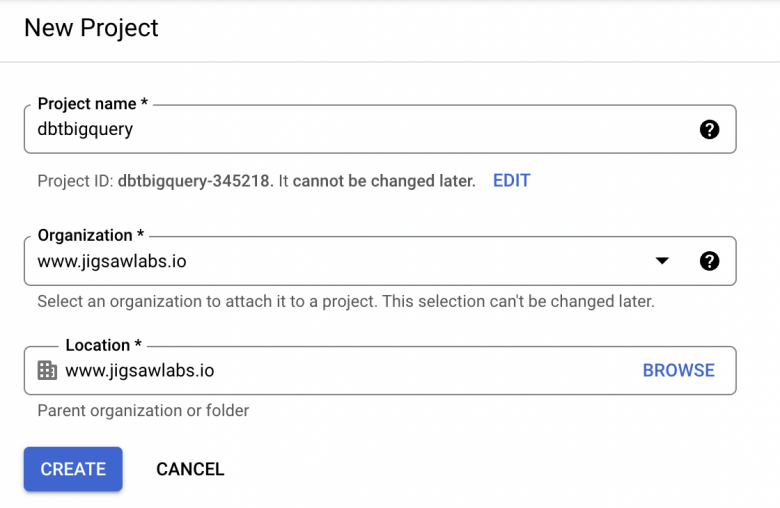
Для настройки данного инструмента зайдем в Google Cloud Console и создадим новый проект под названием dbtbigquery.
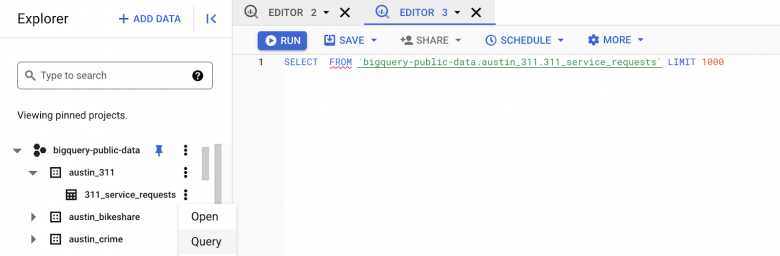
На этом этапе уже можно выполнять запросы. Если вы кликните на базу данных, austin_311, затем на таблицу внутри набора данных, а затем на Query, Google откроет заготовку под этот запрос.
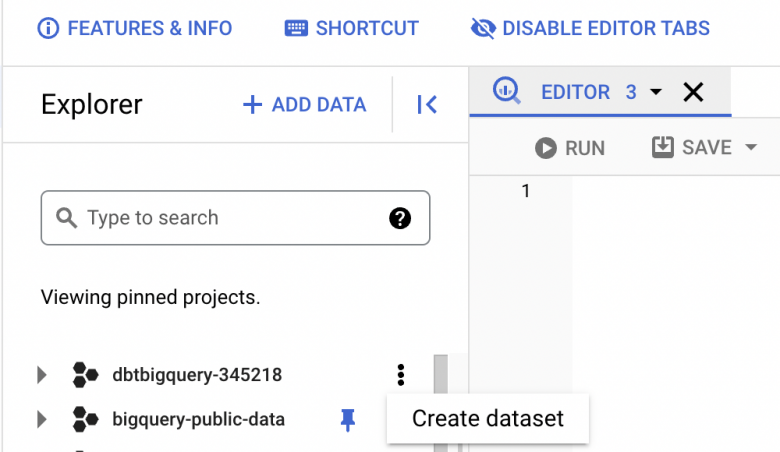
Следующий шаг - загрузка любой выборки данных в BigQuery и запуск процесса ML.
Мы можем вызвать mixpanel набора данных и оттуда создать новую таблицу:
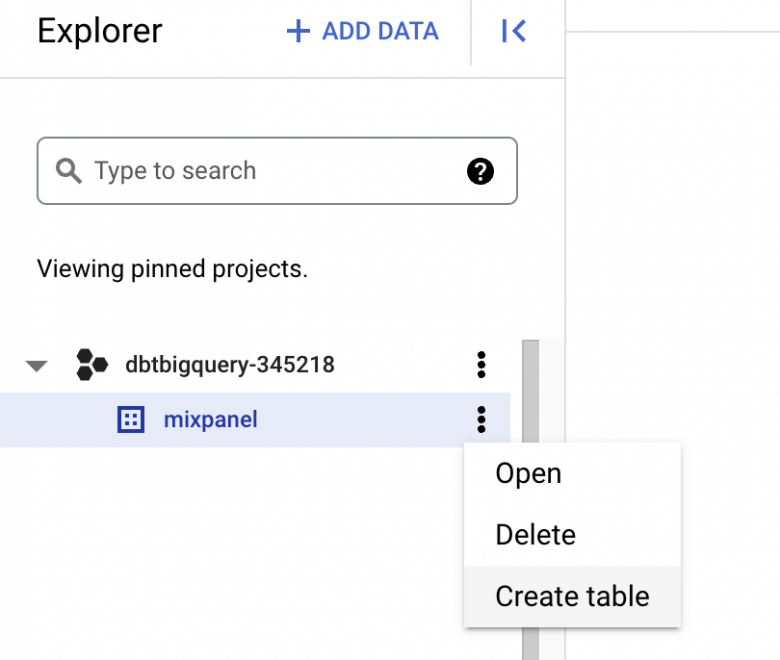
Вводим в появившуюся форму следующую информацию:
В разделе Select Drive URI указываем следующий URL:
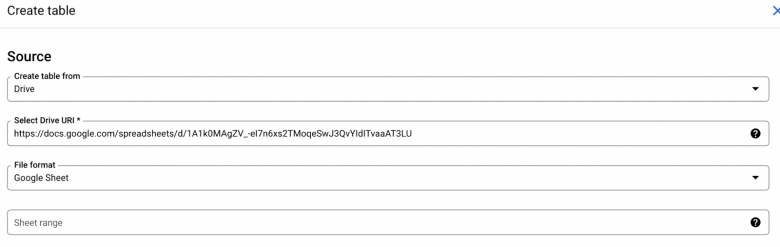
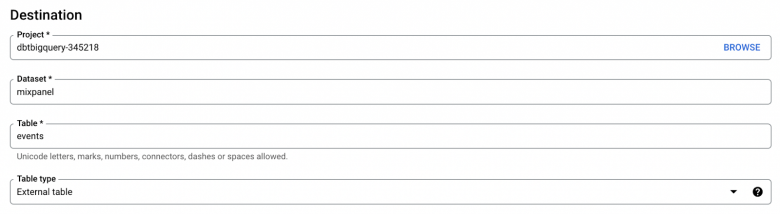
Затем в строке c проектом (Project) кликнем BROWSE и выберем проект, для которого хотим создать датасет:
Внесем следующие изменения в раздел с параметрами схемы (Schema):
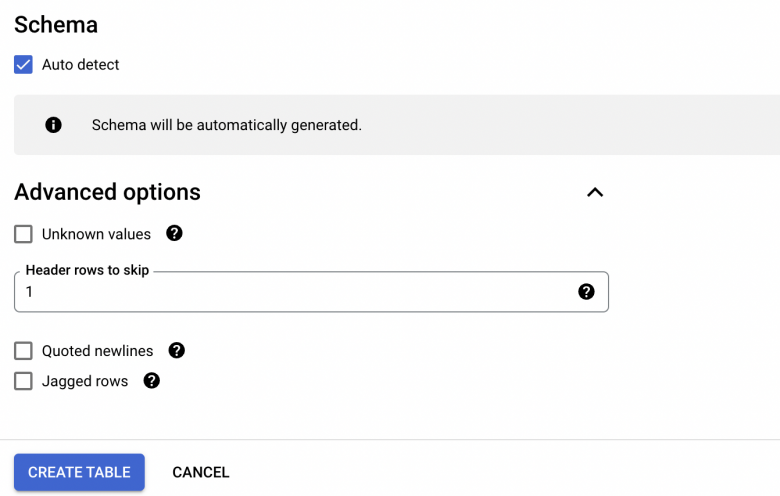
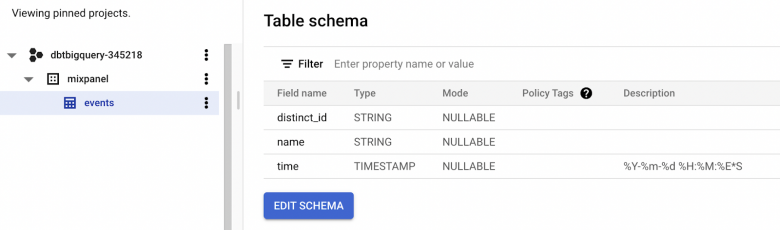
Чтобы схема была сгенерирована автоматически, следует поставить флажок в раздел Auto detect и кликнуть Create Table. Если вы кликнете по только что созданной таблице, то увидите что-то вроде этого:
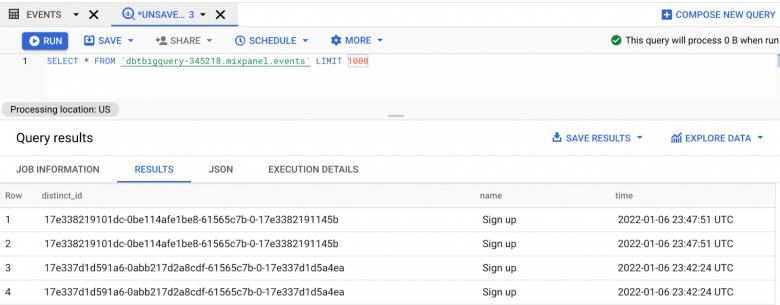
Теперь вы можете просмотреть некоторые данные, выполнив SELECT *:
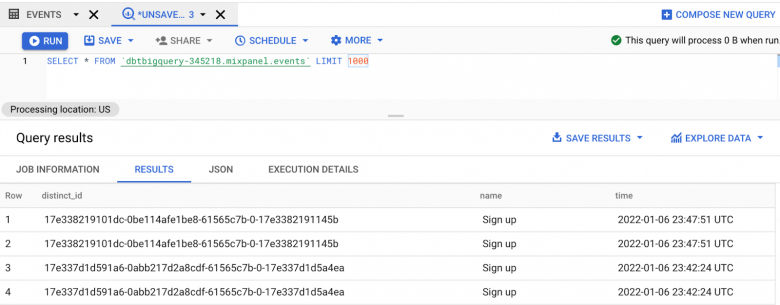
Теперь, когда наши данные загружены в BigQuery, мы должны преобразовать их в формат, пригодный для машинного обучения:
Теперь мы можем преобразовать наши данные к виду, когда каждый пользователь будет представлен одной строкой, а столбцы будут показывать, сколько раз каждый пользователь выполнил определенные действия:
select distinct_id,count(case when name ='Visited Homepage' then 1 end) as homepage,count(case when name ='Free Curriculum' then 1 end) as free_curriculum,count(case when starts_with(name, 'clicked') then 1 end) as curriculum_clicks,max(case when name = 'Clicked Apply' then 1 else 0 end) as appliedfrom mixpanel.eventsgroup by distinct_id
В результате получим следующую таблицу:
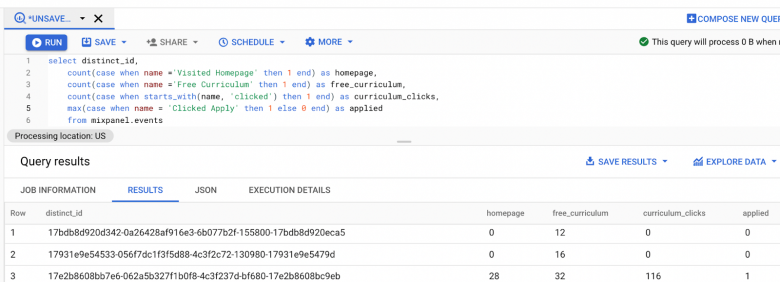
Проделав достаточную работу по конструированию признаков, мы наконец можем приступить к обучению модели.
Более подробную информацию о том, как использовать BigQuery ML, можно получить из руководства по линейной регрессии. Глядя на раздел Create Model, вы увидите следующее:
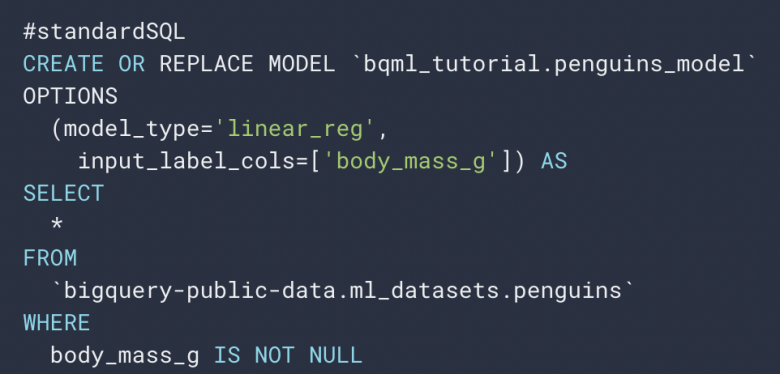
Оператор select определяет все входные данные, нужные нам для обучения модели. Мы выбираем все столбцы в таблице bigquery-public-data.ml_datasets.pengins и определяем в операторе CREATE MODEL модель, которую хотим создать. Создаем модель под названием penguins_model. Затем в разделе OPTIONS мы должны указать тип модели как модель линейной регрессии.
Итак, если вы все сделали правильно, то это будет выглядеть следующим образом:
CREATE OR REPLACE MODEL `mixpanel.events_model`
OPTIONS (model_type='logistic_reg', input_label_cols=['label'])
AS SELECT homepage, free_curriculum, curriculum_clicks, label
FROM `dbtbigquery-345218.mixpanel.event_features`
Теперь перейдем к настройке dbt.
DBT будет запускать SQL команды на нашей базе данных, поэтому первым шагом будет регистрация в DBT и подключение его к базе данных BigQuery.
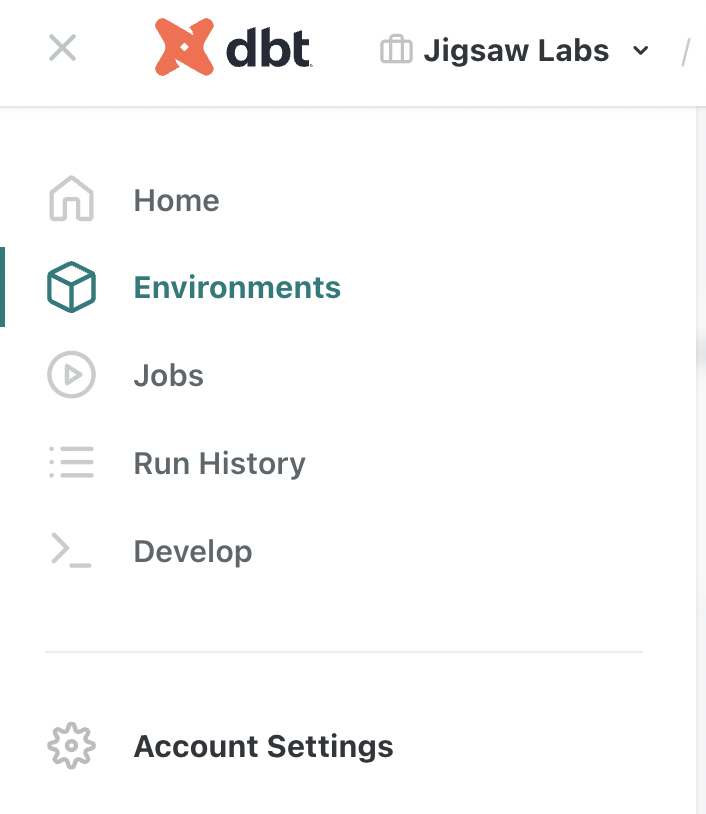
Здесь нужно кликнуть New Project:

Далее нужно ввести имя проекта mixpanel_dbt и выбрать хранилище данных BigQuery. Вам будет предложено ввести учетные данные, чтобы проект DBT мог подключиться к . базе данных BigQuery.
Самый оптимальный способ подключить базу данных — использовать специальный JSON-файл.
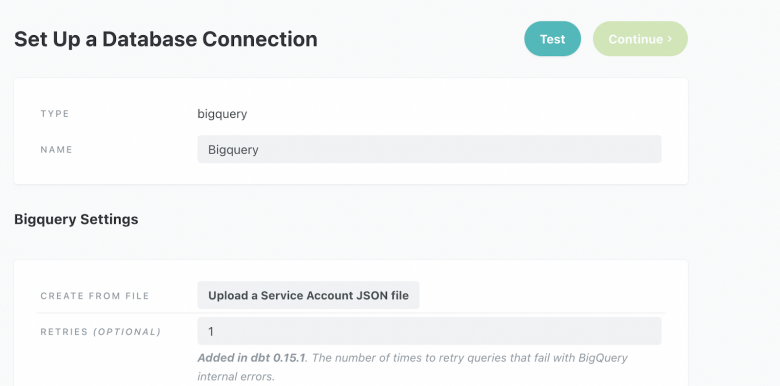
Чтобы создать этот файл, вернитесь в свою учетную запись BigQuery и выполните следующие действия:
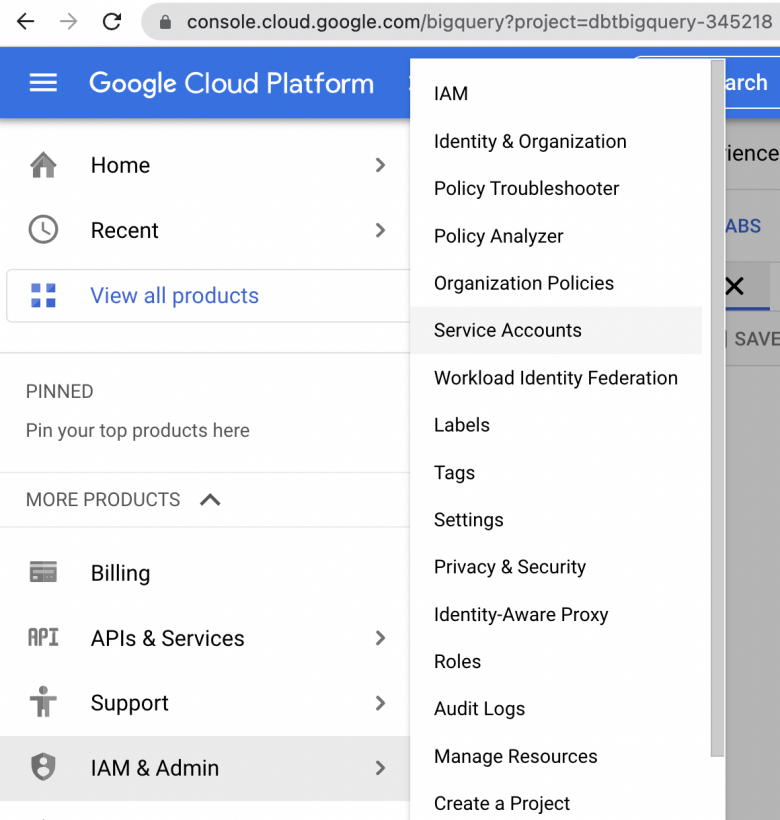
Перейдите в раздел IAM & Admin > Service Accounts.
> Учетная запись сервиса (service account) используется для авторизации систем в учетной записи BigQuery — в данном случае этой системой является DBT.
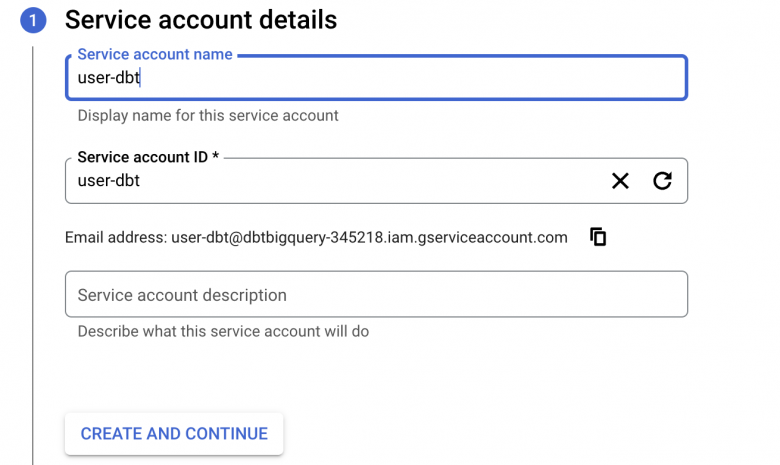
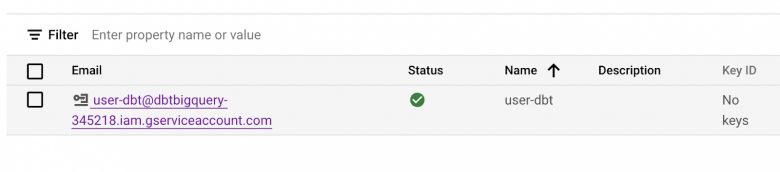
Здесь вам нужно установить имя учетной записи сервиса как user-dbt, а затем нажать Create and Continue.
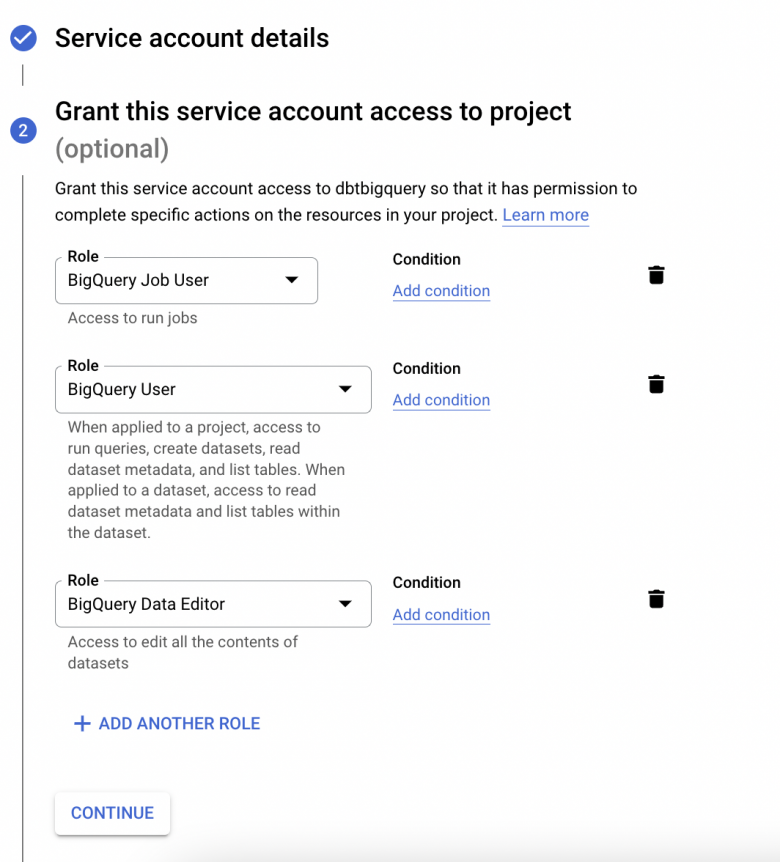
Далее Google предложит добавить роли. Введите BigQuery Job User, BigQuery User и BigQuery Data Editor.
Теперь следующим шагом будет создание учетных данных, чтобы мы могли авторизовать DBT для подключения к базе данных:
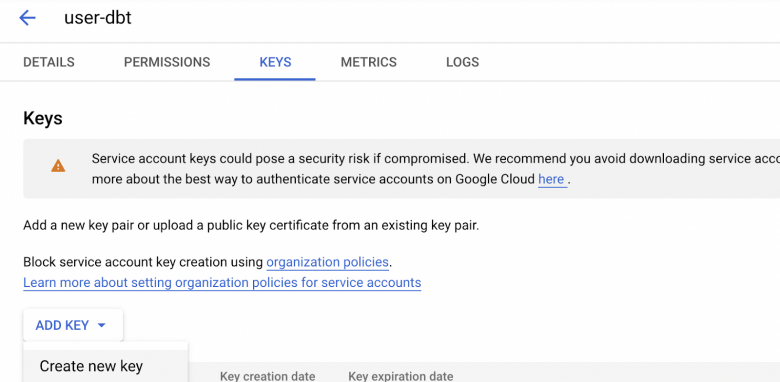
При нажатии Create New Key будет создан новый JSON-файл со всеми необходимыми учетными данными (его надо будет загрузить в DBT):
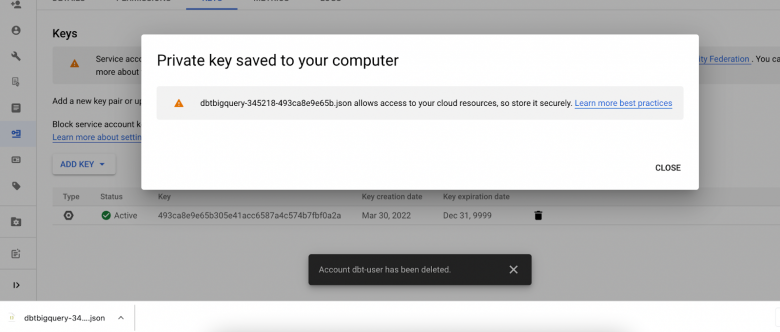
Вернитесь в DBT, нажмите Upload a Service Account JSON File и выберите только что созданный файл.
Когда он будет загружен, нажмите кнопку Test ( чтобы проверить, что теперь DBT может подключиться к базе данных).
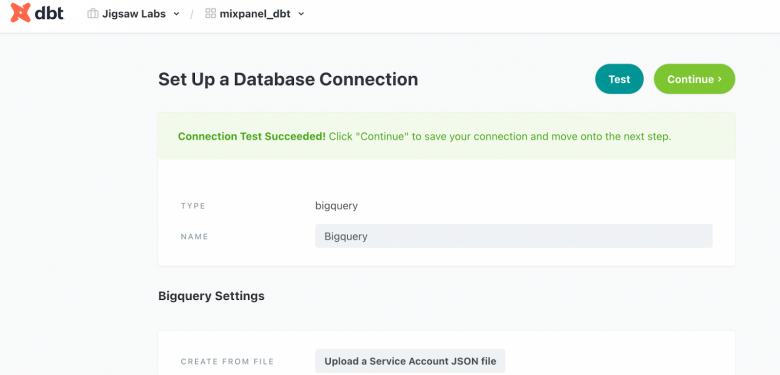
Когда вы убедитесь, что соединение состоялось, нажмите Continue.
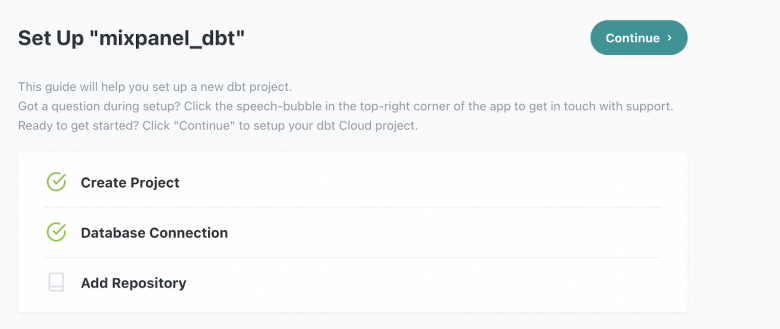
Последний шаг - добавление репозитория (повторно выберете проект в раскрывающемся списке вверху и нажмите Continue).
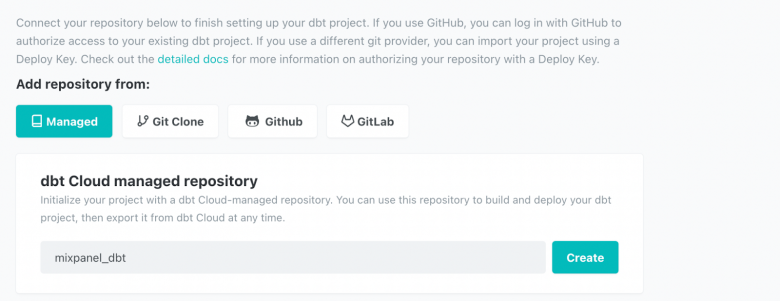
Можно подключить свой репозиторий к Github, но использовать репозиторий, управляемый DBT, чуть проще, поэтому мы будем использовать именно этот вариант и назовем его mixpanel_dbt (так же, как и наш проект).
Как только мы нажмем кнопку Create, все будет готово! Теперь реализуем SQL-команды в DBT.
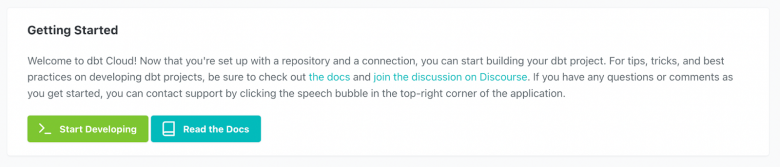
Нажмем зеленую кнопку Initialize project в левом верхнем углу и кликнем по кнопке Preview:
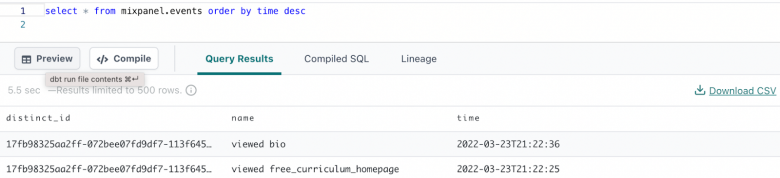
Теперь повторим шаги, которые мы уже выполняли с помощью BigQuery. Создадим новый файл под названием user_events и добавим следующий запрос:
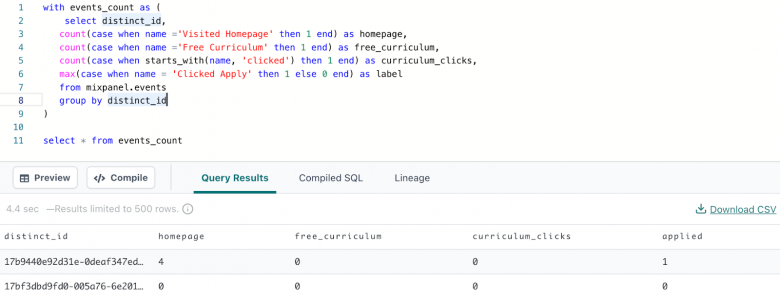
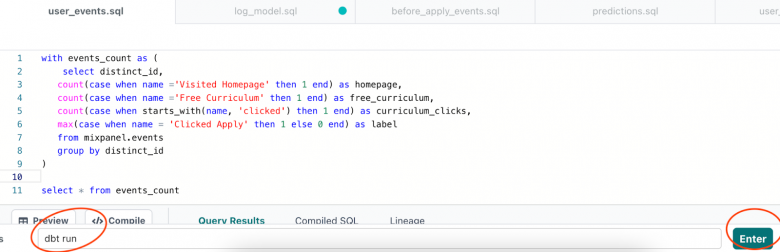
Теперь с DBT можно легко превратить запрос, подобный приведенному выше, в новую таблицу, вызвав в командной строке в самом низу run, и нажав зеленую кнопку Enter:
DBT откроет консоль и, если вы нажмете на details, то увидите, что DBT только что создал новую таблицу в BigQuery ML:
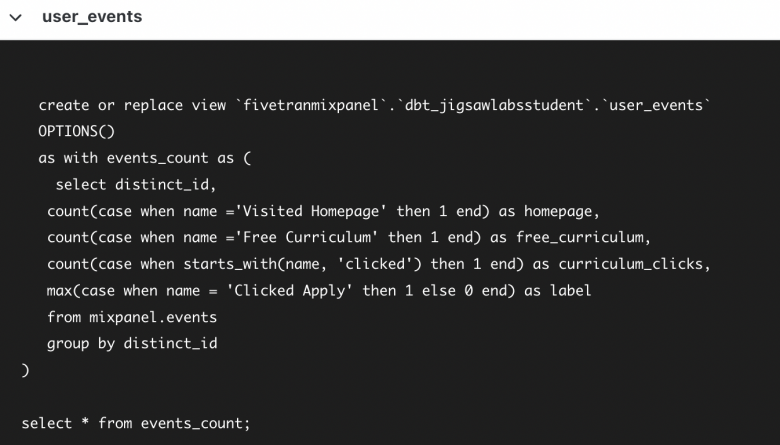
Если вы перейдете к консоли BigQuery, то обнаружите, что было создано новое представление:
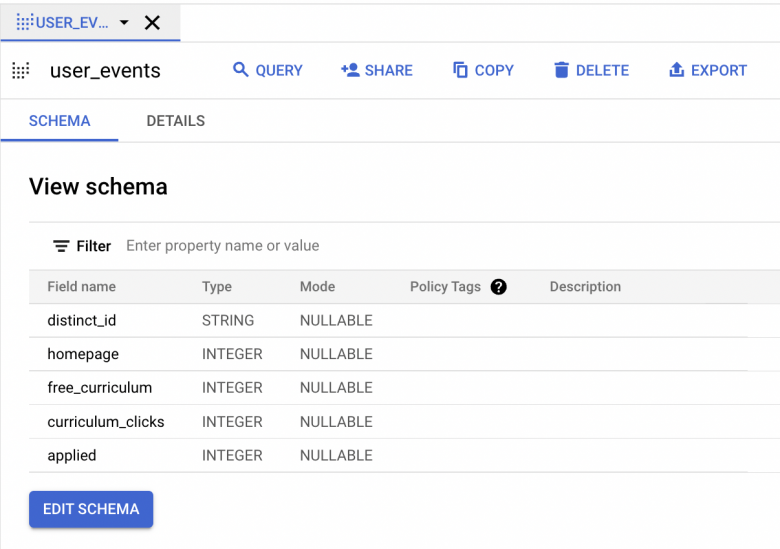
Теперь нужно, чтобы модель ML ссылалась на представление user_events. Лучший способ сослаться на другую таблицу DBT — использовать функцию ref. Вы найдете это в своем файле log_model.
На данный момент для файла log_model нужно просто выбрать * из таблицы user_events:
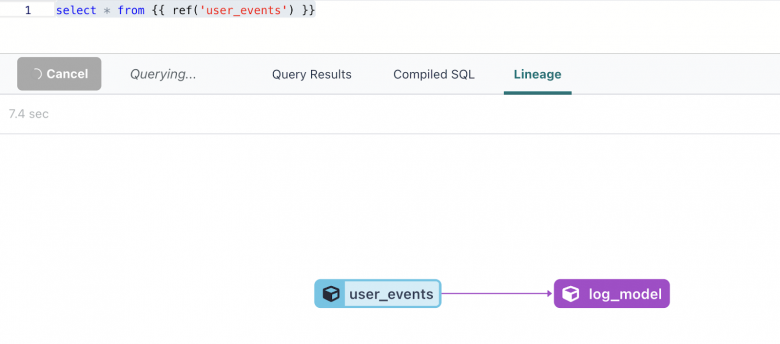
Теперь нам надо добавить user_events в нашу модель Google ML. Для этого мы будем использовать пакет DBT, который называется dbt_ml.
Вы можете установить этот пакет, добавив следующее в файл packages.yml:
packages:
   - package: kristeligt-dagblad/dbt_ml     version: 0.5.1
Затем в командной строке запустим dbt deps:
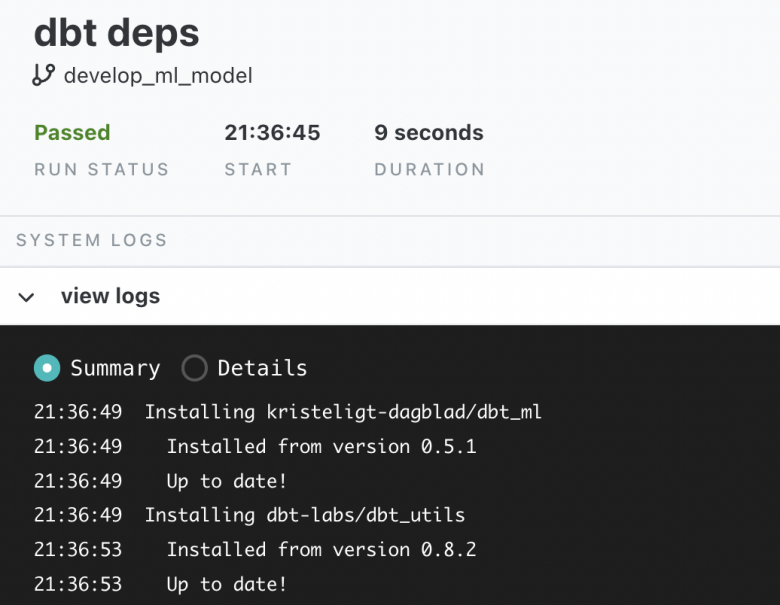
После установки пакета добавьте следующее в файл dbt_project.yml в вашем репозитории DBT:
on-run-start:
    - '{% do adapter.create_schema(api.Relation.create(target.project, "ml_model_audit")) %}'
- "{{ dbt_ml.create_model_audit_table() }}" models:
dbt_ml_example:
materialized: view vars:
"dbt_ml:audit_schema": "ml_model_audit"
"dbt_ml:audit_table": "ml_models"
Продолжая работу с документацией в dbt_ml github, обязательно измените файл log_model.sql на следующий:
{{
     config(
         materialized='model',
         ml_config={
             'model_type': 'logistic_reg',
             'early_stop': true,
             'ls_init_learn_rate': 2,
         }     ) }}
 select homepage,
 free_curriculum,
 curriculum_clicks,
 label from {{ ref('user_events') }}
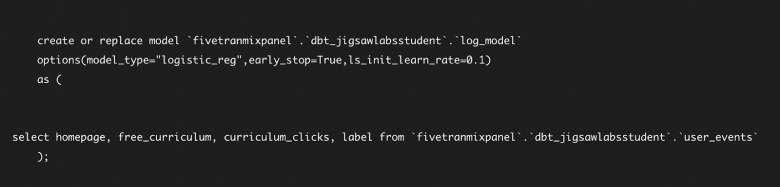
Запустите log_model с помощью dbt run –select log_model, который запустит зависимость log_model от user_events, за которой следует log_model.
Если вы посмотрите на детали DBT run, то увидите, что он сгенерировал и запустил SQL точно так же, как мы ранее делали это непосредственно в BigQuery ML:
Вы можете делать прогнозы на основе этой модели в файле predictions.sql, добавляя следующее:
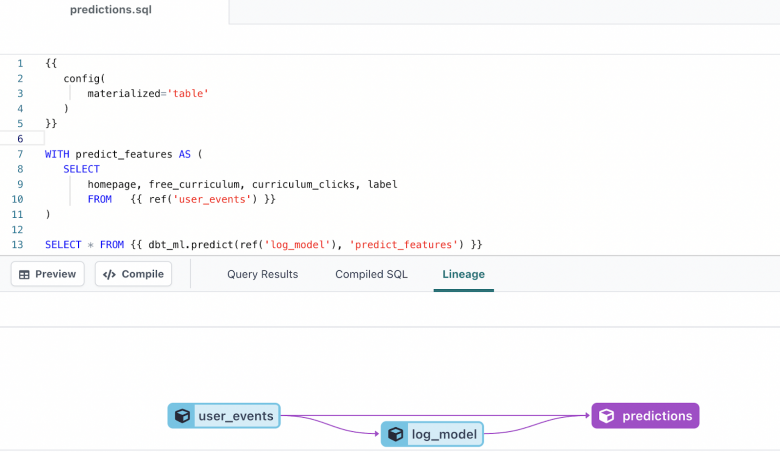
Далее вызовите dbt run –select predictions в командной строке и перейдите к BigQuery, чтобы просмотреть прогнозы.
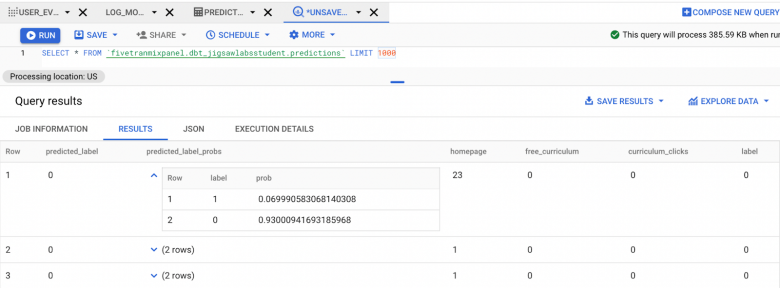
Теперь пришло время поговорить о преимуществах dbt.
Как мы уже знаем, dbt— это не просто инструмент, а целая философия построения современных, надежных и масштабируемых хранилищ данных. Вот ключевые преимущества dbt, которые делают его де-факто стандартом в индустрии данных.
Главное его преимущество заключается в том, что инжиниринг данных можно представить как программный код. Кроме того, dbt не ограничивает вас чистыми SQL-запросами. Интеграция с Jinja позволяет создавать динамический SQL. Кроме того, dbt сам строит граф зависимостей (Directed Acyclic Graph — DAG) на основе ссылок ref() и source() в ваших моделях. Еще одно неоспоримое преимущество заключется в том, что dbt обеспечивает согласованность и порядок в проекте данных. Что немало важно, dbt — это не просто инструмент, это большое и активное сообщество.
Таким образом, dbt — это каркас, который превращает ваше хранилище данных из хаотичного набора SQL-скриптов в надежный, документированный, тестируемый и легко развиваемый актив, который реально приносит бизнес-ценность.
В соответствующем репозитории DBT конвейер включает в себя обучение и тестирование данных. Преимущества использования такого инструмента, как DBT, еще более выражены.
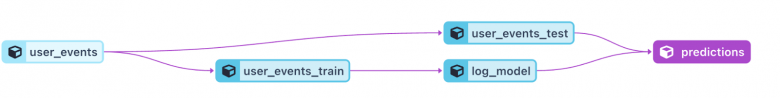
В рамках данной статьи мы также хотели бы рассмотреть анализ рисков и ошибок при внедрении ML-пайплайна.
Нужно сказать, что внедрение пайплайна машинного обучения — это сложный проект, в ходе которого крайне важно учесть следующие риски:
- Риск "Мусор на входе — мусор на выходе" (Garbage In, Garbage Out). Низкое качество исходных данных приводит к бесполезным прогнозам. Поэтому в dbt-пайплайн мы советуем внедрять кастомные тесты данных (например, проверку на пропуски в ключевых полях, аномалии в распределениях). Пайплайн не запустится, если тесты не пройдены, что предотвращает обучение моделей на некорректных данных.
- Риск Data Leakage (Утечки данных). При создании признаков в тренировочный набор данных непреднамеренно попадает информация из будущего (тестового периода), что завышает результаты модели. Поэтому мы строго следим за разделением данных во времени. Все Feature Engineering-модели в dbt используют только исторические данные на момент события. Для этого мы применяем продвинутые макросы в dbt для динамического разделения данных.
- Риск высокой стоимости BigQuery. Неоптимизированные запросы и частые переобучения больших моделей могут привести к значительным затратам. Именно поэтому мы проводим тщательный аудит и оптимизацию всех SQL-запросов. Настраиваем политику переобучения моделей (например, не каждый день, а только при значительной деградации точности) и используем инкрементальное обновление признаков, чтобы не пересчитывать всю историю каждый раз.
- Риск непонимания и отсутствия принятия результата бизнесом. Бизнес-пользователи не доверяют "черному ящику" модели и не используют прогнозы. Именно поэтому мы делаем пайплайн максимально прозрачным. Вместе с прогнозами мы предоставляем объяснения (feature importance) — какие факторы больше всего повлияли на конкретное предсказание. Это помогает бизнесу понять логику модели и принимать обоснованные решения.
В заключение хотелось бы отметить, что интеграция dbt и BigQuery ML — это не просто технологический стек, это новая парадигма в разработке машинного обучения. Она позволяет сократить Time-to-Market с месяцев до недель, значительно снизить TCO (Total Cost of Ownership) за счет отказа от отдельной ML-инфраструктуры, повысить надежность и воспроизводимость ML-процессов, а также демократизировать машинное обучение, позволив аналитикам и инженерам данных участвовать в создании ML-моделей.


