

Эволюция прогнозирования в ритейле: от скользящих средних до ансамблей нейросетей. Практический опыт внедрения и извлеченные уроки
В современном ритейле точность прогнозирования продаж — это не просто метрика, это прямой инструмент влияния на ключевые бизнес-показатели: оборачиваемость товарных запасов, уровень сервиса, рентабельность логистики и маркетинговых активностей. Ошибка в прогнозе на 20% может привести к миллионным убыткам из-за затоваривания или, наоборот, к упущенной выгоде из-за отсутствия товара на полке.
В этой статье мы детально разберем эволюцию моделей — от простых статистических методов до сложных ансамблей, — с которыми столкнулись в рамках проекта для одной из крупнейших розничных сетей. Мы расскажем не только о успехах, но и о ключевых ошибках, рисках и практических кейсах, которые помогут вам избежать наиболее распространенных ошибок при построении собственных систем.
В процессе нашей профессиональной деятельности мы успели поработать с различными моделями, которые можно условно разделить на cтатистические, линейную регрессию, деревья решений и нейронные сети.
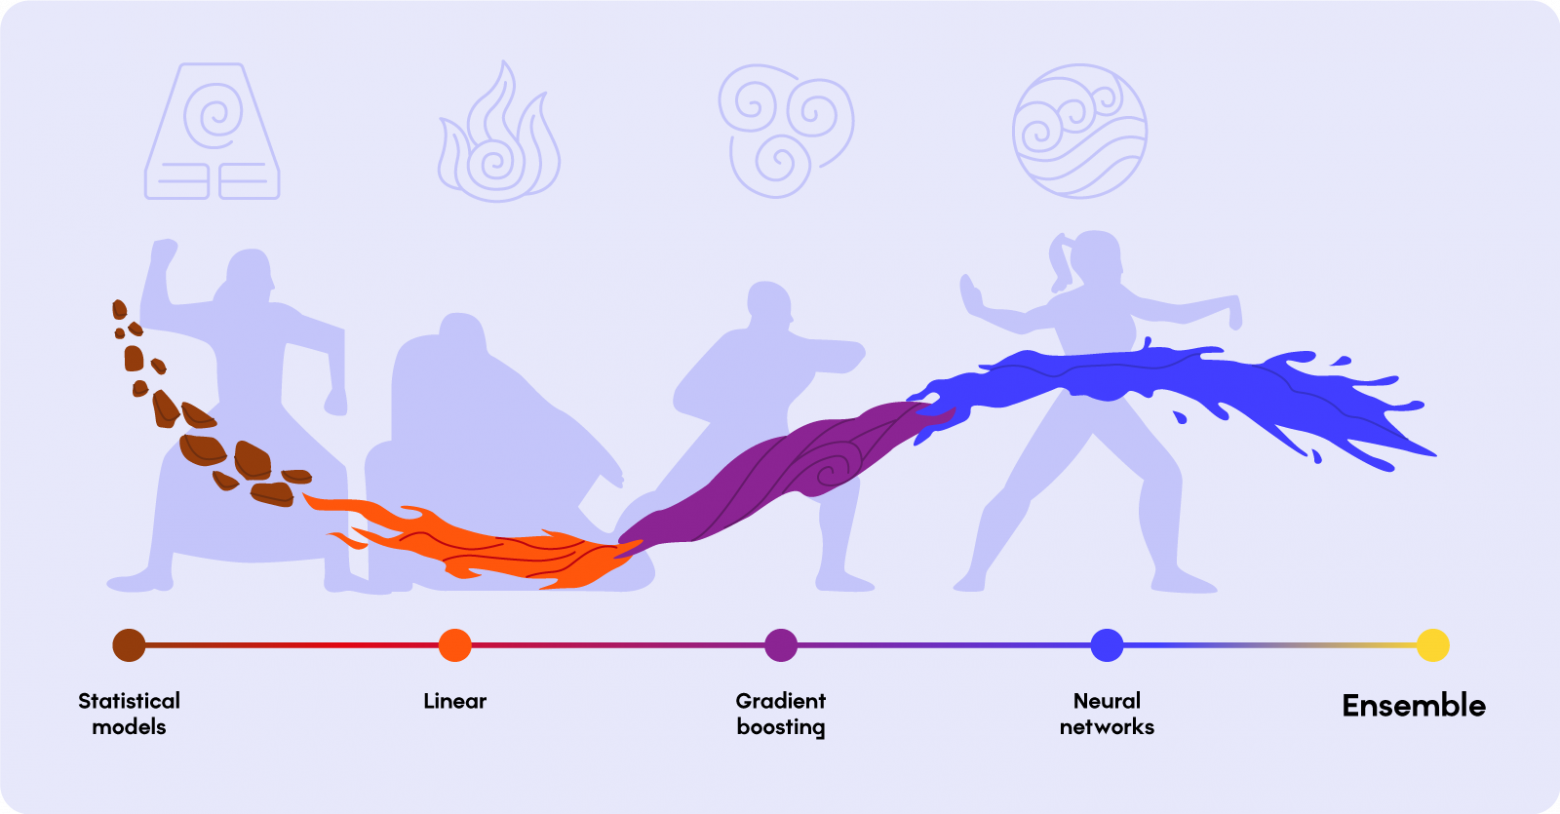
Познакомимся поближе с каждым из типов и пройдём путь становления ансамбля алгоритмов, применяемых нами и нашими заказчиками.
Фундамент: почему без статистических моделей никуда
Любой путь в прогнозировании начинается с простых и интерпретируемых методов.
В нашем случае отправной точкой стала Мультипликативная Модель Прогнозирования (ММП), унаследованная от legacy-системы «Автозаказ».
Суть подхода:
Прогноз формируется как произведение «очищенной» базовой продажи (тренд) на ряд коэффициентов-мультипликаторов:
y = x * k₁ * k₂ * ... * kn, где
- x — базовая продажа, прогнозируемая с помощью скользящих средних или экспоненциального сглаживания.
- k₁...kn — мультипликаторы, учитывающие влияние различных факторов: цена, акция, сезонность, эластичность спроса.
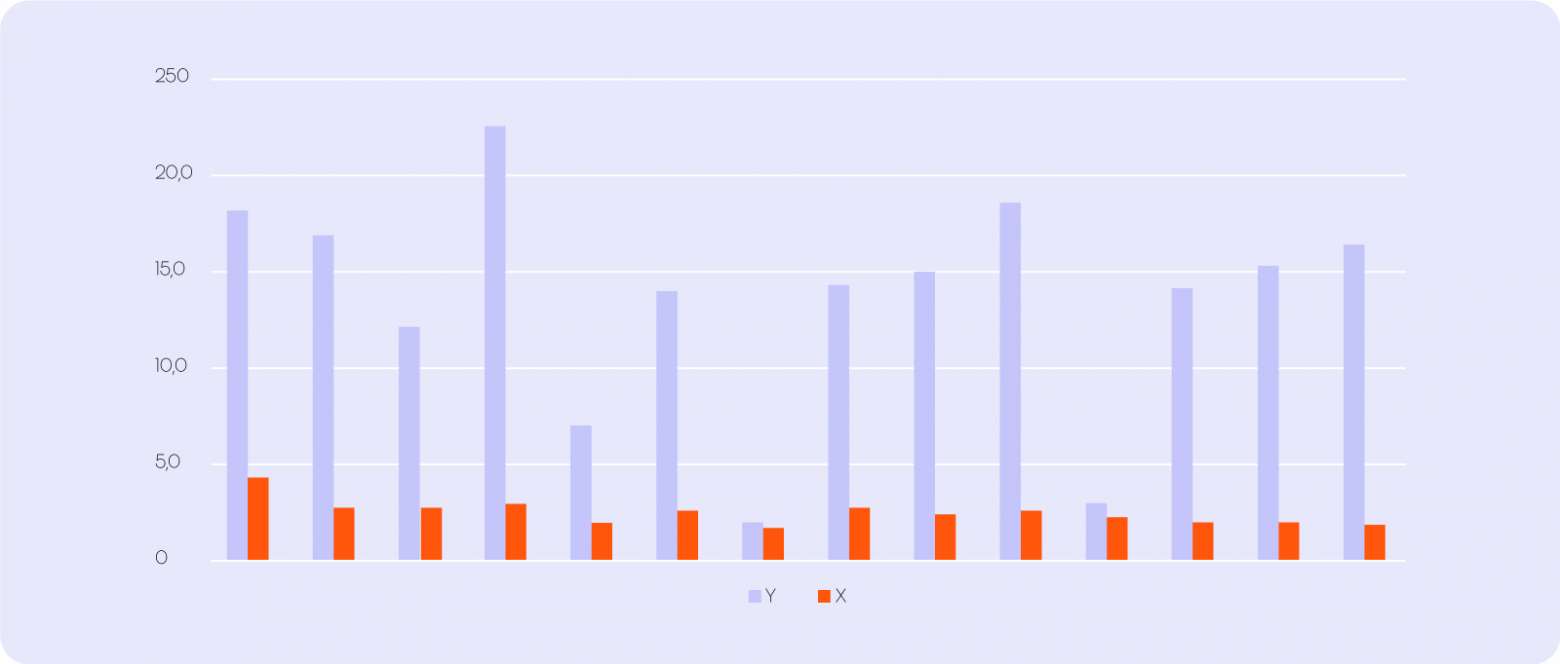
Одним из ключевых мультипликаторов был коэффициент эластичности спроса по цене. Изначально он рассчитывался глобально для всей товарной категории. Это привело к грубой ошибке: для премиального йогурта снижение цены на 10% могло дать рост продаж на 30% (высокая эластичность), а для базового хлеба — всего на 2% (низкая эластичность). Использование усредненного коэффициента по категории «молочные продукты» искажало прогноз для обоих товаров.
В итоге мы разработали алгоритм расчета эластичности на уровне товарной позиции (SKU) для магазинов с достаточной историей, а для новинок или магазинов без истории — использовали иерархический подход: поднимались на уровень выше (бренд → подкатегория → категория), пока не находили достаточное количество данных для надежного расчета.
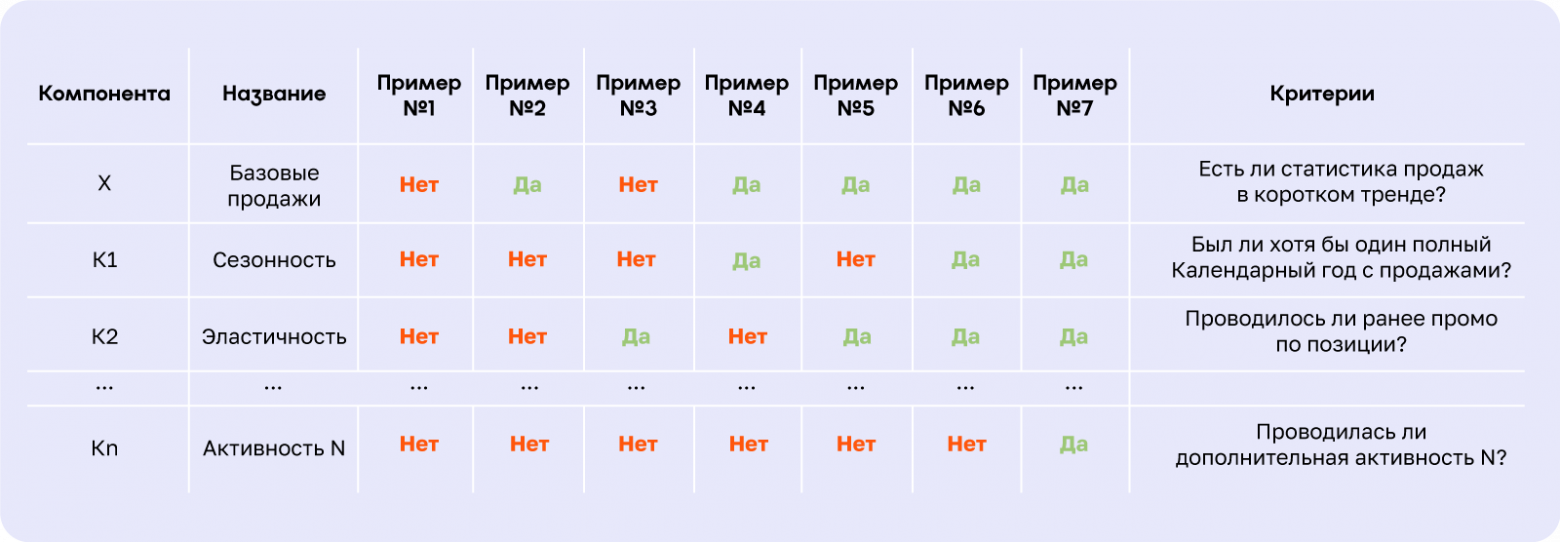
Главная особенность данного алгоритма состоит в независимой иерархической структуре расчёта каждого из компонентов, позволяющей использовать модель для прогнозирования товаров, не имеющих собственных наблюдений.
Это действительно важно - изучите таблицу, в которой приведён пример наиболее часто встречающихся комбинаций статистики по компонентам для одного магазина.
Сильные стороны ММП
Во-перых, это высокая интерпретируемость. Бизнес-пользователь точно видит, что прогноз изменился потому, что, например, коэффициент сезонности для мороженого в июле составил 2.5, а коэффициент акции «2 по цене 1» — 1.8.
Во-вторых, это работа с «холодными» стартами. Модель может давать прогноз для абсолютно новых товаров и магазинов, используя коэффициенты с более высоких уровней агрегации.
И, наконец, в – третьих, это скорость и простота. Расчет требует минимальных вычислительных ресурсов.
Слабые стороны и потенциальные риски
Здесь в первую очередь стоит отметить бесконечное усложнение логики. Каждое новое бизнес-правило или нестандартная акция (например, «скидка на второй товар в чеке») требует создания новой «ветки расчета» — ручной прошивки сложного правила вида if-else. Это приводит к монструозному, плохо поддерживаемому коду.
Кроме того, это слепота к комплексным зависимостям. Модель не может уловить сложные нелинейные взаимодействия. Например, эффект того, что акция на кофе может увеличить продажи молока, но только в определенных форматах магазинов и в определенные дни недели.
И, наконец, никто не отменял проблемы с короткими сезонными товарами. Для новогодних елок или куличей не хватает короткой истории (3 месяца), чтобы надежно оценить тренд, а годовая сезонность в базовой модели не учитывается.
Исходя из всего выше сказанного мы советуем пользоваться статистическими моделями как надежным бэклайном и стартовой точкой. Они идеальны для автоматизации рутинного заказа стабильных товаров с предсказуемым спросом. Но для прогнозирования акционных продаж и учета сложных зависимостей их недостаточно.
Линейные модели: мощность и ограничения экстраполяции
Следующим шагом эволюции стало внедрение линейной регрессии. Первоначальная реализация была отдана на аутсорс и представляла собой «черный ящик» с закрытым кодом на R, что стало нашей ключевой ошибкой на старте.
Не передавайте на аутсорс разработку ключевых компетенций. Отсутствие контроля над кодом и архитектурой привело к катастрофическому падению производительности (время обучения выросло со 24 до 140 часов) и невозможности оперативно вносить изменения.
В нашем случае мы полностью переписали решение на Python (PySpark), перенесли данные в HDFS и пайплайны с помощью Airflow. Это сократило время обучения до 8 часов и дало полный контроль над процессом.
Ключевые вызовы и решения при работе с линейными моделями
Во-первых, это нелинейность мира. Спрос в ритейле редко линеен. Скидка 50% не дает в 5 раз больше роста продаж, чем скидка 10%. Мы боролись с этим через преобразование целевой переменной (логарифмирование) и добавление полиномиальных признаков.
Во-вторых, это проблема нулевых продаж. До 80% строк в дневных данных могут иметь нулевые продажи для конкретного SKU-магазин. Если не обработать это, модель получит сильное смещение (bias).
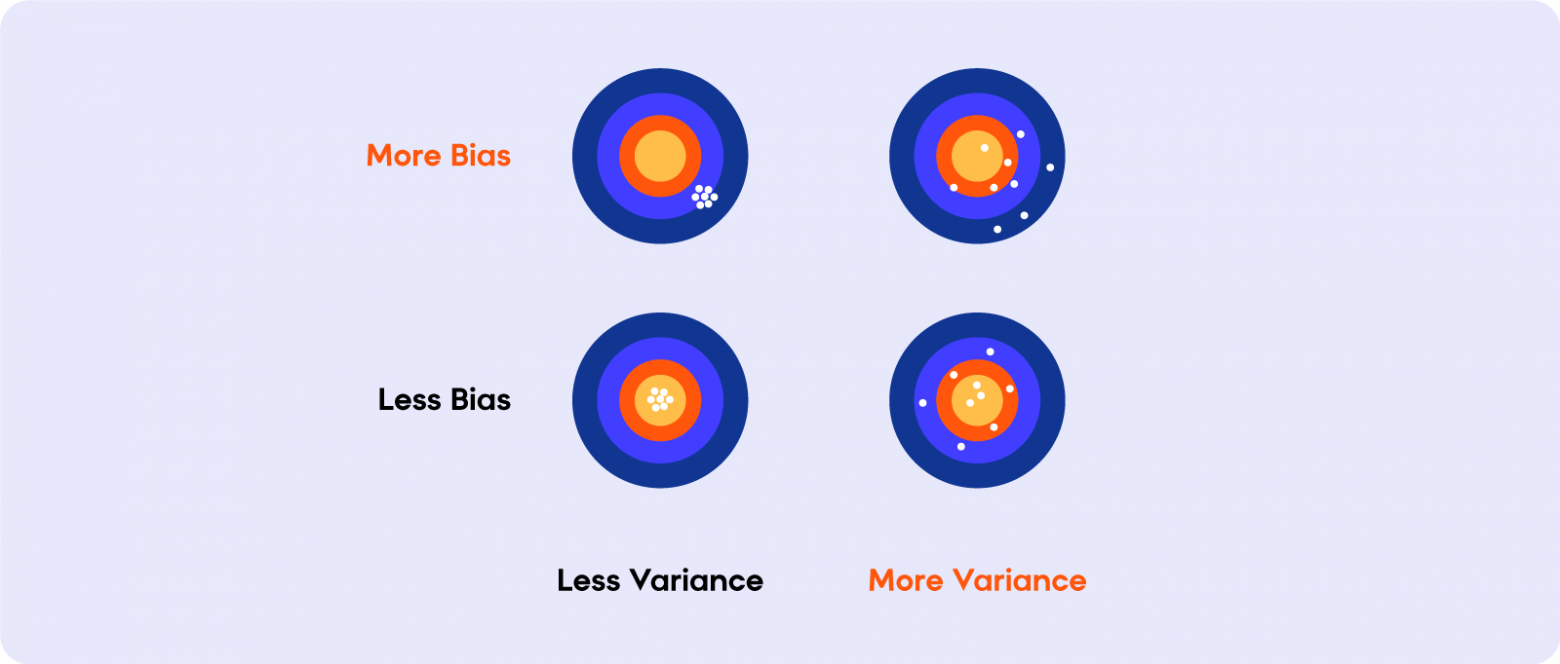
Поскольку простое удаление нулей искажало картину, заставляя модель завышать прогнозы для товаров с низкой оборачиваемостью, мы ввели взвешивание наблюдений. Нулевым продажам присваивался меньший вес, причем вес рассчитывался адаптивно в зависимости от частоты потребления в товарной категории.
Во-вторых, это сезонность, находящаяся на низком уровне. Линейная модель плохо улавливает сезонность на уровне конкретного товара в конкретном магазине из-за шума и короткой истории.
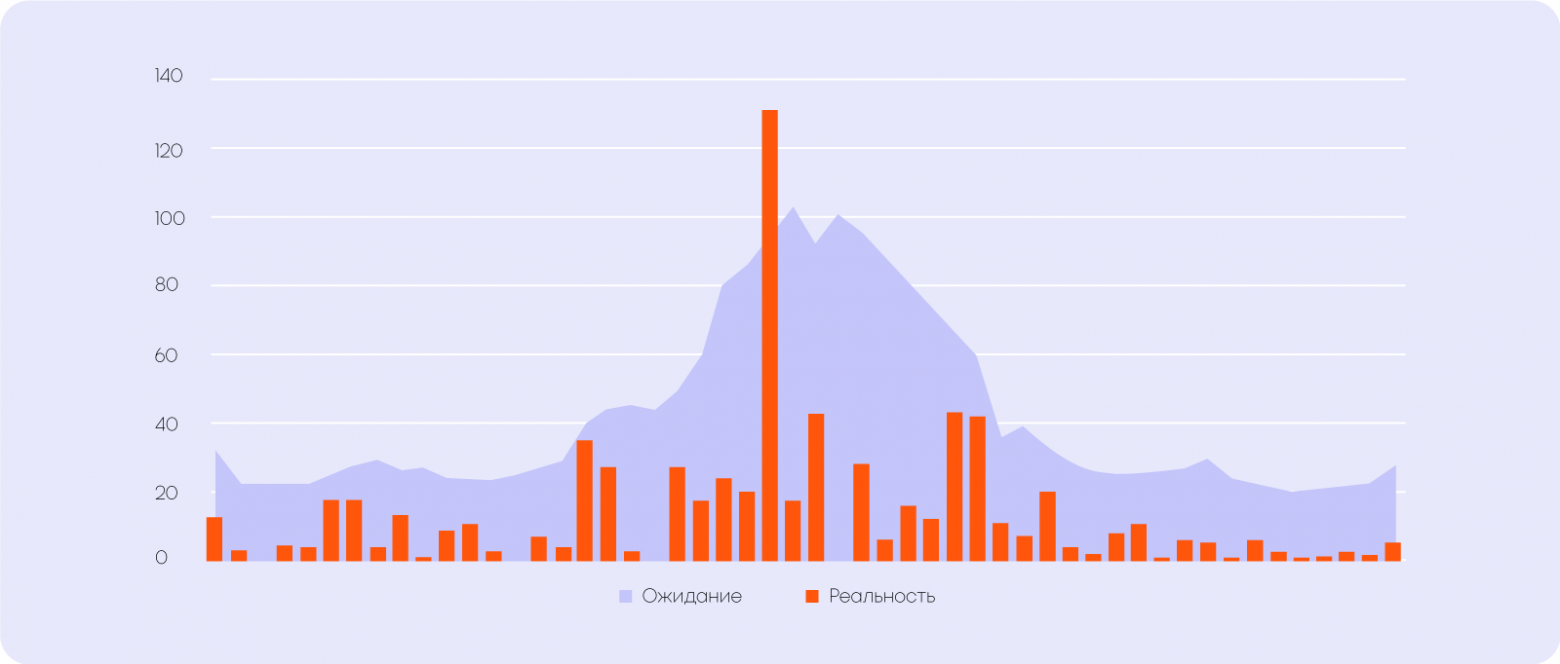
Мы пробовали подавать в модель временные фичи (день года, закодированный через sin/cos), коэффициенты сезонности с категорийного уровня. Улучшения были, но проблема кардинально не решалась. Линейная модель по своей природе слаба для таких сложных временных паттернов.
В-третьих, стоит учитывать тот факт, что слепая экстраполяция — это один из главных рисков. Модель может давать абсурдные прогнозы для значений признаков, выходящих за рамки обучения. Например, если максимальная скидка в истории была 30%, а мы выставляем 70%, модель может спрогнозировать тысячекратный рост спроса. В связи я этим обязательным мероприятием является постобработка прогнозов с обрезкой аномально высоких и отрицательных значений на основе бизнес-логики.
Сильные стороны линейных моделей:
Во-первых, это интерпретируемость. Веса признаков показывают, что именно и насколько сильно влияет на спрос.
Во-вторых, это экстраполяция. Может предсказывать спрос для новых цен и акций, которых не было в истории (но с осторожностью!).
В – третьих, это скорость. А именно быстрое обучение и прогнозирование.
В целом, линейные модели — отличный инструмент для задач, где важны интерпретируемость и скорость, а зависимости близки к линейным. Идеально для прогнозирования спроса на товары с постоянным ценовым паттерном.
Слабые стороны линейной модели
Во-первых, это падение качества прогноза, в том случае, если есть сложные нелинейные зависимости между признаками и целевой переменной.
Во-вторых, очень часто возникают проблемы при необходимости обработки большого количества категориальных признаков.
В-третьих, это высокая чувствительность к аномалиям и выбросам.
В –четвертых, для интерпретации необходимо агрегировать влияния веса признаков большого количества моделей в единую сущность. Так, для прогноза одного товара на нескольких различных магазинах может использоваться 300-700 моделей. Заказчику же интересно знать, какие именно 5 факторов больше всего влияют на прогноз. Здесь-то как раз и возникает сложность, как правильно «схлопнуть» коэффициенты такого количества моделей, чтобы оценить их общий вклад в прогноз.
И, наконец, в-пятых, это риски при экстраполяции: важно уметь контролировать результаты, полученные на данных, которые модель никогда не видела, так как они могут быть неадекватными.
Градиентный бустинг (GBDT): работа с реалиями ритейла
Переход к градиентному бустингу над деревьями (XGBoost, LightGBM) стал качественным скачком. Это самый популярный алгоритм для табличных данных, и не без причин.
Метод основан на идее комбинации сразу нескольких слабых алгоритмов, последовательно уточняющих прогноз друг друга с целью минимизации ошибок.
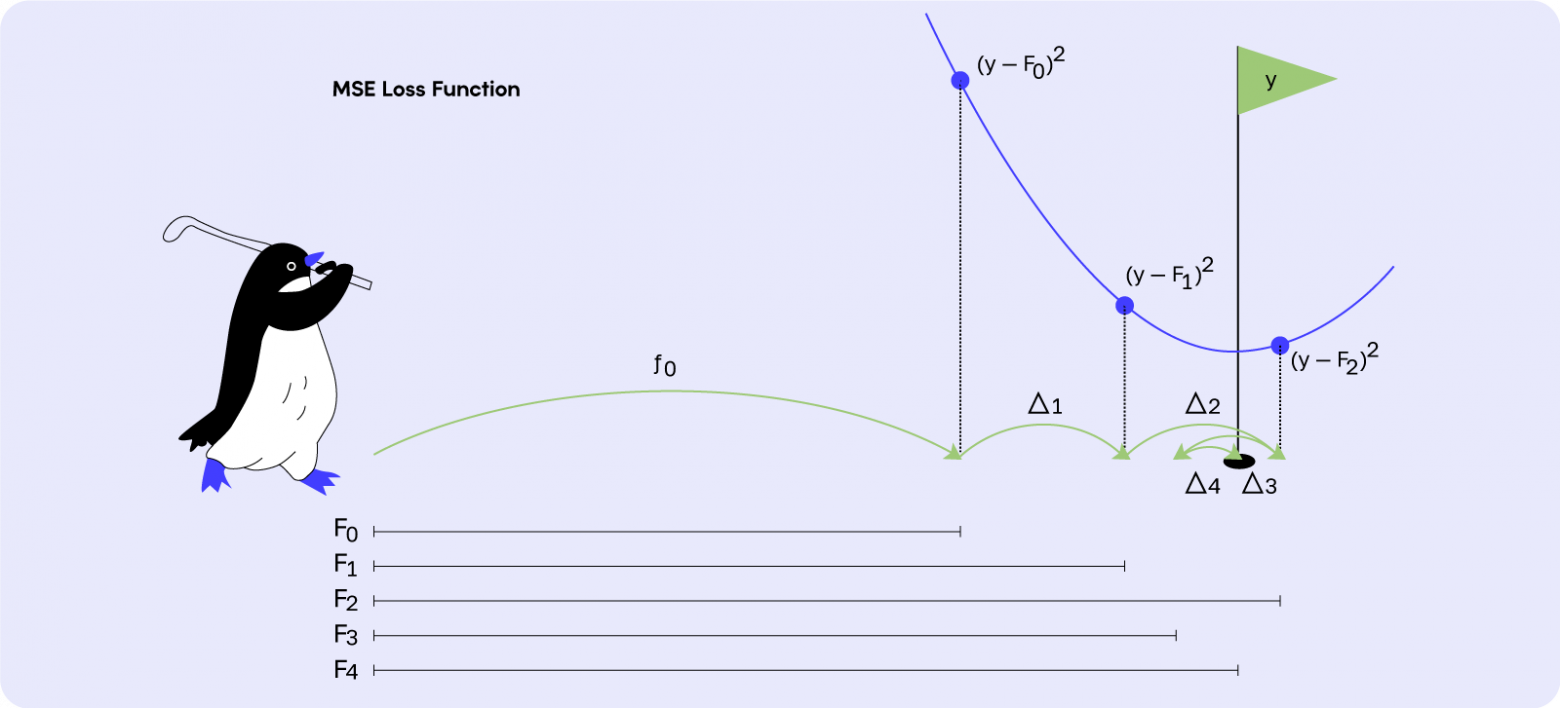
Настройка процесса выглядят следующим образом: мы обучаем не одну гигантскую модель, а множество (сотни тысяч) мелких моделей на уровне «Товарная группа × Тип магазина × Географический кластер». Это позволяет учитывать специфику спроса в разных регионах и форматах торговых точек.
Ключевые доработки и находки
Во-первых, это борьба с переобучением. Мы активно используем монотонные ограничения (monotonic constraints). Например, можно задать правило, что рост скидки не должен приводить к снижению спроса. Это предотвращает абсурдные предсказания и делает модель более устойчивой.
Во-вторых, это квантование признаков. Округление таких признаков, как цена, до целых рублей (например, 99.99 -> 100) помогло бороться с переобучением на шум в данных.
В – третьих, это разные функции потерь. Для разных товарных категорий мы используем разные функции ошибок:
- Poisson — для товаров с низкой оборачиваемостью и целочисленными продажами.
- Tweedie — для данных с обилием нулей (например, продажи непопулярных товаров).
- Huber — для устойчивости к выбросам.
Сильные стороны бустинга:
Это, в первую очередь, автоматическая работа с фичами. Алгоритм сам умеет обрабатывать пропуски, категориальные признаки (после encoding) и нелинейные зависимости.
Кроме того, это консервативность. Бустинг не экстраполирует за пределы обучающей выборки. Это страхует от неадекватных прогнозов для экстремальных значений скидок.
И, наконец, это высокая точность. Обеспечивает высочайшее качество прогноза на табличных данных.
Слабые стороны и риски:
- Во-первых, это колоссальная ресурсоемкость. Модель требует хранения и загрузки сотен тысяч файлов (.pkl, .pmml), что создает операционные сложности.
- Во-вторых, это слабая интерпретируемость. Понять, почему для конкретного магазина был выдан такой прогноз, сложно. Приходится использовать методы вроде SHAP, что требует дополнительных вычислительных затрат.
- В – третьих, это голод на данные. Для редких товаров или новых магазинов качества может быть недостаточно.
На наш взгляд, градиентный бустинг — это workhorse для прогнозирования акционного спроса. Внедряйте его, когда исчерпали лимиты простых моделей и накопили достаточный объем качественных данных.
Ансамбль моделей: синергия и управляемая надежность
Ни одна модель не идеальна. Сила одной является слабостью другой. Поэтому финальным шагом стало построение ансамбля.
Наш ансамбль включает в себя следующие элементы:
- ММП: для надежного прогноза новых товаров и магазинов.
- Линейная модель: для случаев, где важна экстраполяция и интерпретируемость.
- Градиентный бустинг: как основной источник точности для стандартных ситуаций.
- Нейросеть (в разработке): для учета сложных временных паттернов и кросс-категорийных взаимодействий.
Мы отказались от сложной «модели-блендера» для предсказания весов из-за рисков переобучения и операционной сложности. Вместо этого используем гибкую систему правил, состоящую из следующих элементов:
- Правило отсева аномалий. Если прогноз одной из моделей сильно выбивается из прогнозов остальных (например, бустинг дал 100 единиц, а линейная модель — 10 000), это значение отбрасывается или проходит ручную проверку.
- Эвристические веса. Для новых товаров вес ММП повышается. Для сезонных товаров в пик сезона повышается вес бустинга, который лучше уловил сезонность на длинной истории.
- Бизнес-логика. Для товаров с высокими рисками затоваривания (например, скоропорт) мы искусственно занижаем прогноз, выбирая минимальный из предложенных моделями.
Сильные стороны ансамбля:
- В-первых, это заметное повышение точности. Ансамбль в среднем всегда точнее любой отдельной модели.
- Во-вторых, это надежность и отказоустойчивость. Если одна модель не справилась или упала, другие подстрахуют.
- В – третьих, это гибкость. Позволяет управлять прогнозом на высшем уровне, не переучивая сами модели.
Слабые стороны:
Прежде всего, это высокая операционная сложность. Необходимо поддерживать целый зоопарк моделей и инфраструктуру для их работы.
Кроме того, это сложность аналитики. Чтобы понять причину ошибки, нужно «раскручивать» каждую модель в ансамбле.
На основе нашего опыта мы сформировали ключевые рекомендации для внедрения систем прогнозирования в ритейле:
- Во-первых, начинайте с простого. Не бросайтесь сразу строить нейросеть. Начните с регрессии или даже скользящих средних. Это даст вам быстрый результат и понимание данных.
- Во-вторых, обязательно инвестируйте в качество данных. 80% успеха — это качественные и правильно подготовленные данные. 20% — выбор алгоритма.
- В- третьих, по возожности избегайте vendor lock-in. Не становитесь заложником закрытых решений и сторонних подрядчиков. Развивайте внутреннюю экспертизу.
- В- четвертых, внедряйте поэтапно. Сначала автоматизируйте прогноз для стабильных товаров простыми методами. Затем беритесь за акционный спрос с помощью бустинга.
- И, наконец, ансамблируйте. Не ищите одну идеальную модель. Используйте синергию нескольких подходов для повышения точности и надежности.
Прогнозирование продаж — это не научный проект, а инженерная дисциплина, цель которой — создание надежного, управляемого и понятного бизнесу инструмента. Двигайтесь от простого к сложному, непрерывно тестируйте и помните, что идеального алгоритма не существует, но существует надежная система, построенная на комбинации проверенных подходов.


