

ClickHouse в промышленной эксплуатации: полное руководство по внедрению от экспертов BI
В эпоху, когда объемы данных растут экспоненциально, а требования к скорости их анализа измеряются секундами, традиционные системы хранения данных достигают своих пределов. Запросы, которые выполнялись минуту, начинают занимать час, а ночные ETL-процессы не успевают завершиться к утру. Бизнес теряет возможность оперативно реагировать на изменения, а аналитики — проводить глубокие исследования.
В этой статье мы подробно расскажем, что такое ClickHouse, в каких случаях его внедрение становится стратегическим преимуществом, а в каких может быть избыточным. Мы поделимся реальными кейсами из нашей практики, детально разберем архитектурные решения, а также предостережем от распространенных ошибок, которые могут свести на нет все преимущества этой мощной системы.
Итак, ClickHouse — это не просто еще одна база данных. Это высокооптимизированный вычислительный движок, спроектированный для работы с огромными массивами данных. Его архитектура изначально заточена под выполнение агрегирующих запросов (SUM, COUNT, AVG) с феноменальной скоростью, что делает его идеальным решением для аналитических дашбордов и отчетности в реальном времени; систем мониторинга и анализа логов (Application Logs, Metrics, Telemetry); платформ поведенческой аналитики (User Analytics, Clickstream Analysis); финансовых сервисов для анализа транзакций и выявления мошенничества, а также для рекламных и маркетинговых технологий для анализа эффективности кампаний.
Секрет скорости ClickHouse кроется в совокупности архитектурных решений.
Во-первых, это колоночное хранение данных. В отличие от строчных СУБД (как MySQL или PostgreSQL), которые хранят данные по строкам, ClickHouse хранит их по столбцам. Это фундаментальное различие.
Если вам нужно посчитать средний чек по всем заказам за последний месяц, строчной системе придется прочитать всю строку для каждого заказа (ID, дата, клиент, товары, сумма...), а затем извлечь только значения суммы. ClickHouse же читает с диска только один столбец order_amount. Это радикально снижает объем IO-операций и ускоряет выполнение запроса в десятки и сотни раз.
Во-вторых, это эффективное сжатие. Данные в столбцах, как правило, однородны (например, только даты или только числа), что позволяет применять к ним высокоэффективные алгоритмы сжатия. На практике это означает, что объем данных на диске может уменьшиться в 5-10 раз по сравнению с сырыми данными, что еще больше ускоряет чтение.
В – третьих, это векторизация запросов. ClickHouse обрабатывает данные не по одной строке, а большими блоками (векторами), максимально эффективно используя вычислительные мощности современного CPU (кеш, инструкции SIMD).
В – четвертых, это движок таблиц MergeTree. Это сердце ClickHouse. Он позволяет партиционировать данные (например, по дате), что позволяет системе читать только нужные части данных, а не всю таблицу целиком. Кроме того, с его помощью можно сортировать данные при вставке по первичному ключу, что обеспечивает быстрое нахождение нужных строк, а также производить фоновое слияние (Merge) небольших кусочков данных в более крупные, оптимизируя хранение и последующее чтение.
И, наконец, отдельно стоит отметить распределенную обработку (MPP — Massively Parallel Processing). ClickHouse легко масштабируется на кластер из нескольких серверов (нод). Данные автоматически шардируются (распределяются) между нодами, и запрос выполняется параллельно на всех из них, после чего результаты агрегируются. Это позволяет линейно наращивать производительность, просто добавляя новые серверы.
ClickHouse блестяще проявляет себя сразу в нескольких сценариях.
Во-первых, это очень высокая скорость записи. ClickHouse может поглощать миллионы строк в секунду, что делает его идеальным для потоков данных из Kafka, логов приложений или событий с веб-сайтов.
Во-вторых, это молниеносная агрегация по большим объемам данных. Запросы с GROUP BY, которые в других СУБД выполняются минутами и часами, в ClickHouse часто завершаются за секунды.
В- третьих, это сценарии "один раз записал, много раз прочитал". Данные вставляются пачками (batch) и в дальнейшем преимущественно читаются для анализа.
При всем при этом у ClickHouse есть осознанные ограничения, которые важно понимать до начала внедрения!
В частности, это отсутствие полноценных транзакций (ACID). ClickHouse не поддерживает транзакции в классическом понимании. Нельзя начать транзакцию, обновить несколько строк в разных таблицах и закоммитить изменения. Вставка данных атомарна на уровне пачки (batch), но точечные UPDATE и DELETE — это дорогие операции, которые не являются сильной стороной системы.
Кроме того, это слабая эффективность точечных запросов (Point Queries). Запрос вида SELECT * FROM orders WHERE id = 12345 будет неэффективен, особенно в больших таблицах. ClickHouse создан для сканирования и агрегации больших объемов, а не для поиска отдельных записей по ключу.
Далее, Clickhouse не является полной заменой OLTP-системе. Категорически не стоит использовать ClickHouse как основную базу данных для вашего веб-приложения, где требуется частое обновление отдельных строк, сложные транзакции и ссылочная целостность.
Важно! Попытка использовать ClickHouse для CRUD-операций (частое обновление отдельных строк) приведет к катастрофическому падению производительности и операционным проблемам.
ClickHouse в облаке vs. On-Premise
Выбор платформы развертывания — это вопрос контроля, затрат и операционных компетенций.
Для начала рассмотрим управляемый ClickHouse в облаке (Yandex Cloud Managed ClickHouse, Altinity Cloud, AWS)
Безусловными плюсами данного решения являются следующие моменты:
- Быстрый старт: развертывание кластера за минуты, а не недели;
- Нулевые операции: провайдер берет на себя обновления, резервное копирование, мониторинг и масштабирование кластера;
- Экономическая эффективность: оплата по факту использования (pay-as-you-go), нет капитальных затрат на железо;
- Встроенная отказоустойчивость: провайдеры обычно предлагают реплицированные кластеры "из коробки".
Однако не стоит забывать и про минусы:
- Меньше контроля: ограниченные возможности тонкой настройки под специфические нужды;
- Потенциально более высокая стоимость при очень больших и стабильных нагрузках;
- Выход из облака (Vendor Lock-in): миграция больших объемов данных может быть сложной.
В целом, можно сказать, что данное решение отлично подходит для стартапов, проектов с переменной нагрузкой, команд без глубоких экспертов по администрированию ClickHouse.
Теперь предлагаем рассмотреть on-premise развертывание.
Начнем с плюсов:
- Полный контроль: возможность тонкой настройки каждого параметра под конкретную задачу и железо;
- Пиковая производительность: можно собрать сервер с оптимальной конфигурацией CPU, RAM и дисков (часто NVMe);
- Безопасность и комплаенс: данные полностью остаются в вашем периметре, что критично для госструктур, финансов и здравоохранения;
- Предсказуемая стоимость при долгосрочной эксплуатации.
Минусы:
- Высокие операционные затраты: требуется команда инженеров для установки, настройки, мониторинга и поддержки кластера.
- Капитальные затраты: необходимость закупать и обслуживать оборудование.
- Медленное масштабирование: добавление новых нод требует закупки и физической установки серверов.
Данный тип развертывания больше всего подходит крупным предприятиям со стабильными нагрузками, строгими требованиями к безопасности и наличием сильной DevOps-команды.
Кейс по созданию реальной аналитической платформы для беттинг-сервиса
Один из показательных примеров — модернизация инфраструктуры данных для международного беттинг-сервиса betPawa.
betPawa — это международная платформа для онлайн-ставок (букмекерский сервис), активно работающая, в частности, на африканском рынке. Как и любой подобный сервис, его бизнес-модель критически зависит от данных. Ключевые операционные процессы платформы включают в себя: регистрацию и активность пользователей (привлечение новых игроков и удержание существующих); прием и расчет ставок (обработка миллионов транзакций во время популярных спортивных событий), платежи и вывод средств (интеграция с различными платежными системами); маркетинг и акции (анализ эффективности рекламных кампаний и бонусных программ), а также комплаенс и безопасность (мониторинг мошеннической активности и соблюдение регуляторных требований).
С технической точки зрения проблема заказчика была классической: устаревшая ETL-архитектура не справлялась с объемом и скоростью поступления данных.
Источниками данных служили операционные базы MySQL, содержащие данные о действиях игроков (регистрации, ставки, платежи), что касается архитектуры, то здесь ситуация была следующей: Airflow периодически выгружал данные из MySQL, преобразовывал их и загружал обратно в MySQL для отчетности.
Ключевые проблемы были следующими.
Во-первых, это экстремальная медлительность. ETL-процесс мог длиться более 12 часов и часто не успевал завершиться к началу нового рабочего дня. Аналитики получали данные с задержкой в сутки.
Во-вторых, это нулевая реальность в реальном времени. Невозможно было отслеживать активность пользователей и эффективность маркетинговых кампаний онлайн.
В – третьих, это отсутствие масштабируемости. Рост бизнеса и, как следствие, объема данных, только усугублял проблему.
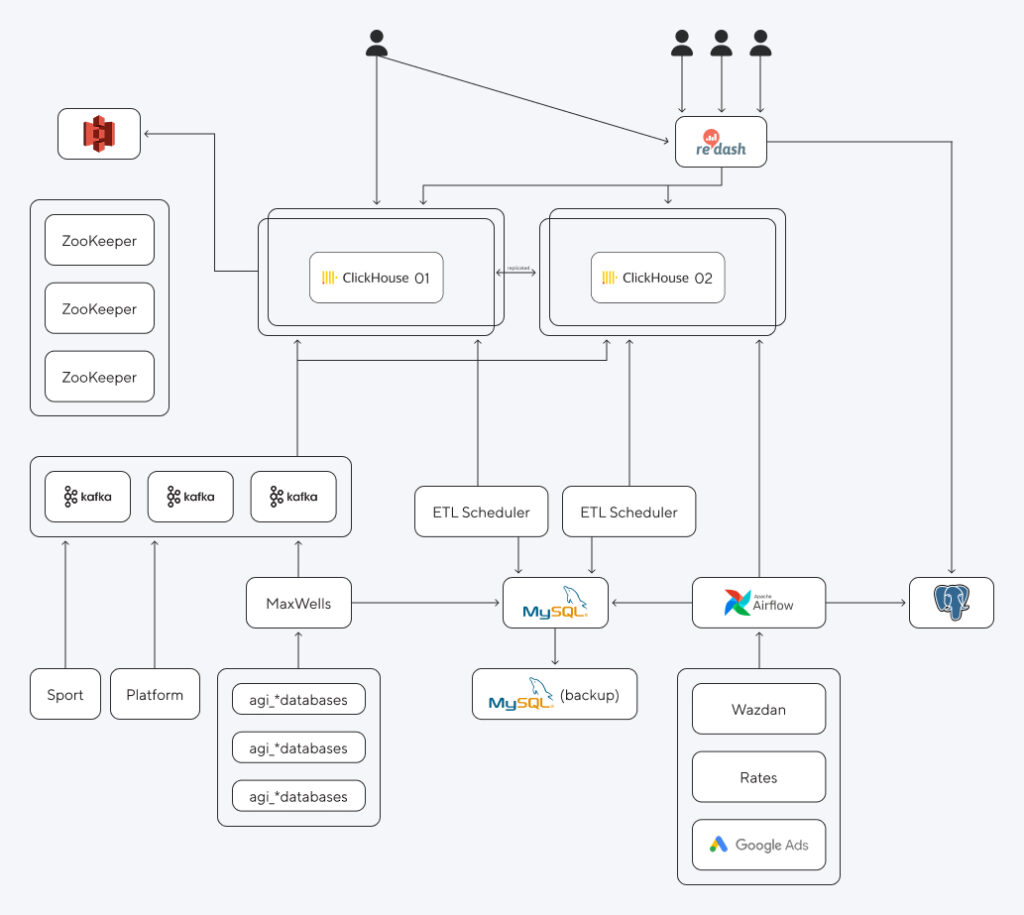
Предложенное решение на базе ClickHouse состояло в следующем: приглашенные дата - инженеры, работая в формате аутстаффа (полная интеграция в команду заказчика), спроектировали и внедрили современную потоковую архитектуру, характеризующуюся такми аспектами, как:
1. Потоковая передача данных (CDC). Вместо периодических выгрузок Airflow была настроена постоянная потоковая репликация данных из MySQL в Apache Kafka с помощью Maxwell's Daemon. Это инструмент, который "подслушивает" изменения в бинарных логах (binlog) MySQL и отправляет их в Kafka в реальном времени.
2. ClickHouse как центральное хранилище. Данные из Kafka напрямую поступают в ClickHouse. Для этого используются движки таблиц Kafka и MaterializedView, которые обеспечивают непрерывный прием данных. На стадии Stage часть данных сначала попадает в промежуточные ("сырые") таблицы, где происходит их очистка и объединение из разных источников. После стадии Stage (или напрямую из Kafka) данные попадают в основные таблицы фактов, оптимизированные под конкретные виды анализа. На их основе создаются агрегированные витрины данных для аналитиков.
В результате внедрения новой системы был реализован переход от ночных пакетных обработок к аналитике в реальном времени. Задержка в получении данных сократилась с 24 часов до 3-5 минут. Кроме того, появилась возможность построения интерактивных дашбордов. Бизнес-пользователи получили доступ к актуальным данным о ставках, платежах и активности пользователей с возможностью фильтрации и детализации за секунды. В целом, новая инфраструктура стала с легкостью выдерживать пиковые нагрузки, связанные с спортивными событиями, и смогла масштабироваться по мере роста бизнеса.
Примечание:
Maxwell's Daemon — это ключевой инструмент в арсенале инженера данных, который решает одну из самых сложных задач — захват изменений данных в реальном времени. Давайте разберем его более подробно.
Maxwell's Daemon — это open-source утилита для CDC (Change Data Capture) данных из MySQL в реальном времени. Название является отсылкой к мысленному эксперименту "Демон Максвелла" в физике, что символизирует способность инструмента "сортировать" изменения данных.
Если говорить просто, Maxwell — это "мостик", который:
- подключается к вашей MySQL-базе как реплика
- читает бинарные логи (binlog) — журнал всех изменений в базе
- преобразует эти изменения в JSON-сообщения
- отправляет их в различные системы: Kafka, Kinesis, RabbitMQ, или просто в файл
Процесс работы данного инструмента можно условно разбить на несколько ключевых этапов:
1. Подключение к MySQL как реплика. Maxwell подключается к MySQL-серверу с правами репликации, а затем запрашивает позицию в бинарном логе и начинает читать изменения с этой точки
2. Чтение бинарного лога (binlog). MySQL записывает в binlog все изменения: INSERT, UPDATE, DELETE. Maxwell читает эти записи в реальном времени, не нагружая основную базу
3. Парсинг и преобразование в JSON. Каждое изменение преобразуется в структурированное JSON-сообщение:
json
Copy
Download
{
  "database": "ecommerce",
  "table": "orders",
  "type": "insert",
  "ts": 1630000000,
  "xid": 12345,
  "commit": true,
  "data": {
    "id": 1001,
    "user_id": 501,
    "amount": 99.99,
    "status": "completed",
    "created_at": "2023-08-25 10:30:00"
  }
}
Для UPDATE сообщение содержит и старые, и новые значения:
json
Copy
Download
{
  "database": "ecommerce",
  "table": "orders",
  "type": "update",
  "ts": 1630000001,
  "data": {
    "id": 1001,
    "status": "shipped"  // новое значение
  },
  "old": {
    "status": "completed"  // старое значение
  }
}
4. Отправка в целевую систему. Настроенный продюсер отправляет сообщения в Kafka, RabbitMQ и т.д.
Базовая конфигурация через config.propertie выглядит следующим образом:
# Подключение к MySQL
host=mysql-production.example.com
user=maxwell
password=secret
port=3306
# Куда отправлять данные
producer=kafka
kafka.bootstrap.servers=kafka1:9092,kafka2:9092
kafka_topic=maxwell_events
# Фильтрация (опционально)
filter=exclude: database.*, include: important_db.important_table
А запуск выглядит так:
./bin/maxwell --config config.properties
В целом, Maxwell's Daemon — это элегантное и эффективное решение для захвата изменений данных из MySQL. Его главные преимущества, это, в первую очередь, простота (минимальная конфигурация, понятный вывод JSON), надежность (точно следует за binlog, сохраняет позицию), производительность (практически нулевая нагрузка на источник), а также гибкость (легко интегрируется с любыми системами через Kafka).
Именно благодаря этим качествам Maxwell стал ключевым компонентом в таких проектах, как betPawa, где реальное время обработки данных критически важно для бизнеса.
Для команд, работающих с MySQL и нуждающихся в реальном времени данных, Maxwell часто оказывается оптимальным выбором — достаточно простым для быстрого старта, но достаточно мощным для промышленной эксплуатации.
Типичные ошибки и риски при внедрении ClickHouse: как их избежать?
Наш многолетний опыт внедрения ClickHouse в десятках проектов позволил выделить ключевые ошибки, которые допускают команды.
Во-первых, это неправильная схема данных и первичный ключ. Самый главный риск в данном случае кроется в низкой производительности запросов, особенно при неправильном порядке столбцов в первичном ключе. Первичный ключ должен отражать наиболее частые сценарии запросов. Столбцы, по которым часто идет фильтрация (например, date, user_id), должны стоять в начале ключа. Тщательно проектируйте схему таблиц на этапе проектирования, так как ее изменение в будущем может быть трудоемким.
Во-вторых, это игнорирование партиционирования. Главный риск в данном случае состоит в том, что запросы будут выполняться полным сканированием таблицы (full scan), что крайне медленно для больших объемов. Поэтому всегда партиционируйте большие таблицы, чаще всего по дате (toYYYYMM(event_date)). Это позволяет системе читать только релевантные партиции.
В – третьих, это попытка использовать мелкие вставки (одна строка за раз). В данном случае самый главный риск – это экстремально низкая производительность записи и высокая нагрузка на систему. Всегда вставляйте данные пачками от 1000 до 100000 строк за один запрос. Используйте буферизацию на стороне приложения или инструменты вроде Kafka для агрегации мелких событий.
В – четвертых, это отсутствие мониторинга процесса слияния (Merge). Накопление большого количества мелких кусочков данных (parts) может привести к замедлению запросов и исчерпанию места inodes на файловой системе. Настройте мониторинг метрик ClickHouse (например, через Prometheus) для отслеживания количества частей в таблицах и состояния фоновых процессов слияния.
И, наконец, недооценка операционных затрат при On-Premise развертывании. В этом случае кластер остается без должного обслуживания, что приводит к простоям и потере данных. Обязательно четко оцените наличие компетенций для поддержки кластера. Если команды нет, рассмотрите управляемые облачные решения.
В целом, ClickHouse — это не просто быстрая база данных. Это инструмент, который позволяет бизнесу принимать решения на основе актуальных данных, а не вчерашних отчетов. Он открывает возможности для глубокого анализа пользовательского поведения, оперативного мониторинга бизнес-метрик и создания интеллектуальных систем, реагирующих на события в реальном времени.
Внедрение ClickHouse — это сложная инженерная задача, требующая глубокого понимания как самой СУБД, так и принципов построения надежных data-платформ. Ошибки на этапе проектирования архитектуры и схемы данных могут нивелировать все преимущества технологии.


