

Основы работы с данными: таблицы, типы данных и схемы
Основа любой аналитической системы — это данные: где они хранятся, как они структурированы, какие правила применяются к их хранению и извлечению. В рамках курса по Apache Doris мы рассматриваем основы работы с данными: как устроены таблицы, какие есть типы данных, какие схемы данных применимы в аналитических нагрузках и зачем нужна продуманная структура данных для эффективного выполнения запросов. Doris — это распределённая колонночная база данных для аналитики в реальном времени, спроектированная для обработки больших объёмов данных с высокой скоростью ответов. Она подходит для квази-реального анализа событий, бизнес-отчетности и дэшбордов, где важна скорость агрегаций и возможность работать с большими таблицами. Внимание к структурам данных, выбору типов, проектированию схем и правильной настройке кластера позволяет снизить задержки, ускорить запросы и облегчить поддержку вашего аналитического стека.
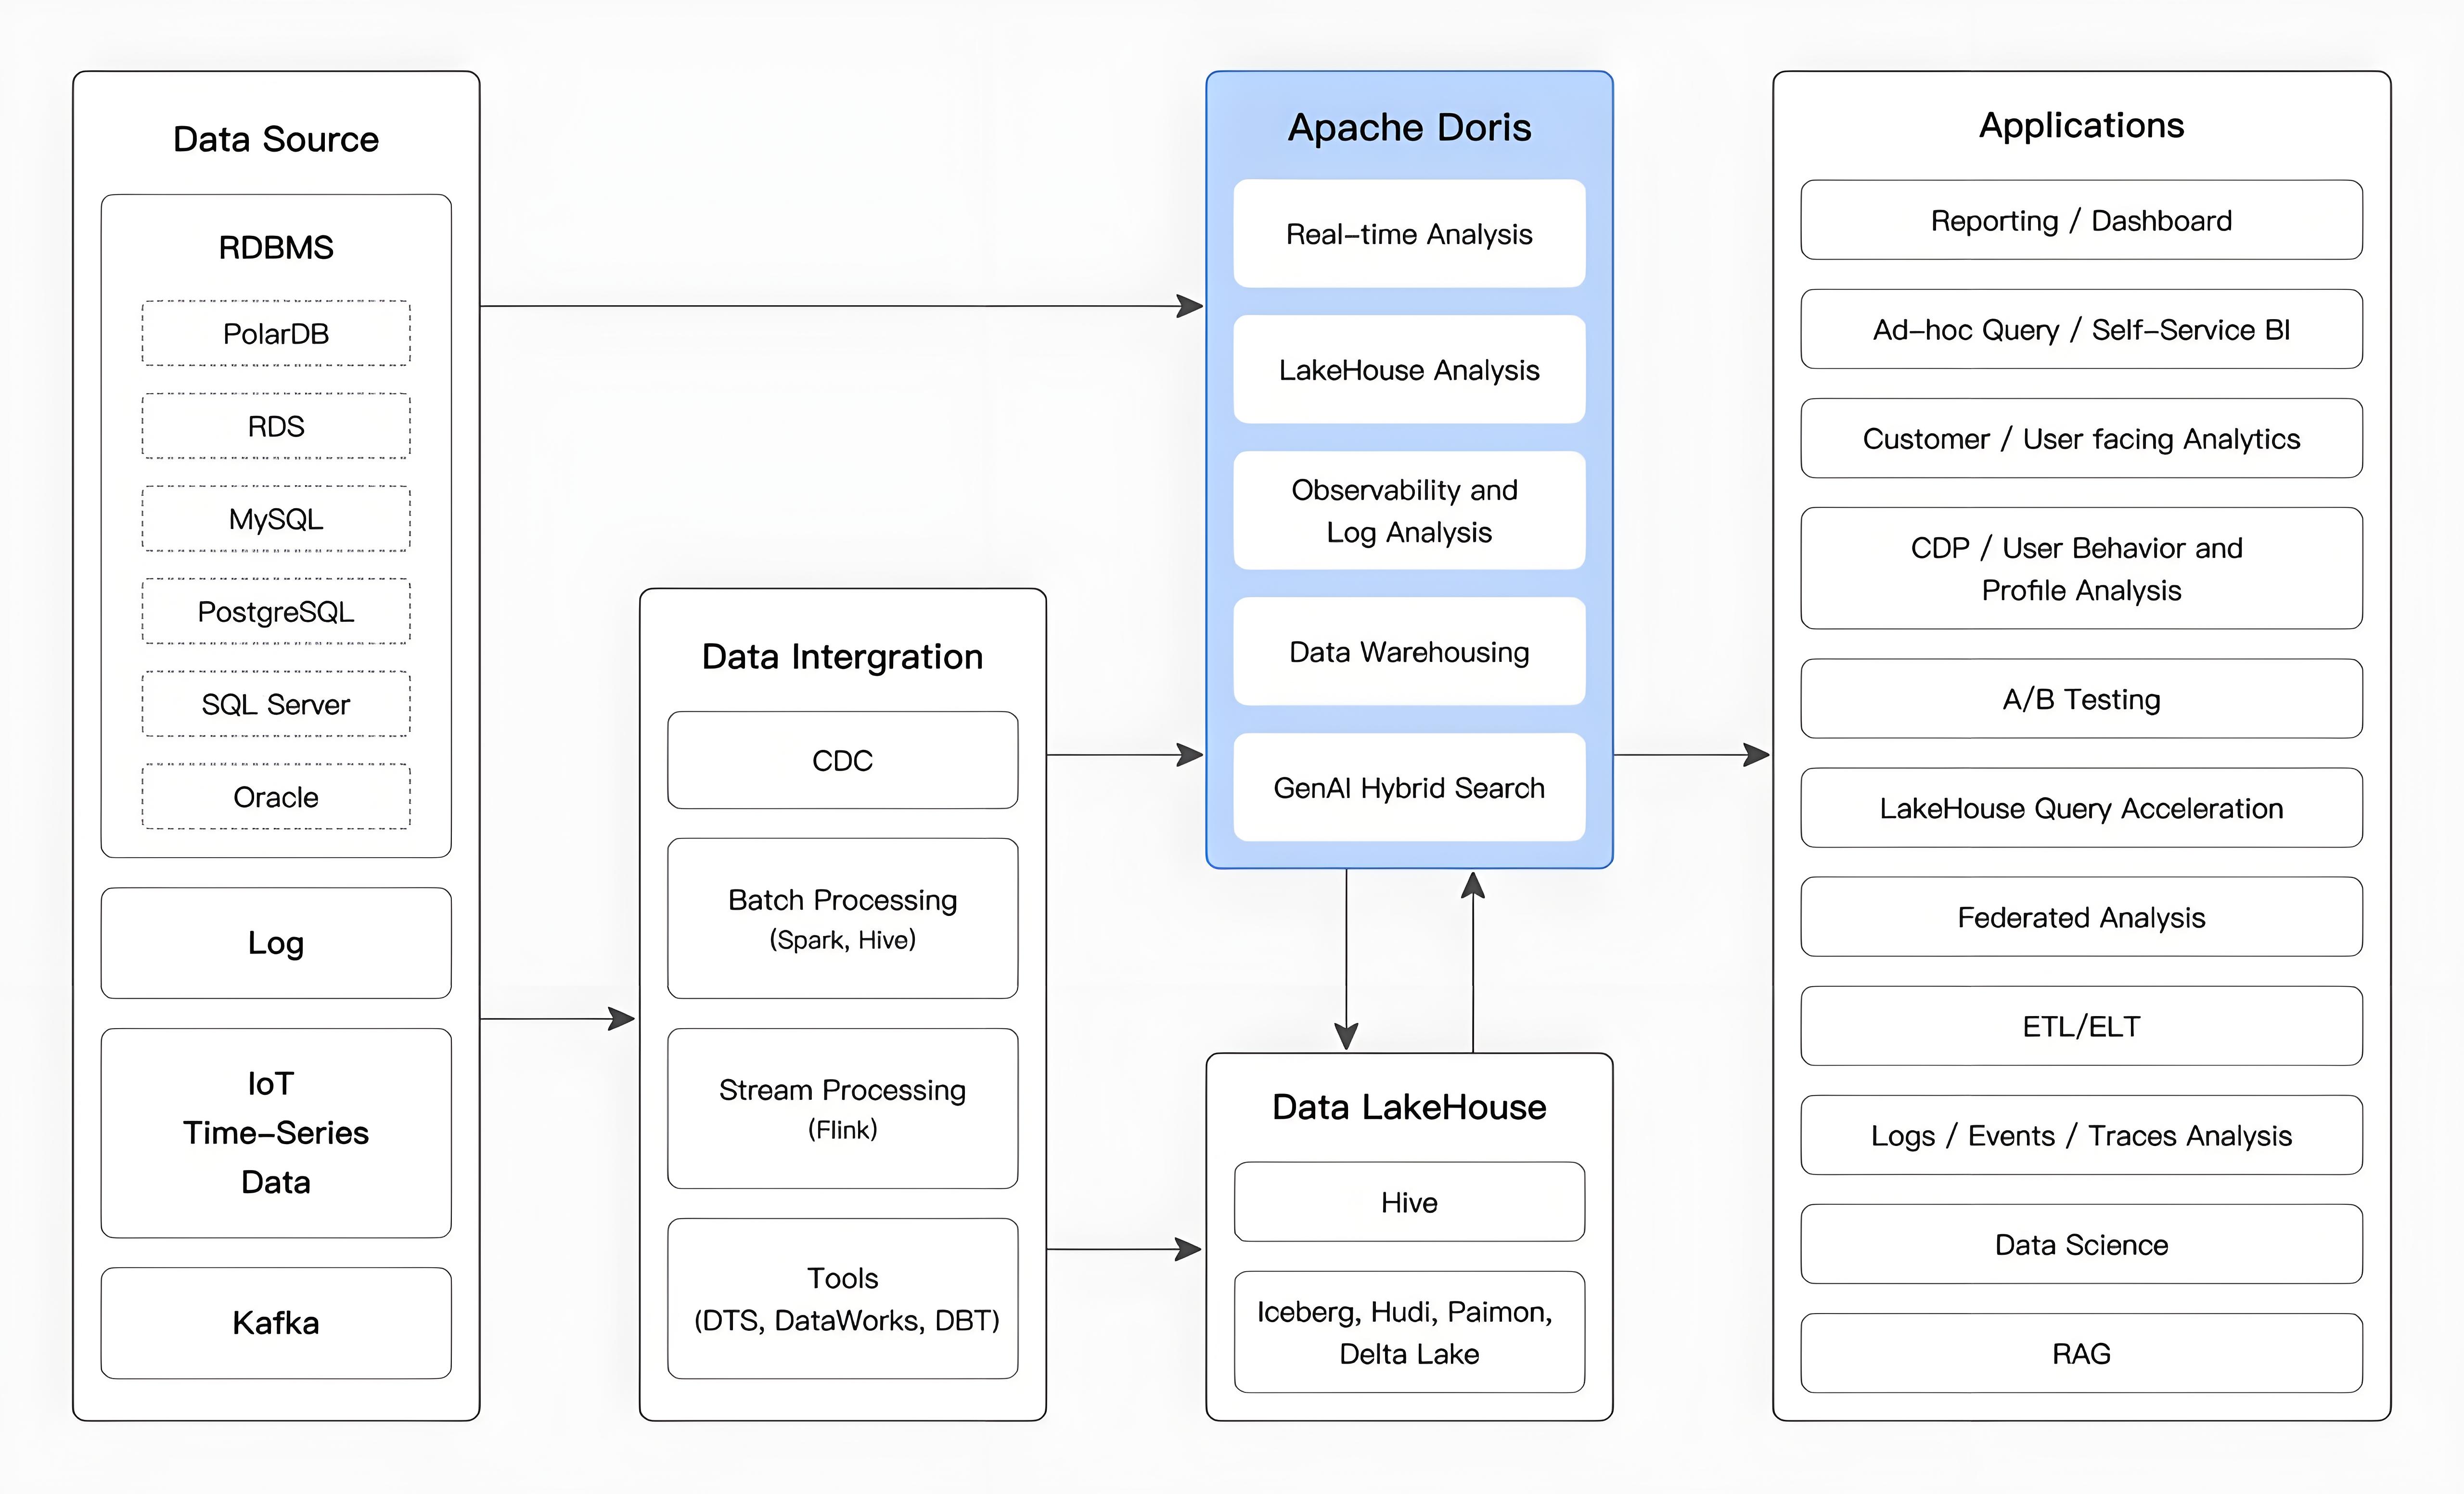
Таблицы и схемы как основа структуры данных
Схема базы данных — это набор таблиц и их взаимосвязей, которые обеспечивают хранение информации в удобной и эффективной форме. В аналитических задачах часто применяют концепции денормализации и проекций под конкретные сценарии запросов, чтобы минимизировать количество соединений и ускорить агрегации. В Doris это реализуется за счёт структурирования данных в таблицах и выборе подходящей схемы разбиения и распределения.
Типы таблиц в Doris
В Doris существуют различные типы таблиц, которые определяют правила обработки ключей и агрегаций. Важной частью проектирования является выбор между типами таблиц, которые влияют на поведение вставки, обновления и агрегации данных. Основные концепции:
- DUPLICATE KEY таблицы: предназначены для наборов событий или фактов, где каждая запись может дублироваться и не требует агрегации на уровне схемы. При вставке новые строки могут добавляться независимо; агрегации не выполняются автоматически по ключу. Такой подход удобен для лог-файлов, событий и фактов продаж в реальном времени, когда важно сохранить точную последовательность операций и не упрощать данные до суммарного вида.
- AGGREGATE KEY таблицы: предназначены для ситуаций, когда по определённой группе записей нужно автоматически агрегировать числовые значения. При вставке увеличение значения по ключу может происходить за счёт суммирования, минимального/максимального и других агрегаций, которые заданы для столбцов. Это полезно, например, для таблиц фактов с дневными итогами, где важно поддерживать агрегированное состояние без явной группировки в каждом запросе.
Выбор типа таблицы влияет на поведение операций и производительность. В процессе проектирования полезно определить: как часто данные будут обновляться, требуется ли поддержка дельта-обновления в реальном времени и как будут использоваться агрегации в аналитике.
Разделение и распределение данных
Doris реализует масштабирование за счёт горизонтального распределения. Основные принципы:
- DISTRIBUTED BY HASH(col) или DISTRIBUTED BY HASH(col1, col2): распределение по хэш-значению указанных столбцов. Это позволяет равномерно распределять данные по баками (BUCKETS) и параллельно обрабатывать запросы.
- PARTITION BY: разбиение таблицы на физические разделы по диапазонам значений, например по дате. Разбиение улучшает время выполнения запросов, позволяет параллелизм уровнем разделов и упрощает архивирование и очистку устаревших данных. В Doris можно сочетать партиции и хэш-распределение, подстраивая хранение под характер запросов.
- Репликация и устойчивость: Doris реплицирует данные между несколькими BE-узлами для отказоустойчивости и повышения доступности. Выбор числа реплик зависит от требуемой устойчивости и доступной инфраструктуры.
Типы данных и их особенности
Doris поддерживает набор базовых и практических типов данных, которые применяются для определения точности хранимых значений и памяти, потребляемой под столбцы. Приведённый ниже перечень охватывает основные категории, которые чаще всего используются в аналитических задачах:
- Числовые: TINYINT, SMALLINT, INT, BIGINT, LARGEINT (иногда встречается как 128-битный целочисленный тип в отдельных реализациях). Эти типы применяются для идентификаторов, счетчиков и метрик.
- Числовые с плавающей точкой: FLOAT, DOUBLE. Используются для приближённых или масштабируемых вычислений.
- Десятки и точность: DECIMAL (и варианты с высокой точностью в зависимости от версии). Используются там, где важна финансовая точность и контролируемый дробный формат.
- Логические и строковые: BOOLEAN, CHAR, VARCHAR. VARCHAR полезен для описаний, имен, категорий; CHAR может применяться для фиксированной длины строк.
- Дата и время: DATE, DATETIME (или TIMESTAMP в некоторых реализациях). Эти типы критичны для временных рядов, дневной аналитики и ретроспектив.
- Расширенные/сложные типы: в некоторых версиях Doris добавляются поддержка дополнительных структур данных или специфических форматов; однако при проектировании стоит держаться базовых типов и избегать полагаться на экспертную поддержку редко используемых типов без тестирования.
Теория схем и эволюции
- Эволюция схемы: изменение структуры таблиц в аналитических СУБД требует аккуратного подхода. В Doris можно добавлять новые столбцы к существующим таблицам, иногда нужно учитывать зависимые представления и совместимость с текущими запросами. Прежде чем менять схему, полезно провести анализ запросов, зависимостей и объёмов данных.
- Нормализация против денормализации: в аналитике часто предпочтительна денормализация ради снижения числа JOIN-операций и ускорения агрегаций. Doris хорошо работает с денормализованными схемами, особенно когда задачи ориентированы на Fast Aggregations и фильтрацию по ключам.
- Принципы проектирования под нагрузку: определение рабочих запросов, частоты обновления данных, требуемой скорости ответов и размерности данных помогают выбрать подходящие ключевые столбцы, способ разбиения и специфику таблиц (DUPLICATE vs AGGREGATE).
Методологии проектирования схем
- Определение фактов и измерений: в типичной аналитике полезно разделить измерения (где используются атрибуты, такие как дата, регион, клиент) и факты (числовые метрики, такие как продажи, количество). Это создаёт понятную и расширяемую схему.
- Выбор ключей: для DUPLICATE KEY — ключи определяют уникальные уникальные сочетания записей, но дубликаты не удаляются автоматически. Для AGGREGATE KEY — ключевые столбцы используются для группирования и агрегаций, а вставляемые значения агрегируются на уровне таблицы.
- Планирование партиционирования: если ваш набор данных имеет устойчивые временные паттерны, партиционирование по дате часто даёт хорошие выгоды. Это помогает ограничить сканируемые данные и ускоряет очистку устаревших данных.
- Оптимизация запросов: для часто повторяющихся запросов с агрегациями стоит задуматься о денормализации и предвысоких агрегатах. В других случаях разумно поддерживать нормальные таблицы и использовать агрегации на уровне запросов.
Практические примеры
Open-source подход: локальная установка Doris и базовые сценарии
Цель примера: показать базовый цикл работы с данными в Doris на открытой платформе, используя простой сценарий загрузки данных, создание таблиц и выполнение запросов.
1) Развёртывание Doris в локальной среде (упрощённый сценарий)
- Используйте Docker или локальный кластор. В качестве иллюстрации можно запустить локальный набор FE и BE узлов, чтобы проверить базовые операции.
- Это позволяет новичку увидеть, как запускаются сервисы, как подключиться к ним через клиентские инструменты и как выполнять базовые операции над данными.
2) Создание базы и таблиц
- Создаём базу данных для аналитики, например: CREATE DATABASE analytics;
- Пример создания таблицы с DUPLICATE KEY и распределением по HASH:
  CREATE TABLE analytics.sales_fact (
    sale_id BIGINT,
    product_id INT,
    store_id INT,
    sale_date DATE,
    amount DECIMAL(18,2),
    quantity INT
  ) DUPLICATE KEY(sale_id) DISTRIBUTED BY HASH(sale_id) BUCKETS 16;
--Пример создания таблицы измерений (dim) с AGGREGATE KEY:
  CREATE TABLE analytics.product_dim (
    product_id INT,
    product_name VARCHAR(100),
    category VARCHAR(50),
    price DECIMAL(18,2)
  ) AGGREGATE KEY(product_id) DISTRIBUTED BY HASH(product_id) BUCKETS 8;
3) Загрузка данных и базовый анализ
- В простом сценарии можно вставлять данные через INSERT:
  INSERT INTO analytics.product_dim (product_id, product_name, category, price)
  VALUES (1001, 'Телеприбор A', 'Электроника', 1299.99),
(1002, 'Телеприбор B', 'Электроника', 899.50);- В реальном кластере данные чаще загружаются пакетами через брокеры (BROKER LOAD) или через хранение в HDFS/S3 и последующую загрузку. Это позволяет обойти ограничение на прямые вставки в большие таблицы.
4) Пример простой аналитики
- Запрос для агрегации продаж по дате:
  SELECT sale_date, SUM(amount) AS total_sales, SUM(quantity) AS total_units
  FROM analytics.sales_fact
  GROUP BY sale_date
  ORDER BY sale_date;
- Запрос с фильтром и агрегацией по категории:
  SELECT p.category, SUM(s.amount) AS category_sales
  FROM analytics.sales_fact s
  JOIN analytics.product_dim p ON s.product_id = p.product_id
  WHERE s.sale_date BETWEEN '2024-01-01' AND '2024-12-31'
  GROUP BY p.category;
Практический пример с российскими решениями и инструментами
Российские и отечественные инструменты часто применяют Doris в рамках больших дата-центров и корпоративной аналитики. В качестве практического примера можно рассмотреть интеграцию Doris с популярными инструментами BI и разработки, используемыми в российских проектах:
- DataGrip (разработчик JetBrains, российское происхождение компании) — мощная IDE для работы с базами данных, поддерживает JDBC-совместимые источники и может работать с Doris. Это позволяет новичку подключаться к Doris, просматривать схемы, писать SQL, выполнять отладку запросов и сохранять шаблоны запросов в дружелюбном интерфейсе.
- Apache Superset (open-source) — платформа визуализации и дэшбордов, которая может подключаться к Doris через соответствующий драйвер/коннектор JDBC/ODBC. Это даёт возможность быстро строить дэшборды, фильтры и дашборды на основе данных Doris, полезно для демонстраций и бизнес-аналитики.
- DBeaver (многоязычный кроссплатформенный клиент SQL, поддерживающий JDBC) — открытый инструмент, который можно использовать совместно с Doris для администрирования, SQL-выражений и простого экспорта результатов.
- Российские инфраструктурные проекты и внутренние BI-решения: в корпоративной среде Doris может быть внедрён как часть дата-озера (data lake) или аналитического слоя, соединённого с локальными брокерскими конвейерами, ETL/ELT-процессами и мониторингом. Часто применяются отечественные средства мониторинга и журналирования, которые оборачивают доступ к Doris через API и гибко управляют нагрузкой.
Порядок действий для практики с Doris в реальной среде
- Определите требования аналитики: какие данные, какие временные интервалы, какие показатели и какие дашборды должны быть доступны пользователям.
- Разработайте схему: решите, какие таблицы будут DUPLICATE KEY, какие — AGGREGATE KEY; выберите поля для ключей, определите партиционирование по дате и распределение по HASH.
- Разверните кластер: создайте FE и BE ноды, настройте репликацию, параметры памяти и дисков, обеспечьте сеть и устойчивость.
- Подключите BI/ETL-инструменты: DataGrip для разработки и тестирования SQL, Superset/Metabase или отечественные BI-решения для визуализации.
- Протестируйте загрузку данных и запросы: проверьте скорость сканирования, точность агрегаций и устойчивость к нагрузкам.
Технические детали
Устройство кластера и настройка
- Архитектура Doris строится вокруг Frontend (FE) и Backend (BE) нод. FE отвечает за метаданные и планирование запросов, BE хранит и обрабатывает данные.
- Физическое распределение данных осуществляется через BUCKETS и DISTRIBUTED BY HASH, а логика группировки и агрегаций — через тип таблицы (DUPLICATE KEY vs AGGREGATE KEY).
- Партиционирование позволяет ограничивать сканирование по диапазонам и ускорять агрегации.
Типы столбцов и их влияние на производительность
- Выбор типа данных влияет на использование памяти и точность вычислений. Например, DECIMAL обеспечивает точность для финансовых расчётов, но может потребовать большего объёма памяти.
- Использование строковых типов VARCHAR/CHAR влияет на занимаемую память и производительность фильтрации по строкам; выбор длины и нормализация текстовых данных поможет эффективнее сжать данные.
Управление схемой и миграциями
- DESCRIBE TABLE и SHOW CREATE TABLE позволяют увидеть текущую схему, что упрощает миграции и голосование за изменения.
- При изменении схемы полезно планировать совместимость с существующими запросами и обработку данных без потери информации.
Интеграции и инструменты
- Подключение через JDBC/ODBC: Doris обеспечивает совместимость через стандартные интерфейсы, что позволяет использовать широкий набор инструментов разработки и визуализации.
- Мониторинг и телеметрия: сбор метрик FE/BE (CPU, память, I/O, задержки, число запросов) и настройка панелей в Grafana или аналогичных инструментах для визуализации загрузок и производительности.
Риски и ограничения
- Схема и архитектура: неправильный выбор партиционирования и распределения может привести к узким местам и высокой задержке запросов при больших объёмах данных.
- Эволюция схемы: добавление столбцов возможно, но изменение ключевых концепций (например, переход между DUPLICATE KEY и AGGREGATE KEY) может быть затратным и потребовать миграций данных.
- Обновления и совместимость: версии Doris развиваются, новые функции могут улучшать производительность, но потребуют тестирования в вашей среде и возможных изменений в существующих конструкциях.
- Интеграции: интеграция с BI/ETL инструментами требует внимания к версиям драйверов и совместимости, особенно при использовании российских или отечественных инструментов в рамках корпоративной экосистемы.
- Обновление и резервное копирование: требуется выстроенная стратегия бэкапов и восстановления, чтобы минимизировать риск потери данных и простоя.
- Временные ограничения и задержки: большие таблицы и сложные запросы могут приводить к задержкам, если кластер недоокомплектован ресурсами. Планирование ресурсов и тестирование под реальные нагрузки помогут снизить риски.
- Безопасность и соблюдение нормативов: хранение и обработка данных должны соответствовать локальным требованиям по защите данных и политике доступа. Не забывайте о ролях, правами доступа и аудитам.
Работа с данными в Doris требует понимания того, как структурируются таблицы, какие типы данных применяются и как правильно проектировать схемы для нужд аналитики. Основы включают выбор типа таблицы (DUPLICATE KEY или AGGREGATE KEY), распределение и партиционирование, освоение базовых типов данных и механизмов загрузки данных. Практические примеры показывают, как можно начать с простого набора таблиц, загрузить данные, выполнить базовые анализы и затем расширять схему по мере роста требований. Обратите внимание на инструменты интеграции и мониторинга — это поможет поддерживать устойчивость к нагрузкам и качество аналитики. В условиях российского рынка можно эффективно использовать отечественные инструменты разработки и визуализации (например, DataGrip) в связке с Doris, что упрощает внедрение и обучение сотрудников. Важно планировать миграции, тестировать под нагрузками и постоянно держать в фокусе требования к точности, скорости и устойчивости системы.
Вопрос–Ответ (FAQ)
1) Что такое DUPLICATE KEY и AGGREGATE KEY таблицы в Doris и как выбрать между ними?
DUPLICATE KEY таблицы сохраняют каждую вставку как отдельную запись без автоматической агрегации. Это подходит для событийной или логной аналитики, где важно сохранить каждую операцию. AGGREGATE KEY таблицы агрегируют значения по ключевым столбцам во время вставки или обновления, что полезно для дневной или периодной аналитики с суммированием и другими агрегациями. Выбор зависит от того, нужно ли вам сохранять каждую запись в точности или упростить данные до агрегированного состояния.
2) Какие типы данных наиболее часто используются в Doris и как выбрать тип?
Наиболее часто встречаются числовые типы (TINYINT, SMALLINT, INT, BIGINT, LARGEINT), DECIMAL для точных вычислений, FLOAT/DOUBLE для вещественных чисел, BOOLEAN, VARCHAR и DATE/DATETIME. Выбор типа зависит от характера данных и необходимой точности. Например, финансовые показатели лучше хранить в DECIMAL, временные ряды — в DATE/DATETIME, идентификаторы — в BIGINT.
3) Как выбрать схему для аналитических запросов?
Планируйте схему вокруг фактов и измерений. Разделите данные на таблицы фактов (с метриками) и измерения (категории, параметры). Определите ключевые столбцы для быстрого фильтра и агрегации. Решите, где применить денормализацию ради ускорения агрегаций, и где оставить нормализованные структуры для гибкости.
4) Зачем нужна партиционирование и распределение?
Партиционирование ограничивает сканирование чтением только нужных диапазонов данных, что ускоряет запросы и упрощает очистку устаревших данных. Распределение по HASH по ключу обеспечивает равномерное распределение данных между узлами кластера, что улучшает параллелизм выполнения запросов.
5) Как осуществлять загрузку данных в Doris?
Данные можно загружать через INSERT для небольших партий, а для больших массивов — через механизмы загрузки через брокеров, HDFS или S3 (load jobs). В реальном сценарии чаще всего применяют пакетную загрузку из облачных хранилищ или локальных источников через брокеры для высокой скорости.
6) Какие инструменты можно использовать для работы с Doris в российских условиях?
Open-source инструменты: Apache Superset, DBeaver и другие клиенты через JDBC/ODBC. Российские решения включают DataGrip от JetBrains, который поддерживает работу с Doris через JDBC и часто используется в российских ИТ-отделах. Эти инструменты позволяют писать SQL, управлять схемами и строить дэшборды.
7) Какие риски и ограничения есть при внедрении Doris?
Риски включают неправильный выбор схемы и партиционирования, задержки под реальную нагрузку при нехватке ресурсов, сложности миграций схем, зависимость от версий и совместимости инструментов. Важно иметь план по мониторингу, резервному копированию и обновлениям, а также учитывать требования к безопасности и соответствию нормативам.
8) Как обеспечить мониторинг и устойчивость Doris в продакшене?
Настройте сбор метрик FE/BE, используйте инструмент мониторинга (например Grafana) для визуализации задержек, нагрузок и состояния кластера. Настройте политики резервирования, регулярное резервное копирование и план восстановления. Тестируйте обновления в тестовой среде перед переносом в продакшен.
9) Как правильно проектировать эволюцию схемы без потери данных?
Планируйте миграции с учётом существующих запросов и зависимостей. При изменении схемы полезно добавлять новые столбцы безопасно и тестировать влияние на существующие запросы. Применяйте миграции по этапам, используйте версии и контроль изменений, а также тестируйте на подмножествах данных.
10) Где можно найти ресурсы для углубления?
Официальная документация Apache Doris, примеры по созданию таблиц и нагрузке, руководства по выбору схем и настройке кластера. Также полезны практические материалы по интеграции Doris с BI-инструментами (DataGrip, Superset) и сообществу специалистов, которые решают схожие задачи.


