

Поиск, навигация и UX каталога
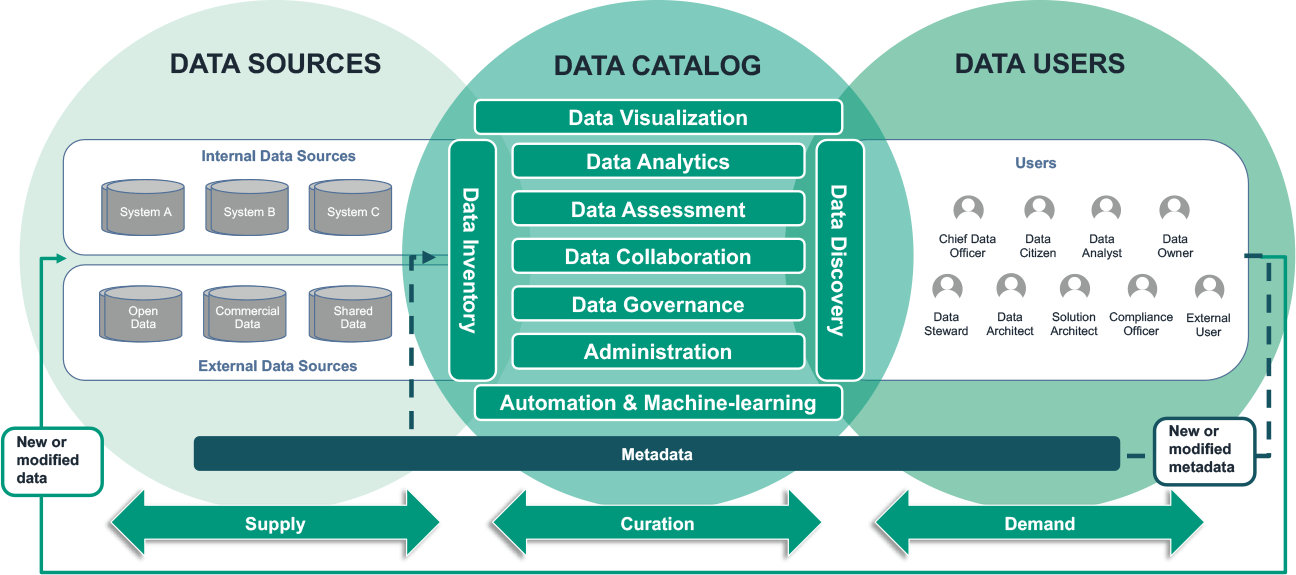
Поиск, навигация и UX каталога данных являются ключевыми элементами любого внедрения Data Catalog в компании. Цель каталога — сделать данные доступными, прозрачными и понятными для широкого круга сотрудников: аналитиков, разработчиков, бизнес-аналитиков, риск-менеджеров и руководителей. Хорошо спроектированный UX и продуманная навигация позволяют пользователю не только быстро находить нужный набор данных, но и понимать контекст: что за данные, кто ответственен, какие стандарты качества применяются, какие ограничения по доступу и какие зависимости существуют. Эта глава рассчитана на новичка: объясняет базовые концепции, термины, методологии проектирования поиска и навигации, приводит практические примеры как на базе открытых решений, так и с учетом российских реалий, а также рассматривает риски и ограничения внедрения.
Базовые термины и концепции
- Каталог данных (data catalog) — это централизованная система метаданных и квалифицированной информации об активам данных, включающая их описание, контекст, качество, историю изменений, связи и правила доступа. Каталог служит входной точкой для поиска данных и их понимания.
- Метаданные — данные о данных. Технические метаданные описывают структуру и хранение данных: имена таблиц, типы столбцов, схемы, источники загрузки, расписания обновлений. Бизнес-метаданные (бизнес-термины, владельцы, ответственность, цели использования) формируют понятный контекст для пользователей, не являющихся экспертами по данным.
- Глоссарий/деловая лексика (business glossary) — набор бизнес-терминов и его определений, связанный с активами данных. Хороший глоссарий уменьшает двусмысленность и способствует единообразию понимания данных.
- Лейблы и таксономия (tags, taxonomy) — метаданные для классификации активов: чувствительность данных (PII, секреты, общедоступные данные), тематика, домен (Финансы, Маркетинг, Операции), уровень качества и т.д.
- Лейблы качества и риска (data quality, data risk) — индикаторы состояния данных, которые помогают пользователю быстро оценить доверие к набору (уровень полноты, согласованности, задержки, точности).
- Линейность данных (data lineage) — карта происхождения данных и их трансформаций: источники, ETL/ELT шаги, промежуточные хранилища. Линейность позволяет понять, как данные приходят в итоговый набор, какие зависимости существуют и какие последствия изменения могут быть.
- Поиск и навигация (search and navigation) — совокупность механизмов извлечения информации и способов перемещения по каталогу: полнотекстовый поиск, фильтры, фасеты, автодополнение, построение графа зависимостей, визуализация линейности.
- Поиск релевантности (search relevance) — набор факторов, определяющих, как результат поиска ранжируется: соответствие запросу, популярность, качество, обновляемость, доверие к источнику.
- Управление доступом (RBAC/ABAC, SSO) — гарантии того, кто может видеть и использовать какие активы. В каталогах важна не только видимость, но и аудит действий и соответствие требованиям конфиденциальности.
- Экосистема метаданных и интеграции — каталог редко существует отдельно. Он должен интегрироваться с источниками метаданных (СУБД, хранилища данных, BI-инструменты, пайплайны данных, системы качества), системами безопасности и мониторинга.
Методологии проектирования UX и поиска
- Пользовательские персоны и задачи — чтобы UX был эффективен, нужно понимать, кто будет пользоваться каталогом и какие у них задачи. Например: аналитик ищет набор данных для квартального отчета, инженер по данным проверяет источник и качество данных, бизнес-аналитик ищет термины в глоссарии.
- Информационная архитектура — продуманная организация активов по доменам, папкам, пространствам имен, типам активов. Включает единые правила именования и категоризации.
- Прогрессивная фильтрация — дизайн, позволяющий «сначала» найти широкий набор документов, затем сузить результаты несколькими фасетами: домен, владелец, период обновления, уровень чувствительности, источник данных и т. д.
- Поиск как продукт — поиск должен иметь понятную подсветку, подсказки, релевантные результаты, автодополнение и возможность сохранения запросов. Важна способность строить сложные запросы без углубления в синтаксис.
- Прототипирование и тестирование — на этапах разработки проводят тесты с реальными пользователями: проверяют понятность терминов, скорость поиска, удобство навигации по линейности и карте зависимостей.
- Метаданные как процесс — сбор и обновление метаданных должны быть автоматизированы там, где возможно, с поддержкой ручного ввода и проверки. Это снижает устаревание и повышает доверие к каталогу.
Практические примеры
Практика архитектурного выбора и навигационных решений опирается на реальный опыт внедрения каталогов в разных условиях. Ниже представлены два типа примеров: на базе открытых решений и с учетом российских реалий (описаны кейсы в форме обобщённых сценариев, с акцентом на архитектуру, процессы и практику).
1) Практические примеры на базе открытых решений
- Пример стекa Amundsen + OpenSearch + PostgreSQL. Amundsen обеспечивает центральный каталог, метаданные и линейность, OpenSearch служит поисковым движком, PostgreSQL хранит системные данные каталога и глоссарий. Архитектура строится так: источники данных (разные базы, дата-озера и BI-инструменты) подключаются к индексу метаданных через адаптеры и коннекторы. Метаданные собираются через воркеры и сервисы эксплуатации, обновления происходят по расписанию или по событию. В результатe пользователь получает: полнотекстовый поиск по названию таблиц и столбцов, фильтры по домену, владельцам, тегам, а также карту линейности. Применение: бизнес-аналитик быстро находит таблицу продаж, которая обеспечивает расчет KPI, и видит цепочку трансформаций до финального набора. Преимущества: гибкость, активная экосистема, множество готовых коннекторов; недостатки: необходимость настройки и поддержки инфраструктуры, знания в области DevOps.
- Пример с DataHub или OpenMetadata. Эти проекты поддерживают похожие сценарии: агрегирование технических и бизнес-метаданных, линейность, глоссарий, политика доступа, а также возможности расширенной аналитики по служебной информации и использование собственных индексов для релевантности. В рамках практики они позволяют строить качественные каталоги в организациях с большим числом источников и команд. Практический подход: выстраивание коннекторов к источникам (базы данных, файловые хранилища, трейсы данных), определение бизнес-терминов и лейблов, настройка политики доступа, внедрение процессов обновления метаданных.
2) Практические примеры с учётом российских реалий и рынков
- Реальные задачи российских компаний часто требуют усиления контроля доступа, соблюдения норм по персональным данным и интеграции с отечественными системами безопасности и аутентификации. В таких условиях может применяться открытая архитектура на базе международных open-source решений (Amundsen, OpenMetadata, DataHub) с адаптированными модулями под требования российского регулятора. Например, интеграция с СУБД и хранилищами, где используются отечественные средства аутентификации и авторизации, такие как SSO через SAML/OIDC в рамках государственного или корпоративного SSO, настройка RBAC по ролям сотрудников, делегирование прав на уровне бизнес-облаков и проектов.
- Пример кейса без раскрытия брендов. Крупная российская компания внедряет каталог данных, ориентированный на бизнес-аналитику и разработку. Архитектура включает: несколько источников данных (реляционные базы, Hive/FP-дашборды, файлы в Хранилище), централизованный индекс METADATA, бизнес-глоссарий и набор правил классификации. В рамках проекта реализованы: тазовый набор политики доступа, контекстные страницы активов (описание, владелец, домен), линейность от исходных систем до отчётности. Важными аспектами стали: автоматический сбор технических метаданных через коннекторы, ручное наполнение бизнес-метаданных сотрудниками-«гарантами» качества, настройка событий обновления метаданных и сигналов качества. Результат: ускорение поиска активов, снижение времени на оценку источников данных, улучшение доверия к данным, устойчивость к отказам источников.
- Важная мысль о российском рынке: многие заказчики стремятся к совместной работе над данными в рамках отечественных политик безопасности, поэтому интеграция с локальными средствами аутентификации и аудитом логов является обязательной. Такие проекты чаще опираются на открытые решения, но адаптируются под локальные требования к хранению журналов, архивированию и контролю доступа. Примеры практик включают настройку многоуровневого доступа, преобразование данных о доступе в логи и аудит, использование отечественных сертифицированных решений для шифрования и защиты данных в пути и на диске.
Архитектура и компоненты
- Источники метаданных (data sources) — это базы данных, дата-озера, файлы, BIи аналитические сервисы. На практике источники подключаются через коннекторы или через адаптеры, которые конвертируют их метаданные в единый формат каталога.
- Пользовательский интерфейс (UI) — фронтенд каталога, который обеспечивает поиск, просмотр активов, страницы линейности, глоссарий, страницы политики доступа и страницы управления данными. UI должен поддерживать доступность (WCAG) и быть интуитивно понятным.
- Поисковый движок (search backend) — обеспечивает полнотекстовый поиск и фасетирование. Популярные варианты: Elasticsearch, OpenSearch, Solr. Выбор зависит от требований к масштабируемости, доступности и лицензирования.
- Модуль метаданных и модель данных — хранение описаний активов, связей, версий и истории изменений. Обычно включает схемы активов: набор атрибутов для объектов типа dataset, таблица, файл, дата-объект, сервис и т. д.
- Линейность данных (lineage) — хранение связей между источниками и зависимостями трансформаций. Визуализация линейности помогает понять, как данные проходят путь от источников к конечным представлениям.
- Глоссарий и семантика — набор бизнес-терминов, их определений, взаимосвязей и связей с данными. Глоссарий часто связан с активами данными через теги и понятия.
- Управление доступом и безопасность — реализуется через RBAC/ABAC, интеграцию с каталогами пользователей и поставщиками удостоверений, аудит доступа и криптографическую защиту.
- Пайплайны инференса и обновления метаданных — процессы, которые собирают, нормализуют и обновляют метаданные. Включают регулярные задачи, ETL/ELT-процессы, триггеры по событиям и мониторинг качества.
- Интеграции и коннекторы — модули для подключения к базам данных, дата-озерам, хранилищам файлов и BI-инструментам. Важна поддержка стандартов и возможность расширения.
Как устроен поиск и навигация на уровне практики
- Фасеты и фильтры — позволяют уточнить поиск по домену, источнику, владельцу, уровню чувствительности, дате обновления, языку описания и т. д. Это существенно снижает когнитивную нагрузку и ускоряет поиск.
- Синонимы и обработка естественного языка — внедрение словарей синонимов и поддержка естественных фраз, которые соответствуют запросам пользователей. Это улучшает релевантность и снижает фрустрацию.
- Поиск по линейности — поиск может учитывать не только название и описание, но и путь линейности. Это полезно, когда пользователь ищет данные через несколько шагов трансформаций.
- Карта линейности — визуализация зависимостей между активами, отображение источников, промежуточных стадий и целевых наборов. Это облегчает понимание контекста данных и влияние изменений.
- Автодополнение и подсказки — ускоряют поиск и уменьшают ошибки набора запросов. Подсказки могут указывать на термины в глоссарии, популярные активы и недавно обновленные данные.
- Метаданные как навигационные ориентиры — страницы активов содержат структурированный набор секций: технические метаданные, бизнес-метаданные, линейность, качество, политики доступа, связи с глоссарием и т. д. Это позволяет пользователю быстро понять, что именно за актив.
- Измерение пользовательского опыта — сбор метрик использования каталога: частота обращений к конкретным активам, время поиска, доля удачных находок, доля доступных активов, среднее время на просмотр карточки актива. Аналитика помогает улучшать UX.
Технические детали для внедрения
Инструменты и стек. В зависимости от требований можно выбрать ряд решений:
- Открытые решения: Amundsen, Apache Atlas, DataHub, OpenMetadata. Они дают готовые модули для метаданных, линейности, глоссария и поиска.
- Поиск: Elasticsearch или OpenSearch как движок индексации и полнотекстового поиска.
- Хранение метаданных: PostgreSQL, MySQL или подобные РСУБД для ядра каталога. Для линейности может потребоваться графовая база данных (например, Neo4j в некоторых реализациях) или собственные графовые структуры в рамках решения.
- Интеграционные коннекторы — для подключения к базам данных, дата-озерам, хранилищам и BI-инструментам. Важно обеспечить устойчивость к изменениям схем источников.
- Инструменты оркестрации и мониторинга — Airflow, Dagster или аналогичные системы для планирования сборов метаданных; Prometheus/Grafana для мониторинга.
Архитектура данных каталога
- Источники данных преобразуются в унифицированную модель активов: dataset, таблица, файл, сервис и т. д.
- Индексирование — метаданные индексируются и доступны через поиск, фильтры и релевантный ранжир.
- Линейность — строится карта зависимостей между активами, позволяющая отследить происхождение данных.
- Глоссарий — термины и определения связываются с активами через теги и связи.
- Безопасность — реализуется управление доступом на уровне активов, групп пользователей и ролей, ведется аудит доступа.
Механики ingestion и обновления
- Плановые задачи по сбору метаданных: определение источников, период обновления, обработка изменений.
- Обновления по событиям: реагирование на изменения в СУБД, изменении схем или новых загрузках.
- Верификация и качество метаданных: автоматические проверки на полноту, согласованность, актуальность; механизмы уведомлений в случае нарушений.
Примеры конфигураций и интеграций
- Коннектор к реляционной БД через JDBC — сбор таблиц, столбцов, типов и комментариев.
- Коннектор к дата-озеру — получение информации о структурах файлов, партициях, форматах.
- Интеграция с BI-инструментами — извлечение связей между источниками отчетности и наборов данных, которые они используют.
- Интеграция с системой безопасности — связь с учетной записью пользователя, роли, отслеживание действий и аудит.
Пример концептуального сценария поиска
- Пользователь ищет набор данных для анализа продаж за последние 3 месяца.
- В категориях активов он выбирает домен Финансы и формат данных: tabular, с фильтром по обновлению.
- Система возвращает список таблиц, связанных с доменом Финансы, и предлагает просмотр линейности, чтобы понять, какие процессы преобразуют данные.
- Пользователь открывает карточку актива, читает бизнес-описание, смотрит владельца и группу доступа, проверяет качество данных и совместимость с фильтрами.
- Если актив не подходит, пользователь может перейти к похожим активам через связанные термины в глоссарии или через теги.
Риски и ограничения
- Качество и актуальность метаданных — если сбор и обновление метаданных не автоматизированы или требуют слишком много ручной работы, catalogue быстро теряет доверие пользователей. В результате поиск может возвращать устаревшие или неверные данные.
- Проблемы доступа и безопасности — неправильная настройка RBAC/ABAC может привести к утечкам или несанкционированному доступу к чувствительным данным. Важно обеспечить надлежащее управление доступом, аудит и соответствие требованиям.
- Масштабируемость и производительность — при большом количестве источников и активов поисковая система может стать узким местом. Нужно продумать шардирование, кеширование и эффективную индексацию.
- Согласованность терминологии — без единого бизнес-глоссария формируются расхождения в терминах. Это снижает уверенность пользователей и ухудшает качество поиска.
- Интеграции и совместимость — конфликт версий коннекторов и обновлений может привести к падению обновлений метаданных. Важно планировать версионирование и совместимость модулей.
- Стоимость владения — внедрение каталога требует ресурсов: инфраструктура, поддержка, обновления, обучение сотрудников. Необходимо заранее планировать бюджет и окупаемость.
- Соответствие и регуляторика — особенно в российской среде есть требования по хранению персональных данных и аудиту. Необходимо проектировать каталог так, чтобы соблюдались все нормы и регламенты.
- Пользовательский опыт и обучение — если UX слишком сложный или не интуитивный, сотрудники будут обходить каталог, что снижает его полезность. Нужны тренинги и понятная документация.
- Зависимость от инфраструктуры — каталог может стать критичным сервисом; выход из строя поиска или индексации сказывается на многих командах. Необходимо резервирование и план восстановления.
- Долгосрочная поддержка и эволюция — технологии и источники данных меняются. Важно поддерживать архитектуру, чтобы она оставалась совместимой и полезной в будущем.
Поиск, навигация и UX каталога данных — это не просто техническая задача по индексации метаданных. Это комплексное направление, где успех зависит от тесной взаимосвязи между данными, контекстом и пользователями. Важны единая терминология и понятная бизнес-логика, качественные и обновляемые метаданные, продуманная архитектура поиска и навигации, а также эффективная интеграция с существующими процессами и системами в компании. При правильном подходе каталог становится мощным инструментом для повышения производительности, улучшения качества данных и соблюдения регламентов. Он упрощает доступ к данным, ускоряет исследования и анализ, а значит — поддерживает принятие обоснованных решений и развитие цифровой культуры в организации.
FAQ — Вопросы и ответы
1) Что такое данные в каталоге и зачем нужен бизнес-глоссарий?
Ответ: Данные в каталоге представляют собой совокупность активов — наборов данных, таблиц, файлов и сервисов, а также их описание и контекст. Бизнес-глоссарий добавляет единое определение терминам, помогающим бизнес-пользователям понимать, что именно означает каждый актив, какие цели он служит и кто отвечает за него. Глоссарий снижает двусмысленность и улучшает качество поиска.
2) Какие ключевые элементы UX важны для поиска в каталоге?
Ответ: Важны удобство поиска, релевантность результатов, фасеты и фильтры, автодополнение, ясная карточка актива с контекстной информацией (владельцы, домен, политика доступа, линейность, качество), карта линейности и возможность сохранять запросы. Хороший UX предполагает последовательную навигацию и возможность быстро переходить от поиска к контекстной информации и к действиям (например, запрос доступа или просмотр линейности).
3) Какой стек технологий можно использовать для открытой реализации каталога?
Ответ: Типичный стек включает: открытые каталоги (Amundsen, DataHub, OpenMetadata или Apache Atlas), поисковый движок (Elasticsearch или OpenSearch), хранилище метаданных (PostgreSQL/MySQL), коннекторы к источникам данных, инструменты оркестрации (Airflow или Dagster) и, при необходимости, графовую базу данных для линейности (например, Neo4j). Важно, чтобы стек позволял легко расширяться и поддерживался на рынке.
4) Какие практики помогают поддерживать актуальность метаданных?
Ответ: Автоматическая сборка метаданных через коннекторы к источникам, события об изменениях в источниках (если поддерживаются), периодическое обновление и верификация качества данных, а также ручное пополнение бизнес-метаданных через ответственных за активы. Важно выстроить процесс управления изменениями и иметь видимую историю обновлений.
5) Какие есть типичные риски и как их снижать?
Ответ: Основные риски — устаревшие или неполные метаданные, нарушение доступа к данным, проблемы с масштабируемостью и стоимостью владения. Их снижают путем автоматизации сбора метаданных, внедрения строгой политики доступа и аудита, продуманной архитектурой для масштабирования, мониторингом производительности и обучением пользователей.
6) Как интегрировать каталог с российскими требованиями по безопасности и регуляторике?
Ответ: Важно обеспечить интеграцию с отечественными системами аутентификации и управления доступом, использовать подходящие средства защиты данных и журналирования, соблюдать требования к хранению и аудитам, а также предусмотреть хранение критичных данных в рамках отечественных инфраструктур. Архитектура должна поддерживать RBAC/ABAC и возможность аудита действий пользователей.
7) Какие метрики полезно отслеживать для оценки эффективности каталога?
Ответ: Важны метрики использования и удовлетворенности: доля активов с полной и актуальной документацией, частота посещений активов, среднее время на поиск, доля успешных находок, скорость обновления метаданных, количество запросов на доступ и среднее время их обработки, а также качество данных (процент активов с высокой степенью доверия).
8) Как начать внедрение каталога, если компания только начинает цифровую трансформацию?
Ответ: Начните с определения минимально жизнеспособного набора активов и бизнес-глоссария, выбирайте открытое решение, которое можно быстро развернуть, настройте базовые политики доступа и базовую навигацию, автоматизируйте сбор метаданных для нескольких критичных источников данных, пробуйте поиск на реальных задачах пользователей и собирайте обратную связь для последующих итераций.
9) В чем разница между search-first и navigation-first подходами в UX каталога?
Ответ: Search-first фокусируется на быстрых текстовых запросах и релевантности результатов. Navigation-first предпочитает организованную иерархическую навигацию и фильтры, позволяя пользователю исследовать данные через контекст и домены. В идеальном случае применяется гибридный подход: пользователи могут быстро найти активы через поиск и одновременно исследовать связанные активы через структурированную навигацию и линейность.
10) Какие шаги помогут обеспечить устойчивость каталога на долгий срок?
Ответ: Разработайте архитектуру, которая поддерживает масштабирование; автоматизируйте сбор и обновление метаданных; внедрите единый глоссарий и политики доступа; обеспечьте мониторинг и алерты по качеству и доступности; проводите регулярные обучающие сессии для пользователей; проводите ревью терминов и обновления линейности. Важно держать документацию по архитектуре и процессам в актуальном состоянии и планировать периодические обновления в рамках дорожной карты.


