

Интеграция данных: ETL и ELT конвейеры
Интеграция данных является основой любой зоны BI и DWH при внедрении Customer Data Platform (CDP). В этом разделе мы сосредоточимся на ETL и ELT конвейерах как на практических и теоретических инструментах, которые позволяют собрать разрозненные источники данных, привести их к единому стандарту и передать в аналитическую среду, пригодную для сегментации клиентов, персональных рекомендаций и многоканальной коммуникации. Вы научитесь различать ETL и ELT подходы, выбирать подходящие архитектуры под задачи CDP, понимать типы источников, преобразований и целевых хранилищ, а также оценивать риски и ограничения внедрения.
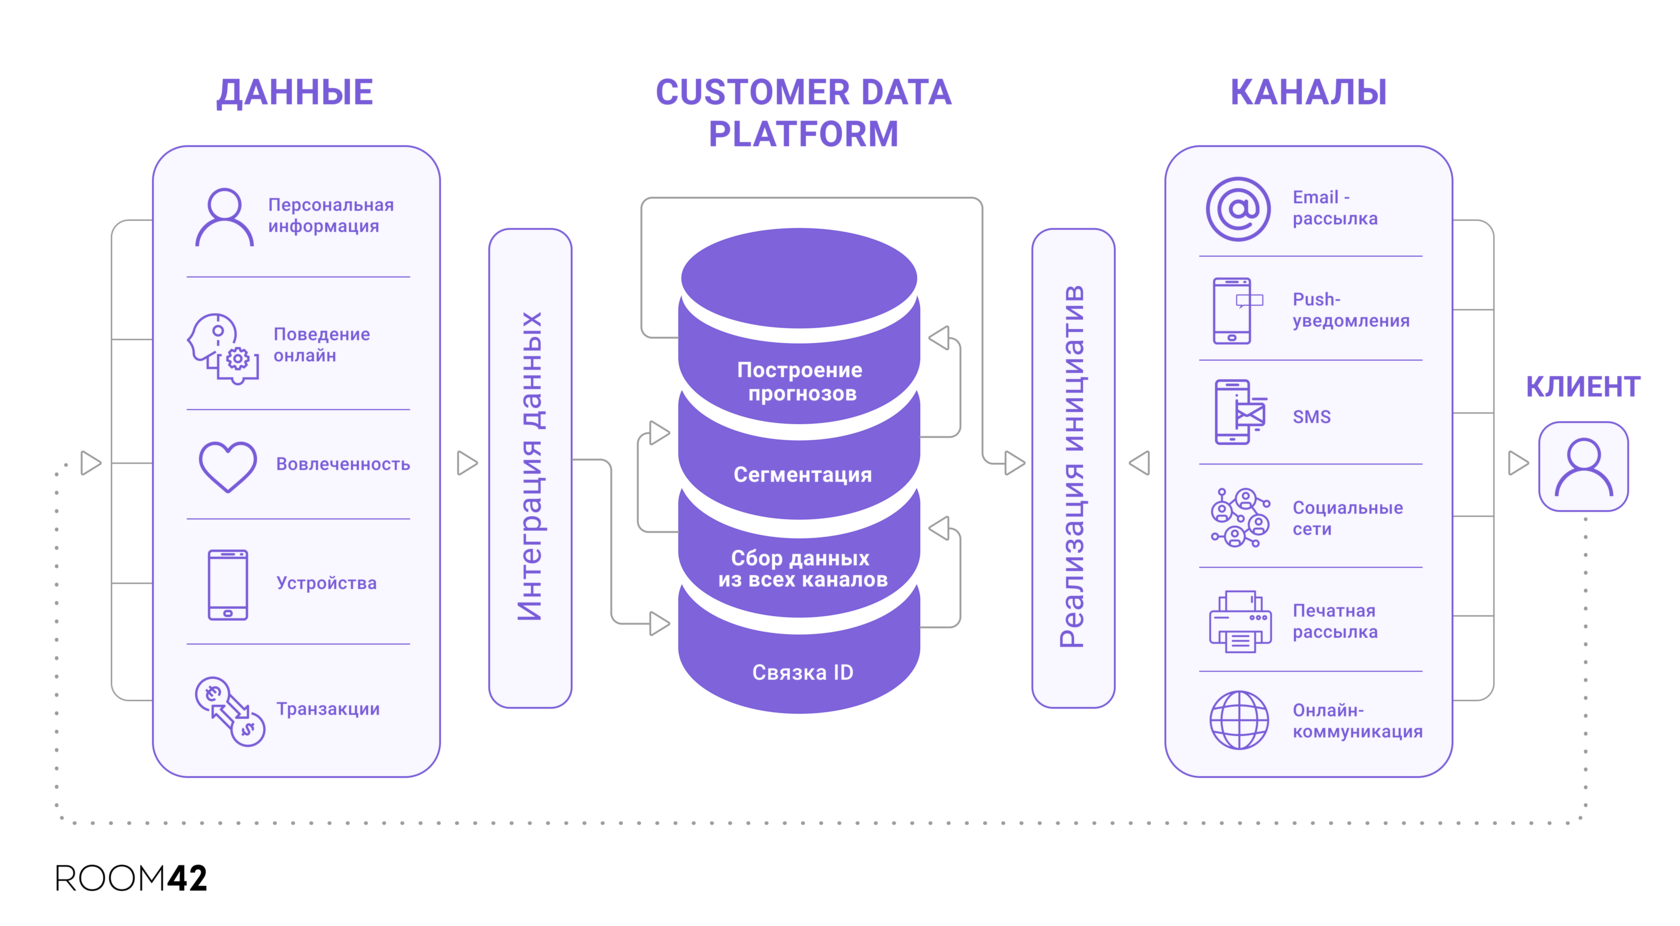
Что такое ETL и ELT
- ETL (Extract-Transform-Load) — процесс, при котором данные извлекаются из источников, проходят преобразование в промежуточной области до загрузки в целевое хранилище и затем загружаются в него уже в преобразованном виде. Преобразование чаще всего выполняется на отдельном этапе в ETL-сервере или локальной инфраструктуре.
- ELT (Extract-Load-Transform) — подход, при котором данные сначала извлекаются и загружаются в целевое хранилище, а затем преобразуются внутри самого хранилища. Этот подход становится особенно эффективным при использовании современных колоночных хранилищ и мощных механизмов обработки внутри них (например, в ClickHouse, Snowflake, BigQuery или аналитических степпах на Spark).
Различия и когда что использовать
- В условиях CDP, когда требуется оперативная идентификация покупателей, построение единого профиля и поддержка реального времени, ELT часто выглядит предпочтительнее: загрузка в хранилище с минимальной задержкой и последующая трансформация внутри хранилища позволяет быстрее обновлять аналитические и сегментные модели.
- В случаях сложной предобработки, строгой очистки источников или слабой производительности хранилища может оказаться целесообразнее применить ETL: трансформации выполняются заранее, чтобы снизить нагрузку на целевую БД и упростить логику контроля качества данных.
Ключевые концепты
- Источники данных: CRM/ERP-системы (1С, Bitrix24), веб-сайты и мобильные приложения, логи событий, файлы CSV/Parquet, внешние API.
- Staging и Core хранилища: staging-слой служит буфером, где данные нормализуются и валидируются; основное хранилище (DWH) — ClickHouse, PostgreSQL, Snowflake, BigQuery и т. п.
- Data lake и data marts: лендинговый слой (независимый от DWH) может быть использован для сырых данных, тогда как data marts — поддомены, концентрирующиеся на конкретных доменах (клиенты, продажи, продукты).
- Архитектуры обработки: пакетная обработка (batch), потоковая обработка (streaming) и гибридные модели.
- Обеспечение качества данных: валидаторы, проверки на полноту, согласованность, уникальность, контроль дубликатов.
- Управление данными и безопасность: политика доступа, контроль PII, маскирование, шифрование, аудит, соответствие требованиям локального законодательства (включая локализацию персональных данных).
- Инструменты и методологии трансформации: dbt для ELT-подхода внутри хранилища; схемы «звезда»/«снежинка» для моделирования; управление версиями схем и тестированием моделей.
Методологии проектирования ETL/ELT конвейеров
- Разделение зон ответственности: источники → префильтрация и валидация → сферы хранения → transformed данные → потребители. Этот принцип помогает снизить риск ошибок и облегчает сопровождение.
- Idempotentность и повторяемость: конвейеры должны быть устойчивыми к повторным запускам и дубликатам данных; применяются паттерны upsert, последовательно применяемые изменения, контроль версий записей.
- Управление схемами и эволюцией: поддержка схематических изменений без сбоев в работе конвейера; использование схем-реестра и тестирования на миграционные изменения.
- Мониторинг и наблюдаемость: сбор метрик скорости, задержек, количества записей, ошибок; алертинг и dashboards для прозрачности процессов.
- Гигиена данных и соответствие требованиям: очистка, минимизация хранения данных PII, маскирование и разграничение доступа; аудит происхождения данных.
Практические примеры и сценарии применения
- Базовый ETL-поток для CDP: источники — CRM (1С), веб-приложение, ERP; префильтрация и нормализация — staging в PostgreSQL; загрузка в аналитическое хранилище на базе ClickHouse; периодические обновления и контроль целостности. Преобразование выполняется в конвейере ETL до загрузки или внутри ClickHouse в ELT-моделях.
- ELT-поток с dbt: данные сначала загружаются в ClickHouse, затем dbt выполняет трансформации, объединения и расчеты (скрытые вычисления, агрегации, создание мер и представлений). Такой подход хорошо сочетается с современной колоночной архитектурой и быстрыми запросами.
- Потоковая интеграция: изменение клиентов в PostgreSQL передается через Debezium в Kafka; далее обработчик Spark Structured Streaming или Flink осуществляет трансформацию и запись в ClickHouse в реальном времени. Это позволяет поддерживать обновления профиля клиента и сегментов в режиме near real-time.
- Комбинированный подход: пакетные загрузки для исторических данных и потоковые обновления для активных событий, что обеспечивает баланс между полнотой данных и задержкой.
Практические примеры (open-source и российские решения)
Open-source примеры:
- Apache Airflow: оркестрация ETL/ELT конвейеров, планирование задач, мониторинг и ведение журналов. В рамках CDP Airflow может координировать сбор данных из разных источников, запуск Python-скриптов для трансформаций и отправку результатов в хранилища.
- Apache NiFi: сбор, маршрутизация и преобразование данных в реальном времени и пакетно, удобен для потоков данных из CSV, JSON, обрывочных файлов и API.
- Apache Kafka: потоковая обработка событий и интеграция между сервисами; Debezium для захвата изменений из СУБД.
- dbt (data build tool): важный инструмент для ELT-трансформаций внутри хранилища; позволяет писать тесты, версии моделей и управлять зависимостями трансформаций.
- Airbyte: набор готовых коннекторов для источников и приемников, упрощает создание повторяемых и масштабируемых конвейеров.
- ClickHouse: открытое высокопроизводительное OLAP-хранилище. Часто используется как целевое хранилище в CDP-проектах, поддерживает быстрое агрегирование и анализ больших объемов данных.
Российские и локальные решения/контекст:
- 1С: популярная в РФ ERP/CRM-система с экспортом данных и интеграционными возможностями в локальной инфраструктуре. В контексте CDP данные из 1С часто консолидируются вместе с данными из других систем.
- Яндекс.Облако и локальные решения на базе отечественных СУБД: ClickHouse широко используется в российской практике в рамках CDP-проектов (декларируемо как открытое и мощное решение для аналитических нагрузок). В сочетании с инструментами Airflow, NiFi и dbt можно строить устойчивые конвейеры загрузки и трансформации.
- Примеры архитектуры: сбор данных из 1С и веб-источников, загрузка в ClickHouse, использование dbt для трансформаций и построения профилей клиентов; рядом размещаются данные из телеметрии и маркетинговых источников, все это является единым источником истины для аналитики и персонализации.
Архитектура конвейера
- Источники данных: CRM, ERP, веб-аналитика, мобильные приложения, файлы, API партнёров.
- Staging/landing: чистый слой, donde приводят данные к общему формату (универсальные поля, единые типы данных, конвертация кодировок, идентичности).
- Core-хранилище: OLAP- или OLTP-решение в зависимости от задачи; в CDP чаще встречается OLAP-ориентированное хранилище, например ClickHouse, плюс иногда вспомогательные SQL-базы.
- Data marts и профили клиентов: доменные слой, где создаются сегменты, источники реальных данных и возрастной анализа.
- Целевые сервисы CDP: сегментация, персонализация, сегментные каталоги, предиктивные модели, синхронизация с маркетинговыми каналами.
Инструменты и роли
- Оркестрация: Apache Airflow управляет задачами, зависимостями, расписанием и мониторингом.
- Потоковая интеграция: Apache Kafka как транспорт данных; выбор между Kafka Streams, Spark Streaming или Flink для обработки потоков.
- Преобразование: dbt как основной инструмент трансформаций внутри хранилища; также можно использовать Spark SQL или SQL-оболочки внутри ClickHouse для более сложных преобразований.
- Коннекторы: Airbyte или Singer для быстрого подключения к источникам и приемникам; ручная разработка коннекторов возможна для специфических российских систем (1С, локальные API).
- Хранилище: ClickHouse как основной источник аналитических запросов; PostgreSQL для операционных нужд или как промежуточное хранилище; иногда используется Snowflake/BigQuery в гибридных сценариях.
Стратегии ETL и ELT
- ETL-подход: предобработка данных в отдельном ETL-сервисе (Python, Java) перед загрузкой в целевое хранилище. Подходит, когда источники сложны, а хранилище ограничено по мощности или нужно обеспечить высокую консистентность еще до загрузки.
- ELT-подход: загружаются сырые данные, а затем выполняются трансформации внутри хранилища; выгодно для больших объемов и высоких скоростей загрузки, а также когда хранилище достаточно мощное для обработки сложных запросов.
- Гибрид: пакетная загрузка исторических данных + потоковые обновления для активных данных; уменьшает задержку обновлений и поддерживает полноту данных за период.
Управление качеством и версиями данных
- Валидаторы и тесты: Great Expectations или аналогичные решения для проверки схем, полноты, точности и соблюдения бизнес-правил.
- Эволюция схем: версия схемы и миграции, автоматические тесты на регрессию после изменений.
- Логирование и наблюдаемость: ведение журналов загрузок, ошибок и времени выполнения; построение дашбордов по SLA и качеству данных.
Безопасность и соблюдение
- Защита данных: шифрование в транзите и на диске, управление ключами, безопасные секреты для доступа к коннекторам и сервисам.
- Управление доступом: ролевая модель доступа, сегментация по данным (PII/персональные данные), маскирование данных на этапе вывода для аналитиков.
- Соответствие требованиям: локализация персональных данных, хранение данных в нужной юрисдикции; контроль доступа к данным CDP и журналам.
Практические рекомендации по реализации
- Начать с небольшого набора источников и целевого хранилища; постепенно расширять конвейеры.
- Предпочитать ELT внутри мощного хранилища; использовать dbt для управляемых и тестируемых трансформаций.
- Внедрять мониторинг и алертинг на ранних стадиях; документировать конвейеры и зависимые сервисы.
- Использовать готовые коннекторы там, где возможно; для специфических российских систем — реализовать кастомные коннекторы через REST API или файловые обмены.
- Планировать миграции и отказоустойчивость: резервное копирование, повторяемость загрузок, тестирование восстановления.
Риски и ограничения внедрения
- Сложность архитектуры: ETL/ELT конвейеры требуют грамотного проектирования, документирования и поддержки. Неправильно подобранная архитектура может привести к задержкам, деградации качества данных и дорогим ремонтным работам.
- Задержки и латентность: пакетные конвейеры могут давать задержку вплоть до часов; потоковые решения уменьшают задержку, но требуют более сложной инфраструктуры и мониторинга.
- Стоимость и масштабируемость: хранение больших объемов сырых данных и выполнение трансформаций требует вычислительных ресурсов; неправильный выбор хранилища и конвейеров может привести к росту расходов.
- Совместимость источников: у разных систем различаются форматы и схемы; миграции часто требуют согласованных бизнес-правил и поддержки версий.
- Безопасность и приватность: хранение и обработка персональных данных (PII) должны соответствовать требованиям закона и локальным регуляциям; трудно обеспечить надлежащую маскирование и контроль доступа.
- Зависимость от инфраструктуры: локальные решения (серверы, сети) подвержены сбоям; облачные решения требуют уверенности в доступности и региональной локализации.
- Навыки и компетенции: сотрудники должны обладать знаниями по ETL/ELT, SQL, Python/Scala, системам управления данными и инструментам вроде Airflow, Kafka и dbt; нехватка специалистов может замедлить внедрение и сопровождение.
- Эволюция источников и схем: источники меняются, новые поля добавляются, старые исчезают; необходимо поддерживать совместимость и проводить регрессионное тестирование.
- Управление качеством данных: без устойчивых процессов качества данных конвейеры будут «забирать» плохие данные, что приведет к неверной аналитике и ошибкам в персонализации CDP.
Интеграция данных через ETL и ELT конвейеры — это не просто техническое решение, а комплексная дисциплина, где архитектура, выбор инструментов, подход к качеству данных и соблюдение регуляторных требований тесно взаимосвязаны. В CDP ETL и ELT обеспечивают единый источник истины по профилям клиентов, позволяют сегментировать аудитории и персонализировать коммуникацию на множестве каналов. Опробованные открытые инструменты (Airflow, NiFi, Kafka, dbt, Airbyte) в сочетании с мощными хранилищами (ClickHouse, PostgreSQL) и, при необходимости, российскими решениями позволяют построить устойчивый, масштабируемый и безопасный конвейер данных. Важно помнить о постоянном мониторинге, обеспечении качества данных и соблюдении правил приватности, чтобы конвейеры приносили ценность бизнесу и не создавали рисков.
Вопрос–Ответ (FAQ)
Что такое основное отличие ETL от ELT в контексте CDP?
ETL выполняет трансформации перед загрузкой в хранилище, что полезно, если нужно минимизировать нагрузку на хранилище и обеспечить чистые данные до загрузки. ELT загружает сырые данные в хранилище и выполняет трансформации внутри него, что более эффективно для масштабирования и использования мощностей современных хранилищ, часто вместе с dbt для управления моделями и тестами.
Какие источники данных чаще всего интегрируются в CDP в рамках ETL/ELT конвейеров?
Клиентские данные из CRM/ERP (например 1С), веб-аналитика, мобильные приложения, файловые экспорты, API внешних систем и маркетинговые источники; также логи и события из веб-сайтов и приложений.
Какие инструменты лучше начать использовать для начинающего проекта CDP?
Для оркестрации — Apache Airflow; для потоковой интеграции — Apache Kafka; для коннекторов — Airbyte; для трансформаций — dbt; для хранилища — ClickHouse (плюс PostgreSQL для операционных целей). Это сочетание позволяет быстро собрать рабочий конвейер и постепенно расширять функциональность.
Как выбрать между Open Source и российскими решениями?
В большинстве случаев разумно начать с открытых инструментов (Airflow, NiFi, Kafka, dbt, ClickHouse) в связке с локальными сервисами и облачными платформами; российские решения применимы, когда есть требования к локализации данных, совместимости с 1С или особые регуляторные требования. ClickHouse имеет русское происхождение и широко применяется в РФ, что упрощает локальную поддержку.
Какие риски стоит учесть при внедрении ETL/ELT для CDP?
Сложность архитектуры, латентность, стоимость, несовместимость источников, безопасность данных, соблюдение регуляторных требований, нехватка квалифицированных специалистов и изменения в схемах источников. Важно заранее планировать мониторинг, тесты и миграционные процессы.
Что такое data lineage и зачем он нужен в CDP?
Data lineage — это прослеживаемость происхождения данных: от источника до конечной модели и потребителя. Он нужен для прозрачности процессов, аудита, управления качеством и упрощения отладки ошибок, особенно в условиях персональных данных и регуляторных требований.
Какие примеры трансформаций часто реализуют в dbt для CDP?
Аггрегации по сегментам клиентов, расчеты метрик (CLV, конверсия, частота покупок), создание представлений для профилей клиентов и устойчивых наборов атрибутов, проверка правил качества, управление версиями моделей и тестами на регрессию.
Как обеспечить соответствие требованиям локального законодательства к персональным данным в ETL/ELT конвейерах?
Внедрять маскирование чувствительных данных, разграничение доступа по ролям, шифрование данных в транзите и на диске, локализацию данных в нужной юрисдикции, аудит доступа и журналирования, а также проводить периодическую проверку процессов обработки ПД.
Что такое streaming-подход и когда он нужен в CDP? Streaming-подход обрабатывает данные в реальном времени или почти в реальном времени. Он нужен, когда требуется оперативная сегментация и персонализация, реактивные уведомления, сигналы на события и минимальные задержки обновления профилей клиентов.
Какие шаги помогают снизить риск при внедрении ETL/ELT для CDP? Начать с малого набора источников и целевого хранилища, выбрать устойчивые конвейеры, внедрить мониторинг и алертинг, тестирование моделей и миграций, а также пошагово расширять архитектуру, поддерживая документированную стратегию управления изменениями и качеством данных.


