

Основы Customer Lifetime Value: концепции и формулы
Customer Lifetime Value (CLTV) — это сумма чистой прибыли, которую бизнес может ожидать получить от каждого клиента на протяжении всего срока взаимодействия. В контексте курса по использованию BI и DWH для расчета CLTV CLTV становится не просто цифрой в отчётах, а ключевым параметром для бюджетирования маркетинга, планирования ассортимента, определения эффективности программ лояльности и точной сегментации. Задача инженерной команды и бизнес-аналитиков состоит в том, чтобы собрать из разрозненных источников данные о клиентах, продажах, марже, взаимодействиях и каналах, привести их к единой модели и выдать понятные, воспроизводимые расчёты CLTV для разных сегментов. В этом разделе мы рассмотрим базовую теорию, термины и формулы, затем — практические примеры расчётов и существующие методологии, которые применяются в современных BI-проектах. Мы также обсудим, как сочетать простые и сложные подходы, когда применимы машинное обучение и когда достаточно аналитических формул, какие данные потребуются и как обезопасить процесс от ошибок и рисков.
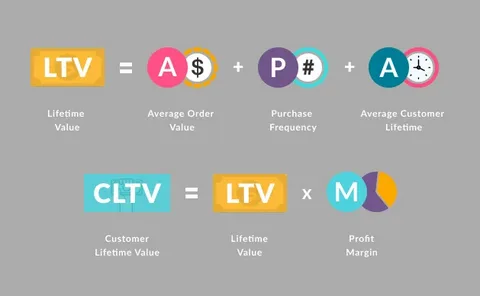
Ключевые термины и концепции
- CLTV (Customer Lifetime Value) — валовая или чистая ценность клиента на протяжении всего времени отношений; в зависимости от формулы это может означать валовую выручку, маржу или прибыль.
- АOV (Average Order Value) — средняя стоимость заказа.
- F (Purchase Frequency) — частота покупок; количество заказов в периоде на одного клиента.
- L (Lifetime) — ожидаемое время жизни клиента в периодах (месяцах, кварталах и пр.).
- GM (Gross Margin) — валовая маржа как доля выручки после затрат на товары, часто выражается в процентах.
- Retention rate (уровень удержания) и churn — доля клиентов, остающихся активными в течение периода; churn — доля ушедших клиентов.
- Discount rate (d) — ставка дисконтирования, учитывающая временную стоимость денег.
- RFM-анализ — метод сегментации по Recency (давность последней покупки), Frequency (частота), Monetary value (сумма покупок).
- Cohort analysis — анализ по группам клиентов, которые начали покупки в один и тот же период, для отслеживания поведения во времени.
- Методы моделирования: простая формула CLTV, дисконтированная денежная величина (DCF), модели BG/NBD и Pareto/NBD для оценивания частоты покупок, модели монетной стоимости (Gamma-Gamma) для оценки величины заказа, survival-анализ и ML-модели для прогноза будущих расходов.
Классические формулы CLTV
Простая формула CLTV без дисконтирования:
CLTV = GM × AOV × F × L
где GM — маржа в доле, AOV — средний размер заказа, F — частота покупок, L — ожидаемая длительность отношений с клиентом в периодах. Пример: GM = 0.6 (60%), AOV = 50 , F = 2 заказа в месяц, L = 6 месяцев → CLTV ≈ 0.6 × 50 × 2 × 6 = 360. Эта формула хорошо работает при стабильном поведении клиентов и ограниченном горизонте времени.
Дисконтированная формула CLTV (DCF-версия):
CLTV_disc = Σ_{t=0}^{L-1} [ Revenue_t × GM ] / (1 + d)^tRevenue_t — выручка в период t; d — дисконтирование. Этот подход учитывает временную стоимость денег и сезонность; применяется в более зрелых бизнес-моделях, где важна точная финансовая корректировка по времени.
Модель с постоянной базовой выручкой на период и постоянным удержанием:
CLTV = (R × GM) / (1 − r)
R — выручка на клиента в период; r — коэффициент удержания (retention) в этот же период. Эта формула часто встречается в аналитических публикациях и применяется для быстрого набора инкрементальных CLTV.
Модели частоты и монетарной стоимости (Pareto/NBD, BG/NBD, Gamma-Gamma) Эти модели используют поведение клиентов на уровне повторных покупок и сумму заказов, чтобы forecast будущую активность и среднюю денежную ценность. Они особенно полезны, когда данные охватывают длительный период и демонстрируют изменение поведения клиентов со временем. BG/NBD моделирует частоту покупок, Pareto/NBD — совместно с параметрами сцепляет вероятность оставления клиента, а Gamma-Gamma — монетарную стоимость заказов для сохранения разброса величины заказов.
Методы расчета и выбор подхода
- Простой подход: подходит на старте проекта, когда нет достаточного объема данных для сложных моделей. В этом случае применяют CLTV по формуле GM × AOV × F × L с простыми оценками F, L и GM.
- Коортный подход (cohort): строят CLTV по группам клиентов, входивших в один момент времени (месяц регистрации). Это позволяет учитывать сезонность и изменение поведения во времени.
- Модели частоты и монетарной стоимости: Pareto/NBD и BG/NBD применяются, когда есть данные по дате первой и последней покупки и количества заказов. Они дают более точные оценки L и F по каждому клиенту.
- Модели монетарной стоимости (Gamma-Gamma): применяются, когда нужно оценить монетарность заказов независимо от частоты.
- Машинное обучение: регрессионные и кластеризационные подходы для прогнозирования будущих расходов, вероятности повторной покупки и возможного ухода; например, модели на основе логистической регрессии для churn или градиентного бустинга для прогноза LTV на клиента.
- Мониториинг и валидация: важно регулярно валидировать модели на актуальных данных, использовать кросс-валидацию по временному разрезу и оценку точности прогнозов (MAE, RMSE, R^2, продажная валидность).
Сценарий и данные
- Бизнес-сценарий: онлайн-ритейлер с 1–2 млн клиентов в год, 20–30 тыс. заказов в день; маржа по товарам варьируется, но в среднем GM = 0.6.
- Данные: таблица заказов (order_id, customer_id, order_date, total_amount, product_category), таблица клиентов (customer_id, segment, signup_date, region), таблица товаров (product_id, category, price). Источник данных — OLTP база; данные должны быть выгружены в OLAP-хранилище (DWH) для анализа.
Пример архитектуры данных
- Источник данных: PostgreSQL или другой OLTP-БД.
- Этап ETL/ELT: Apache Airflow или Dagster для планирования и оркестрации; dbt для трансформаций и тестирования моделей.
- Хранилище: ClickHouse или PostgreSQL/TimescaleDB для аналитических запросов; ClickHouse чаще выбирается для больших объемов и быстрого аггрегирования.
- Моделирование и прогнозирование: Python с libraries lifetimes, lifelines, scikit-learn; R с пакетами для survival-анализов; Prophet для сезонных трендов.
- Визуализация: Metabase или Apache Superset (open-source), Russian-ориентированная платформа — Яндекс DataLens (для dashboards) в связке с Яндекс Облако, DataLens может подменять часть BI-потребностей в рамках российского стека.
- Контроль доступа и безопасность: интеграция с LDAP/AD, локализация данных, аудит и шифрование.
Кейс 1: простой CLTV на основе SQL и открытого стека
- Вычисление AOV и F по клиентам
- AOV_i = SUM(order_value_i) / COUNT(order_i)
- F_i = COUNT(order_i) per клиент
- Прикидка L через удержание
- retention_i = proportion of customers who сделали хотя бы еще одну покупку после первого заказа
- L_i приблизительно = 1 / (1 - retention_i) — это упрощенная оценка срока жизни клиента.
- Рассчёт CLTV без дисконтирования
- CLTV_i = GM × AOV_i × F_i × L_i
- Пример расчета для выборки клиентов:
- GM = 0.6
- Клиент A: AOV = 45, F = 3, retention = 0.5 → L ≈ 1 / (1 - 0.5) = 2 → CLTV ≈ 0.6 × 45 × 3 × 2 = 162
- Клиент B: AOV = 60, F = 1, retention = 0.2 → L ≈ 1 / 0.8 = 1.25 → CLTV ≈ 0.6 × 60 × 1 × 1.25 = 45
- Расчет с дисконтированием
- Revenue_t = AOV × F (на период t)
- CLTV_disc_i = Σ_t Revenue_t × GM / (1 + d)^t, например d = 0.05 (5% годовых, если период — год)
Это позволяет сравнивать клиентов с учётом временной стоимости денег.
Кейс 2: Pareto/NBD и Gamma-Gamma в рамках PyData
- Собираем историю покупок клиентов: date_of_first_purchase, frequency, monetary_value
- Применяем модель BG/NBD для прогнозирования частоты покупок и Pareto/NBD для удержания
- Gamma-Gamma — для оценки монетарной стоимости заказов
- Итог: CLTV для каждого клиента рассчитывается как ожидаемая выручка на период X, умноженная на GM и дисконтированная по времени
- Инструменты: lifetimes (Python), pandas, SQL (для извлечения и агрегаций)
Практические примеры: сравнительный взгляд
- Open-source стек: PostgreSQL + Airflow + dbt + ClickHouse + Metabase Преимущества: гибкость, прозрачность, широкое сообщество, локальная обработка данных. Применение: сбор данных, расчёты на уровне источников, создание агрегатов, визуализация CLTV по сегментам.
- Российские решения: ClickHouse + Яндекс DataLens + Яндекс.Облако Преимущества: высокая производительность, локализация данных, удобные дашборды на русском рынке, поддержка государственного/регуляторного сектора, готовые коннекторы к Яндекс.Облако. Применение: быстрые запросы к CLTV-агрегатам, оперативные дашборды по сегментам, интеграция с Yandex.Cloud Data Proc для ML-обработки и автогенерации прогнозов CLTV.
Архитектура данных и модель данных
Рекомендованная модель данных — звездная схема:
- Факт_Продажи (customer_id, order_id, order_date, amount, gross_margin, channel)
- Дим_Клиент (customer_id, segment, region, signup_date, age, gender)
- Дим_Дата (date_id, day, month, quarter, year)
- Дим_Товар (product_id, category, price) Расчёты CLTV следует размещать в OLAP-слое, чтобы аналитики могли выполнять запросы по нужным сегментам. В ClickHouse можно создавать materialized views для частых аггрегаций CLTV по дате, сегменту и каналу.
ETL и трансформации
- Источник данных: OLTP база (PostgreSQL, MySQL), ERP (1С), CRM-системы.
- ETL/ELT: Airflow для планирования DAG-ов, Extraction из OLTP, трансформации в DWH через dbt, выгрузка в аналитические таблицы.
- Правки моделей: версионирование схем, тестирование (unit tests) на ключевых финзапросах, валидность сумм и бизнес-правил.
Хранилище и производительность
- ClickHouse как аналитическая база для больших данных: быстрые агрегации по сегментам, временным окнам, сезонности.
- PostgreSQL/TimescaleDB для исторических данным и меньших нагрузок.
- Оптимизация: партиционирование по месяцам, индексы по customer_id и order_date, денормализация частых агрегаций в Materialized Views, кэширование на слоях бизнес-логики.
Визуализация и операционная отдача
- Методы визуализации: Metabase или Grafana для аналитики CLTV; DataLens для русскоязычных пользователей и dashboards в Яндекс.Облаке.
- Визуализация CLTV по сегментам: по регионам, каналам привлечения, типам товаров; сравнение текущего CLTV с целями CAC (стоимость привлечения клиента) и ROAS (возврат на рекламные вложения).
Риски и ограничения внедрения
- Качество и полнота данных: расходные данные могут быть неполными или дублированными; необходимо проводить очистку и дедупликацию.
- Выбор метода: простая формула CLTV пригодна на старте, но может давать искаженные результаты в условиях сезонности, изменений в поведении клиентов и различных каналов.
- Модельный риск: внедряемые ML/статистические модели требуют достаточного объема данных; переобучение на исторических данных может не отражать будущую динамику (дрейф в поведении).
- Временная стоимость денег и дисконтирование: выбор дисконтной ставки влияет на итоговые цифры; нужно согласовать методологию с финансовой службой.
- Регуляторные и правовые риски: обработка персональных данных, локализация и хранение в рамках национального законодательства; соблюдение GDPR и локальных требований в России.
- Инфраструктура и ресурсы: вычислительная нагрузка на DWH, хранение больших массивов данных, обслуживание ETL-пайплайнов.
- Выбор инструментов: open-source Stack требует квалификации команды, документирования и контроля версий; российские решения требуют адаптации к локальным требованиям и интеграции с отечественными сервисами.
- Ограничение точности: простые формулы дают ориентировочные результаты; более точные модели требуют данных с достаточной глубиной: первая покупка, дата, сумма, поведение в последующих месяцах.
Прагматические рекомендации по внедрению
- Начинайте с базового CLTV на основе простых формул и сегментируйте по ключевым метрикам (регион, канал, сегмент клиента).
- Плавно внедряйте учёт времени: добавляйте дисконтирование и сезонность.
- Переходите к коортному анализу и моделям BG/NBD и Gamma-Gamma, когда у вас есть достаточно длинная история покупок.
- Внедряйте аналитическую витрину на ClickHouse и DataLens, а данные для ML — в Python-окружение с lifetimes и lifelines.
- Важно обеспечить качество данных: чистка, дедупликация, согласование дат и временных зон.
- Регулярно валидируйте модели: сравнивайте прогнозируемый CLTV с фактическим за период, следите за дрифтом и пересматривайте гипотезы каждые 3–6 месяцев.
Основы CLTV лежат на пересечении теории и практики. Простой подход полезен на старте, чтобы запустить процесс и понять базовые зависимости: как средний чек, частота покупок и срок жизни клиента влияют на общую ценность. По мере накопления данных и опыта внедрения переход на более продвинутые модели позволяет учитывать временную стоимость денег, сезонность, различия между каналами и сегментами, а также прямо использовать прогноз CLTV для бюджетирования, оптимизации маркетинга и повышения эффективности программ лояльности. В рамках BI/DWH проекта крайне важно выстроить корректную архитектуру данных, обеспечить прозрачность расчетов, выбрать подходящие инструменты — как open-source, так и отечественные — и постоянно отслеживать качество данных и корректность методик. Постепенный, контролируемый рост методологии CLTV поможет бизнесу принимать обоснованные решения и достигать устойчивых результатов.
- CLTV — это не просто цифра, а управленческий инструмент для планирования и оптимизации взаимоотношений с клиентами.
- Существует набор формул и подходов: от простейших до дисконтированных и модельных требуют данных и дисциплины в обработке.
- Архитектура данных и выбор инструментов критически влияют на точность и скорость выдачи CLTV.
- Важно учитывать риски: данные, изменения поведения, регуляторные требования и финансовые предпосылки.
- Реализация в рамках открытых технологий (PostgreSQL, ClickHouse, Airflow, dbt, Lifetimes) и российских решений (Яндекс DataLens, Яндекс.Облако) позволяет создавать гибкие и масштабируемые решения CLTV.
Вопрос–Ответ (FAQ)
1) Что такое CLTV и зачем он нужен бизнесу?
CLTV — это оценка общей ценности клиента на протяжении всего срока сотрудничества. Он помогает планировать маркетинговые бюджеты, определять рентабельность привлечения, настраивать программы лояльности и сегментировать аудиторию. Правильный CLTV позволяет сравнивать эффективность разных каналов привлечения и принимать решения об оптимизации ассортимента и обслуживания.
2) Какие существуют базовые формулы CLTV и в чем их смысл?
Существуют простые формулы, где CLTV определяется как GM × AOV × F × L, и более продвинутые формулы с дисконтированием (DCF) и с учетом churn. Простая формула полезна на старте, дисконтированные подходы — для финансовой коррекции, а модели BG/NBD и Gamma-Gamma — для прогнозирования поведенческих паттернов клиента.
3) Какие данные нужны для расчета CLTV?
Необходимы данные о транзакциях (order_id, customer_id, order_date, total_amount), данные о клиентах (customer_id, signup_date, регион), информация по марже (GM) и, по возможности, каналы привлечения. Чем длиннее история покупок, тем точнее модели и прогнозы CLTV.
4) Как выбрать подход к расчёту CLTV: простая формула vs. ML-модели?
Начинайте с простой формулы для быстрого старта и понимания базовых зависимостей. При наличии достаточного объёма данных и потребности в учете времени, сезонности и различий по каналам переходите к моделям BG/NBD, Pareto/NBD и Gamma-Gamma, а затем к ML-моделям для предиктивной оценки CLTV по клиентам.
5) Какую роль играет маржинальность (GM) в расчете CLTV?
GM показывает чистую прибыль на единицу выручки и влияет на итоговую ценность клиента. Разные товары и сегменты могут иметь разную маржу, поэтому GM иногда рассчитывают отдельно для каждого сегмента или канала, чтобы получить более точные оценки CLTV.
6) Какие данные и метрики помогают достоверно прогнозировать CLTV в BI/DWH?
Необходимо иметь стабильные данные по выручке, количестве заказов, датам и суммам, а также по марже. Важны коэффициенты удержания и частоты покупок во времени. Коэффициенты retention, F и L дают основу для CLTV, а модель BG/NBD и Gamma-Gamma — для более точных предсказаний.
7) Какие проблемы и риски возникают при внедрении CLTV?
Ключевые риски: плохое качество данных, неполнота истории покупок, дикие колебания в поведении клиентов, сезонность и кризисы, регуляторные требования к данным, а также риск неправильной трактовки результатов и переобучения моделей. Необходимо проводить валидацию, тестирование и регуляную корректировку методик.
8) Какие инструменты можно использовать в open-source стеке для CLTV?
Open-source стек может включать PostgreSQL или ClickHouse как OLAP-хранилище, Apache Airflow для ETL/оркестрации, dbt для трансформаций, Metabase или Apache Superset для визуализации, Python (lifetimes, lifelines, scikit-learn) для моделирования CLTV и прогнозов.
9) Какие российские решения применимы для CLTV?
Российские решения включают ClickHouse как основу DWH и аналитики, Яндекс DataLens для визуализации и дашбордов, Яндекс.Облако как облачную инфраструктуру, а также локальную поддержку и интеграцию с отечественными сервисами. Эти инструменты хорошо работают в рамках локальных регуляторных требований и обеспечивают производительность при больших объемах данных.
10) Что важно учесть на этапе внедрения в реальном проекте?
Важно определить стратегию: начать с простого CLTV и постепенно внедрять продвинутые модели; организовать архитектуру данных (звезда или снежинка); наладить ETL/ELT-процессы и валидацию данных; обеспечить прозрачность методик и доступность для бизнес-пользователей; настроить мониторинг качества данных и мониторинг моделей; обеспечить соответствие требованиям локализации и приватности.
Примечание: все примеры в тексте — концептуальные, адаптируемые под конкретный бизнес-кейс. Реальные проекты требуют детального анализа источников данных, согласования бизнес-логик и настройки инфраструктуры под организацию и регуляторные требования.


