

Моделирование данных для CLTV: модели и схемы
Customer Lifetime Value (CLTV) — это оценка совокупной прибыли, которую бизнес ожидает получить от клиента за весь период отношений. В эпоху онлайн-ритейла, SaaS и финансовых сервисов CLTV служит не только инструментом оценки доходности отдельно взятого клиента, но и драйвером решений по сегментации, таргетингу, ценообразованию, бюджету на маркетинг и персонализации коммуникаций. В контексте курса «Использование BI и DWH для расчета CLTV» мы сосредоточимся на моделировании данных: какие данные нужны, как их структурировать в хранилище и какие модели прогнозирования применяются на практике. В главе мы рассмотрим как теоретические основы, так и практические примеры реализации как на открытых инструментах, так и на российских решенияx. Мы обсудим не только модели, но и архитектурные схемы данных, жизненный цикл проекта, риски и ограничения внедрения. В конце главы — блок FAQ, который суммирует ответы на наиболее частые вопросыуравшиеся у сотрудников и студентов курса.
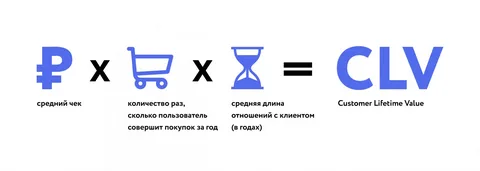
Что такое CLTV и зачем он нужен
CLTV — это сумма дисконтированной или недисконтированной будущей прибыли, которую клиент принесёт за весь период сотрудничества. В BI и DWH контекстах CLTV часто служит KPI для оценки эффективности маркетинга, удержания и продуктовых улучшений. В чистом виде CLTV можно рассчитать двумя базовыми подходами: историческим (retrospective) и прогнозируемым (predictive).
- Исторический CLTV: сумма известной выручки по каждому клиенту за фиксированный период. Применим, когда данных недостаточно для предсказания поведения и когда требуется быстрый ретроспективный показатель.
- Прогнозируемый CLTV: оценка будущей выручки на горизонты — например 6–12, 24 месяца — с учётом частоты покупок, времени до следующей покупки, монетарной ценности и вероятности ухода. Это требует моделей, которые учитывают динамику поведения и вероятность churn.
Базовые понятия и терминология
- Частота (frequency): число повторных покупок клиента за измеряемый период.
- Рецентность (recency): время с момента последней покупки.
- Время жизни клиента (customer lifecycle): период от первого взаимодействия до текущего момента/ожидаемого ухода.
- Монетарная ценность (monetary value): средняя или суммарная выручка на клиента за определённый период.
- Churn (отток): вероятность прекращения взаимодействий клиента в обозримом будущем.
- Временная дисконтация: приведение будущей выручки к текущей стоимости.
- Проприетарная vs. открытая модель: собственные алгоритмы компании против общедоступных моделей.
Модели CLTV: подходы
- Модели на основе событий и сценариев поведения. В этом подходе фокус на частоте и монетарной ценности. Популярной эмпирической моделью является BG/NBD (Bailey-Green-NBD) для оценки вероятности повторной покупки и Gamma-Gamma для монетарной составляющей.
-
BG/NBD и Gamma-Gamma (классическое семейство)
- BG/NBD оценивает вероятность повторной покупки клиента, основываясь на его истории: сколько раз он покупал, когда в последний раз, и как долго он был активен.
- Gamma-Gamma модель определяет денежную величину каждой покупки отдельно от частоты, чтобы предсказать среднюю монетарную ценность будущих покупок.
- В сочетании эти две модели позволяют получить ожидаемую CLTV для каждого клиента.
-
Прогнозные модели машинного обучения
- Регрессионные подходы: линейная/логистическая регрессия на наборе признаков (recency, frequency, monetary, сезонность, канал, цена, скидки, демография и т.д.).
- Модели с учётом времени: LSTM/GRU, Prophet, временные ряды для прогнозирования выручки; градиентный бустинг (XGBoost, LightGBM) на оконных признаках.
- Модели для сегментов: кластеризация клиентов (KMeans, HDBSCAN) с последующим обучением отдельных моделей в сегментах.
-
Марковские и цепи жизненного цикла
- Марковские модели используют состояния клиента (активен, вероятно уйдет, ушел) и вероятности перехода между состояниями в каждом периоде.
- Применение: расчёт ожидаемой выручки на горизонты и динамическая адаптация бюджета на удержание.
-
Cohort-анализ и сценарный анализ
- Анализ групп клиентов по дате первого взаимодействия; оценка CLTV внутри каждой когорты, учет изменений во времени.
- Сценарный анализ позволяет тестировать «что-if» сценарии: влияние изменения цены, частоты рекламы, стимулов на CLTV.
Архитектура данных: схемы и принципы проектирования
Роли схемы в BI/DWH
- Источники данных: транзакционные базы, логи веб‑и мобильных взаимодействий, системы оплаты, CRM.
- ETL/ELT: извлечение, трансформация, загрузка данных в хранилище. В современном стекe часто применяется ELT: данные сначала загружаются в хранилище, затем обрабатываются в SQL‑операциях или в аналитических пайплайнах.
- Моделирование CLTV: данные для моделей формируются на уровне факт-таблиц и размерностей, а предиктивные результаты сохраняются в предиктивных фактах для дэшбордов и дальнейшей интеграции в бизнес‑процессы.
Типовая структура хранилища
- Фактовая таблица cltv_facts: (customer_id, date_key, revenue, orders, duration, frequency, recency, churn_risk, predicted_cltv, horizon).
- Таблица клиентов (customers_dim): (customer_id, cohort_month, region, channel, segment, age_group, gender, loyalty_ttier, etc.).
- Таблица дат (date_dim): (date_key, date, year, month, quarter, day_of_week, holiday_flag).
- Таблица продуктов/категорий (products_dim): (product_id, category, price).
- Таблица каналов/источников (sources_dim): (source_id, channel, campaign, medium).
- Таблица фактов транзакций (transactions_fact): (transaction_id, customer_id, date_key, revenue, currency, channel, product_id).
Схема звездой vs снежной (star vs snowflake)
- Звезда: простая и понятная структура с минимальным числом соединений; чаще предпочтительна для CLTV, где скорость аналитики критична.
- Снежная: более нормализованная структура, лучше для управления данными и кросс-домекингом, но потребует дополнительных соединений.
Метрики качества данных и lineage
- Важно хранить версию схемы, линейку источников, качество данных, логи трансформаций и атрибуты «кто, когда и что изменил».
Принципы хранения прогнозов и обновления версий
- Прогнозируемые значения CLTV должны храниться отдельно от исторических показателей; версии моделей и параметры должны сохраняться с тегами времени обновления.
Практические примеры
1) Open-source пример: CLTV с использованием BG/NBD и Gamma-Gamma (библиотеки Lifetimes, Python)
- Сценарий: у вас есть исторические покупки клиентов: customer_id, date_purchase, revenue.
-
Предварительная подготовка данных:
- Рассчитываем для каждого клиента: frequency (кол-во повторных покупок у клиента), recency (время между первой и последней покупкой), T (пользовательское время на дату последней покупки).
- Монетарная ценность: average_order_value или монетарная величина на клиента.
-
Шаги моделирования:
- Подгоняем BG/NBD на (frequency, recency, T) данных.
- Подгоняем Gamma-Gamma на монетарной ценности per customer.
- Получаем CLTV через combination: predicted_purchases и predicted_monetary_value.
-
Реализация в общих чертах:
- Импортируете данные в pandas DataFrame, агрегируете по customer_id.
- Применяете fit к моделям BG/NBD и Gamma-Gamma.
- Вычисляете predicted_cltv для каждого клиента и группируете по сегментам, регионам или источникам.
-
Преимущества подхода:
- Хорошая адаптация к поведению клиентов с разной частотой покупок.
- Способность учитывать монетарную ценность каждой покупки независимо от частоты.
-
Ограничения:
- Требует достаточного количества транзакций для надёжной подгонки; у редких клиентов вариативность может быть высокой.
- Временная зависимость и сезонность должны быть учтены отдельно.
2) Российские решения и практические применения: ClickHouse, Yandex DataLens, dbt, ELT-подход
- Архитектура: источники данных — транзакции и логи, загрузка в ClickHouse, трансформации через dbt и отбор признаков; прогнозы — в Python или через ClickHouse ML, сохранение в ClickHouse для дэшбордов.
-
Пример реализации
- Хранилище: ClickHouse как аналитическая база данных для больших объемов событий. Структура: transactions (customer_id, date, revenue, channel), customers_dim (customer_id, region, cohort), date_dim.
- Предиктивная часть: выстроить пайплайн feature engineering в dbt (частота, recency, монетарная ценность, каналы, сезонность), затем поднуть на ML-модель (XGBoost/LightGBM) через Python, с последующим сохранением прогнозов в cltv_pred (customer_id, horizon, predicted_cltv).
- Визуализация: Yandex DataLens или другие российские решения для dashboards, позволяющие быстро визуализировать CLTV по сегментам, регионам и каналам.
-
Преимущества российского стека:
- ClickHouse обеспечивает сверхбыструю агрегацию и масштабируемость по миллионам клиентов.
- Yandex DataLens предлагает доступ к метаданным, визуальные дэшборды и интеграцию с экосистемой Яндекс.Облако.
- Локальные решения позволяют соответствовать требованиям локализации данных и регуляторным требованиям.
3) Этапы внедрения на примере полного пайплайна
Этап 1: сбор и консолидирование данных
- Источники: транзакционные БД, CRM, онлайн-логи, платежные сервисы.
- Инструменты: ETL/ELT-пайплайны (Airflow, Dagster, Prefect; для российских проектов — можно применять локальные оркестраторы).
Этап 2: построение схемы CLTV
- Создание фактовых таблиц: cltv_facts, transactions_fact.
- Создание размерностей: customers_dim, date_dim, sources_dim, products_dim.
- Расчёт признаков: frequency, recency, T, monetary_value, channel, cohort_month.
Этап 3: обучение моделей
- Опционально: применяем BG/NBD и Gamma-Gamma (open-source Lifetimes) или ML-модели на основе исторических признаков.
- Подготовка данных: нормализация, обработка пропусков, устранение выбросов, кросс-валидация.
Этап 4: внедрение и эксплуатация
- Прогноз CLTV сохраняется в cltv_pred и используется для принятия решений: таргетинг, бюджеты, персонализация.
- Автоматическое обновление: еженедельные/ежедневные обновления данных и переобучение моделей.
Этап 5: мониторинг и аудит
- Контроль точности прогноза, backtest по историческим периодам.
- Мониторинг качества данных и зависимости от источников.
Типовая схема данных и спецификация таблиц
- Таблица клиентов (customers_dim)
customer_id (PK), cohort_month, region, channel, segment, age_group, gender, loyalty_tier
-
Таблица дат (date_dim)
date_key (PK), date, year, month, quarter, is_holiday
-
Таблица транзакций (transactions_fact)
transaction_id (PK), customer_id (FK), date_key (FK), revenue, currency, channel_id, product_id
- Таблица продаж (orders or transactions) – для частотности
order_id (PK), customer_id (FK), date_key (FK), revenue, product_id
-
Таблица продукции (products_dim)
product_id (PK), category, price
- Таблица источников (sources_dim)
source_id (PK), channel, campaign, medium
-
Фактовая CLTV (cltv_facts) или предиктивная таблица (cltv_pred)
customer_id (PK), horizon_start_date, predicted_cltv, predicted_frequency, predicted_monetary, model_version
Пример SQL‑показателей CLTV (исторический подход)
- Пример расчета исторической CLTV по клиентам за последний год:
  SELECT customer_id, SUM(revenue) as historical_cltv
    FROM transactions_fact
    WHERE date_key >= DATE_SUB(CURRENT_DATE, INTERVAL 12 MONTH)
    GROUP BY customer_id;
- Пример расчета RFM‑показателей (для последующей сегментации)
  Recency: DATEDIFF(day, MAX(date), CURRENT_DATE)
  Frequency: COUNT(DISTINCT order_id)
  Monetary: SUM(revenue) / NULLIF(COUNT(DISTINCT order_id), 0)
Модельные подходы в коде (описательно)
BG/NBD и Gamma-Gamma (open-source Lifetimes)
- Подготовить данные: frequency, recency, T, monetary_value per customer.
- Подогнать модели: model.fit(frequency, recency, T) и gamma_gamma_model.fit(mon_val)
- Рассчитать CLTV: customer_lifetime_value = lifetimes.customer_lifetime_value(model, gamma_gamma_model, freq, rec, T, monetary_value, time=periods)
ML‑модели
- Признаки: recency, frequency, monetary, cohort, channel, region, product category, маркетинговый канал, сезонные признаки (month_id, quarter).
- Обучение: XGBoost/LightGBM для регрессии целевого CLTV на горизонте.
- Валидация: временная кросс-валидация, backtesting на исторических данных.
Инструменты и стек: обзор вариантов
Open-source
- БД: PostgreSQL, ClickHouse
- Аналитика: Lifetimes (BG/NBD, Gamma-Gamma), Statsmodels, Scikit-learn, XGBoost/LightGBM
- ELT/ETL: Airflow, dbt (data build tool), Spark (для больших данных)
- Визуализация: Apache Superset, Metabase
Российские решения
- ClickHouse как основа аналитической базы данных
- Yandex DataLens для визуализации и дэшбордов
- dbt в связке с локальными хранилищами (ClickHouse, PostgreSQL)
- Ориентированные на рынок BI компании-поставщики услуг внедрения: R-Style BI (решения для подготовки данных и внедрения BI-процессов), локальные интеграторы и провайдеры услуг по ELT/ETL в рамках российского рынка
Встраивание ML внутри БД
- ClickHouse ML и интеграция с Python-кодом: обучение моделей вокруг данных в ClickHouse, сохранение предиктов обратно в БД
- Возможность использования PyOD/Statsmodels для гиперпараметрической настройки
Важные практические аспекты
Данные и приватность
- Обеспечение защиты ПД/персональных данных: минимизация данных, псевдонимизация, хранение только необходимых атрибутов
- Соответствие требованиям GDPR и локальным требованиям РФ (для внутри-страны обработки персональных данных)
Валидация и backtesting
- Разделение на обучающую, валидационную и тестовую выборку по времени
- Backtesting прогноза CLTV на исторических периодах
Управление изменчивостью и drift
- Клиентское поведение может меняться из-за сезонности, изменений в цене, конкуренции
- Необходимо регулярное обновление моделей и мониторинг точности прогноза
Модели и бизнес-контекст
- Включать в модель контекст канала, стратегии удержания, ценовые предложения, скидки
- Учитывать мультиканальные эффекты и влияние маркетинговых активностей на CLTV
Риски и ограничения
Данные и качество
- Неполнота данных, пропуски и несогласованность между системами
- Сдвиги в поведении: сезонность, новые каналы, изменения в продукции, регуляторные ограничения
- Ограниченная выборка: редкие клиенты дают слабую статистику для BG/NBD и Gamma-Gamma моделей
Моделей и методологии
- Пресуппозиции BG/NBD: независимость покупок, отсутствие «поломки» модели при изменении поведения
- Монетарные модели: монетарная ценность может быть нестационарной; не все покупки одинаково ценны
- ML‑модели требуют большого объема данных и могут переобучаться на шуме
- Концепт-дрифт и изменения в рыночной среде требуют адаптивности и частого обновления моделей
Архитектура и внедрение
- Сложность стека: множество инструментов (ETL/ELT, хранилище, модельный слой, визуализация) — риск «разрыва» между данными и моделями
- Окупаемость проекта: ROI может потребовать времени; CLTV оценивается как стратегический показатель, а не оперативный KPI
- Безопасность и регуляторика: хранение и обработка персональных данных требуют надлежащего уровня защиты
Операционные риски
- Требования к компетенциям: специалисты должны владеть данными, аналитикой и бизнес-логикой
- Поддержка инфраструктуры: обновления зависимостей, совместимость версий инструментов
- Взаимодействие с бизнесом: перевод аналитических показателей в принятые решения требует дисциплины и процессов
Рекомендации по минимизации рисков
- Начинайте с простого и понятного: исторический CLTV и RFM, затем переход к предиктивным моделям
- Фокус на качественные данные: устранение пропусков и ошибок на входе
- Разделяйте задачи моделирования и внедрения: создайте прототип, затем полнофункциональный пайплайн
- Регулярно проводите backtesting и мониторинг точности прогноза
- Внедряйте контроль версий моделей и экспериментальную платформу для сравнения моделей
- Обеспечьте соответствие правилам защиты данных и внутренним политикам
Моделирование данных для CLTV требует сочетания теории и практики: от грамотного проектирования схемы данных и выбора подходящих моделей до внедрения пайплайнов на реальных данных в рамках BI/DWH. Проекты CLTV, основанные на открытых инструментах, позволяют быстро начать работу, протестировать подходы на малых данных, а затем масштабироваться с использованием российских и локальных решений, таких как ClickHouse и Yandex DataLens. Важно помнить, что CLTV — это не только сумма цифр; это инструмент стратегических решений: как распределяется маркетинговый бюджет, какие клиенты приносят наибольшую ценность, какие каналы требуют усиления, и какие предложения стоит тестировать. Все модели должны быть прозрачны, повторяемы и подкреплены бизнес-логикой. В итоге грамотная модель CLTV помогает повысить рентабельность маркетинга, оптимизировать удержание и улучшить работу продукта в рамках устойчивого роста компании.
Вопрос–Ответ (FAQ)
1) Что такое CLTV и чем он отличается от простого выручки по клиенту?
CLTV — это прогнозируемая общая стоимость отношений с клиентом за весь период сотрудничества, обычно дисконтированная во времени. Простая выручка по клиенту измеряет фактическую выручку в прошлом периоде и не учитывает будущие покупки, отток или монетарную стоимость будущих взаимодействий. CLTV добавляет взгляд в будущее и позволяет планировать бюджеты, таргетинг и удержание.
2) Какие модели чаще всего применяются к прогнозированию CLTV?
Наиболее распространены: BG/NBD для вероятности повторной покупки и Gamma-Gamma для монетарной ценности будущих покупок. В качестве альтернативы применяют регрессионные и ML‑модели (XGBoost/LightGBM, регрессия, модели временных рядов). Также используется Марковская цепь и когортный анализ для анализа жизненного цикла клиента.
3) Какие данные нужны для построения CLTV?
Не менее важные элементы: история транзакций (customer_id, date, revenue), дата первого взаимодействия, канал/источник, демография, регион, продуктовые категории, данные о скидках и промоакциях. В DWH CLTV чаще строят на данных с датами и суммами, а признаки дополняют на основе RFM‑анализа и канальных признаков.
4) Какую роль играет архитектура DWH в CLTV-проекте?
DWH служит центральной точкой консолидации данных и определения единых правил обработки. В CLTV-проектах обычно применяются Star schema или Snowflake schema: фактовая таблица CLTV + размерности клиентов, дат, источников и продуктов. Правильная архитектура обеспечивает достоверность атрибутов, скорость агрегаций и возможность масштабирования.
5) Какие инструменты можно использовать в открытом стеке?
Open-source набор включает PostgreSQL/ClickHouse как хранилища, Lifetimes для BG/NBD и Gamma-Gamma, Python (pandas, scikit-learn, XGBoost), dbt для ELT‑трансформаций, Apache Airflow для оркестрации, Apache Superset или Metabase для дэшбордов. Это обеспечивает полный цикл: от загрузки и обработки данных до прогноза и визуализации.
6) Какие российские решения подходят для CLTV?
Среди них — ClickHouse как высокопроизводительная аналитическая база данных, Yandex DataLens для визуализации и анализа, локальные решения по ELT/ETL и интеграционные услуги от российских компаний-партнёров. Этот стек удобен для локализации данных и соответствия требованиям регуляторов.
7) Какие главные риски при внедрении CLTV и как их минимизировать?
Ключевые риски: качество данных, несогласованность источников, сезонность и системные сдвиги в поведении клиентов, риск переобучения и концептуальные ограничения моделей. Минимизировать риски можно через: начать с простого подхода, обеспечивать качественные данные, проводить backtesting и мониторинг точности, внедрять контроль версий моделей, использовать принципы ELT и прозрачной архитектуры, а также соблюдать требования к защите данных.
8) Какой подход к внедрению CLTV в бизнесе предпочтителен?
Начать с исторического CLTV и RFM‑аналитики для быстрого получения первых выводов. Затем постепенно внедрять предиктивные модели для горизонтов 6–24 месяца, параллельно развивая пайплайн в рамках DWH. Важно обеспечить сотрудничество между бизнесом и аналитиками на каждом этапе, чтобы превратить CLTV в практические решения: корректировку бюджета, оптимизацию каналов и персонализацию предложений.
9) Какие метрики используются для оценки качества CLTV-моделей?
MSE/MAE/RMSE для регрессионных предикций, коэффициент корреляции между предсказанным и фактическим CLTV, backtesting по историческим периодам, точность классификации (если используется сегментация по порогам churn), и бизнес‑метрики: ROI маркетинга, CPA и LTV по каналам.
10) Какие шаги после внедрения CLTV?
Продолжать мониторинг точности, обновлять данные и переобучать модели, отслеживать сезонность и изменения в покупательском поведении, расширять функционал: интеграцию CLTV с ценовым инструментарием, автоматические рекомендации по бюджету и персонализации, визуализации для оперативной поддержки бизнес-подразделений.


