

Атрибуция маркетинговых кампаний и влияние каналов
Атрибуция маркетинговых кампаний и влияние каналов — это одна из ключевых проблем современного маркетинга и аналитики продаж. Когда пользователь взаимодействует с множеством каналов: поисковая реклама, соцсети, email-рассылки, партнерские площадки, оффлайн-активности, — становится сложной задачей определить, какие именно touchpoints принесли конверсию и какую долю прибыли они обеспечили. В контексте расчета CLTV (customer lifetime value) атрибуция приобретает особое значение: чтобы корректно оценить будущую ценность клиента, нужно знать, какие каналы и кампании влияют на размер покупки и событие повторной покупки в течение жизненного цикла клиента.
Цель данной главы — познакомить нового сотрудника с основами атрибуции, рассказать о существующих моделях и методологиях, привести технические примеры построения атрибуционной модели на практике с использованием BI и DWH, а также рассмотреть риски и ограничения внедрения. Мы обсудим как теорию, так и реальные практические примеры: от простых правил распределения доли дохода между каналами до продвинутых моделей на основе марковских процессов и принципов игры Шепли. Будут приведены примеры реализации с использованием open-source инструментов (ClickHouse, Apache Airflow, dbt, Apache Spark, Metabase, Apache Superset) и российских решений (Yandex DataLens, ClickHouse как российско-рынковая технология, интеграционные подходы с Яндекс.Метрика). В конце — блок вопросов и ответов, который поможет закрепить ключевые идеи и подготовиться к реальным задачам в работе.
Теоретическая часть
Определения и базовые понятия
- Атрибуция маркетинговых кампаний — процесс распределения конверсий и выручки по каналам и кампаниям, которые к ним привели. Цель атрибуции — понять вклад каждого контакта в путь клиента и на этой основе оптимизировать расходование маркетингового бюджета.
- Влияние каналов — совокупное влияние каждого канала на вероятность совершения конверсии и на ценность клиента в рамках CLTV.
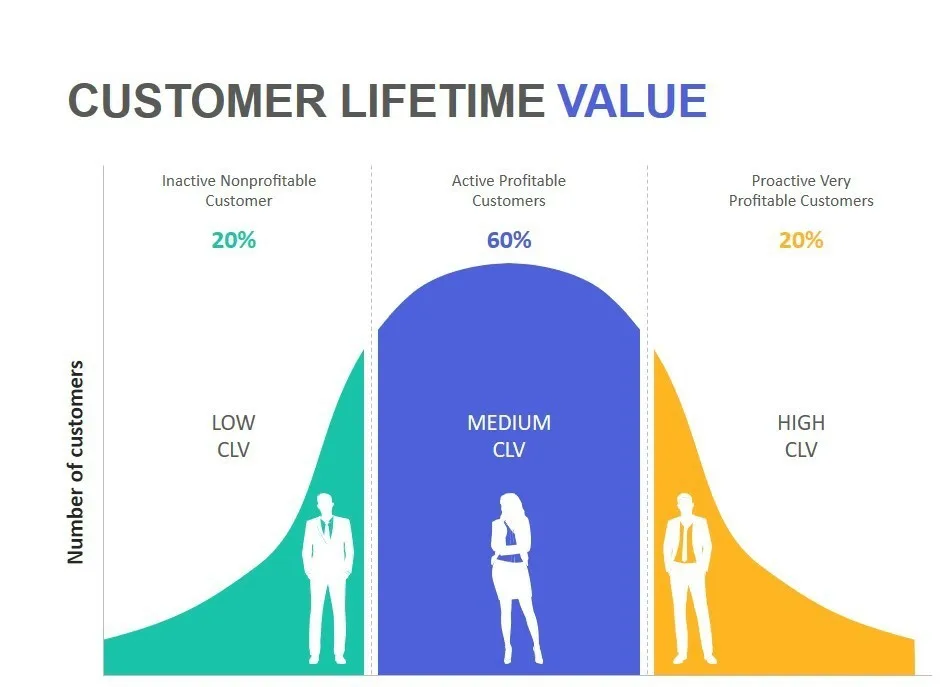
- CLTV (customer lifetime value) — ожидаемая суммарная выручка, которую принесет клиент за весь период взаимоотношений с компанией. В модели атрибуции CLTV часто расчетываются в связке с маркетинговыми вложениями и характером путей клиентов.
Основные подходы к атрибуции
- Многоступенчатая атрибуция (Multi-Touch Attribution, MTA) — распределениеcredit между всеми touchpoints в цепочке взаимодействий. В рамках MTA учитываются последовательности взаимодействий пользователя с каналами до конверсии.
- Модели первого и последнего касания (First-Touch и Last-Touch) — присваивают всю ценность первому или последнему взаимодействию соответственно. Эти простые правила часто дают искажения, например недооценивают влияние ранних контактов.
- Линейная и временная (time-based) атрибуция — распределение равной доли между всеми touchpoints или пропорциональное влиянию в зависимости от временного расстояния до конверсии. Временная атрибуция учитывает эффект отложенного влияния кампаний.
- Модель с убывающим по времени вкладом (Time Decay) — ближе к конверсии touchpoints получают большую долю кредита.
- Модели на основе данных (Data-Driven Attribution, DDA) — ML- или статистически основанные подходы, которые обучаются на исторических данных и оценивают вклад каналов без жестко заданных правил. Часто применяется в сочетании с графами путей и байесовскими или марковскими подходами.
- Модели Маркового процесса (Markov Chains) — формализуют путь клиента как цепь состояний (каналов), где переходы между состояниями задаются вероятностями. Удаление конкретного канала и просмотр изменения вероятности конверсии позволяет оценивать вклад этого канала.
- Значение Шепли (Shapley value) — концепция из теории кооперативных игр, применяемая для оценки вклада каждого канала в итоговую конверсию, учитывая все возможные наборы каналов. Это один из способов справедливо распределять ценность между несколькими участниками.
- Инкрементальная эффектная методика (incremental modeling) — через A/B-тестирование или holdout-эксперименты оценивается вклад конкретных кампаний в рост продаж и CLTV по сравнению с контрольной группой.
Ключевые концепты для построения атрибуции в контексте CLTV
- Путь клиента (customer journey) — последовательность касаний с каналами и кампаниями, ведущая к конверсии или повторной покупке.
- Канал и кампания — канал это вид рекламы или источника (поисковая реклама, соцсети, email, трафик, офлайн-продажи); кампания — конкретная рекламная единица внутри канала.
- Временные окна атрибуции — период времени между touchpoint и конверсией, который учитывается при распределении кредита.
- Cross-channel и cross-device атрибуция — учет взаимодействий клиента через различные устройства и платформы; сложность возникает из-за неполной идентификации клиента на разных устройствах.
- Данные и качество данных — атрибуцию можно выполнять только на основе качественных и сопоставимых данных: идентификаторы пользователей, временные метки, каналы, кампании, суммы выручки, события покупки и взаимодействия.
- Этические и правовые аспекты — сбор и обработка пользовательских данных подчиняются законами о приватности (например, требования к anonymization и consent), что влияет на доступность данных и дизайн моделей.
Методология построения атрибуционной модели в контексте BI/DWH
- Сбор и нормализация данных — агрегируем данные из разных источников: веб-аналитика, CRM, платные и органические каналы, оффлайн-данные; выравниваем по единицам времени, идентификаторам пользователя и бизнес-событиям.
- Формирование путей клиентов — для каждого клиента формируем хронологическую последовательность touchpoints: временная шкала с каналами, кампанией, идентификаторами кликов, санитация дубликатов.
- Выбор модели атрибуции — в зависимости от доступных данных и целевой метрики выбираем: простые (последний или первый касание), линейные, time-decay, марковские модели или DDA.
- Распределение ценности по каналам — как именно распределять выручку или маржу между каналами и кампаниями, учитывая разнообразие путей и перекрытие.
- Расчет CLTV с учетом атрибуции — CLTV может быть рассчитан как сумма дисконтированной выручки по цепочке клиента за весь период, приняв во внимание вероятностную атрибуцию стоимости каналов и маркетинговых затрат.
- Валидация и мониторинг — проверяем устойчивость моделей на наборе данных-валидации, сравниваем с holdout-группами и контролируем качество предсказаний (error metrics, ROC-AUC, calibration, backtesting на исторических данных).
Практические примеры
Пример 1. Открытый стек: атрибуция на основе марковского процесса с использованием ClickHouse, Apache Airflow и dbt
Контекст
- Источники данных: веб-аналитика, CRM, платные источники, оффлайн продажи.
- Хранилище: ClickHouse как высокопроизводительный аналитический data warehouse, способный хранить большие объемы событийной информации и быстро выполнять агрегации.
- Оркестрация и трансформации: Apache Airflow для планирования задач извлечения/нагрузки, dbt для преобразований и моделирования данных, Python для вычислений.
- Визуализация: Metabase или Apache Superset на базе ClickHouse.
Шаги реализации Сбор данных и моделирование путей
- Таблица событий events с полями: user_id, event_time, channel_id, campaign_id, event_type, revenue, order_id, device_id.
- Определяем константный окне атрибуции (например, 30 дней) для конверсий.
- Для каждого user_id строим путь: упорядоченные по времени touchpoints.
Расчет переходов (transition matrix)
- На уровне SQL или в Python строим матрицу переходов между состояниями (каналами) в путях пользователей.
- Пример идеи: количество переходов из канала A в канал B до конверсии.
- В конце получаем вероятность перехода P(B|A) и аналогичные значения для всех пар каналов.
Расчет вкладов и удаление канала
- Удаление канала K: оцениваем уменьшение вероятности конверсии и соответствующее изменение выручки. Это позволяет определить вклад каждого канала.
- Включаем учёт повторных покупок в расчеты CLTV: например, для каждого клиента суммируем дисконтированную выручку за все покупки и связываем её с каналами путей.
Расчет CLTV с учётом атрибуции
- CLTV клиента: сумма дисконтированной выручки по всем заказам за период жизни клиента.
- Распредление вкладов: для каждого заказа пропорционально распределяем выручку по каналам на основе рассчитанных вкладов из марковской модели.
- Итоговая метрика: CLTV по каналам и кампаниям, ROI по каналам, стоимость привлечения по каждому каналу.
Визуализация и выводы
- В UI (Metabase/Superset) строим дашборды: вклад каналов в CLTV, распределение расходов, коэффициенты ROI, динамика по времени.
- Примерное SQL-подключение в панели: агрегацию CLTV по каналу за месяц, зависимость дохода от набора каналов.
Преимущества такого подхода
- Позволяет учитывать перекрестное влияние каналов и порядок их взаимодействия.
- Более точна оценка вклада отдельных каналов по сравнению с простыми методами.
- Интегрируется в open-source стек и позволяет гибко расширять функциональность.
Пример 2. Российское решение в связке ClickHouse + Yandex DataLens
Контекст
- Данные из Яндекс Метрика, CRM и оффлайн-торговли импортируются в ClickHouse через конвейеры ETL.
- Для визуализации используется DataLens — российское решение, интегрируемое с ClickHouse, с поддержкой динамических панелей и защиты данных.
- Архитектура упрощена за счет того, что ClickHouse хорошо масштабируется под хранение больших объемов события и транзакционных данных, а DataLens обеспечивает быстрый доступ к результатам атрибуционной модели без потребности в сложной настройке BI.
Шаги реализации Интеграция источников и единая модель данных
- Привязка пользователей по user_id или anonymized_id из разных источников.
- Создание таблиц событий: interactions (touchpoints), purchases (конверсии), campaigns, channels, costs.
Атрибуционная модель
- Применяем линейную атрибуцию или time-decay в рамках путей клиентов, используя простые SQL-выражения и затем расширяем до марковской модели при необходимости.
- Расчет вкладов и CLTV по сегментам: новые/повторные клиенты, по каналу/кампании, по устройству.
Визуализация
- DataLens подключается к ClickHouse, библиотеки визуализации позволяют отслеживать вклад каналов по CLTV, ROI, и сравнивать фактическую выручку с прогнозной.
Результаты и выводы
- Возможность быстро адаптировать модели под новые источники трафика и кампании за счет гибкой архитектуры данных.
- Удобство для бизнес-пользователей: понятные дашборды и прозрачные метрики.
Эти примеры демонстрируют, что сочетание open-source инструментов и российских решений позволяет строить эффективные атрибуционные модели, которые интегрируются в процесс расчета CLTV и бизнес-аналитику в целом.
Архитектура данных и стек технологий
- Источники данных: веб-аналитика (UTM-метки, referer, каналы), CRM (клиентские профили, покупки), оффлайн продажи, платные источники (партнерские сети, рекламные кампании).
- Хранилище данных: ClickHouse как база для OLAP-аналитики, поддерживающая быстрые агрегаты и сложные запросы к большим массивам событий.
- ETL/ELT: Apache Airflow или Dagster для оркестрации цепочек извлечения и подготовки данных; dbt для трансформаций и моделирования данных, обеспечение реплицирования схем и версий моделей.
- Моделирование и анализ: Python (pandas, NumPy, SciPy, scikit-learn) для построения атрибуционных моделей (многие подходы используют ML/статистические методы); SQL для предобработки и агрегаций.
- Визуализация и хранение результатов: Metabase, Apache Superset или Yandex DataLens для создания дашбордов и отчетов; BI-слой обращается к ClickHouse напрямую.
- Управление качеством и безопасностью: Data Quality checks, мониторы роста ошибок, контроль доступа, приватность и анонимизация данных в соответствии с локальными требованиями.
Модели и расчеты на примерах SQL и Python
Пример проведения линейной атрибуции на SQL-подходе:
- Собираем все покупки и соответствующие touchpoints.
- Распределяем выручку поровну между touchpoints в рамках каждого пути (если линейная атрибуция): доля каждый touchpoint = 1 / число touchpoints в пути.
- Агрегируем по каналу и кампании.
Пример марковской атрибуции:
- Формируем последовательности путей клиентов: канал A -> канал B -> канал C -> покупка.
- Строим матрицу переходов между каналами и используем вероятности переходов для определения вклада каждого канала в конверсию.
- Удаление канала K в вычислениях позволяет оценить, на сколько уменьшается конверсия и выручка, если исключить данный канал.
Расчет CLTV:
- CLTV = сумма дисконтированной выручки по всем покупкам клиента за срок жизни.
- Если применяем атрибуцию по каналам, то часть CLTV присваивается каждому каналу в зависимости от вклада модели атрибуции.
- Пример дисконтирования: дисконтированный поток денежных средств = сумма выручки_t / (1 + r)^t, где r — ставка дисконтирования, t — временной промежуток.
Пример кода (псевдокод):
- Собрать пути: select user_id, array_agg(channel_id order by event_time) as path from events where event_type in ('click','impression','purchase') group by user_id;
- Расчет вкладов через марковскую модель: compute transition probabilities between channels from path data; for each channel compute removal effect by simulating absence of channel и пересчитав конверсии.
- Распределение CLTV по каналам: for каждого пользователя CLTV = sum(purchase_value_discounted); attribution_share[channel] = приоритетная доля channel из модели; channel_cltv += CLTV * attribution_share[channel].
Практические примеры с российскими и open-source решениями
Open-source стек:
- ClickHouse для хранения и агрегаций; поддерживает сложные запросы и масштабирование.
- Apache Airflow или Dagster для оркестрации конвейеров обработки данных.
- dbt для трансформаций и моделирования данных, контроля версий схем.
- Python-пакеты для моделей атрибуции: pandas, scikit-learn, numpy; возможно применение Markov chains или построение моделей на базе графов.
- Metabase или Apache Superset как слой визуализации и дашбордов.
Российские решения:
- ClickHouse — ядро хранилища, разработано российскими инженерами, широко применяется в компаниях в России и СНГ.
- Yandex DataLens или DataSphere — BI-инструменты российского происхождения для визуализации и анализа, интегрирующиеся с ClickHouse и другими данными.
- Яндекс.Метрика — источник данных для атрибуционной аналитики в рамках маркетинговых кампаний, особенно полезен для сбора путей и касаний в онлайн-среде. Интеграция с локальными системами (CRM, оффлайн) может потребовать ETL-процессов.
Практический кейс
- Компания ведет данные в ClickHouse, где хранит события веб-сайта и оффлайн продажи. Для атрибуционной аналитики строится путь клиента и рассчитывается вклад каждого канала в CLTV с использованием линейной и марковской моделей. Визуализация идет через DataLens, где бизнес-аналитики видят вклад каналов, ROI и прогноз CLTV по сегментам.
- В случае необходимости можно внедрить DataQuality проверки, чтобы обеспечить согласованность данных при синхронизации разных источников: CRM, веб-аналитика, оффлайн-торговля.
Риски и ограничения внедрения
Данные и качество данных
- Неполные или разрозненные данные по пользователям, неполные пути клиента, несопоставимые идентификаторы (cross-device).
- Проблемы синхронизации между источниками: задержки в загрузке данных, различие временных зон, дубликаты.
- Неправильные окна атрибуции: слишком длинные или слишком короткие окна приводят к искажению вклада каналов.
Модели и их предпосылки
- Модели атрибуции полагаются на стабильность путей и на наличии достаточного объема данных для обучения. Новые кампании или изменения в каналах могут резко изменить структуру путей, что требует обновления моделей.
- Модели Markovian требуют аккуратной подготовки данных и могут быть сложнее в настройке, чем простые правила.
Cross-device и идентификация пользователей
- Часто пользователи взаимодействуют с компанией через разные устройства, и сопоставление их поведения может быть непростой задачей. Недостаток идентификаторов может привести к недооценке вклада каналов.
Этические и правовые аспекты
- Соблюдение законов о приватности и согласие пользователя на обработку данных. В некоторых юрисдикциях требуются строгие политики анонимизации и ограничение сборов.
Технические ограничения
- Необходимость поддержки больших объемов данных и периодических обновлений моделей. Выбор подходящего архитектурного решения, чтобы не возникало узких мест в конвейерах ETL/ELT.
Применение и действие бизнес-решений
- Атрибуционная аналитика должна быть внедрена в процесс принятия решений. Важно избегать «коварной» трактовки модели и не превращать ее в единственный источник решения, поскольку она может быть чувствительна к качеству данных и к предпосылкам моделей.
Вопросы приватности и согласования
- При работе с персональными данными нужно учитывать требования законов о персональных данных, ограничение на хранение и обработку данных, а также обоснование использования сенситивных данных.
Атрибуция маркетинговых кампаний и влияние каналов являются важной частью современной аналитической практики, особенно когда речь идёт о расчете CLTV. Теоретически существует широкий набор подходов — от простых правил на основе первого/последнего касания до сложных моделей на основе марковских цепей и методов данных. Практически атрибуцию чаще всего реализуют через сочетание open-source инструментов и российских решений: ClickHouse как хранилище, dbt и Airflow как инструменты для подготовки и оркестрации данных, Python для моделирования, DataLens или DataSphere для визуализации. В любом случае ключевые принципы остаются неизменны: качественные данные, корректная идентификация путей клиентов, выбор подходящей модели атрибуции, валидизация и непрерывное улучшение моделей.
Риски и ограничивающие факторы должны учитываться на всех стадиях проекта: от дизайна архитектуры до внедрения в бизнес-решения. Важным является сочетание технической реализации с четким управлением данными, соблюдением правовых норм и прозрачной коммуникацией результатов атрибутивной аналитики с бизнес-коллегами. Только так можно получить полезные, понятные и применимые в бизнесе инсайты по CLTV и эффективности каналов.
- Атрибуция — это не замена ROAS и не простая перераспределение выручки; это методология понимания вклада каналов в финансовые результаты и CLTV.
- Выбор модели атрибуции зависит от доступности данных, целей аналитики и структуры путей клиентов.
- Технически эффективная реализация требует интеграции open-source и российских инструментов в связке: ClickHouse, Airflow, dbt, Python, DataLens/Superset, BI-платформы и источники данных в единую систему.
- Важно реализовать этапы валидации и мониторинга, чтобы оперативно выявлять деградацию моделей и корректировать расчеты.
- Риски включают недостаток данных, cross-device проблемы, privacy-ограничения и изменения в маркетинговой среде; они требуют активной работы над качеством данных, архитектурой данных и этическими аспектами.
Вопрос–Ответ (FAQ)
1) Чем отличаются атрибуция на основе марковского процесса и data-driven атрибуция?
- Атрибуция на основе марковского процесса строит вероятности переходов между каналами и рассчитывает вклад каждого канала через эффект удаления. Data-driven атрибуция — это ML/статистическая методика, обученная на исторических данных, которая определяет вклад каналов, учитывая множество факторов, включая порядок и специфичность путей. В реальных проектах часто применяют сочетания: марковский подход как реализуемый и объяснимый метод, дополняя его ML-моделями для уточнения вкладов.
2) Как выбрать окно атрибуции?
- Выбор окна зависит от цикла покупки и длительности жизненного цикла клиента. Для товаров с быстрым принятием решения можно использовать 7–30 дней, для товаров с длительным циклом покупки — 60–180 дней и более. Важно тестировать разные окна и проводить кросс-проверку на валидности.
3) Какие данные необходимы для атрибуции?
- Необходимы: идентификатор пользователя (user_id), временные метки взаимодействий (event_time), канал и кампания (channel_id, campaign_id), тип события (click, impression, purchase), сумма покупки (revenue), идентификатор заказа (order_id) и, по возможности, данные из CRM и оффлайн-источников. Важно обеспечить единый идентификатор и возможность связывать данные между источниками.
4) Как решить проблему cross-device атрибуции?
- Необходимо объединять события через унифицированные идентификаторы (напр., cookie-идентификатор + устойчивый user_id, возможно, через идентификацию по email в рамках согласованных данных), и при отсутствии идентификатора использовать вероятность сопоставления. В рамках модели можно учитывать неопределенный статус пользователя и использовать вероятностные подходы к сопоставлению.
5) Какие риски существуют при внедрении атрибуционной модели в BI/DWH?
- Риск ошибок в данных и несогласованности между источниками, риск переобучения на исторических данных, риск неправильной интерпретации результатов в бизнес-решениях, риск утечки данных и нарушения приватности, риск того, что модель устареет при изменении маркетинговой среды и поведения клиентов.
6) Как валидировать атрибуционную модель?
- Делать holdout-тесты, сравнивать прогнозируемые вкладки с фактическими изменениями в выручке, проводить backtesting на исторических периодах, сравнивать результаты разных моделей (маркoвская против линейной или time-decay), использовать контрольную группу для оценок инкрементального эффекта.
7) Как интегрировать атрибуцию в CLTV?
- Распределить CLTV клиента по каналам на основе вкладов атрибуционной модели. В итоге у нас получится распределение CLTV по каналам и кампаниям, что позволяет анализировать рентабельность каждого канала и пересчитать бюджет на маркетинг, опираясь на вклад в будущую ценность клиентов.
8) Какие ограничения у open-source стека для атрибуции?
- Ограничения могут быть связаны с масштабом хранения и обработки данных, сложности поддержки сложных моделей, потребности в настройке и мониторинге инфраструктуры. Однако стек на базе ClickHouse, Airflow, dbt, Python и BI-инструментов остаётся гибким и масштабируемым, и обеспечивает прозрачность методов атрибуции.
9) Какие преимущества дает использование российского решения в этом контексте?
- Российские решения, такие как ClickHouse и DataLens, обеспечивают хорошую локализацию данных, совместимость с российскими источниками данных и нормативными требованиями, а также растущую экосистему инструментов и специалистов, знакомых с локальными бизнес-процессами.
10) Что важнее — точность модели или понятные выводы для бизнес-пользователей?
- Обе составляющие критичны. Точность модели важна для аккуратности OLAP-аналитики и корректного распределения выручки, но бизнес-пользователи требуют понятных и прозрачных интерпретаций. Поэтому рекомендуется выбирать модели, которые можно объяснить на простом языке (например, марковские подходы с понятными вкладами) и дополнять их визуализациями в BI-системах, позволяющими видеть вклад каждого канала и CLTV по сегментам.


