

Этапы зрелости AI: от начального уровня к устойчивому внедрению
Развитие искусственного интеллекта в компании редко заканчивается на запуске первого проекта. Истинная ценность достигается только если результаты масштабируются, управляются, сопровождаются метриками и процессами, которые работают по цепочке от идеи до операционного использования и постоянно улучшаются.
Эта глава посвящена теме "модели зрелости AI" (AI Maturity) — как систематически определить текущее состояние организации, какие артефакты и практики нужны на каждом уровне зрелости, какие KPI и чек-листы применяются для оценки и контроля, а также как безопасно и эффективно переходить от начального уровня к устойчивому внедрению. Мы рассмотрим теорию, приведем примеры методов оценки, дадим практические инструкции и примеры инструментов (open-source и российские решения), обсудим риски и ограничения и закончим FAQ с ответами на наиболее частые вопросы.
Ключевые идеи:
- Модель зрелости — это путь, а не фиксированное состояние: у каждой организации своя траектория, но общие принципы присутствуют.
- Оценка зрелости строится по нескольким направлениям: данные, разработка моделей, пайплайны эксплуатации, управление и ответственность (Governance), люди и культура.
- KPI и бенчмаркинг позволяют переводить зрелость в бизнес-результаты: ROI, время выхода на рынок, качество принятия решений и устойчивость к рискам.
- Важны инфраструктура и практика: рефакторинг пайплайнов, управление версиями, мониторинг, мониторинг срабатываний и регрессионный тестинг.
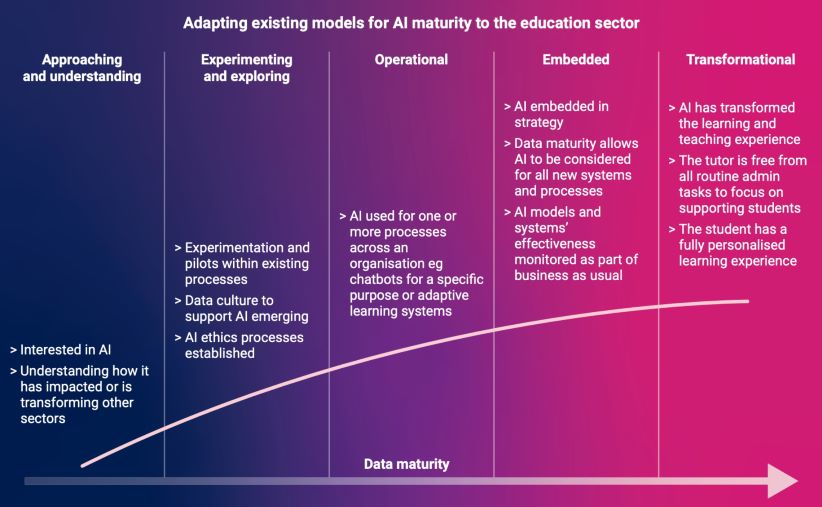
Что такое модель зрелости AI
AI Maturity — это совокупность требований к процессам, технологиям, организациям и политикам, которые позволяют компаниям стабильно создавать, внедрять и масштабировать ИИ-решения. Модели зрелости обычно описывают последовательность уровней развития, где каждый следующий уровень строится на результатах предыдущего и добавляет новые способности и требования.
Ключевые компоненты модели зрелости:
- Данные и качество данных: доступ к данным, их полнота, качество, линейная прослеживаемость, защита персональных данных.
- Разработка моделей: воспроизводимость экспериментов, управление версиями моделей, тестирование, безопасность.
- Эксплуатация и MLOps: развёртывание, мониторинг, инцидент-менеджмент, обработка сбоев, CI/CD для моделей.
- Управление и комплаенс: политика использования, риск-менеджмент, соответствие требованиям закона о данных, аудит.
- Организация и навыки: роли, процессы, культура, обучение сотрудников.
Типовая 5-ступенчатая модель зрелости AI
Ниже приведена обобщенная, но широко применимая структура, которая подходит большинству организаций и хорошо ложится на российский рынок, включая локальные требования к данным и безопасности.
Начальный уровень (Ad hoc / Initial)
- Характеристики: проекты запускаются спонтанно, отсутствуют формальные процессы, данные часто изолированы.
- Доказательства: единичные пилоты; отсутствуют регистры моделей; минимальный мониторинг.
- Что требуется: базовый доступ к данным, простые протоколы тестирования, регламенты по обработке персональных данных.
Экспериментальный уровень (Opportunistic / Pilot)
- Характеристики: появляются формальные пилотные проекты, начинается сбор метрик, есть базовый пайплайн.
- Доказательства: регламентированные наборы данных, протоколы верификации, тестовые стенды.
- Что требуется: единая среда для экспериментов, базовый контроль версий моделей, первая стратегия мониторинга.
Повторяемый уровень (Defined / Repeatable)
- Характеристики: повторяемые пайплайны, шаблоны проектов, базовые MLOps-процессы, управляемые данные.
- Доказательства: повторяемые результаты на разных наборах, документация процессов, базовый governance.
- Что требуется: разумная архитектура данных, модельный реестр, управление зависимостями, политики качества данных.
Управляемый уровень (Managed / Integrated)
- Характеристики: enterprise-grade MLOps, полный цикл от Data到Deployment, управление рисками, контроль качества на уровне предприятия.
- Доказательства: формальные политики, аудит, мониторинг производительности, безопасность и соответствие требованиям.
- Что требуется: полноценная платформа для развёртывания и мониторинга, интеграция с бизнес-процессами, управление изменениями.
Оптимизируемый уровень (Optimized / Scaled)
- Характеристики: AI в операциях масштабируется по компаниям, процессы непрерывно улучшаются, данные и модели управляются как активы.
- Доказательства: автоматизированный CI/CD для моделей, продвинутый мониторинг drift и безопасность данных; простые в поддержке реинжиниринг бизнес-процессов.
- Что требуется: организация непрерывной инновации, продвинутые политики по этике и ответственности, активное управление рисками и данными на уровне всей корпорации.
Почему 5 уровней? Потому что он дает понятную дорожную карту и позволяет разбирать конкретные практики и артефакты на каждом этапе внедрения.
Методы оценки зрелости AI
Подход по областям (Capability-based)
Оценка ведется по нескольким областям, которые важны для успешного внедрения ИИ:
- Data (качество, доступность, полнота, линейная прослеживаемость данных)
- Model (репродуктивность, версияing, качество моделей, тестирование, безопасность)
- Platform / Deployment (CI/CD, оркестрация, мониторинг, управление инцидентами)
- Governance (политики, комплаенс, аудит, управление рисками)
- People & Organization (роли, навыки, культура принятия решений, обучение)
Каждую область оценивают по шкале от 0 до 5 (0 — отсутствует; 5 — оптимально). Затем вычисляют суммарный балл и определяют уровень зрелости на основе набора критериев и весов, которые соответствуют и бизнеса.
Чек-листы и чек-матрицы
Чек-листы помогают систематизировать сбор доказательств. Пример структуры чек-листа:
Данные
- Есть ли zentrale data lake/data fabric? [да/нет]
- Есть ли качественные метрики данных? [есть/нет]
- Соблюдаются ли требования к персональным данным? [да/нет]
Модели
- Есть ли регистр моделей? [есть/нет]
- Есть ли версияing и тестовые окружения? [есть/нет]
- Ведётся ли регрессионное тестирование? [да/нет]
Эксплуатация
- Наличие пайплайнов CI/CD для моделей? [да/нет]
- Мониторинг рабочих показателей и дрейфа? [есть/нет]
- Регулярные ревизии рисков и инцидентов? [да/нет]
Governance
- Определены ли политики этики и ответственности? [да/нет]
- Есть ли аудит и документация по соответствию требованиям? [да/нет]
Люди
- Есть ли определенные роли (ML Engineer, ML Ops, Data Steward)? [да/нет]
- Проводится ли обучение и развитие персонала по MLOps? [да/нет]
KPI и бенчмаркинг
Ключевые показатели эффективности (KPI) должны быть связаны с бизнес-целями и операционными требованиями:
- Бизнес- KPI: ROI, NPV, общее влияние на выручку, среднее время до достижения бизнес-цели.
- Операционные KPI: time-to-value, deployment frequency, mean time to recovery (MTTR) после инцидента.
- Технические KPI: точность/качество моделей, стабильность метрик дрейфа, узлы отказа, задержки.
- Риск и комплаенс: число инцидентов безопасности, количество нарушений правил обработки данных.
Бенчмаркинг позволяет сравнить ваши показатели с внутренними целями и внешними аналогами (рынковыми/индустриальными). Внутренний бенчмарк строится на данных вашей компании по аналогичным задачам за прошлые периоды; внешний — на открытых дефинициях отрасли (например, показатели отраслевых докладов, отчеты консалтинговых компаний, открытые датасеты). В некоторых индустриях доступны отраслевые базы данных и эталонные показатели, которые можно использовать для калибровки.
Таблица: Этапы зрелости AI и параметры оценки
| Этап | Основные характеристики | Доказательства | Рекомендуемые KPI | Инструменты/практики |
|---|---|---|---|---|
| Начальный | Эксперименты ограничены, отсутствуют процессы | Единичные пилоты, без реестра моделей | Время до первого рабочего пилота, базовые данные доступности | Прототипы, открытые датасеты, простые пайплайны |
| Экспериментальный | Формальные пилоты, начинаются регламенты | Регистры проектов, базовые тесты | Время от идеи до пилота, качество данных | MLflow, DVC, простые Kubeflow/CI |
| Повторяемый | Стандартизированные пайплайны, базовые MLOps | Регистр моделей, контроль версий | Доля повторяемых проектов, качество данных | Kedro, Feast, MLflow, Airflow |
| Управляемый | Enterprise-grade, управление рисками | Аудит, мониторинг, регуляции | Время развертывания в прод, MTTR | Kubernetes, MLflow, Policy-as-Code |
| Оптимизируемый | Масштабирование, непрерывное улучшение | Эталонные практики, автоматизация | ROI, безупречный мониторинг, снижение издержек | CI/CD для моделей, продвинутый мониторинг, этика и риск |
Практические примеры
Кейс-образец: путь компании от начального к устойчивому внедрению AI
Этап 1: Активация пилотного проекта
- Задача: автоматизация обработки заявок в отделе поддержки.
- Инструменты: DeepPavlov для NLP-части, простые sklearn-модели; хранение данных в локальном Data Lake.
- Результат: пилот показал потенциал, но отсутствие единых стандартов затруднило масштабирование.
Этап 2: Формализация пилотов
- Внедрены регистры моделей, базовый набор метрик, начат мониторинг точности и latency.
- Инструменты: MLflow для экспериментов, DVC для версий данных, Kedro как каркас пайплайнов.
Этап 3: Повторяемость и стандарты
- Созданы шаблоны проектов, общие правила верификации данных, внедрено управление данными и их качеством.
- Инструменты: Feast как единый фичей-store, Airflow для оркестрации задач.
Этап 4: Управляемость и интеграция
- Внедрены CI/CD пайплайны для моделей, централизованный мониторинг производительности, обработка инцидентов.
- Инструменты: Kubernetes как платформа развёртывания, мониторинг с Prometheus + Grafana, Policy-as-Code (OPA).
Этап 5: Масштабирование и оптимизация
- Автоматизация обновления моделей без простоев, расширение на новые домены, усиленная этика и безопасность.
- Инструменты: продвинутый мониторинг дрейфа, автоматизированные ретренировочные пайплайны, интеграция с бизнес-процессами.
Примеры инструментов и решений (open-source и российские)
Open-source
- MLflow — управление экспериментами, регистры моделей.
- Kedro — каркас для конвейеров данных и модульной разработки.
- Feast — единое хранилище признаков (feature store).
- Kubeflow / Airflow — оркестрация и CI/CD для ML.
- DVC — управление версиями данных и артефактов.
- DeepPavlov — NLP-библиотека с предобученными моделями и инструментами для обучения.
- OpenVINO — оптимизация моделей под аппаратное обеспечение Intel/совместимое.
Российские решения и примеры
- Yandex DataSphere — платформа для разработки и развёртывания ML-проектов с интеграцией с инфраструктурой Яндекса.
- ABBYY — OCR и Intelligent Document Processing; решения для извлечения данных и автоматизации документооборота.
- DeepPavlov — активное российское сообщество и набор компонентов для NLP (дип-обучение, интеграции с русскоязычными задачами).
- SberCloud / Sber AI — платформа и инструменты для развёртывания ML-решений внутри экосистемы Сбербанка.
Практические рекомендации по переходу между уровнями
- Переводите оружие пилотирования в привычку: создайте формальные чек-листы для каждого проекта, чтобы доказать соответствие требованиям.
- Вводите регистр моделей и данных на ранних стадиях. Это помогает отслеживать версии и воспроизводимость.
- Обеспечьте базовый мониторинг и оповещение с возможностью реагирования на инциденты (MTTR >1 ч — сигнал к усилению).
- Реализуйте начальные политики по данным и безопасности, особенно в отношении персональных данных.
- Включайте бизнес-цели в KPI: не только метрики точности, но и влияние на скорость принятия решений и экономику.
Архитектура MLOps на разных уровнях зрелости
- Уровень 1-2 (Начальный/Экспериментальный): локальные ноутбуки, простые скрипты, отсутствие регистрирования артефактов.
- Уровень 3 (Повторяемый): единый каркас пайплайнов, регистр моделей, простая оркестрация.
- Уровень 4 (Управляемый): централизованный репозиторий моделей, мониторинг, CI/CD.
- Уровень 5 (Оптимизируемый): масштабирование на разные домены, автоматическое обновление моделей, этическая и правовая комплаенс.
ASCII-директии архитектуры:
Data Lake / Data Warehouse
      │
      ▼
Feature Store (Feast)
      │
      ├── Model Registry
      │     └── Tracked versions
      │
      ├── Training Pipeline (CI)
      │
      └── Deployment (CD)
            │
            ▼
      Model Serving / API Gateway
            │
      Monitoring & Drift Detection
            │
      Alert / Incident Management
Пример кода: простой детектор дрейфа и оценка данных
Ниже приведен упрощенный пример, как можно осуществлять начальный мониторинг дрейфа между обучающей и текущей выборками по непрерывно изменяющимся признакам.
# drift_check.py
import numpy as np
from scipy.stats import ks_2samp

def ks_drift(past_values, new_values, alpha=0.05):
    """
    Возвращает True, если есть статистически значимый дрейф между двумя распределениями.
    """
    stat, pvalue = ks_2samp(past_values, new_values)
    return pvalue < alpha, pvalue

# Пример использования
train_vals = np.random.normal(0, 1, 1000)
current_vals = np.random.normal(0.2, 1.1, 1000)  # смещение
drift_significant, p = ks_drift(train_vals, current_vals)
print("Drift detected:", drift_significant, "p-value:", p)
Этот пример демонстрирует базовый подход к обнаружению дрейфа распределения в непрерывном потоке данных. В реальных системах необходимо расширять такие проверки на множество признаков, учитывать многомерный дрейф и интегрировать с системой уведомления.
Пример YAML-манифеста для аудита зрелости
assessment:
  company: "ООО ПрогрессИИ"
  date: 2025-12-01
  dimensions:
    data_quality: 3
    data_governance: 2
    model_development: 3
    deployment: 2
    monitoring: 2
    ethics_risk: 2
  overall_score: 14
  stage: "Повторяемый"
  notes:
    - "Нужна регуляция по обработке персональных данных."
    - "Улучшить мониторинг дрейфа и логирование инцидентов."
Практические примеры: приёмы и артефакты
- Регистр моделей: хранение версий, метаданных, метрик, окружения и зависимости.
- Мониторинг: таргетинг на drift, latency, accuracy, качество данных, а также безопасность запросов и ответственность.
- Этические политики: сбор и обработка персональных данных, минимизация риска дискриминации, прозрачность решений.
Риски и ограничения
- Правовые и комплаенс-риски: соответствие законам о персональных данных (152-ФЗ и сопутствующие нормативные акты), локализация данных, ограничения на вывод и хранение данных за пределами страны.
- Данные и качество: слабое качество данных, неполнота, непоследовательность источников, недостающие логи и линейная прослеживаемость.
- Дрейф и устойчивость: модели со временем могут терять актуальность из-за изменений в данных, внешних факторов или поведения пользователей.
- Безопасность и приватность: угроза взлома, утечки, неправильная обработка чувствительных данных и использование устаревших библиотек.
- Экономические риски: высокая стоимость инфраструктуры, нехватка квалифицированных кадров, сложности в масштабировании.
- Технологическая зависимость: риск от vendor lock-in, ограничение на гибкое внедрение в нестандартные сценарии.
- Организационные риски: сопротивление изменениям, нехватка квалифицированных специалистов, культурные барьеры между бизнес-сторонами и ИИ-отделами.
- Этические риски: предвзятость моделей, несправедливые решения, отсутствие прозрачности и объяснимости.
Как минимизировать риски:
- Внедряйте принципы data governance и политики доступа, реализуйте авторизацию и аудит.
- Строите архитектуру как modular: можно заменить компоненты без полной перезаписи.
- Запускайте пилоты с четким набором OKR и ограниченными бюджетами на старте.
- Развивайте компетенции сотрудников и культуру ответственного использования ИИ.
Выводы
- Путь к устойчивому внедрению ИИ — это по сути путь к созданию управляемого, контролируемого и масштабируемого процесса: от выжимки успешных пилотов к системам, которые работают на уровне всей организации.
- Модель зрелости AI помогает структурно планировать изменения, определить требования к данным и технологиям, а также синхронизировать усилия бизнес-юнитов и ИИ-отдела.
- Важна интеграция инструментов: от Open-source (MLflow, Kedro, Feast, DVC, DeepPavlov) до российских решений (Yandex DataSphere, ABBYY, DeepPavlov, SberCloud) — для разных задач и сценариев.
- Четкие KPI, чек-листы и регуляторные политики позволяют измерять прогресс и управлять рисками на каждом этапе.
FAQ (Вопросы и ответы)
1) Что такое AI maturity и зачем нужна модель зрелости?
- AI maturity — это уровень готовности организации к созданию и эксплуатации ИИ-решений на системном уровне. Модель зрелости нужна, чтобы объективно оценивать текущее состояние, планировать развитие по шагам, управлять рисками, выбирать инструменты и формировать KPI, связывая технологические усилия с бизнес-результатами.
2) Какие стадии зрелости чаще всего используют в промышленности?
- Чаще всего применяют пятиступенчатую схему: Начальный (Ad hoc), Экспериментальный (Pilot), Повторяемый (Defined/Repeatable), Управляемый (Managed/Integrated) и Оптимизируемый (Optimized/Scaled). Уровни помогают определить приоритет и необходимое развитие процессов, инфраструктуры и культуры.
3) Какие области оцениваются в рамках оценки зрелости?
- Основные области: Data (качество и доступность данных), Model (разработка и качество моделей), Platform/Deployment (пайплайны, развёртывание, мониторинг), Governance (политики, комплаенс, аудит) и People & Organization (роли, навыки, культура). Иногда добавляют этику и безопасность как отдельные подмодули.
4) Какие KPI применяются для оценки зрелости?
- KPI бывают бизнес-ориентированными (ROI, влияние на выручку), операционными (время до реализации, частота развёртывания) и техническими (точность, дрейф, MTTR). Важно связывать KPI с целями бизнеса и планами внедрения.
5) Какие инструменты можно использовать для оценки и управления МLOps?
- Open-source: MLflow (эксперименты и регистр моделей), Kedro (конвейеры данных), Feast (feature store), DVC (версионирование данных), Kubeflow/Airflow (оркестрация), DeepPavlov (NLP).
- Российские решения: Yandex DataSphere (ML платформa), ABBYY (OCR/DP), DeepPavlov (NLP на русском), SberCloud (платформа ML и инфраструктура). Эти площадки поддерживают локализацию данных и интеграцию с российскими системами.
6) Как оценивать дрейф данных и моделей?
- Начните с простых статистических тестов ( KS-тест, тесты на распределение признаков). Далее переходите к многомерному дрейфу, включая дрейф концепций и поведения. В реальности нужен комплексный мониторинг: дрейф данных, деградация точности модели, задержки и качество логирования.
7) Какие риски и ограничения стоит учитывать при внедрении?
- Правовые: соответствие законодательству о персональных данных и локализация данных; безопасность.
- Технические: качество данных, дрейф, зависимость от инфраструктуры, сложность масштабирования.
- Организационные: нехватка специалистов, сопротивление изменениям, сложности в коммуникации между бизнес-единицами и ИИ-отделом.
- Экономические: стоимость, окупаемость, необходимость инвестировать в инфраструктуру и обучение.
8) Какие российские решения стоит рассмотреть для локального внедрения?
- Yandex DataSphere для управляемой разработки и развёртывания ML-проектов в русской экосистеме
- ABBYY для обработки документов и извлечения данных.
- DeepPavlov как готовое NLP-решение под русский язык и локальные задачи.
- SberCloud/MLOps-платформы для корпоративных задач в экосистеме банковских и промышленных компаний.
9) Как начать путь к устойчивому внедрению AI в своей организации?
- Сформируйте первую дорожную карту зрелости с четкими KPI и регламентами. Убедитесь в наличии регистров моделей и данных, базовых процессов мониторинга, и поддержки политик по данным и безопасности. Пилотируйте на одной бизнес-задаче, наращивайте масштабы шаг за шагом, внедряйте MLOps практики и governance, чтобы бизнес-подразделения смогли масштабировать решения без потери качества и управляемости.
10) Как связать бизнес-цели с техническими метриками в рамках модели зрелости?
- Определяйте бизнес-цели до начала проекта, затем переводите их в набор KPI, которые можно измерить: время до результата, экономический эффект, скорость внедрения, качество данных и поведение моделей. Включайте в отчетность не только точность моделей, но и влияние на бизнес-процессы и ритмы управления рисками.
Если вы рассматриваете AI как часть цифровой трансформации компании, мы поможем сформировать дорожную карту, оценить риски и запустить пилот с понятными метриками эффективности.


