

Пошаговый план внедрения пилотного проекта ML
Краткое введение
Пилотный проект ML служит как vernietпадающее звено между экспериментами в стендап-заданиях аналитиков и масштабируемой эксплуатацией моделей в продуктивной среде. Этот этап критически важен для снижения бизнес-рисков, обучения команды и выработки реалистичных KPI, которые позволят управлять расходами на инфраструктуру, качество модели и влияние на бизнес-процессы. Пошаговый план внедрения пилотного проекта ML помогает структурировать работу, обеспечить управляемость изменений и доказать стоимость ML-инициатив для ИТ-директоров и руководителей направлений.
Введение
Цель пилота - проверить жизнеспособность решения на реальных данных в ограниченном объёме, минимизировав риски и затраты, определить требования к данным и инфраструктуре, получить первые бизнес-метрики и готовность к переходу в MLOps. Эффективный пилот требует четкой постановки проблемы, согласованных KPI, прозрачной архитектуры и управляемого масштаба. В рамках курса мы систематизируем весь цикл: от формулировки гипотезы и сбора данных до мониторинга и планирования масштабирования.
Теоретические основы и терминология
- МL lifecycle и MLOps: цикл с формулировкой задачи, подготовки данных, обучения, оценки, развёртывания и мониторинга, управляемый через практики DevOps для моделей (CI/CD для моделей, управление версиями, репродуктивность).
- KPI для пилота ML: бизнес-метрики (например, точность, ROC-AUC, F1, экономическая эффективность), операционные метрики (время отклика, latency, пропускная способность), качество данных (data quality metrics, data drift).
- Методы валидации гипотез: A/B-тестирование, анализ контрфактов, кросс-валидация на стейдж-средах, ленточное тестирование.
- Архитектурные паттерны: учебная среда (training), валидационные окружения (dev/stage), продакшн-сервер (prod), мониторинг и обратная связь.
Методологии и подходы
- Определение цели и рамок пилота
- Выберите одну конкретную бизнес-проблему с понятной ценностью: например, предиктивная сегментация клиентов, предсказание отказов, рекомендационная система или автоматизация обработки документов.
- Сформулируйте гипотезу: "Если мы применяем модель X к данным Y, то достигаем метрики Z на периоде T."
- Установите KPI (бизнес и операционно-данные) и пороги успеха для перехода к полноценной эксплуатации.
- Подготовка данных и инфраструктуры
- Идентифицируйте источники данных, требования к качеству и доступ к ним.
- Определите требования к воспроизводимости: версионирование данных, контроль версий моделей, репликационные окружения.
- Обеспечьте безопасное и контролируемое использование данных: маскирование, анонимизация, соблюдение регуляторики.
- Выбор методологии и техники
- Подбор алгоритмов и архитектуры: градиентные бустинг, нейронные сети, линейные модели и т.д., в зависимости от задачи.
- Определите базовый уровень производительности (baseline) и план улучшения.
- Спроектируйте пайплайны: подготовка данных, фичинг, обучение, валидация, развёртывание.
- Планирование эксперимента
- Определите временной вакуум, порядок экспериментов, критерии остановки.
- Включите план по деградации модели и обновлениям: какие сигналы будут считаться дрейфом данных и как реагировать.
- Архитектура и технологическая реализация
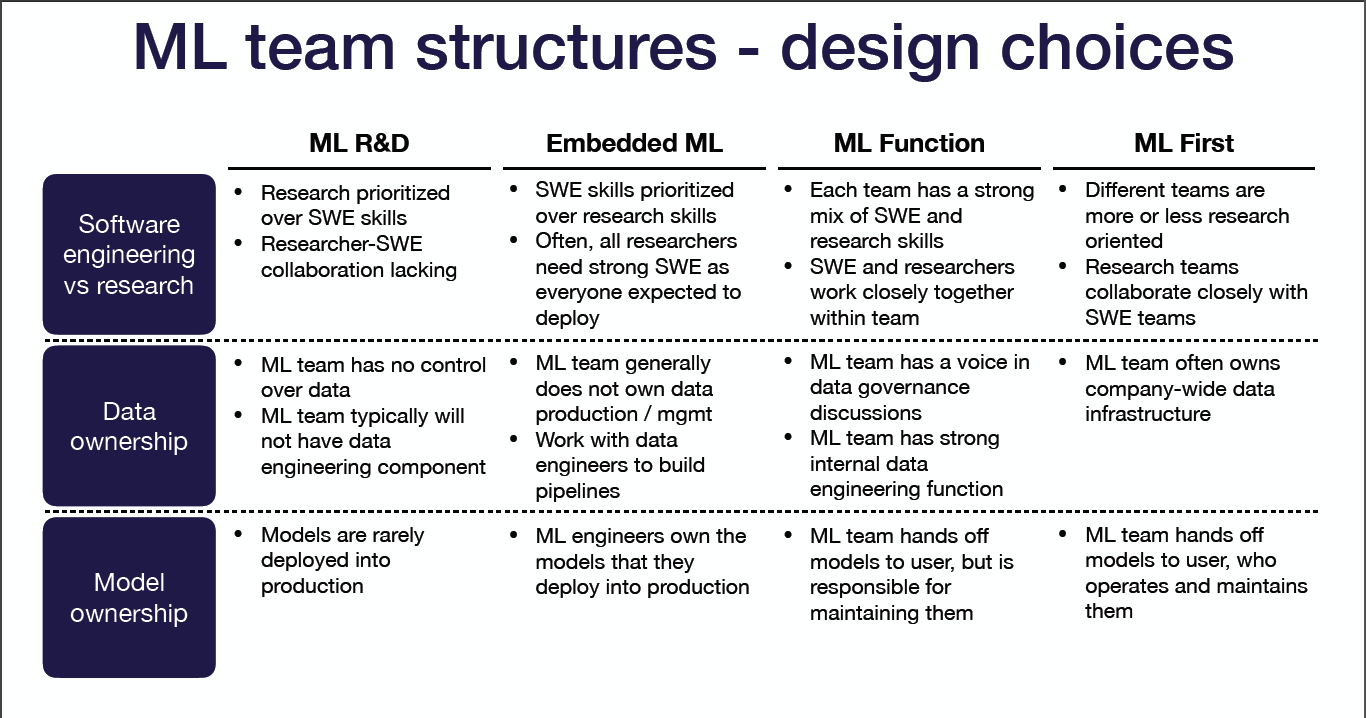
- Постройте целевую архитектуру с разделением ответственности: data ingestion, feature store, обучающие пайплайны, модель-реализация, мониторинг, доступ для стейкхолдеров.
- Внедрите управление версиями: данные, код, конфигурации, веса моделей.
- Обеспечьте безопасность и соответствие требованиям: доступ к данным, журналы аудита, шифрование.
- Этап внедрения и оценка
- Реализация пилота в ограниченном окружении: dev/stage, затем небольшая продакшн-подверга.
- Сбор и анализ метрик: сравнение с baseline, анализ экономического эффекта.
- Подготовка перехода к MLOps: план миграции, требования к инфраструктуре, процессы обновления и мониторинга.
- Масштабирование и переход к MLOps
- Определите шаги перехода от пилота к продакшн-уровню: CI/CD, модельный регламент, мониторинг дрейфа, алерты.
- Внедрите функционал автоматических отклонений и процесса обновлений.
Архитектура и технологическая реализация
- Общее представление: данные -> пайплайны -> фичи -> обучение -> валидация -> развёртывание -> мониторинг.
- Инфраструктура:
- Хранилище данных: Data Lake / Lakehouse (Delta Lake, Apache Iceberg) для унифицированной версии данных.
- Инструменты оркестрации: Apache Airflow, Dagster, Prefect.
- Фичер-стеор: Feast или аналогичная система хранения признаков.
- Пайплайны обучения: Kubeflow, MLflow, DVC, Metaflow.
- Сервисинг моделей: Seldon Core, BentoML, TorchServe.
- Мониторинг и управление дрейфом: Evidently AI, WhyLabs, Prometheus + custom dashboards.
- Метаданные и управление версиями: ML Metadata (MLMD), кросс-слойная видимость артефактов.
- Безопасность и комплаенс: мониторинг доступа, аудит действий, шифрование в пути и в покое.
- Технологический стек (пример):
- Язык: Python, SQL.
- Библиотеки: scikit-learn, CatBoost (русская разработка из Яндекса), LightGBM, XGBoost, PyTorch, TensorFlow.
- Инфраструктура: Kubernetes, GPU-окружения, облачные ресурсы (AWS, GCP, Azure) или гибрид/локальные кластеры.
- Контроль версий: Git, DVC, MLflow.
- Интеграции: REST/gRPC API, стандартные коннекторы к данным.
Организационные и процессные аспекты
- Роли и команды:
- Владелец бизнес-целей (Product Owner) и стейкхолдеры бизнеса.
- Data Scientist/ML-инженер: разработка модели и пайплайнов.
- ML Ops инженер: развёртывание, мониторинг, автоматизация.
- Data Engineer: подготовка данных, интеграции, качество данных.
- Data Steward / Data Governance: ответственность за соответствие политик.
- Архитектор решений: выбор архитектурных паттернов и совместимости систем.
- Управление проектом:
- Гибкие методологии с четкими спринтами, демо-итогами и risk reviews.
- Оценка бюджета: инфраструктура, лицензии, команды, обучение.
- Управление изменениями: регламент по обновлениям моделей, rollback-планы.
- Процессы качества:
- Верификация данных и метрик на каждом этапе пайплайна.
- Регулярные аудиты данных и модели.
- Документация: чёткие спецификации данных, моделей, соглашения по интерфейсам.
Практические примеры и кейсы (open-source и российские решения)
- Open-source кейсы:
- Предсказание оттока клиентов с использованием CatBoost и LightGBM на базе реальных наборов данных.
- Нейронные сети для анализа текста: использование BERT-подобных моделей и их доработки под бизнес-задачи.
- Системы мониторинга качества данных и дрейфа с Evidently AI и WhyLabs.
- Модели обслуживания данных в streaming-потоках с Apache Flink и Spark Structured Streaming.
- Пример пайплайна в Kubeflow/MLflow для контроля экспериментов и версионирования моделей.
- Российские решения и проекты:
- DeepPavlov - открытая библиотека для NLP и диалоговых систем, примеры обучения и интеграции в бизнес-процессы.
- RusVectōriy - набор русскоязычных моделей векторного представления слов и текстов, интеграция в поисковые и классификационные задачи.
- CatBoost - русскоязычный и открытый инструмент градиентного бустинга, эффективный на несложных и средних по сложности задачах, хорошо работает с табличными данными и категориальными признаками.
- Примеры отечественных проектов по обработке документов и автоматизации рутинных операций, реализованные на базе упомянутых инструментов и адаптируемые под отраслевые требования.
- Примеры реальных решений в рамках пилотов:
- Модели для предиктивной диагностики оборудования с использованием CatBoost и простого пайплайна подготовки данных; мониторинг дефектов и их дрейфов.
- NLP-решения на DeepPavlov для обработки входящих заявок или документов с автоматическим извлечением сущностей и классификацией контекста.
- Поэтапная интеграция модели в сервисы через REST API с отслеживанием версий и автоматическим откатом.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Алгоритмы и подходы:
- Табличные данные: CatBoost, LightGBM, XGBoost; базовые линейные и логистические модели.
- Текст: трансформеры (BERT-подобные модели), адаптация под русскоязычный контент, fine-tuning.
- Композитные подходы: ансамбли, стэкинг, blend-инг.
- Пайплайны и протоколы:
- Data ingestion: Airflow/Dabster/Dagster - интеграция источников данных, ETL/ELT.
- Feature store: Feast для централизованного управления признаками, совместно с версионированием.
- Обучение: Kubeflow/MLflow для отслеживания экспериментов, репликации и сохранения артефактов.
- Валидация: разделение на обучающие, валидирующие и тестовые наборы; демонстрационные тесты.
- Развёртывание: Seldon Core или BentoML для сервисинга моделей; можно использовать TorchServe для PyTorch.
- Мониторинг: Evidently AI, Prometheus, Grafana; линзы для анализа качества и дрейфа.
- Интеграции и интерфейсы:
- REST/gRPC сервисы для потребителей бизнес-слоя.
- Интеграция с BI и аналитическими инструментами для визуализации результатов.
- Контроль версий кода и данных через Git/DVC.
- Безопасность и соблюдение:
- Реализация политики доступа, журналирование событий, аудит и контроль соответствия.
- Шифрование данных в покое и в транзите, а также управление ключами.
- Пример кода/конфигураций:
- Пример конфигурации MLflow для экспериментов:
import mlflow
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import roc_auc_score
mlflow.set_experiment("pilot_ml_rf") with mlflow.start_run(): model = RandomForestClassifier(n_estimators=200, random_state=42) model.fit(X_train, y_train) preds = model.predict_proba(X_val)[:, 1] auc = roc_auc_score(y_val, preds) mlflow.log_metric("val_auc", auc) mlflow.sklearn.log_model(model, "rf_model")
- Пример конфигурации Feast для признаков:
feast apply feast materialize-incremental $(date -u +%Y-%m-%d) - Mermaid-диаграмма архитектуры пайплайна:
graph TD;
A[Data Sources] --> B[Data Ingestion/ETL];
B --> C[Feature Store (Feast)];
C --> D[Model Training (Kubeflow/MLflow)]; D --> E[Evaluation & Validation]; E --> F[Model Registry]; F --> G[Serving (Seldon Core)]; G --> H[Monitoring & Observability];
- Рекомендованные практики:
- Версионирование данных и моделей; хранение артефактов в репозитории и реестр моделей.
- Непрерывная интеграция пайплайнов данных и моделей.
- Пилот в формате минимального масштаба: ограничение по данным, по серверам и по доступу.
Риски, ограничения и типовые ошибки
- Риски:
- data leakage между обучением и тестированием; несоответствие данных реальному бизнес-процессу.
- дрейф данных и концептуальное устаревание признаков.
- переоценка ожиданий от пилота и несоответствие KPI продакшн-ситуациям.
- ограничение инфраструктуры: нехватка вычислительных ресурсов, задержки в доступе к данным.
- Ограничения:
- качество и полнота данных; согласование с регуляторикой и безопасностью.
- сложность поддержки и масштаба в рамках пилота.
- Типовые ошибки:
- отсутствие базового уровня (baseline) и нечётко сформулированных целей.
- недостаточное участие бизнес-коллектива в формулировании проблем и KPI.
- отсутствие управляемых процессов обновления модели и мониторинга.
- слабое документирование пайплайна и артефактов, что усложняет повторение экспериментов.
- игнорирование требований к данные, безопасности и регуляторики.
Перспективы развития направления
- По мере роста зрелости пилота и уверенности в бизнес-эффекте увеличиваются объёмы данных, расширяются функциональные области и усложняются задачи.
- Внедрение MLOps-практик - автоматизация деплоймента на продакшн, непрерывное обучение, мониторинг дрейфа и автоматическое обновление моделей.
- Расширение использования фич-сторов, управление данными на уровне предприятия и синергия между различными доменами (финансы, продажи, обслуживание клиентов).
- Внедрение автоматизированных тестов для ML-моделей, улучшение аудита и прозрачности решений.
- Этапы зрелости включают: признанную бизнес-ценность пилота, устойчивую работу пайплайнов, адаптивную платформу, способность к масштабированию и управлению рисками.
Заключение
Пошаговый план внедрения пилотного проекта ML позволяет систематизировать путь от идеи до реального бизнес-эффекта. Важно помнить, что пилот - это не одноразовый эксперимент, а структурированный процесс обучения организации: от понимания проблемы до развёртывания управляемой среды MLOps. В ходе пилота команда учится работать с данными, оптимизировать процессы, развивает культурную готовность к принятию решений на основе данных и создает фундамент для масштабирования решений на предприятии.
Вопрос-Ответ (FAQ)
Какие первые шаги при выборе проблемы для пилота?
Определите бизнес-цель, которая приносит заметную ценность при ограниченном объёме комплекта данных. Формулируйте гипотезу и KPI, которые можно проверить за 4-12 недель. Включите стейкхолдеров и подтвердите, что проблема поддаётся измерению.
Как выбрать метрику успеха пилота?
Выбирайте метрику, которая прямо коррелирует с бизнес-ценностью: точность, ROC-AUC, F1 для классификаций; экономический эффект (ROI) через экономический отклик; latency для онлайн-сервисов. Не забывайте о дрейфе и устойчивости метрик к изменениям в данных.
Как избежать утечки данных (data leakage)?
Разделяйте данные должным образом, исключайте информацию будущего из обучающего набора, применяйте кросс-валидацию и отдельные наборы для обучения и тестирования. Введите чек-листы на этапе подготовки данных.
Какие инструменты лучше использовать на старте?
Базовый стек: Python, scikit-learn/CatBoost, TensorFlow/PyTorch, MLflow/DVC для версионирования, Feast для признаков, Kubeflow для orchestrating. Для мониторинга - Evidently AI.
Что такое baseline и почему он важен?
Baseline - это простой, но реалистичный уровень производительности модели без сложных техник. Он нужен для объективной оценки прогресса пилота и понимания, какой прирост даёт новая модель.
Как построить архитектуру пилота?
Архитектура должна разделять инфраструктуру на источники данных, пайплайны подготовки, обучение, валидацию, развертывание и мониторинг. Важно иметь централизованный Feature Store и механизм версионирования артефактов.
Какие риски наиболее критичны?
Риск нарушения регуляторики и безопасность данных; риск неправильной оценки, плохого качества данных; риск дрейфа данных; риск высокий стоимость владения инфраструктурой без четкого ROI.
Как организовать переход к MLOps после пилота?
Планировать миграцию на сервисы мониторинга, CI/CD для моделей, автоматическое обновление моделей и регуляторную документацию. Включить в планы бюджет, ресурсы и ответственность.
Что делать с российскими решениями и локальными компетенциями?
В рамках пилота используйте российские инструменты и библиотеки, такие как DeepPavlov для NLP и RusVectōriy для векторизации текста, а также CatBoost - удобный инструмент для табличных данных с русскими разработчиками. Это ускорит адаптацию к отечественным требованиям и регуляторике.
Как оценивать успех пилота?
Оценка по бизнес-метрикам, экономическому эффекту и качеству данных; анализ устойчивости в разных сценариях, а также готовности к развёртыванию в продакшн и масштабированию.
Элементы для самостоятельной подготовки
- Пример проекта можно моделировать как задачa предсказания риска задержки поставок на основе данных по заказам и логистике, используя CatBoost и MLflow для экспериментов.
- Примеры кода и конфигураций - в репозиториях с открытым доступом: CatBoost, DeepPavlov, RusVectōriy, MLflow, Feast.
- Пример архитектурной диаграммы пайплайна представлен выше в виде диаграммы Mermaid.
Дополнительные ресурсы
- Open-source библиотеки: CatBoost, DeepPavlov, RusVectōriy, scikit-learn, TensorFlow, PyTorch, Feast, Kubeflow, MLflow, DVC.
- Документация по архитектурам и протоколам: архитектура пайплайна ML, управление артефактами, контроль доступа и безопасность.
- Кейс-стади и исследования по пилотам внутри отраслей: финансы, производство, retail, здравоохранение.
Примечание
Данная глава служит руководством к действию: она сочетает теоретическую базу с практическим подходом к реализации пилотных проектов ML в реальной организации, подчеркивая важность открытой архитектуры, прозрачности процессов и управляемого перехода к MLOps.
Если вы планируете запуск ML-инициатив или масштабирование AI-проектов, важно выстроить не только модели, но и всю экосистему — от данных и инфраструктуры до процессов эксплуатации и управления.
Узнайте, как внедрить искусственный интеллект в бизнес от стратегии до промышленного внедрения, включая разработку AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы компании.


