

Эволюция ML в организациях: от экспериментов к эксплуатации
Краткое введение
Эта глава посвящена переходу организации от эпохи экспериментальных прототипов к устойчивой эксплуатации моделей машинного обучения в условиях реального бизнеса. В рамках курса «MLOps в облаке и on-premise выбор инфраструктуры, масштабирование и управление затратами» мы разберем, как выстраивать зрелость ML-практик: от экспериментальных сред и прототипирования до промышленного конвейера поставки моделей, мониторинга, управления затратами и аудита. Основной посыл: без системной архитектуры, стандартов разработки и операционных процессов ML остаются «модными» экспериментами, которые не приносят бизнес-ценности. Напротив, дисциплинированная эволюция ML во всей организации требует согласованных ролей, инструментов, процессов и инфраструктурной поддержки.
Введение
За последние годы организациям удалось снизить барьеры к внедрению ML: появились готовые платформы, стандартизированные паттерны развёртывания и методики контроля качества. Но это только часть пути. Ключевая мысль состоит в том, что переход к эксплуатации требует не только технических решений, но и управленческих изменений: внедрения жизненного цикла моделей, прозрачной себестоимости, устойчивых процессов обновления и безопасного управления данными. В этой главе мы проследим эволюцию ML-инициатив: от экспериментов на отдельных проектах к централизованному, повторяемому и мониторируемому ML-пайплайну в рамках архитектурной модели MLOps.
Мы будем рассматривать как теоретические основы, так и практики реальных организаций, включая открытые и локальные (российские) решения. Особое внимание уделим тому, как выбирать инфраструктуру для ML в условиях облака и on-premise, как достигать масштабирования без взрывного роста затрат, и как внедрять устойчивый процесс эксплуатации моделей в бизнес-процессы.
Теоретические основы и терминология
- Модели жизненного цикла ML (ML lifecycle): от идеи к эксплуатации через фазы экспериментирования, внедрения, мониторинга и обновления.
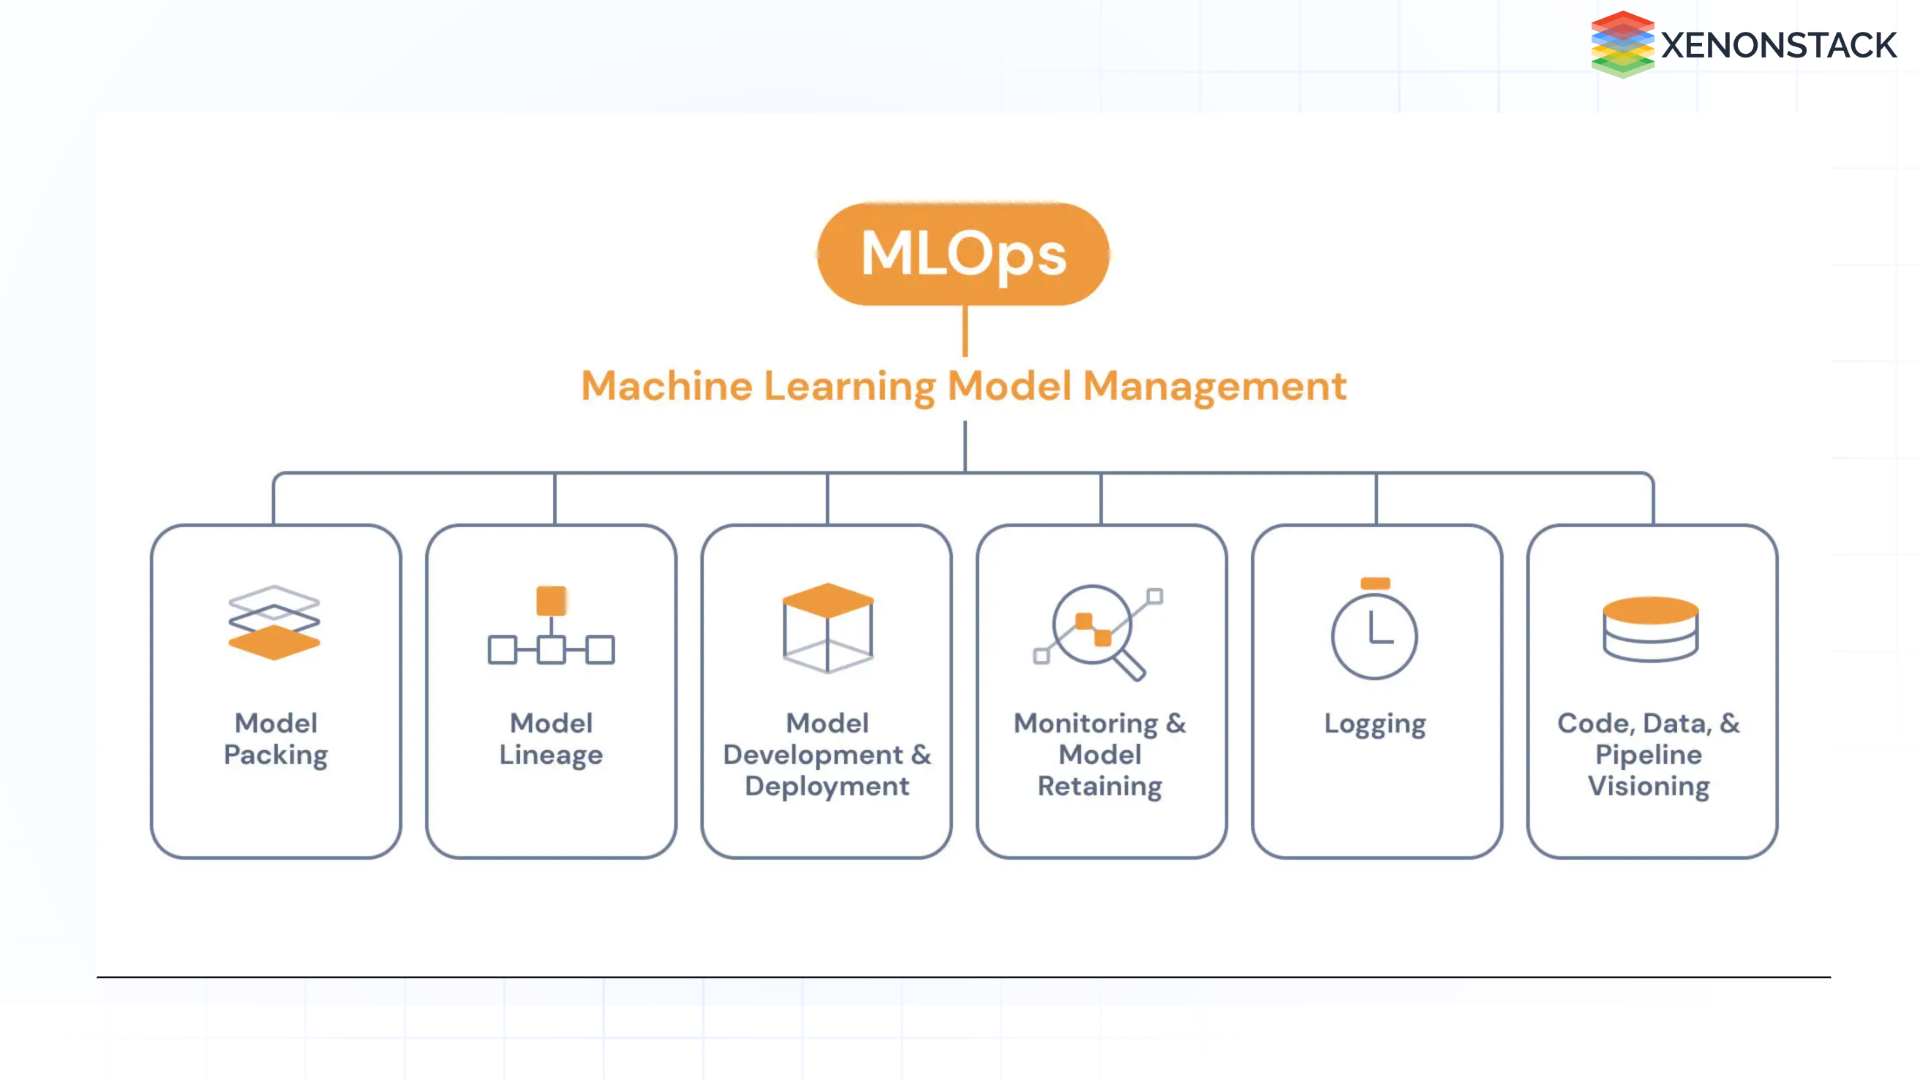
- MLOps: принципы, стандарты и практики для автоматизации, воспроизводимости и управления качеством ML-решений на протяжении полного цикла.
- Репродуцируемость и управляемость: версии данных, версионирование моделей, управление зависимостями и воспроизведение результатов.
- Feature store и data lineage: механизмы хранения признаков и трассировки происхождения данных для повторного использования и аудита.
- Архитектурные паттерны развёртывания: онлайн-сервисы (serving), батчевые конвейеры (ETL/ELT), потоковые вычисления.
- Принципы контроля затрат: cost-aware ML, подсчёт TCO/TCO на жизненном цикле моделей, ранжирование задач по бизнес-ценности и стоимости.
Ключевые термины, которые будут использоваться в тексте:
- CI/CD для ML (CI/CD for ML)
- Continuous Training (CT)
- Continuous Deployment (CD)
- Feature Store
- Model Registry
- Observability и Monitoring
- Data Drift и Concept Drift
- Governance и Compliance
Методологии и подходы
- Эволюционный путь: от прототипирования к промышленной эксплуатации через уровни зрелости ML-практик: исследовательский, распределённый пилот, серийное внедрение.
- Архитектурные слои: дата-инфраструктура, платформа разработки и обучения, платформа развёртывания и эксплуатации.
- Управление данными: качество, качество данных, защитa персональных данных, этические аспекты и соответствие регуляторным требованиям.
- Инструментальная экосистема: выбор инструментов для экспериментации, версионирования, оркестрации, мониторинга и управления затратами.
- Управление стоимостью и экономическая эффективность: прогнозирование затрат, автоматическое масштабирование и отключение неэффективных вычислений.
Цель методологий - обеспечить гладкий переход от «пальцевых» прототипов к устойчивым цепочкам поставки моделей в бизнес-процессы без потери качества и управляемости.
Архитектура и технологическая реализация
- Общая архитектура ML-платформы:
- Data Lake / Data Warehouse: источник и сохранение исходных данных.
- Feature Store: система хранения признаков с версионированием и доступом к ним.
- Model Registry: каталог моделей, метаданные, версии, окружения и тесты.
- DevOps и CI/CD для ML: пайплайны сборки, тестирования, развёртывания и мониторинга.
- Serving слои: онлайн- и офлайн-обработку, API для приложений.
- Monitoring и Observability: метрики производительности моделей, drift-детекция, провизоринг ресурсов.
- Инфраструктурные варианты:
- Облако: масштабируемость, гибкость, готовые сервисы для хранения, вычислений и оркестрации (Kubernetes, managed ML сервисы).
- On-premise: контроль над данными, требования к безопасности, устойчивость к задержкам и регуляторным ограничениям.
- Гибрид: частный кластер для чувствительных данных и публичный для вычислительных задач.
- Примеры технологических стеков:
- Оркестрация конвейеров: Kubeflow Pipelines, Apache Airflow, Dagster.
- Обучение и хранение моделей: MLflow, MLflow Models, DVC.
- Feature Store: Feast, Hopsworks Feature Store.
- Модели и сервисы: Python, контейнеризация (Docker), Kubernetes, Seldon Core, KFServing.
- Мониторинг: Prometheus, Grafana, OpenTelemetry.
- Пример архитектурной схемы (описание):
- Источник данных → Data Processing Layer → Feature Store → Model Registry → Training Pipelines → Candidate Models → Staging → OnlineServing / BatchServing → Monitoring/Feedback Loop → Cost Management.
- Протоколы и интеграции:
- REST/gRPC для взаимодействия между сервисами.
- Apache Kafka или RabbitMQ для потоков данных.
- YAML/JSON в конфигурациях пайплайнов и CI/CD.
- Метаданные и протоколы репозитория: Git, ML Metadata, DVC для версионирования данных и моделей.
Пример кода: простой конвейер обучения и регистрации модели (псевдокод на Python с использованием MLflow)
# Пример: обучение модели и логирование в MLflow
import mlflow
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import pandas as pd
загрузка данных
df = pd.read_csv('data/train.csv')
X = df.drop('target', axis=1)
y = df['target']
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)
with mlflow.start_run(run_name='rf_training'):
model = RandomForestClassifier(n_estimators=200, random_state=42, n_jobs=-1)
model.fit(X_train, y_train)
preds = model.predict(X_val)
acc = accuracy_score(y_val, preds)
mlflow.log_metric('val_accuracy', acc)
mlflow.sklearn.log_model(model, 'rf_model')
- Этот пример иллюстрирует базовую практику: логирование метрик и сохранение модели в реестре для повторного использования.
- В реальном проекте к этому добавляются этапы валидации, A/B-тестирования, сохранение версий данных и окружений, а также интеграция с системой мониторинга затрат.
Организационные и процессные аспекты
- Роли и ответственность:
- Data Scientist: развитие моделей, эксперименты, валидация гипотез.
- ML Engineer / MLOps Engineer: инфраструктура, пайплайны, автоматизация, поддержка CI/CD.
- Data Engineer: подготовка данных, качество данных, интеграции.
- Product Owner и бизнес-аналитики: формулирование бизнес-целей, метрик успеха.
- Compliance и Governance: контроль за безопасностью, соответствием регуляторным требованиям.
- Процессы и политики:
- Управление версиями данных и моделей.
- Регистрация и обзор изменений в моделях (Model Registry).
- Контроль качества данных и drift-детекция.
- Управление затратами: бюджетирование, лимиты, алертинг.
- Внедрение и обновления: CI/CD конвейеры, этапы тестирования, canary и blue/green развёртывания.
- KPI зрелости ML-подразделения:
- Время цикла от идеи до эксплуатации (Time-to-Value).
- Доля моделей с мониторингом и управляемыми обновлениями.
- Стоимость обработки единицы бизнес-метрики.
- Уровень соответствия регуляторным требованиям и аудита.
Практические примеры и кейсы (open-source и российские решения)
- Open-source кейсы:
- Kubeflow: управляемые пайплайны, обучение и развёртывание в Kubernetes.
- MLflow: трекинг экспериментов, хранение артефактов, пакетная регистры моделей.
- Feast (Feature Store): централизованный доступ к признакам, версионирование и совместное использование.
- Dagster: orchestration и тестирование пайплайнов, тестируемость и observability.
- Российские решения и практики:
- Яндекс DataSphere (Яндекс DataSphere): платформа для подготовки данных, обучения и развёртывания моделей в рамках экосистемы Яндекса; поддерживает интеграцию с локальными и облачными ресурсами.
- СберCloud ML Ops: набор инструментов и практик для управления ML-циклами в рамках инфраструктур Сбера, включая мониторинг, контроль затрат и безопасное развёртывание.
- Локальные решения на базе Kubernetes и институтских стеков: использование открытых инструментов в сочетании с корпоративными требованиями к безопасности и конфиденциальности.
- Аналитика кейсов:
- Применение моделей прогнозирования спроса и ценообразования в рознице с использованием облачных и локальных вычислений.
- Мониторинг качества моделей в реальном времени и автоматическое обновление на основе drift-детекции.
- Управление затратами через ограничение вычислительных ресурсов и автоматическое масштабирование в периоды пиковой нагрузки.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Архитектура реального конвейера:
- Источник данных → Data Processing → Feature Store → Model Registry → Training Pipeline → Validation → Canary Deployment → Online Serving → Feedback → Monitoring → Cost Control.
- Примеры протоколов интеграции:
- REST/ gRPC между микросервисами сервиса рекомендаций и мониторинга.
- Kafka для потока данных и событий об обновлениях данных.
- S3-compatible хранилища для артефактов и данных.
- Метрики и мониторинг:
- Метрики точности, F1, ROC-AUC на валидации.
- Drift-метрики для данных и концепций (Data Drift, Concept Drift).
- Метрики затрат: стоимость вычислений, загрузка графа, простаивание ресурсов.
- Примеры архитектурной схемы (описание визуализации):
- Слои: Data Layer (источники данных), Compute Layer (обучение и инференс), Serving Layer (API), Observability Layer (мониторинг и аудиты).
- Безопасность и соответствие:
- Шифрование данных на хранении и при передаче.
- Управление доступами по ролям (RBAC), аудит действий.
- Защита персональных данных: минимизация данных, псевдонимизация, анонимизация.
- Пример конфигурации инфраструктуры (фрагмент YAML для Kubernetes и Kubeflow Pipelines)
apiVersion: argoproj.io/v1alpha1 kind: Workflow metadata: generateName: ml-training- spec: entrypoint: train-pipeline templates: - name: train-pipeline dag: tasks:
- name: data-prep template: data-prep
- name: train-model dependencies: [data-prep] template: train
- name: register-model dependencies: [train-model] template: register
- name: data-prep container: image: myorg/data-prep:latest command: ["python", "prep.py"]
- name: train container: image: myorg/ml-trainer:latest command: ["python", "train.py"]
- name: register container: image: myorg/model-registry:latest command: ["python", "register.py"]
- Пример конфигурации модели в Model Registry:
{ "model_name": "customer_ltv_forecast", "version": "v1.2.0", "framework": "lightgbm", "metrics": { "val_accuracy": 0.87, "f1_score": 0.82 }, "production": false, "description": "Model for predicting Customer Lifetime Value", "env": { "python": "3.9", "dependencies": ["numpy>=1.21", "pandas>=1.3", "lightgbm>=3.3"] } } - Эти примеры иллюстрируют принципы: повторяемость, воспроизводимость и безопасную эксплуатацию.
Риски, ограничения и типовые ошибки
- Риски:
- Data drift и концептуальный дрейф: данные начинают меняться быстрее, чем адаптируются модели.
- Проблемы безопасности и приватности: утечки данных, использование данных без согласия.
- Проблемы качества данных: пропуски, аномалии, источники ложных сигналов.
- Рост затрат и неконтролируемое масштабирование: вычислительные расходы растут быстрее, чем бизнес-выгода.
- Неправильное использование моделей: энд-ту-энд риск, нарушение регуляторных требований.
- Ограничения:
- Не все задачи подходят под единый стандартный конвейер; требуется адаптация под бизнес-цели и регуляторные условия.
- Сложность интеграции между различными инструментами и платформами.
- Типовые ошибки:
- Недооценка важности версионирования данных и окружений.
- Отсутствие должного мониторинга и алертинга.
- Игнорирование управляемости затрат в процессе эксплуатации.
- Неправильная постановка целей и недостаточная валидность бизнес-метрик.
Перспективы развития направления
- Расширение автоматизации: автоматическая настройка гиперпараметров, автоматическое тестирование пайплайнов, автоматическое обновление моделей на основе drift-детекции.
- Масштабирование архитектуры: переход к микроархитектурам и гибридным инфраструктурам с использованием edge-вычислений для персонализированных сервисов и задержек.
- Расширение роли управления затратами: внедрение более точного прогнозирования TCO, оптимизация использования ресурсоемких вычислений и автономное масштабирование.
- Рост роли регуляторной и этической составляющей: аудиты моделей, обеспечение прозрачности и объяснимости принятых решений.
- Развитие отечественных технологий и локальных решений: усиление интеграций с Яндекс DataSphere и отечественными облачными и инфраструктурными решениями, адаптация под требования российского рынка.
Заключение
Эволюция ML в организациях - это многогранный процесс, включающий технические, управленческие и регуляторные аспекты. Перевод ML-проектов из стадии экспериментов в эксплуатацию требует четкой архитектуры, зрелых процессов и согласованных ролей. В условиях облачных и локальных инфраструктур успех зависит от выбора правильной комбинации технологий, политики управления затратами и эффективной организационной культуры, ориентированной на бизнес-цели. В рамках курса мы будем подробно рассматривать конкретные решения, методологии и практики, которые позволяют системно разворачивать и поддерживать ML-эксплуатацию на масштабе всей организации.
Вопрос-Ответ (FAQ)
Что такое переход от экспериментов к эксплуатации в контексте ML?
Это стадия унифицирования подхода: от локальных пилотов к промышленной эксплуатации через стандартизацию пайплайнов, версионирование данных и моделей, мониторинг и управление затратами. Основная цель - обеспечить воспроизводимость, масштабируемость и бизнес-ценность, а не только впечатляющие метрики на тестовых данных.
Какие ключевые архитектурные слои нужны для устойчивой MLOps-платформы?
Источник данных и обработка → Feature Store → Model Registry → Training Pipelines → Validation/ Canary → Online/Batch Serving → Monitoring и Cost Control. Важна тесная интеграция между слоями, обеспечение безопасности и управляемости.
Как выбрать между облаком и on-premise для ML-платформы?
В выборе важны регуляторные требования, доступ к данным, задержки сервиса, стоимость и требования к безопасности. Облако обеспечивает масштабируемость и гибкость, on-premise - контроль над данными и соответствие строгим регламентам. Гибридные подходы позволяют совместить преимущества обоих вариантов.
Какие типичные инструменты применяются для orchestration и пайплайнов?
Kubeflow Pipelines, Apache Airflow, Dagster. Эти платформы позволяютDefining и автоматизировать конвейеры подготовки данных, обучения моделей и тестирования, а также управлять зависимостями и версиями.
Что такое Data Drift и Concept Drift, и как их обрабатывать?
Data Drift: изменение распределения входных данных во времени. Concept Drift: изменение зависимостей между входами и целевой переменной. Обрабатывать можно мониторингом качества данных и модели, автоматической переобучаемостью, тестированием на свежих данных и быстрому обновлению моделей через CI/CD для ML.
Какие существуют практики для контроля затрат в ML-проектах?
Прогнозирование и лимиты использования ресурсов, автоматическое масштабирование, canary-развертывания, остановка неиспользуемых экземпляров, выбор оптимальных алгоритмов и инфраструктурных конфигураций. Включение cost-метрик в пайплайны и регуляторные алерты.
Какие примеры российских и open-source решений стоит рассматривать на стадии внедрения?
Open-source: Kubeflow, MLflow, Feast, Dagster. Российские возможности: Яндекс DataSphere как платформа для подготовки данных, обучения и развёртывания моделей в рамках экосистемы Яндекса; решения на базе СберCloud ML Ops для управления конвейерами и мониторинга в рамках инфраструктур Сбера.
Как обеспечить регуляторную и этическую совместимость ML-решений?
Включение governance-процессов: аудит данных и моделей, ретроспективы валидаций, документирование моделей и решений, обеспечение объяснимости и мониторинга возможной дискриминации. Соблюдение регуляторных требований и конфиденциальности данных должно быть встроено в архитектуру и процессы.
Какие практические шаги предпринять для перехода от пилота к эксплуатации?
Определить цель и бизнес-метрики, выбрать стек, настроить Model Registry и Feature Store, реализовать CI/CD для ML, внедрить мониторинг и drift-детекцию, запланировать план обновления и регламент аудита. Постепенно переводить пилоты в серийные развёртывания.
Как оценивать успешность внедрения MLOps в организации?
Важны не только метрики точности моделей, но и скорость цикла внедрения, стабильность пайплайнов, прозрачность затрат, контроль качества данных, возможность аудита и соблюдение регуляторных требований. Успех измеряется бизнес-ценностью, устойчивостью и управляемостью ML-процессов.
Если ваша компания планирует внедрение машинного обучения или масштабирование AI-решений, ключевым фактором успеха становится правильная архитектура платформы данных и MLOps-инфраструктуры.
Узнайте, как реализовать искусственный интеллект для бизнеса от стратегии до внедрения: от оценки готовности компании и выбора архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и систем генеративного AI, интегрированных в ключевые бизнес-процессы.


