

Интеграция с оркестраторами и пайплайнами: Airflow, Kubeflow, Dagster, Prefect
Краткое введение
Эффективная повторная загрузка признаков требует не только хранения и версионирования данных, но и точной синхронизации между этапами подготовки, обучения и инференса. Оркестраторы и пайплайны позволяют управлять зависимостями, обеспечивать повторяемость и управлять политиками доступа. В этой главе мы рассмотрим архитектуры интеграции feature store с популярными оркестраторами: Apache Airflow, Kubeflow Pipelines, Dagster и Prefect, а также обсудим подходы к управлению версиями признаков, доступами, качеством данных и безопасностью в рамках обучающих пайплайнов.
- Введение
Фичер стор (feature store) - это системная подсистема для хранения, управления и версионирования признаков, используемых в моделях машинного обучения. Основные задачи интеграции с оркестраторами:
- обеспечение консистентности между процессами подготовки данных, обучения и инференса;
- повторное использование признаков между пайплайнами и целями проекта;
- управление версиями признаков и их доступами;
- прозрачность метаданных и трассируемость.
Ключевые понятия:
- Feature group (группа признаков): логическая единица хранения набора признаков, пригодного для повторного использования.
- Feature versioning: механизм хранения изменений признаков и их версий.
- Training pipeline vs inference pipeline: конвейеры подготовки и использования признаков в обучении и в инференсе.
- Metadata и lineage: отслеживание источников данных, зависимости и использование признаков.
- Access control (RBAC/ABAC): разграничение доступа к данным признаков, контроль по ролям и политикой.
- Теоретические основы и терминология
- Оркестрация vs. планирование задач: оркестраторы обеспечивают планирование и исполнение задач по DAG, слепок времени выполнения и мониторинг.
- Idempotency и повторяемость: повторное выполнение должно приводить к тем же результатам, особенно важно для обучения и версии признаков.
- Real-time (онлайн) vs batch (оффлайн): онлайн- STORE обеспечивает низкую задержку доступа к признакам для инференса; офлайн-хранение оптимизировано под массовые расчеты на обучении.
- Версионирование признаков: стратегия именования версий, например, feature_name@version или feature_group версионирование по метаданным.
- Nature of events меняется: concepts include “feature drift”, “data drift” и регламентированное обновление признаков.
- Методологии и подходы
- Архитектурные паттерны интеграции:
- Паттерн pull-схемы: пайплайн запрашивает признаки из store в момент выполнения задачи.
- Паттерн push-схемы: источник данных признаков публикует обновления в store, после чего пайплайн может реагировать на триггеры.
- Управление версиями и релизами признаков:
- Непрерывная интеграция признаков: новые версии признаков тестируются в отдельной среде, затем развертываются в продакшн.
- Канал деградации и откат: возможность откатиться к предыдущей версии признаков без нарушения пайплайнов.
- Безопасность и контроль доступа:
- RBAC/ABAC для чтения и записи признаков, включая ограничения по окружению (dev/test/prod).
- Шифрование передачи и хранения данных признаков.
- Качество данных и валидация:
- Data validation steps на входе пайплайна (check schemas, nulls, ranges).
- Drift detection для признаков, мониторинг churn и валидности временных окон.
- Архитектура и технологическая реализация
Общая схема интеграции:
- Источник данных -> Feature Store (online/offline storage) -> Оркестратор/Пайплайн -> Модель/Сервис инференса
- Метаданные и lineage ведутся в ML Metadata/Open Metadata или аналогичном инструменте.
- Управление доступами к признакам осуществляется через интеграцию с IAM/OIDC и централизованный RBAC.
Типовые компоненты:
- Оркестратор: Airflow, Kubeflow Pipelines, Dagster, Prefect.
- Feature Store: Feast (Open Source), собственные реализации, интеграция с Yandex DataSphere, Sber ML Platform и пр.
- Хранение признаков: офлайн-слой (Parquet/ORC в HDFS/OSS), онлайн-слой (Key-Value stores: Redis, Redis Flash, Cassandra, ClickHouse за низкой задержкой).
- Метаданные и lineage: MLMD/Open Metadata, собственные метадменеджеры.
- Безопасность: OAuth/OIDC, Key Management Service (KMS), политики роли.
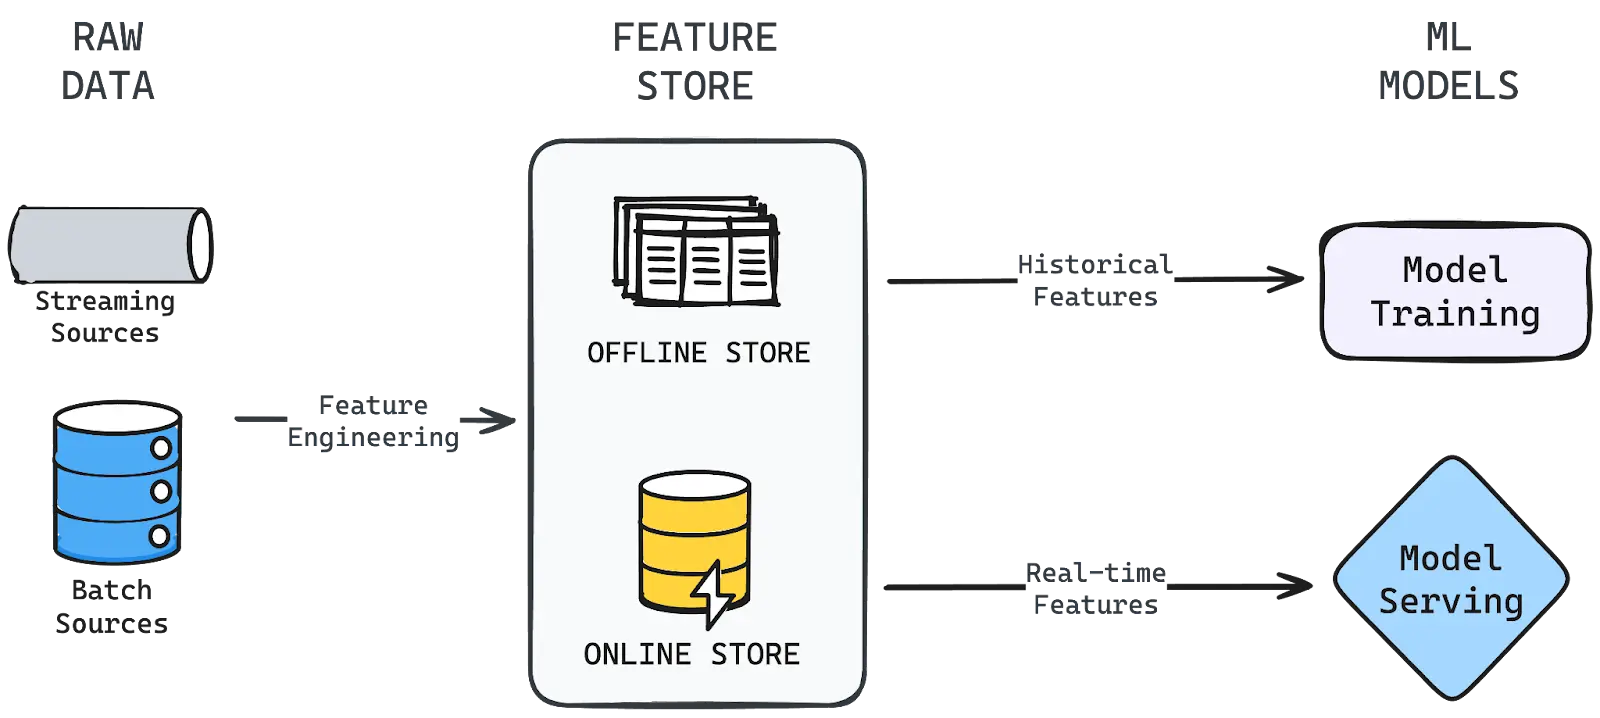
Схемы интеграций:
- Интеграция Airflow -> Feast:
- Airflow DAG вызывает задачи, которые загружают признаки в обучение, а затем сохраняют новую версию признаков и обновляют модель.
- Интеграция Kubeflow Pipelines -> Feast:
- Kubeflow Pipeline шаги (containers) получают признаки через Feast, затем обучают модель внутри Pipeline.
- Интеграция Dagster -> Feast:
- Dagster solids читают признаки, вносят их в пайплайн, а также выполняют проверки качества.
- Интеграция Prefect -> Feast:
- Prefect flows управляют загрузками признаков и передачей их в пайплайны.
Техническая детализация по каждому оркестратору:
- Apache Airflow:
- Используйте Airflow Operators для взаимодействия с feature store (например, PythonOperator, BashOperator с CLI Feast, или кастомный operator).
- Пример: запуск задачи обучения после успешной загрузки признаков и обновления версии.
- Пример метаданных: храните в XCom ссылки на конкретные версии признаков, используемые в обучении.
- Kubeflow Pipelines:
- Kubeflow поддерживает артефакты и зависимости через артефактные типы. Прямые вызовы к Feast через Kubeflow components допустимы.
- Используйте артефакты признаков и шаги кэширования. Поддерживайте версионирование признаков в артефактных хранилищах.
- Dagster:
- Dagster поддерживает более выразимые зависимости через solids и resources. Прямые вызовы к Feast через Python SDK, кэширование признаков.
- Обратите внимание на повторное использование ассетов (Assets) и стейтов обработки признаков в Dagster.
- Prefect:
- Prefect Flux/Flows может использоваться как orchestration layer. Реализуйте задачи получения признаков, валидацию, а затем передачу в обучения.
- Feast как пример feature store:
- Feast поддерживает онлайн/офлайн слои, версионирование признаков, схемы и разрешения к атрибутам. Пример проекта: определения feature_group, валидаторы, и снапшоты baсkend-слоя.
Таблица: сравнение подходов интеграции с оркестраторами
| Оркестратор | Подход к интеграции | Преимущества | Важные детали |
|---|---|---|---|
| Airflow | PythonOperator/CustomOperator + Feast API | Простота, зрелость | Хорошо подходит для офлайн обучения; контроль версий через метаданные |
| Kubeflow Pipelines | Kubeflow component steps + Feast API | Интеграция в MLOps Kubernetes | Эффективна для масштабируемых ML платформах; поддерживает параллелизм |
| Dagster | Dagster solids + resources | Хороший DX, тестируемость | Глубокая интеграция с типами данных и линейностью |
| Prefect | Flow задач + API вызовы | Элегантный API, динамичность | Быстрая настройка; отлично подходит для гибких пайплайнов |
| Feast (как слой) | API взаимодействие | Простое управление признаками | Версионирование, онлайн/оффлайн слои, схема данных |
- Организационные и процессные аспекты
- Управление жизненным циклом признаков:
- Создание, публикация новой версии признаков, деградация и откат.
- Определение политик expire- и retention-intervalов для признаков.
- Governance и доступы:
- Определение ролей: data scientist, ML engineer, data engineer, business owner.
- Разграничение доступа к версиям признаков, окружениям и наборам признаков.
- Контроль качества:
- Валидаторы схем, типы данных, диапазоны значений.
- Тестирование сквозной цепи: от источника до обучения.
- Мониторинг и аудит:
- Метрики использования признаков, задержки, частоты обновления, ошибок.
- Логирование изменений в признаках и версий.
- Управление конфигурациями пайплайнов:
- Использование централизованных конфигураций, секретов, переменных окружения.
- Практические примеры и кейсы (open-source и российские решения)
Open-source решения:
- Feast + Airflow: пример использования Feast API в Airflow DAG для загрузки признаков перед обучением.
- Feast + Kubeflow: интеграция через Kubeflow Pipelines с использованием Feast как базы признаков.
- Dagster + Feast: демонстрация использования Dagster solids для чтения признаков, валидации и обучения.
- Prefect + Feast: поток, где признаки запрашиваются на этапе подготовки данных и передаются в обучающие задачи.
Российские и локальные решения:
- Яндекс DataSphere: российская облачная платформа для ML, включает управление признаками и интеграцию с пайплайнами. Применение: хранение признаков, версионирование, управление доступами и интеграция с обучающими пайплайнами через API DataSphere.
- Тинькофф АI Платформа (пример российского кейса): локальная интеграция feature store в ML пайплайны, использование версии признаков и контроль доступа для банковских моделей. Обеспечивает реплики признаков в продакшн и тестовые окружения.
- Сбер ML/AI-платформы (пример российского кейса): интеграция feature store с оркестраторами и пайплайнами, управление версиями, безопасный доступ, мониторинг качества признаков и своевременная актуализация для регуляторных требований.
- Примеры локального развёртывания Feast на российских кластерах: Feast с локальными онлайн-хранилищами (Redis) и оффлайн-хранилищами (ClickHouse/Parquet в HDFS), интеграция с внутренними системами хранения данных.
Практические кейсы:
- Кейс 1: банковская модель риска
- Признаки риска обновляются каждый день; Feast хранит версии признаков для тренировки и для инференса.
- Airflow DAG orchestrates: загрузка признаков, валидация, обучение и развертывание.
- Контроль доступа: RBAC на уровне «кто может читать какие версии признаков» в prod и dev.
- Кейс 2: рекомендательная система в телеком
- Реализация онлайн-проса признаков через онлайн-слой Feast, диспатчинг в режим инференса.
- Kubeflow Pipelines обеспечивает параллельную обработку большого объема признаков.
- Кейс 3: корпоративная аналитика на базе DataSphere
- Интеграция с Open Metadata для трассируемости и lineage.
- Разграничение по проектам: разные наборы признаков для разных бизнес-юнитов.
- Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Модели хранения признаков:
- Офлайн: Parquet/ORC в HDFS/облачном объектном хранилище; версии сохраняются как метаданные.
- Онлайн: Redis, Redis on Flash, Cassandra, ClickHouse для низкой задержки.
- Протоколы и API:
- Feast API: клиентские вызовы для чтения признаков по версии, метод get_online_features, get_historical_features.
- REST/gRPC интерфейсы: обмен данными между пайплайном и store.
- Подключение к источникам данных:
- Использование Kafka/Kinesis для стриминга признаков в онлайн-слой.
- ETL-процессы для загрузки признаков в оффлайн-слой: Spark или Flink.
- Безопасность:
- OAuth/OIDC для доступа к API хранения признаков.
- Защита данных в покое и в транзите, шифрование на уровне дисков и сетевого трафика.
- Управление секретами: Vault/KMS.
- Версионирование признаков:
- Версии привязаны к дата-времени и гиперпараметрам расчета признаков.
- Механизмы атомарного обновления версии признак-в-объект: feature_group_version, feature_version.
- QA и валидация признаков:
- Схемы: типы данных, допустимый диапазон, неприкосновенность.
- Пакет тестов: unit tests на функции feature generation, end-to-end тесты на пайплайны.
Пример кода: интеграция Airflow + Feast
- DAG: загрузка признаков, обучение и деплой модели
from airflow import DAG
from airflow.operators.python import PythonOperator
from datetime import datetime, timedelta
from feast import FeatureStore
def load_features(feature_view_names: list, project: str, entity_df: str): fs = FeatureStore(repo_path="path_to_repo")
Пример чтения онлайн признаков для обучения
features = fs.get_online_features(
    feature_refs=[f"{name}:latest" for name in feature_view_names],
    entity_rows=entity_df
).to_df()
# Сохранение в обучающую выборку
features.to_parquet("/tmp/train_features.parquet")
def train_model():
загрузка признаков и обучение модели
passdefault_args = {
"owner": "data-team",
"depends_on_past": False,
"start_date": datetime(2024, 1, 1),
"retries": 1,
"retry_delay": timedelta(minutes=15),
}
with DAG("feature_store_training", default_args=default_args, schedule_interval="@daily") as dag:
feat = PythonOperator(
task_id="load_features",
python_callable=load_features,
op_args=[["customer_age", "business_credit_score"], "default_project", "/path/entities.csv"],
)
train = PythonOperator(task_id="train_model", python_callable=train_model)
feat >> train
Пример кода: Kubeflow Pipelines + Feast
# pipeline.yaml
components:
- name: fetch_features
    container:
      image: feast_kubeflow_fetch:latest
      command: ["python", "fetch_features.py"]
- name: train_model
    container:
      image: train_model:latest
      command: ["python", "train.py"]
pipeline:
- fetch_features:
      outputs: features
- train_model:
      inputs: features
Пример кода: Dagster
from dagster import op, job
from feast import FeatureStore
@op
def read_features(context, entity_rows):
fs = FeatureStore(repo_path="path_to_repo")
features = fs.get_online_features(
feature_refs=["user_features:latest"],
entity_rows=entity_rows
).to_df()
return features
@op
def train(context, features_df):
обучение модели на features_df
pass
@job
def feature_store_training_job():
features = read_features({"user_id": [123, 456]})
train(features)
Пример кода: Prefect
from prefect import task, Flow
from feast import FeatureStore
import pandas as pd
@task
def fetch_features(entity_rows: dict) -> pd.DataFrame:
fs = FeatureStore(repo_path="path_to_repo")
features = fs.get_online_features(
feature_refs=["user_features:latest"],
entity_rows=entity_rows
).to_df()
return features
@task
def train_model(features: pd.DataFrame):
обучение модели
pass
with Flow("feature_store_training") as flow:
rows = {"user_id": [1, 2, 3]}
features = fetch_features(rows)
train_model(features)
- Риски, ограничения и типовые ошибки
- Неправильное версионирование признаков:
- Смешение версий и недоразумения между версиями приводят к неконсистентному обучению и деградации качества.
- Несогласованность онлайн и оффлайн слоёв:
- Обновление признаков в оффлайне без синхронного обновления онлайн-слоя приводит к рассинхронизации во время инференса.
- Утечки признаков (data leakage):
- Признаки, завязанные на целевую переменную из будущих данных, вызывают завышение метрик.
- Неправильная настройка RBAC:
- Доступ к чувствительным признакам ограничен ошибочно; риск регуляторных нарушений.
- Сложности с мониторингом:
- Отслеживание drift и качество признаков может быть неэффективным без интеграции с пайплайнами и метаданными.
- Проблемы с производительностью:
- Неправильная конфигурация онлайн-слоя, задержки в сетях, нехватка вычислительных ресурсов.
- Верификация совместимости версий:
- Обновления пайплайна и feature store могут приводить к несовместимостям без тестирования в staging.
- Перспективы развития направления
- Стандартизация и Open Feature:
- Расширение стандартов API и совместимости между разными оркестраторами и feature store.
- Гибридные схемы хранений признаков:
- Совмещение онлайн-слоя для инференса и оффлайн-слоя для обучения с автоматическими тестами на соответствие.
- Непрерывная доставка признаков в продакшн:
- Улучшение CI/CD для признаков, более тесная интеграция с моделями, автоматический откат.
- Улучшение управления данными и безопасностью:
- Расширение RBAC/ABAC и шифрования, более продвинутая политика доступа к признакам по проектам и ролям.
- Расширение кейсов монетизации признаков:
- Повышение эффективности повторного использования признаков между разными проектами и бизнес-юнитами.
- Заключение
Интеграция feature store с оркестраторами и пайплайнами - ключ к повторному использованию признаков, устойчивому управлению версиями и безопасному проведению обучающих и инференс-процессов. Комбинация проверенных инструментов (Airflow, Kubeflow, Dagster, Prefect) с современными архитектурными подходами к хранению признаков обеспечивает гибкость и масштабируемость. В условиях регуляторных требований и российских реалий, наличие локальных решений, таких как Яндекс DataSphere и крупные российские ML-платформы, позволяет строить безопасные и управляемые конвейеры на базе общепринятых стандартов и практик.
FAQ (Вопросы и ответы)
В чем разница между онлайн и оффлайн хранением признаков и зачем она нужна в пайплайнах?
Онлайн хранение рассчитано на низкую задержку и быстрый доступ к признакам во время инференса. Оффлайн хранение оптимизировано под массовые расчёты для обучения и воспроизводимости. В пайплайне вы обычно читаете данные из оффлайн-слоя для обучения, а онлайн-слой может использоваться для скоринга в реальном времени. Разделение устраняет компромисс между задержкой инференса и полнотой данных для обучения.
Как организовать версионирование признаков без хаоса?
Придерживайтесь единой политики версионирования: используйте immutable идентификаторы (например, feature_group_name@version, timestamp-version), храните маппинг версий в метаданных и связывайте версию признака с конкретной версией датасета и кодом расчета признаков. Автоматически тестируйте совместимость версий на staging-окружении.
Какие паттерны интеграции с Airflow наиболее надёжны?
Надёжной является паттерн push-подхода: обновляйте признаки и версии на этапе подготовки, затем используйте их в DAG как входные данные для обучения. Важно хранить ссылки на версии признаков в XCom или в артефактах задачи.
Что важно учитывать при выборе оркестратора?
Задачи: масштабируемость, распределённость кластера, способность интегрироваться с вашими хранилищами данных; требования к гибкости и тестированию; поддержка кросс-платформенных пайплайнов; безопасность и управление доступами.
Какие риски безопасности связаны с интеграцией feature store?
Возможные утечки признаков через неправильное разграничение доступа, совместная экспозиция данных между окружениями, проблемы с крипто-защитой. Решение: RBAC/ABAC, ограничение сетевого доступа, шифрование, аудит и мониторинг доступа.
Как выбирать стратегию доступа к признакам в разных окружениях?
Введите сетевые и логические границы между dev/test/prod. Используйте отдельные версионированные наборы признаков для каждого окружения и централизованный контроль доступа.
Какие практические индикаторы показывают, что интеграция успешна?
Стабильные метрики обучения (качество моделей и повторяемость результатов), низкая задержка доступа к признакам в онлайн-слое, надёжное обновление версий признаков, прозрачная трассируемость и доступность метаданных.
Какую роль играет Open Metadata/ML Metadata в таких системах?
Open Metadata обеспечивает единое представление линейности, связей между источниками данных, признаками, пайплайнами и моделями. Это упрощает аудит, поиск признаков, мониторинг и управление данными.
Какие типовые ошибки встречаются при внедрении на практике?
Неправильное управление версиями, несогласованность онлайн/оффлайн слоёв, пропуски в валидациях качества, слабый мониторинг drift’а признаков, недостаточная безопасность и контроль доступа.
Какие перспективы наиболее значимы для отрасли?
Повышение автономности пайплайнов благодаря автоматическим откатам, унификация стандартов взаимодействия между оркестраторами и feature store, расширение использования Open Metadata, усиление безопасности и соответствия регуляциям, а также прогресс в локальных российских платформах для ML.
Примечания для практикума
- Рекомендуется провести практикум на реальном наборе данных: создать небольшой feature store, подготовку признаков, реализовать обучающую пайплайн через Airflow и Kubeflow, сравнить производительность и задержки.
- В ходе практикума экспериментируйте с версионированием признаков, настройками RBAC и мониторингом качества признаков.
- Включите в тестовый набор кейсы и ограничения регуляторного поля, чтобы отработать безопасное управление доступами и аудит.
Дополним главы примерами и деталями по вашей инфраструктуре. Если хотите, могу подготовить адаптированную конфигурацию под конкретный оркестратор (например, только Airflow и Feast в существующем кластере) или расширить раздел о российской реализации на примерах вашего предприятия.
Feature Store становится важным элементом зрелой AI-платформы, позволяя масштабировать разработку моделей, управлять признаками и повышать повторное использование данных в ML-проектах.
Узнайте, как внедрить искусственный интеллект для бизнеса от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до создания AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в бизнес-процессы компании.


