

Эталонные архитектурные паттерны: data lakehouse, feature store и model registry
Краткое введение
Эта глава посвящена синергии трёх ключевых паттернов в рамках архитектуры данных и ML: data lakehouse, feature store и model registry. В контексте CI/CD для ML и MLOps они выступают фундаментом для воспроизводимости, управляемости и масштабируемости аналитических и ML-проектов. Понимание взаимосвязей между ними позволяет конструировать конвейеры, в которых данные, признаки и модели проходят целостный жизненный цикл: от инжестинга и подготовки данных до тестирования, деплоя и мониторинга моделей в продуктивной среде.
Уровень зрелости организаций в современной практике определяется именно тем, насколько едины и управляемы становятся источники данных, признаки и версии моделей. Эталонные архитектурные паттерны помогают решить ключевые задачи: согласование данных и признаков между этапами цикла жизни ML, обеспечение воспроизводимости экспериментов, автоматизацию тестирования и развёртывания, а также упрощение аудита и соответствия требованиям регуляторов.
Ниже мы последовательно рассмотрим теоретические основы, архитектурные решения, примеры реализации и практические кейсы, чтобы вы могли адаптировать эти паттерны под контекст своей организации - от стартапа до крупных корпораций с требованиями к локализации и контрольности данных.
Введение
Глубокая база паттернов data lakehouse, feature store и model registry опирается на синергию хранения и обработки данных, управления признаками и управляемого жизненного цикла моделей. Data lakehouse объединяет хранение неструктурированных и структурированных данных в едином пространстве с транзакционностью и схемой управляемостью; feature store обеспечивает централизованный доступ к повторно используемым признакам для обучающих и сервисных задач; model registry - централизованный реестр версий моделей, их метаданных и процессов развёртывания.
Эти паттерны особенно актуальны в рамках CI/CD для ML и MLOps, где ключевыми требованиями являются:
- воспроизводимость пайплайнов данных и моделей;
- контроль качества данных и признаков;
- управление версиями данных, признаков и моделей;
- автоматизация тестирования, развёртывания и откатов;
- видимость и трасируемость изменений по всей цепочке поставки данных.
Далее мы переходим к теоретическим основам и терминологии, чтобы закрепить общую логику и обеспечить единый язык для обсуждения архитектурных решений.
Теоретические основы и терминология
- Data lakehouse: архитектурный подход, который объединяет возможности data lake (хранение больших объемов данных в гибкой среде, часто в формате Parquet) и data warehouse (структурированность, ACID-транзакции, запросы с высокой производительностью). Основная идея - единое хранилище и единый метаданных слой для анализа, машинного обучения и оперативной аналитики.
- Feature store: системное место для хранения, версионирования и доступа к признакам. Разделяют offline store (для обучающих пайплайнов и отбора гиперпараметров) и online store (для онлайн-сервиса предсказаний). Важные концепты: feature lineage, feature validation, пакетная и онлайн-реализация, согласование схем.
- Model registry: централизованный реестр версий моделей, их артефактов (weights, scaler, конфигурации), метаданных (производительность, дата обучения, набор данных), а также механизмы деплоя, линейной и канарной проверки, откатов и аудита.
- CI/CD для ML и MLOps: подходы, которые связывают конвейеры данных, обучения, тестирования и развёртывания моделей в автоматизированные процессы с контролем качества и безопасностью. Включает тесты данных, тесты признаков, тесты модели, проверку инфраструктуры и мониторинг в проде.
- Данные и признаки как код: идея управления версиями не только моделей, но и самих данных и признаков; использование схем контрактов, тестов данных и валидаций на входах в конвейеры.
- Метаданные и трассируемость: хранение информации о происхождении данных, трансформациях, версиях признаков и моделей, связях между источниками, методами подготовки и параметрами обучения.
Методологии и подходы
- Контракты данных: формальные соглашения о составе, типах и валидности входных данных, потолках качества и допустимых изменениях.
- Тестирование данных и признаков: валидаторы схем, проверки качеств, тесты устойчивости к дрифту, тесты производительности на больших объемах.
- Валидация моделей: тесты на соответствие конфигурациям, тестовые наборы, canary-публикации и А/Б-тестирования гибких версий.
- Управление версиями и воспроизводимость: хранение артефактов, контроль версий по каждому элементу конвейера, прозрачность изменений и аудируемость.
- Архитектура как код: описания конвейеров, инфраструктуры и конфигураций как код, использование GitOps-подходов (например, Git как источник истины для конфигураций развёртывания).
- Безопасность и соответствие: контроль доступа, шифрование, локализация данных, журналирование и мониторинг событий доступа и изменений.
Архитектура и технологическая реализация
Ниже приведена целевая архитектура, объединяющая data lakehouse, feature store и model registry в едином конвейере CI/CD для ML:
- Источники данных -> Data ingestion/ETL -> Data lakehouse (хранение в формате Parquet, оптимизация через измеримый слой метаданных) -> Feature engineering -> Feature store (offline/online) -> Модели (training) -> Model registry -> Deployment/Serving (optional: model orchestration с использованием Kubeflow, MLflow или Seldon) -> Мониторинг и обратная связь (data drift, качество признаков, метрики модели).
Диаграмма архитектуры (упрощённая, текстовая):
- Источники данных
- raw data storage (data lake) -> ingestion/ETL -> lakehouse
- Признаки
- offline store (для обучения) <- feature engineering -> online store (для сервиса) -> сигнал к моделям
- Модели
- training -> model registry -> staging/production deployment
- Контроль и мониторинг
- валидации данных, тесты признаков, тесты моделей, мониторинг метрик
Чтобы иллюстрировать взаимосвязи, можно привести упрощённую схему на языке Mermaid (для совместимого визуального отображения):
flowchart TD
    A[Источники данных] --> B[Ingestion/ETL]
    B --> C[Data Lakehouse]
    C --> D[Offline Feature Store]
    D --> E[Model Training]
    E --> F[Model Registry]
    F --> G[Staging/Production Deployment]
    G --> H[Serving / Online Inference]
    H --> I[Monitoring & Feedback]
    C --> J[Schema & Metadata Catalog]
    J --> K[Data Governance & Compliance]
Технические подходы к реализации:
- Data Lakehouse: Apache Iceberg или Delta Lake как слой транзакционной управляемости над data lake; схема и эволюция схемы через миграционные файлы; ACID-транзакции при апдейтах и удалениях; Time Travel и версияция данных.
- Feature Store: Feast (open source) как центральный слой признаков; поддержка offline/online; механизм валидации признаков и управление версионированием; интеграция с системами мониторинга качества данных.
- Model Registry: MLflow Model Registry или аналогичные решения; хранение артефактов модели, связанных метаданных и параметров; интеграция с пайплайнами обучения и развёртывания; поддержка версионирования и роллов-баck.
- Операционные инструменты: orchestration (Airflow, Dagster, Kubeflow); мониторинг (Prometheus, OpenTelemetry); тестирование данных (Great Expectations), тесты признаков и моделей; инфраструктурная инфраструктура как код (Terraform, Kubernetes, Helm).
- Безопасность и соответствие: контроль доступа на уровне данных, признаков и моделей; аудит изменений; локализация данных (региональные требования); шифрование и управление ключами.
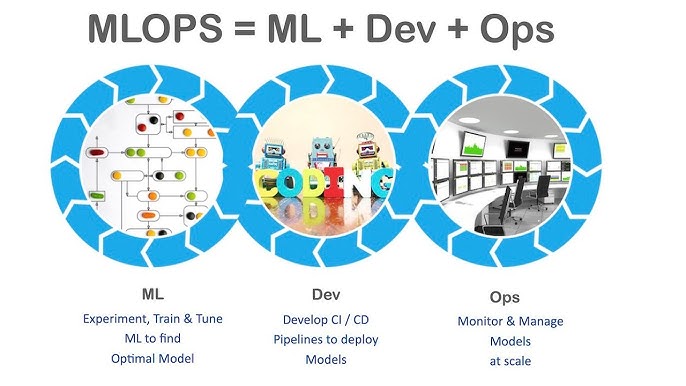
Архитектура и технологическая реализация (детали)
Общие принципы реализации:
- Согласованность между offline и online частями lakehouse и feature store: единая модель данных, единые форматы (Parquet/ORC), единый тип идентификаторов. Это обеспечивает сопоставимость обучающей и продовой среды.
- Контракты данных на уровне пайплайна: каждое изменение данных должно сопровождаться обновлением контрактов и тестами.
- Управление метаданными: к каждому артефакту (данным, признакам, моделям) привязаны метаданные: дата выпуска, набор данных, параметры, окружение, версия кода.
- Автоматизация тестирования на каждом этапе: тесты качества данных, тесты признаков, тесты моделей, тестирование инфраструктуры.
Технические детали реализации (примеры фрагментов кода и конфигураций):
- Пример YAML для конвейера Kubeflow Pipelines (обучение модели и регистрация в Model Registry):
apiVersion: v1 kind: Pipeline metadata: name: ml-pipeline spec: tasks: - name: data-prep template: data-prep
- name: train dependencies: [data-prep] template: train
- name: register-model dependencies: [train] template: register-model
- Пример Python-кода для регистрации признаков в Feast (feature store):
from feast import Feature, FeatureView, FileSource, ValueType
from feast.repo_config import RepoConfig
from datetime import timedelta
определяем источник признаков (offline)
driver_source = FileSource( name="driver_features", path="/data/feast/driver_features.parquet", date_partition_column="event_timestamp", )
driver_view = FeatureView( name="driver_features", ttl=timedelta(days=14), source=driver_source, schema=[
Feature(name="average_speed", dtype=ValueType.FLOAT),
    Feature(name="rides_completed", dtype=ValueType.INT32),
],
)
загрузка/регистрация
repo = RepoConfig(...)
repo.apply()
- Пример конфигурации MLflow для Model Registry:
export MLFLOW_TRACKING_URI=http://mlflow-tracking-server:5000 mlflow server --backend-store-uri sqlite:///mlflow.db --default-artifact-root /mlflow/artifacts - Пример конфигурации тестов данных в Great Expectations (expectation suite):
expectation_suite_name: data_quality_suite datasource: name: general class_name: Datasource data_connector_name: default_inferred_data_connector_name - Пример протокола взаимодействия между Online- и Offline-частью Feature Store:
- Offline: периодические обновления через ETL-пайплайн.
- Online: низколатентный доступ к признакам через кэшированную онлайн-таблицу (Redis, Redis-like или специализированные решения).
- Пример API для доступа к признакам в онлайн режиме:
GET /features/driver_features?date=2024-08-01&driver_id=12345 Authorization: Bearer - Архитектурные протоколы интеграции:
- Apache Kafka или Pulsar как потоковое сообщение для событий обновления признаков.
- REST/gRPC API для доступа к online-store и к модели.
- Реализация через Kubernetes с применением GitOps (ArgoCD) для деплоя конфига и пайплайнов.
Организационные и процессные аспекты
- Роли и ответственности:
- Data Stewards: ответственность за качество данных и соответствие контрактам.
- ML Engineers: разработка и поддержка моделей; поддержка репозитория артефактов и конфигураций.
- Platform Engineers: поддержка инфраструктуры, CI/CD pipelines и мониторинга.
- Compliance и Security: контроль доступа, аудит, локализация данных и соблюдение регуляторных требований.
- Процессы согласования изменений:
- Изменения в data contracts требуют прохождения тестов данных и согласования versioning.
- Внесение изменений в признаки требует обновления версии признак-евианта и миграционных сценариев.
- Контроль качества и аудит:
- Нормативные требования к журналированию: хранение журналов изменений, доступов и ошибок.
- Мониторинг и алертинг по метрикам данных и моделей: дрифт данных, деградация качества признаков, деградация метрик модели.
Практические примеры и кейсы (open-source и российские решения)
- Open-source решения и практики:
- Data lakehouse: Apache Iceberg, Delta Lake, Apache Hudi как базовый слой для единообразного хранения и транзакций.
- Feature store: Feast как открытая платформа для управления признаками; интеграции с различными источниками данных и онлайн/оффлайн магазинами.
- Model registry: MLflow Model Registry или аналогичные open-source решения, позволяющие отслеживать версии моделей и артефакты.
- Операционная среда: Kubeflow, Airflow, Dagster для оркестрации пайплайнов; Great Expectations для валидации данных; Seldon/TFServing для разворачивания моделей.
- Инфраструктура как код: Terraform, Kubernetes, Helm; GitOps через ArgoCD.
- Российские решения, практики и локализация:
- Интеграция с отечественными облачными платформами: Яндекс.Облако и СберОблако с поддержкой инфраструктурных и ML-подходов, адаптированных под требования локализации данных и регулятивов.
- Адаптация open-source стеков под российские условия: использование Kubeflow/MLflow в локализованных средах, локального хранения данных и интеграции с отечественными системами мониторинга и аудита.
- Кейсы организации локальных пайплайнов: внедрение data contracts и тестов качества данных на предприятиях с соблюдением требований к хранению и обработке персональных данных.
- Практики в рамках крупных российских организаций: применение Lakehouse-подходов и CICD для ML в контексте отечественных регулятивов и политики данных, с упором на прозрачность и аудит.
Понимание и адаптация этих кейсов позволят вам выстроить устойчивые конвейеры, которые легко масштабируются и поддаются аудиту в рамках требований РФ и глобальных стандартов.
Технические детали реализации (алгоритмы, схемы, протоколы, интеграции)
- Эволюция схем и контрактов:
- Миграции схем на уровне data lakehouse с проверкой совместимости.
- Валидация новых признаков через контрактные тесты.
- Контроль версий:
- Версионирование признаков и моделей.
- Резервное копирование и восстановление артефактной базы.
- Интеграции:
- Интеграция с системами мониторинга и алертинга на уровне данных и моделей.
- Инструменты трассировки цепочек обработки данных.
- Безопасность:
- Роли и политики доступа: на уровне данных, признаков и моделей.
- Шифрование данных в покое и в движении; аудит доступа к артефактам.
Риски, ограничения и типовые ошибки
- Неполная структуризация данных: без согласованных контрактов данные теряют предсказуемость.
- Несогласованность между offline и online признаками: приводит к рассинхрону между обучением и инференсом.
- Перегрузка пайплайнов: слишком сложные конвейеры приводят к деградации скорости развёртывания и отлаживания.
- Неправильное управление версиями артефактов: отсутствие аудита и воспроизводимости.
- Неправильная локализация и регуляторные риски: недостаточная защита персональных данных и отсутствие соответствующих механизмов аудита.
- Недостаточные тесты: отсутствие показа ошибок до продакшена и риск деградации сервиса.
Перспективы развития направления
- Эволюция lakehouse- архитектуры в сторону унифицированной платформы для данных, признаков и моделей, упрощая governance и compliance.
- Расширение возможностей data contracts и контрактного тестирования с автоматическими обновлениями и миграциями.
- Повышение роли мониторов и наблюдения за данными и моделями, включая использование искусственного интеллекта для прогнозирования сбоев пайплайна и деградации моделей.
- Развитие отечественного стека и интеграций в рамках локализации и соответствия требованиям РФ.
Заключение
Эталонные архитектурные паттерны data lakehouse, feature store и model registry формируют прочную основу для CI/CD в ML и MLOps. Их грамотная реализация обеспечивает воспроизводимость экспериментов, управляемость данных и признаков, а также надёжность и контроль версий моделей. Применение этих паттернов требует не только технической инфраструктуры, но и организационных процессов: контрактов данных, тестирования, аудита и культуры совместной ответственности за качество данных. В условиях быстро меняющегося рынка и регуляторной среды эти паттерны помогают предприятиям достигать устойчивой скорости инноваций без компромиссов по безопасности и соответствию.
FAQ (Вопросы и ответы)
Что делает data lakehouse по сравнению с традиционным data lake и data warehouse?
Data lakehouse объединяет преимущества обоих подходов: гибкость хранения больших объемов данных как в data lake и возможность управляемой схемности с транзакциями и эффективными запросами как в data warehouse. Это позволяет выполнять как оперативную аналитику, так и обучающие задачи ML на единообразной базе.
Какой смысл в разделении online/offline признаков в feature store?
Offline признаков подходят для обучения и повторного использования в повторных эксперах, онлайн признаки - для сервиса предсказаний с низкой задержкой. Разделение позволяет балансировать требования к скорости и точности, а также обеспечивает согласованность между обучением и инференсом.
Какие основные этапы в процессе развёртывания моделей через model registry?
Регистрация артефактов модели и связанного кода; контроль версий; проходение тестов и валидации; размещение в staging-окружении; canary/blue-green развёртывание в prod; мониторинг и управление обновлениями.
Какие типичные тесты стоит включить в пайплайн ML для CI/CD?
Тесты данных (валидаторы схем, качества, дрифт); тесты признаков (валидность и устойчивость); тесты моделей (производительность на валидационном наборе, сравнение с бэкап-версиями); тесты инфраструктуры (ресурсные лимиты, безопасность).
Какие инструменты чаще всего применяются для реализации этих паттернов в open-source?
Iceberg/Delta/Hudi для lakehouse, Feast для feature store, MLflow для registry, Kubeflow/Airflow/Dagster для оркестрации, Great Expectations для тестирования данных, Seldon/TFServing для инференса.
Какие российские особенности стоит учитывать при реализации?
Локализация данных и соответствие регулятивам, интеграция с отечественными облачными платформами (Яндекс.Облако, СберОблако), адаптация стэков под требования к аудитам и контролю доступа, обеспечение устойчивости к внешним ограничениям и сохранение тайминг-сервисов внутри страны.
Что отличает lakehouse от классического data warehouse в контексте ML?
Lakehouse сочетает гибкость хранения неструктурированных данных с транзакционной целостностью и эффективной аналитикой, что облегчает подготовку данных и инфраструктуру для ML, снижая барьеры между исследованием данных и продовым использованием.
Какую роль играет data governance в рамках этих паттернов?
Data governance обеспечивает управление данными, метаданными, правами доступа, качеством и соответствием контрактов, что критически важно для воспроизводимости и аудита, особенно в регуляторной среде.
Какие риски связаны с внедрением этих паттернов на ранних стадиях проекта?
Недостаточное вовлечение бизнес-областей, переусложнение архитектуры без четких бизнес-ценностей, неполное тестирование данных и признаков, риск задержек в развёртывании и повышенные операционные затраты.
Какие перспективы развития данных паттернов в рамках ML и MLOps в ближайшие годы?
Появление унифицированных платформ под единый слой управления данными, признаками и моделями; усиление контрактного тестирования и трассируемости; более тесная интеграция с отеческими облаками и регуляторными требованиями; расширение инструментов мониторинга и автоматизации для снижения операционных издержек и повышения скорости вывода моделей в продакшн.
Если ваша компания планирует масштабировать проекты машинного обучения, ключевым фактором становится создание устойчивой ML-платформы с практиками MLOps и автоматизированными CI/CD-процессами.
Узнайте, как внедрить искусственный интеллект для бизнеса - от стратегии до внедрения: от оценки готовности компании и архитектуры AI-платформы до разработки AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в ключевые бизнес-процессы.


