

Подготовка Kubernetes кластера для установки DataLens Enterprise On Premise
DataLens Enterprise On Premise предоставляет функциональность корпоративного уровня для анализа и визуализации данных в инфраструктуре заказчика. Успешная установка и дальнейшее сопровождение в больших организациях зависят от корректной подготовки Kubernetes кластера: выбора подходящих версий и конфигураций, обеспечения безопасности и согласованности окружения, подготовки хранилищ и сетей, а также выстроенной политики обновлений. В данной главе рассмотрены продуктовые аспекты подготовки кластера, необходимые компоненты и практики внедрения, а также практические сценарии эксплуатации и поддержки.
Введение в DataLens Enterprise On Premise в контексте Kubernetes требует уделять внимание не только техническим требованиям, но и управляемости, совместимости с существующей инфраструктурой и сценариями интеграции с системами обеспечения безопасности и мониторинга. В этом контексте задача методолога
-
предоставить понятную карту реального мира: какие компоненты разворачиваются, какие параметры кластера критичны, как выстроить процессы развёртывания и обновления, какие практики соблюдать для обеспечения доступности и надёжности сервиса.
-
Обзор архитектуры DataLens Enterprise On Premise и требования к Kubernetes.
-
Требования к кластеру, сетям, хранилищам и безопасности.
-
Пошаговый сценарий развёртывания и конфигурации DataLens на Kubernetes.
-
Управление жизненным циклом, обновлениями, мониторингом и интеграциями.
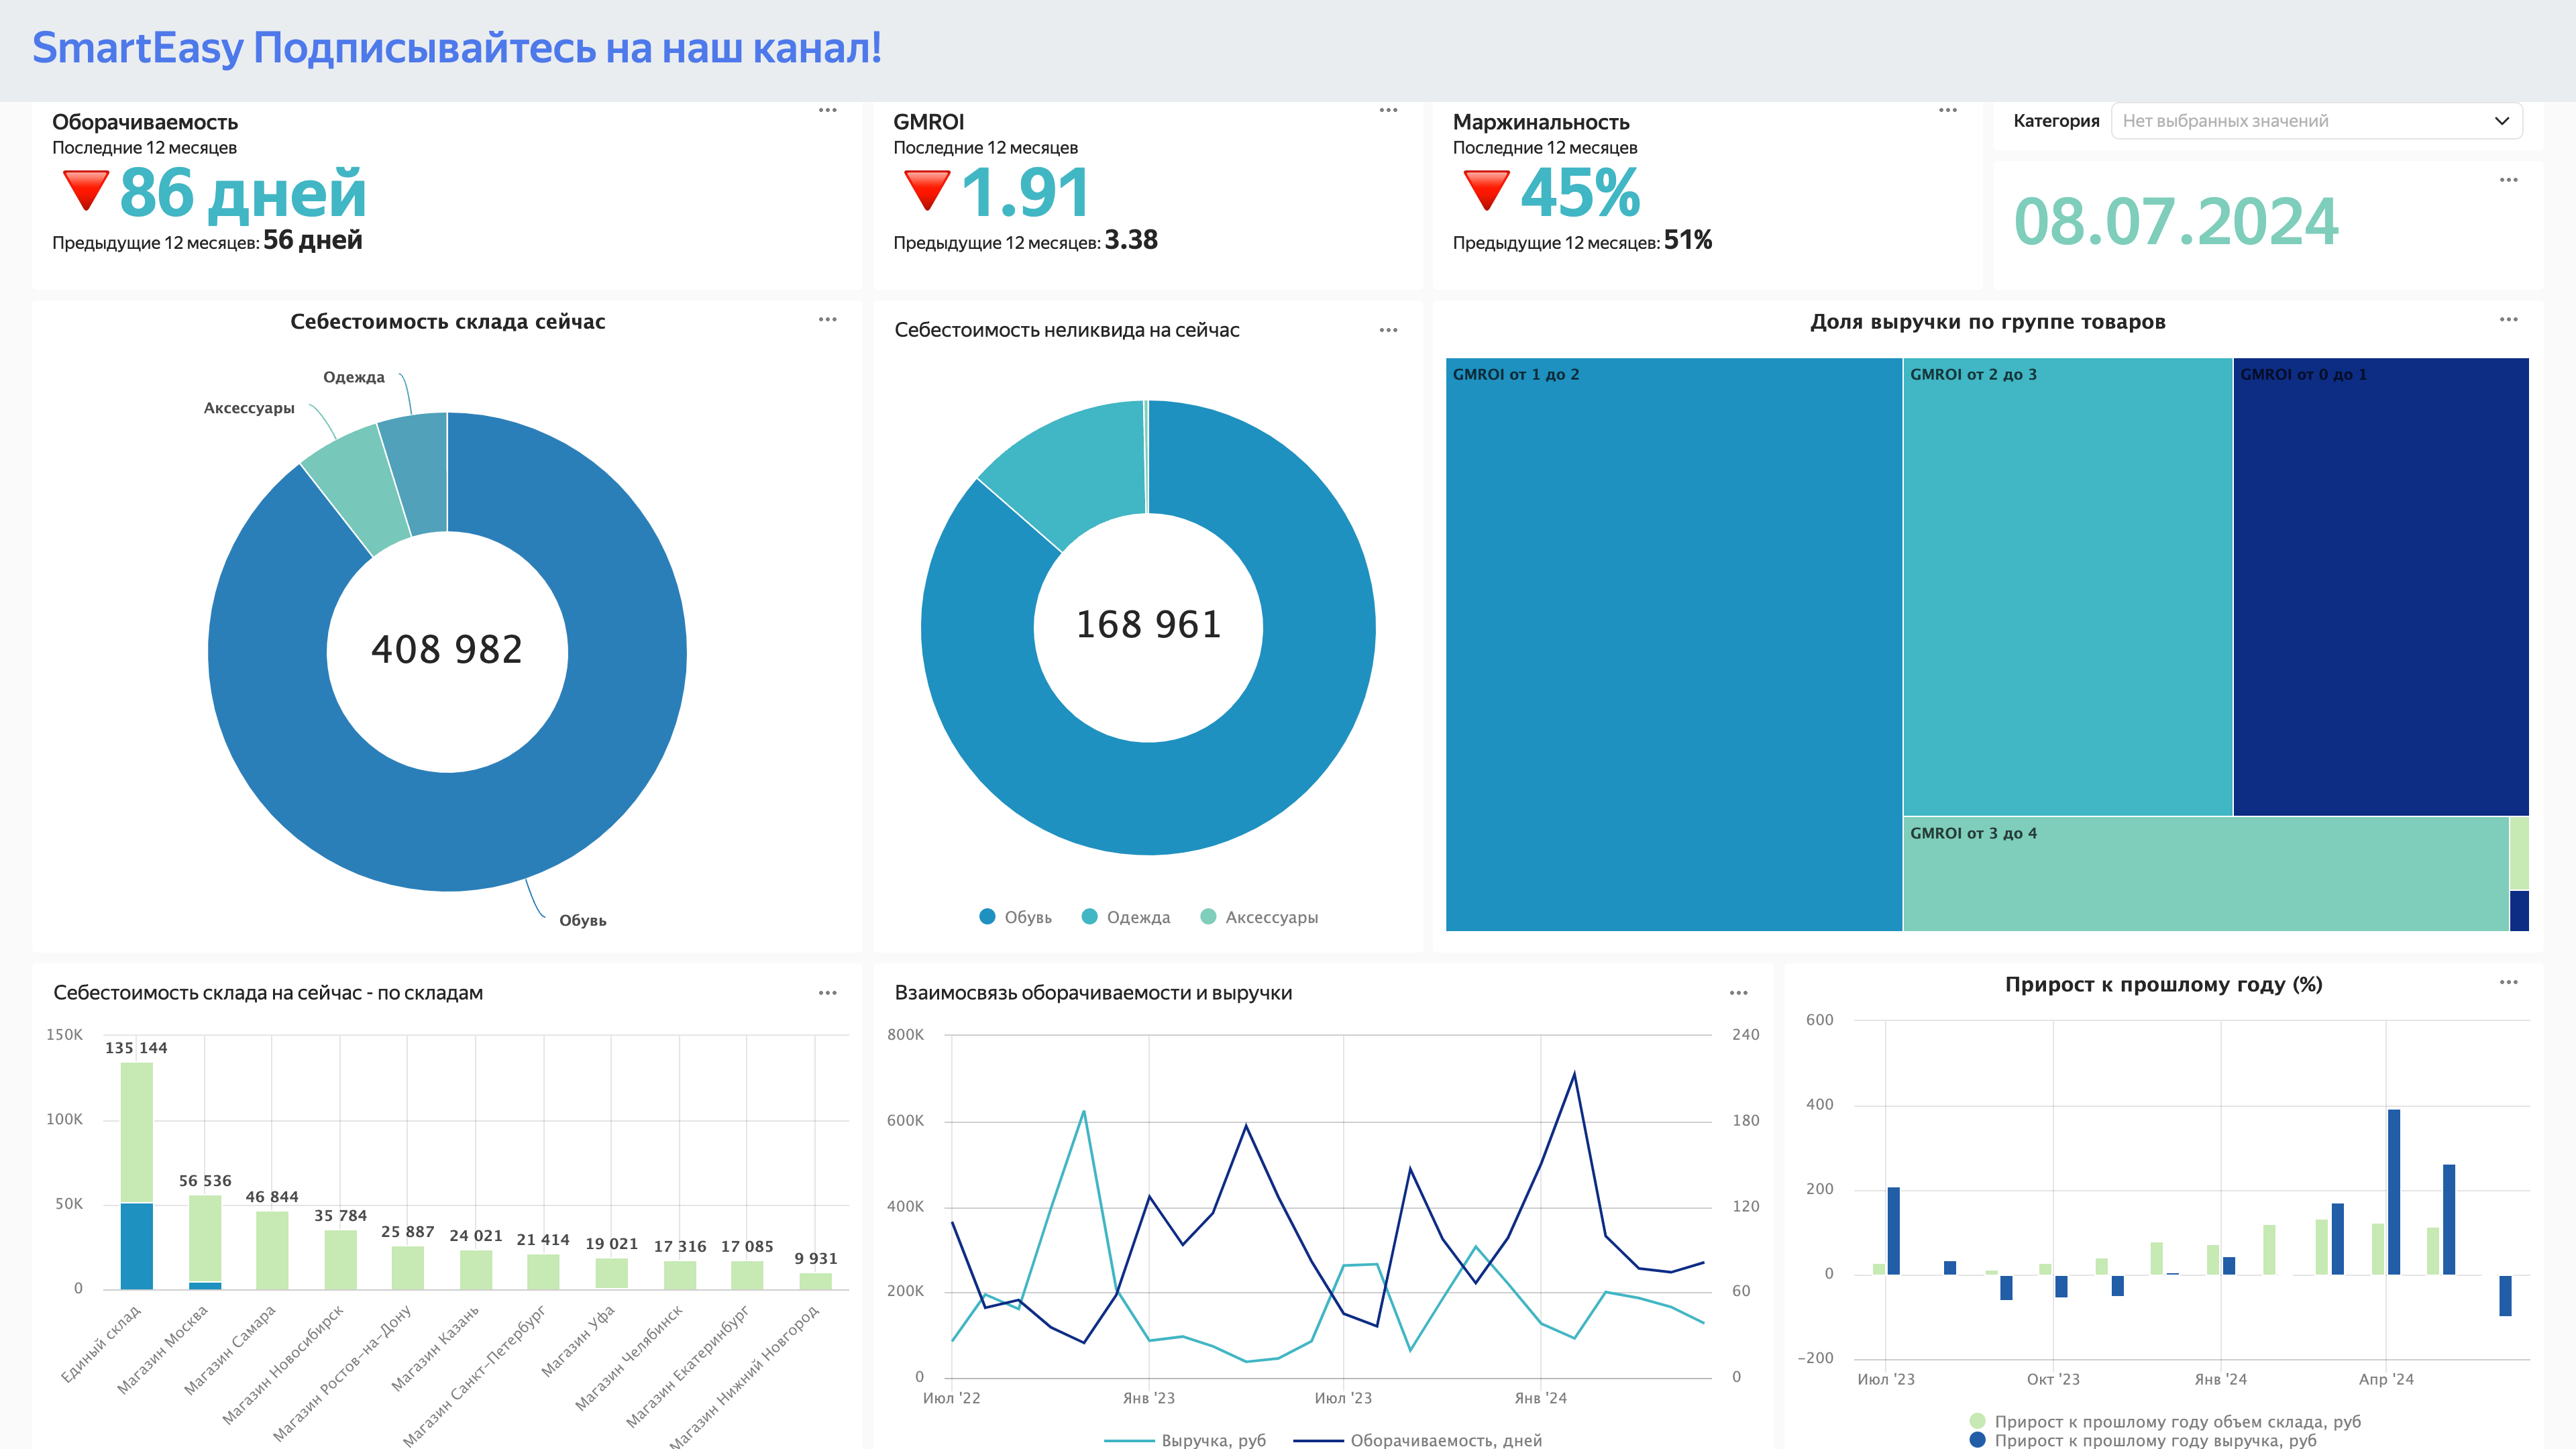
Введение: требования и архитектура
DataLens Enterprise On Premise опирается на набор сервисов, которые работают в контейнеризированной среде Kubernetes. Архитектура предполагает ение ролей между фронтенд-экзекутором, рендеринг-движком, управляющим сервисом и связующим слоем, который обеспечивает доступ к данным и аутентификацию пользователей. Важно понимать, что на уровне кластера требуется надёжная сеть, постоянное хранилище и устойчивые механизмы безопасности: управление секретами, политики доступов, TLS-терминацию и автоматическую выдачу сертификатов.
С точки зрения продукта важна гибкость развёртывания: DataLens Enterprise On Premise может быть запущен как в одном Availability Zone, так и в многозональном кластере для повышения доступности. В рамках Kubernetes рекомендуется проектировать архитектуру с учётом разделения окружений: dev, test, prod, а также выделения сред для интеграций с внешними источниками данных. Это позволяет снизить риск влияния изменений на пользовательские окружения и обеспечивает предсказуемость процессов обновления.
На уровне конфигурации критично определить набор параметров, которые должны быть согласованы между командами разработки, эксплуатации и информационной безопасности: в первую очередь это идентификация и доступ к данным, политика geheimности и хранение чувствительных ключей, режим логирования и мониторинга, а также требования к соответствию внутренним регламентам. Этим обеспечивается не только корректная работа DataLens, но и прозрачная операционная картина для аудитории аудита и регуляторов.
Архитектурные принципы и ориентиры
- Разделение сервисов по ответственностям: UI/API, движок рендеринга, коннекторы к источникам данных, служба безопасности и конфигураций.
- Непрерывность обслуживания: возможность горизонтального масштабирования посредством реплик и балансировки нагрузки.
- Безопасность по умолчанию: минимальные привилегии, централизованное управление секретами, шифрование на уровне хранения и передачи данных.
- Управляемость: централизованный мониторинг, логирование, трассировка и возможность отката изменений.
- Интеграция с корпоративной схемой идентификации: поддержка OIDC/SAML и внешних провайдеров аутентификации, чтобы пользователи могли входить в DataLens через существующие механизмы.
Рекомендованные подходы к конфигурации
- Выбор управляемого решения для кластера: выбор между kubeadm-основанной инфраструктурой, решением на базе Red Hat OpenShift или Rancher, с учётом корпоративных политик безопасности и управления.
- Определение критических ресурсов: для сервисов DataLens заранее планировать CPU, память и сетевые лимиты, предусмотреть резервы под пиковые нагрузки.
- Хранилище и отказоустойчивость: применение CSI‑драйверов под каждое PersistantVolume, настройка репликации данных и копий на случай сбоев.
- Сеть и балансировка: TLS-терминация на уровне Ingress или Load Balancer, сегментация сетей и политики сетевого доступа (NetworkPolicy).
- Управление секретами: режимы хранения секретов в Kubernetes Secrets или внешних секрет-менеджерах, обеспечение вращения ключей и автоматического обновления конфигураций.
Компоненты DataLens Enterprise On Premise и их роли
DataLens Enterprise On Premise состоит из нескольких координирующих и исполняющих сервисов, которые работают вместе для обеспечения анализа, визуализации и обмена данными внутри корпоративной среды. В составе, как правило, присутствуют:
- UI/API шлюз: интерфейс пользователя, REST/GraphQL API для взаимодействия с инструментами DataLens и внешними системами.
- Rendering Engine: движок визуализации, который конвертирует запросы пользователя в графики, дашборды и визуальные виджеты.
- Управляющий сервис: оркестрация задач, конфигураций окружения, контроль версий, управление рабочими пространствами и политиками.
- Коннекторы к источникам данных: адаптеры для подключения к базам данных, хранилищам данных и внешним сервисам, с поддержкой безопасных протоколов.
- Система безопасности и идентификации: интеграция с корпоративной каталогизацией, управление ролями и доступом, поддержка OIDC/SAML.
- Мониторинг и журналирование: интеграции с Prometheus, Grafana, ELK/EFK‑стеком или их эквивалентами для наблюдаемости и аудита.
- Хранилище конфигураций и секретов: централизованное место хранения настроек и чувствительных данных, с опциями вращения ключей и аудит.
- Конфигурационные и сетевые средства: конфигурационные плагины, политики сетевой безопасности и маршрутизации трафика.
Взаимосвязь сервисов строится через хорошо документированные API и устойчивые схемы обмена сообщениями. Важным является обеспечение согласованности конфигураций между средами и возможность быстрого восстановления после сбоев. Для упрощения эксплуатации рекомендуется использовать управляемые принципы инфраструктуры как код: Helm‑чарты или Kustomize‑конфигурации, позволяющие повторяемо разворачивать и обновлять компоненты DataLens.
Подготовка Kubernetes кластера: требования, архитектура и безопасность
Подготовка кластера включает выбор подходящего дистрибутива Kubernetes и обеспечение необходимых условий для устойчивой работы DataLens Enterprise On Premise. Ключевые аспекты:
- Версии и совместимость: следует проверить совместимость DataLens Enterprise с версией Kubernetes, установленной в организации, а также совместимость с используемыми решениями для мониторинга, сетей и секретов. Рекомендуется использовать поддерживаемые минимальные версии и планомерно обновлять стек без прерывания работ.
- Архитектура кластера: рекомендуется распределить узлы по ролям (мастер и рабочие узлы) с запасом вычислительных мощностей, указанных в требованиях DataLens. Для обеспечения доступности важна возможность размещения компонентов в нескольких узлах и, по возможности, в нескольких зонах доступности.
- Хранилище: выбор CSI‑драйверов и классов хранилищ под PersistantVolume должен учитывать требования к задержкам и пропускной способности. Реалистичным является использование репликованных хранилищ и резервного копирования, чтобы обеспечить сохранность данных при сбоях.
- Сетевые настройки: настройка Policy‑based сетевой сегментации, межсетевых экранов и ограничений доступа к внешним источникам. Включение Network Policy, TLS‑терминации и возможности шифрования данных в движении.
- Безопасность и управление секретами: внедрение централизованного управления секретами, практик вращения ключей, а также реализация RBAC в кластере и на уровне приложений DataLens. Встроенная поддержка OIDC/SAML упрощает интеграцию с корпоративными системами идентификации.
- Непрерывность и обновления: организация стратегий обновления кластера, планирование тестовых окружений, а также наличие резервных копий и процедур отката.
Архитектура кластера и распределение ролей
- Рекомендуется применение автономных узлов для управляющих компонентов и отдельных узлов под сервисы DataLens, чтобы минимизировать риск перекрытия рабочих нагрузок.
- Для крупной реализации целесообразно рассмотреть горизонтальное масштабирование реплик Engine и Rendering, с учётом того, что большинство нагрузок DataLens связаны с чтением визуализаций, а не записью.
- Включение горизонтального масштабирования для API‑шлюза и управляющего сервиса обеспечивает устойчивость к пиковым нагрузкам и улучшает отклик пользователей.
Требования к оборудованию, памяти и хранению
- CPU и RAM: для каждого экземпляра движка и UI‑слоя запас по памяти и CPU должен соответствовать предполагаемому числу одновременных пользователей и сложности визуализаций. Рекомендуется минимум 4-8 GiB памяти на узел под движок, плюс резерв под управляющий сервис.
- Хранение: согласованное хранение с поддержкой отказоустойчивости, резервного копирования и возможности быстрого восстановления. Включение шифрования данных и контроль доступа к данным.
- Производительность сети: достаточно широкополосные каналы между узлами, низкая задержка для скоростей отклика, критичных к пользовательскому опыту.
Сетевые требования и безопасность
- TLS и сертификаты: обязательна TLS‑терминация на внешнем прокси или Ingress, с обновлениями сертификатов и автоматическим обновлением.
- Сетевые политики: внедрение ограничений доступа между компонентами DataLens, чтобы минимизировать горизонтальные атаки и минимизировать риск утечки.
- Защита секретов: применение Kubernetes Secrets в зашифрованном виде и поддержка внешних секрет‑менеджеров, если это согласуется с политикой безопасности организации.
Управление секретами и идентификацией
- Интеграция с корпоративной системой идентификации через OIDC или SAML, единая точка входа и централизованный аудит.
- Вращение секретов: регламентированное обновление учетных данных и ключей, а также автоматическое обновление конфигураций приложения DataLens.
- Управление конфигурациями: хранение конфигураций в централизованном репозитории инфраструктуры как код, чтобы обеспечить воспроизводимость развёртываний.
Хранение данных и доступ к ним
- Поддержка устойчивого хранения для конфигураций, индексов и кэшированных данных. Планирование уровней хранения в зависимости от частоты обращения, задержек и ограничений по доступности.
- Резервное копирование: настройка планов регулярного резервного копирования и тесты восстановления для критических данных и конфигураций.
- Сегментация доступа к данным: разграничение ролей для пользователей и сервисов, минимизация прав на чтение и запись в зависимости от функций.
apiVersion: v1
kind: Namespace
metadata:
  name: datalens
Развертывание DataLens Enterprise On Premise на Kubernetes
Развертывание включает создание пространства имён, развёртывание необходимых объектов Kubernetes (CRD, Deployments, Services, Secrets), конфигурацию Helm‑чартов или Kustomize‑конфигураций и настройку интеграции с источниками данных и системами безопасности. В случае сложной инсталляции рекомендуется формировать пакетér с повторяемыми шагами и параметрами.
- Подготовка пространства имён и секретов: создание пространства имён для DataLens, размещение секретов доступа к данным и конфигураций TLS/сертификатов.
- Установка компонентов: развёртывание UI/API шлюза, Rendering Engine и управляющего сервиса, за которым следует настройка окружения и параметров связи с коннекторами и источниками данных.
- Конфигурация хранилища и данных: настройка PersistantVolume, выбор хранилища, пути к логам и кэшированию, настройка политик доступа к данным.
- Безопасность и доступ: настройка интеграции с OIDC/SAML, RBAC и ограничение прав на уровне пространства имён и сервисов.
- Мониторинг и логирование: подключение к Prometheus/Grafana, настройка метрик и алёртов, организация хранения логов.
## Пример минимального манифеста пространства имён apiVersion: v1 kind: Namespace metadata: name: datalens ## Пример описания секретов для TLS apiVersion: v1 kind: Secret metadata: name: datalens-tls namespace: datalens type: kubernetes.io/tls data: tls.crt:tls.key:
Развёртывание может быть выполнено через Helm‑чарт DataLens, который оформляет все зависимости, конфигурационные параметры и стратегии обновления. В случае использования Helm важно определить значения, связанные с данными источниками, секретами, параметрами TLS, лимитами ресурсов и параметрами обновления. Примерные параметры чарта включают:
- imageMirror: путь к образам DataLens;
- replicaCount: число реплик для движка и UI‑слоя;
- resources: лимиты и запросы CPU/memory для каждого компонента;
- ingress: правила маршрутизации и TLS;
- dataSourceConnections: параметры подключения к источникам данных;
- oidc: параметры подключения к провайдеру идентификации.
Для устойчивости инсталляции рекомендуется поддерживать стратегию обновления типа RollingUpdate с минимальным временем простоя. Важна также тестовая среда, где можно проверить совместимость обновлений перед выпуском в prod.
Пример базовой конфигурации Helm
- Назначение пространства имён, секретов, TLS‑ключей, источников данных и политик доступа.
Примечание: конкретные значения зависят от окружения и инфраструктуры. Важна повторяемость развёртываний и документирование параметров для аудита и соответствия внутренним регламентам.
Управление жизненным циклом, обновлениями и эксплуатацией
Управление жизненным циклом DataLens включает планы развёртывания, тестирования, обновления и отката, а также режимы мониторинга и поддержки. Основные принципы:
- Планы выпуска и совместимость: следует поддерживать матрицы совместимости между версиями DataLens и Kubernetes, а также межмодульные зависимости, чтобы обновления не ломали взаимодействие компонентов.
- Канареечные развёртывания: проводить обновления через последовательность окружений, начиная с тестовой среды и затем, по результатам отбора, переход к prod.
- Откат и резервы: наличие откатной стратегии, включая возможность быстрого возврата к ранее работавшей конфигурации и данных.
- Мониторинг и аудит: непрерывный мониторинг работы сервиса, журналирование и аудит изменений, чтобы быстро выявлять отклонения от нормальной эксплуатации и проводить анализ инцидентов.
- Резервное копирование и DR: регулярные резервные копии конфигураций и данных, а также тестирование восстановления в условиях, близких к реальной ситуации.
Интеграции, безопасность и эксплуатация
Интеграции интерфейсов DataLens с внешними системами и источниками данных требуют согласованности политик доступа и форматов обмена. Важными аспектами являются:
- Интеграции с источниками данных: настройка коннекторов и обеспечение устойчивости к сбоям сетей к источникам данных.
- Безопасность: конфигурация межсетевых правил, шифрование данных, безопасное хранение секретов, внедрение аудита и контроль доступа.
- Инфраструктура и безопасность кода: проверка образов контейнеров на возможные уязвимости, применение непрерывной интеграции и зрелые процессы проверки изменений.
- Наблюдаемость: детальные метрики по времени отклика, загрузке CPU/памяти, числу одновременных пользователей и другим критическим параметрам.
Key takeaways
- DataLens Enterprise On Premise требует системного подхода к подготовке Kubernetes кластера: совместимость версий, надёжное хранилище, безопасность и мониторинг.
- Архитектура сервиса предполагает разделение ролей между UI/API, движком рендеринга и управляющим сервисом, с поддержкой коннекторов к данным и интеграций.
- Практики развёртывания должны опираться на инфраструктуру как код, повторяемость, и планирование обновлений с минимальным простоем.
- Центральное управление секретами и идентификацией через OIDC/SAML обеспечивает безопасный доступ к DataLens и аудит операций.
- Резервное копирование и DR‑практики должны быть встроены в цикл эксплуатации DataLens на уровне класса хранения и конфигураций.
- Мониторинг и логирование являются неотъемлемой частью эксплуатации: настройка метрик, алёртов и визуализация в рамках существующей экосистемы мониторинга.
- Тщательное планирование ресурсов, настройки сетей и политики безопасности снижает риски и обеспечивает предсказуемость производительности.
FAQ
1. Какие версии Kubernetes поддерживаются DataLens Enterprise On Premise?
DataLens Enterprise On Premise требует совместимых версий Kubernetes, поддерживаемых в рамках конкретной версии DataLens. Обычно рекомендуется использовать поддерживаемые диапазоны версий и планировать обновления кластера до согласованных ревизий. Важно проверить документацию по конкретной версии DataLens относительно минимальных и рекомендуемых версий Kubernetes, а также совместимости с используемыми решениями для сетей, хранения и секретов.
2. Как выбрать размер кластера и количество реплик?
Выбор размера кластера зависит от числа одновременных пользователей, требований к времени отклика визуализаций и сложности рабочих процессов. Рекомендовано начать с подсчёта ожидаемой пиковой нагрузки и тестирования в staging‑окружении. Как правило, для prod‑окружения целесообразно начинать с двух узлов управления и одного-трёх рабочих узлов на движок и UI, с возможностью горизонтального масштабирования через реплики. В дальнейшем проводится адаптация под фактические показатели нагрузки.
3. Какие принципы обновления DataLens на Kubernetes?
Обновление следует проводить через канарейные развёртывания: сначала обновление в тестовой среде, валидация функциональности и совместимости, затем постепенное внедрение в prod. Важна совместимость конфигураций, журналирование изменений и возможность быстрого отката. Рекомендуется использовать инфраструктуру как код и управление версиями чартов или манифестов для воспроизводимости.
4. Как обеспечить высокую доступность DataLens на кластере?
Высокая доступность достигается посредством горизонтального масштабирования компонентов, распределения реплик по узлам и зонам доступности, а также использования отказоустойчивого хранилища. Включение мониторинга и alert‑правил помогает быстро выявлять сбои. Важно иметь план DR и регулярные тесты восстановления.
5. Какие требования к хранению и резервному копированию?
Требуется устойчивое хранилище с поддержкой репликации и возможности резервного копирования данных и конфигураций. Включение плана регулярного резервного копирования, автоматических бэкап‑планов и тестирования восстановления обеспечивает минимизацию рисков потери данных.
6. Какие практики безопасности рекомендуется внедрить?
Практики включают интеграцию с корпоративной системой идентификации через OIDC/SAML, использование RBAC, TLS для трафика, шифрование at-rest и in-transit, ротирование секретов, аудит доступа и соответствие регламентам. Важно также осуществлять регулярный аудит образов контейнеров и обновлять зависимости.
7. Как организовать мониторинг DataLens и интеграцию с существующей экосистемой?
Мониторинг следует выстроить на основе Prometheus/Grafana, интегрировать с центральной системой логирования и обеспечивать сбор метрик по всем критическим компонентам: UI, движку рендеринга, коннекторам и управляющему сервису. Важно предусмотреть алёрты по задержкам, нагрузке и доступности API.
8. Какие сценарии интеграции с источниками данных наиболее частые?
Наиболее распространены сценарии интеграции с реляционными базами данных, хранилищами данных и сервисами, поддерживающими безопасные протоколы доступа. Важно рассчитать задержку доступа и обеспечить надлежащие политики доступа к данным.
9. Как обеспечить безопасное управление секретами в Kubernetes?
Используйте Kubernetes Secrets (с шифрованием на etcd), внешние секрет‑менеджеры (например, Vault), rotate ключи по времени и внедрите автоматическую перезагрузку конфигураций DataLens при обновлении секретов.
10. Что делать при возникновении инцидента во время эксплуатации?
Сначала зафиксируйте инцидент и соберите метрики, логи и трассировку, затем применяйте план отката к предыдущей рабочей конфигурации. Проведите постмортем, обновите документацию и внесите корректировки в процессы развёртывания и мониторинга.
Если вы ищете инструмент для быстрой и эффективной аналитики без сложного внедрения и высоких затрат, обратите внимание на Yandex DataLens - современную платформу визуализации и анализа данных.
Сервис позволяет подключаться к различным источникам, строить дашборды и делиться аналитикой с командой — при этом он бесплатен, прост в освоении и подходит как для старта, так и для корпоративных решений. Благодаря экосистеме Yandex Cloud и возможности развертывания в закрытом контуре, DataLens становится универсальным инструментом для построения data-driven аналитики в компаниях любого масштаба.


