

AI Maturity в бизнесе: концепции и ключевые аспекты для организаций
Развитие искусственного интеллекта в организациях — это не только техника, но и управленческая практика. Говорят не просто об алгоритмах, а о том, как организовать данные, как выстраивать процессы создания и внедрения моделей, как измерять реальную ценность от AI и как снизить риски. В этой главе мы разберем концепцию зрелости AI (AI maturity) как системное состояние бизнес-подразделения, о котором нужно думать не только инженерам, но и руководителям, владельцам процессов и специалистам по рискам.
Ключевые идеи:
- Зрелость AI — это не столько «сколько моделей запущено», сколько способность бизнес-подразделения системно использовать данные и модели для достижения целей.
- Уровни зрелости: от пилотов и фрагментарных решений до интегрированной корпоративной платформы и управления AI в масштабе бизнеса.
- Основы методологий: ML lifecycle, MLOps, управление данными, обеспечение объяснимости и ответственности (Responsible AI).
- Технические сценарии по конкретным функциям (финансы, цепи поставок, маркетинг, операции) и примеры внедрений с использованием открытого ПО и российских решений.
- Риски, ограничения и принципы безопасного, этичного и законного применения AI.
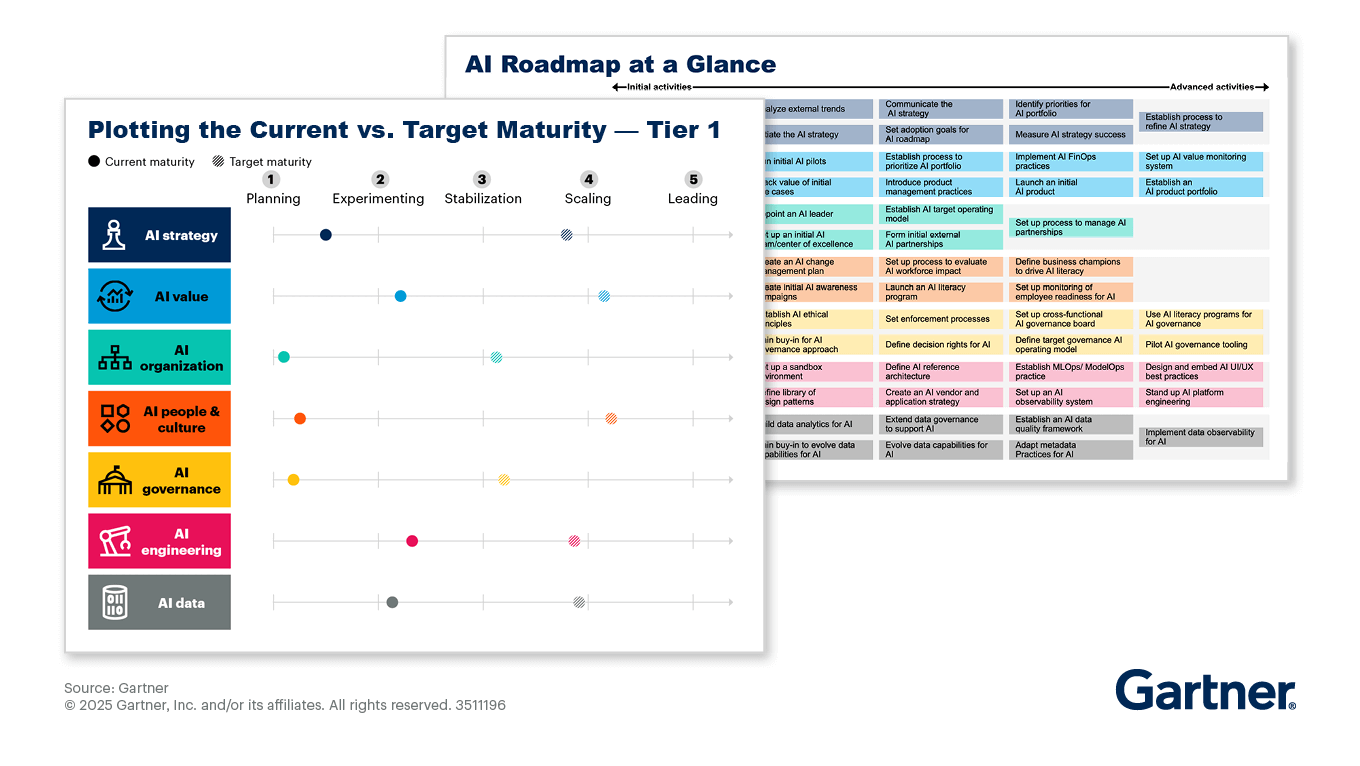
Что такое AI maturity и зачем она нужна
AI maturity — это состояние организации, в котором данные, технологии и управленческие практики выстроены таким образом, что искусственный интеллект не просто «один проект в ИТ», а системная часть операционной модели. Уровни зрелости позволяют понять, на каком этапе находится организация и какие шаги нужны для перехода к следующему уровню.
Ключевые понятия:
- AI lifecycle (цикл жизни AI): постановка задачи, сбор и подготовка данных, выбор и обучение моделей, валидация, внедрение, мониторинг, обновление моделей.
- Data governance и quality: как данные собираются, хранятся, какие правила качества и доступа действуют, как обеспечивается прозрачность источников данных.
- MLOps: управление жизненным циклом ML‑проектов, автоматизация пайплайнов, непрерывная интеграция и доставка моделей, мониторинг.
- Responsible AI: этика, прозрачность, безопасность, защита персональных данных, минимизация предвзятости моделей.
- Explainability и trust: способность объяснить выводы модели бизнес‑пользователям и регуляторам.
- ROI и value realization: как измерить ценность AI и связать её с бизнес‑кейсами.
Уровни зрелости (примерная модель)
| Уровень | Название | Что характерно | Что нужно для достижения |
|---|---|---|---|
| 1 | Инициализация (Ad hoc) | Пилоты, фрагментарные решения, данные расходятся по системам | Понимание целей, сбор исходных данных, минимальные дорожные карты, базовая инфраструктура для экспериментов |
| 2 | Основы (Foundations) | Стандартизированные пайплайны для отдельных проектов, управляемые данные | Разделение ответственности, базовый каталог данных, первые показатели эффективности пилотов |
| 3 | Внедрение (Operationalization) | Многочисленные проекты внутри подразделений; есть ML‑инженеры и инженеры данных | Стандартные процессы развёртывания, монолит политика доступа, регламенты качества данных и моделей |
| 4 | Масштабирование (Scale) | Архитектура данных и моделей общедоступна в организации; управление версиями и риск-менеджмент | Функциональные платформы AI/ML (ML Ops), общий реестр моделей, мониторы и алерты, управление предсказательными сервисами |
| 5 | Трансформация (Transformative) | AI становится частью бизнес‑модели; автономные процессы, персонализация на уровне бизнеса | Полная интеграция в процессы, культура данных, постоянное улучшение, управление ответственностью и соблюдение регламентов |
Термины и методологии
- CRISP-DM (Cross-Industry Standard Process for Data Mining): цикл жизни проекта данных от бизнес‑потребности до внедрения и оценки.
- TDSP (Team Data Science Process): методология от Microsoft, ориентированная на продуктовую разработку в рамках Data Science.
- MLOps: практика и инструменты для жизненного цикла ML‑проектов (CI/CD, мониторинг, переобучение).
- Feature store: центральное хранилище признаков, помогающее стандартизировать и повторно использовать признаки между моделями.
- Model registry: реестр моделей, версия контроля и управление артефактами модели.
- Drift и концептуальная сдвижка: изменение распределений данных и принципов задачи во времени, требующее мониторинга и обновления моделей.
- Responsible AI и bias mitigation: методы минимизации предвзятости, обеспечение прозрачности и защиты данных.
Архитектура и инфраструктура
- Архитектура данных: data lake (хранение неструктурированных и полуструктурированных данных), data warehouse (структурированные данные для аналитики), data lakehouse (совмещение преимуществ).
- Технологии: Delta Lake / Apache Iceberg / Apache Hudi для управляемого lakehouse-слоя; ClickHouse как российский ориентированный аналитический движок для высокоскоростной аналитики.
- Оркестрация пайплайнов: Apache Airflow, Prefect, Dagster.
- Контейнеризация и развертывание: Docker, Kubernetes, Helm.
- Мониторинг и качество данных: Evidently AI, Great Expectations, Prometheus + Grafana.
- Обучение и инфраструкутура для моделей: MLflow, Kubeflow, DVC (таблицы артефактов и данных), Model Registry.
Роли и организационная структура
- Chief AI Officer / Head of AI: стратегическое руководство и выравнивание AI‑инициатив с бизнес‑целями.
- Data Engineer / ML Engineer: построение и поддержка инфраструктуры данных и моделей.
- Data Scientist: разработка и настройка моделей, анализ данных.
- ML Ops / Platform Engineer: обеспечение развёртывания, мониторинга и масштабирования.
- Data Steward и Compliance Officer: управление качеством данных и соответствием требованиям.
- Product Owner: определение бизнес‑ценности и требований к продукту на основе AI.
Практические примеры
Ниже приведены примеры, как идеи теории отображаются на реальных бизнес‑задачах в разных областях. Для каждого примера упомянуты инструменты (open-source и российские решения), подходы к реализации и ожидаемые бизнес‑показатели.
Финансы: риск‑менеджмент и мошенничество
- Бизнес‑задача: улучшение обнаружения мошеннических операций и управление кредитным риском с минимизацией ложных срабатываний.
- Подход: создаётся единая платформа для обработки транзакций, сервисы для признаков по транзакциям, обучаются модели классификации Fraud Detection и Risk Scoring.
- Архитектура: источники данных из ERP/CRM/систем платежей → Data Lakehouse → Feature Store → Модели → Рекомендательный слой и UI → Мониторинг.
-
Инструменты:
- Open-source: CatBoost (хорошо работает с категориальными признаками), LightGBM/XGBoost, scikit-learn; MLflow для отслеживания экспериментов; Kedro или Prefect для управления пайплайнами; Apache Airflow для оркестрации.
- Российские решения: CatBoost (российская разработка); DeepPavlov может применяться в чатботы поддержки по вопросам безопасности; ClickHouse для аналитики в реальном времени.
-
Пример кода (CatBoost):
from catboost import CatBoostClassifier # X_train, y_train — ваши обучающие данные; cat_features — индексы категориальных признаков model = CatBoostClassifier(iterations=300, depth=6, loss_function='Logloss', verbose=50) model.fit(X_train, y_train, cat_features=cat_features) preds = model.predict_proba(X_test)[:, 1] - Метрики: ROC-AUC, PR-AUC, F1 для класса мошенничества, KPI в бизнес‑показателях (снижение потерь, снижение ложных срабатываний).
Цепи поставок: спрос и инфляция
- Бизнес‑задача: прогноз спроса и оптимизация запасов, чтобы снизить затраты и повысить оборачиваемость.
- Подход: многофакторный прогноз спроса, учёт сезонности и событий, сценарное моделирование.
- Архитектура: источники данных из ERP, система запасов, данные продаж → Data Lakehouse → Forecasting сервиса (Prophet, Prophet‑like) → планирование запасов → исполнение в WMS/ERP.
- Инструменты: Prophet для временных рядов (или CatBoost/LightGBM в гибридном подходе), ClickHouse для OLAP‑аналитики, MLflow/Kubeflow для экспериментов и пайплайнов.
- Практическая заметка: в российских реалиях russkie компании часто используют ClickHouse для аналитики в реальном времени и отечественные решения для визуализации и планирования в ERP‑системах.
- Метрики: MAE/MAPE, RMSE для точности, коэффициент оборачиваемости запасов ( turns ), сервисный уровень.
Маркетинг: сегментация клиентов и персонализация
- Бизнес‑задача: повысить конверсию и лояльность за счёт персонализированных коммуникаций.
- Подход: сегментация клиентов по поведению, предсказание откликов на кампании, A/B‑тестирование.
- Архитектура: данные из CRM/платформ маркетинга → Feature Store → Модели сегментации/рекомендаций → кампейны → мониторинг.
-
Инструменты:
- Open-source: scikit-learn для кластеризации, CatBoost для обработки категорий и аномалий, Apache Spark для больших данных, MLflow для трекинга.
- Российские решения: DeepPavlov для обработки естественного языка в чатах поддержки и персонализации, CatBoost как надёжная модель для табличных данных, ClickHouse для аналитики поведения пользователей.
-
Пример кода: кластеризация K‑Means на векторизованных признаках клиента (пример общего подхода):
from sklearn.cluster import KMeans kmeans = KMeans(n_clusters=6, random_state=42) clusters = kmeans.fit_predict(feature_matrix) - Метрики: коэффициент конверсии по кластерам, ROI кампаний, CTR, LTV.
Операции: предиктивное обслуживание и планирование мощностей
- Бизнес‑задача: предугадывать выход оборудования из строя и планировать обслуживание до отказа.
- Подход: сбор сенсорных данных, построение временных рядов и моделей аномалий, интеграция с CMMS/ERP.
- Архитектура: датчики и MES → Data Lakehouse → модели аномалий/предиктивного обслуживания → планирование обслуживания → исполнение в ERP/CMMS.
- Инструменты: Prophet/FBProphet для тренда и сезонности, XGBoost/LightGBM для задач классификации, PyTorch/TensorFlow для сложных моделей, Evidently AI для мониторинга.
- Российские решения: DeepPavlov может быть использован для поддержки операторов диагностики в чатах, CatBoost для дефектного анализа; ClickHouse для хранения и анализа потоков данных.
- Метрики: MAPE/MAE для времени до отказа, OEE (Overall Equipment Effectiveness), uptime, количество не запланированных простоев.
Архитектура и пайплайны
Общий подход: data lakehouse с единым слоем данных и централизованной инфраструктурой для обучения и продакшн‑развёртывания моделей. Этапы:
- Ингестирование данных: потоковые и пакетные источники, качественный контроль данных.
- Очистка и подготовка: нормализация, обработка пропусков, кодирование категориальных признаков.
- Хранение признаков: Feature Store (например, Feast) для повторного использования признаков между моделями.
- Обучение и валидация: автоматизированные пайплайны для обучения с экспериментальным учётом гиперпараметров.
- Развертывание: онлайн (REST/GRPC) или офлайн (батч) режимы, A/B‑тестирование.
- Мониторинг: drift (данные и концепции), качество данных, метрики модели, журналирование и алерты.
- Обновление: повторное обучение и обновление моделей в регистре моделей.
Инструменты и стек (open-source и российские)
- Хранение и обработка данных: Apache Spark, ClickHouse (российский акцент для аналитики), Delta Lake / Apache Iceberg / Apache Hudi.
- Управление данными и качеством: Great Expectations, Pandera, GreatResponse для контроля схем.
- Пайплайны и оркестрация: Apache Airflow, Prefect, Dagster.
- Обучение и версия моделей: MLflow (линейка экспериментов и реестр моделей), Kubeflow, DVC (data versioning), Weights & Biases (W&B) как облачный инструмент (частично бесплатный).
- Мониторинг и объяснимость: Evidently AI, Alibi Learn, SHAP/LIME для объяснимости.
- База данных и поиск: PostgreSQL/ClickHouse для аналитики, Redis для кэширования.
- Российские решения и практики: CatBoost (мощная модель для табличных данных, разработана в России), DeepPavlov (NLP‑платформа с открытым исходным кодом на русском языке), ClickHouse (российский OLAP‑движок для больших данных), Prophet/FBProphet может использоваться для временных рядов, но проект поддерживается сообществом и для гибридной аналитики, а также отечественные облачные и интеграционные решения через Яндекс.Облако и крупные крупные вендоры.
Пример архитектуры для типичного кейса
- Источники данных: ERP, CRM, платежные шлюзы, Sensor Data.
- Косвенный слой: Data Lakehouse (S3/облачное хранилище + Delta Lake) + Data Catalog.
- Признаки: Feature Store ( Feast / собственная реализация), версия признаков.
- Модели: набор табличных моделей (CatBoost, LightGBM, XGBoost) + NLP‑модели на DeepPavlov для коммуникаций и обработки текстов.
- Развертывание: онлайн API сервис (REST/GRPC) с мониторингом и алертами; офлайн‑планы для планирования и прогнозирования.
- Мониторинг: drift по данным и по качеству, A/B‑тестирование, регуляторные уведомления.
- Безопасность и соответствие: контроль доступа, шифрование, аудит, хранение данных согласно регламентам.
Пример небольшого open-source куска кода (для иллюстрации)
Обучение модели на табличных данных с CatBoost:
from catboost import CatBoostClassifier
import pandas as pd
from sklearn.model_selection import train_test_split

data = pd.read_csv("fraud_data.csv")
X = data.drop(columns=["label"])
y = data["label"]

# предполагаем, что некоторые признаки категориальные
cat_features = [i for i, col in enumerate(X.columns) if X[col].dtype == "object"]

X_train, X_valid, y_train, y_valid = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)

model = CatBoostClassifier(iterations=300, depth=6, loss_function='Logloss', verbose=False)
model.fit(X_train, y_train, cat_features=cat_features, eval_set=(X_valid, y_valid), use_best_model=True)
preds = model.predict_proba(X_valid)[:, 1]
Пример регистрации эксперимента в MLflow:
import mlflow
import mlflow.catboost

with mlflow.start_run():
    mlflow.log_param("model", "CatBoostClassifier")
    mlflow.log_param("iterations", 300)
    mlflow.catboost.log_model(model, "fraud_model")
    mlflow.log_metric("roc_auc", roc_auc_score(y_valid, preds))
Пример запроса к ClickHouse для аналитики в реальном времени:
SELECT toStartOfHour(timestamp) AS hour,
       count(*) AS events
FROM events
WHERE timestamp >= now() - INTERVAL 7 DAY
GROUP BY hour
ORDER BY hour
Эти примеры иллюстрируют сочетание открытого ПО и российской инфраструктуры в реальных сценариях.
Риски и ограничения
- Качество данных и управление данными: фрагментированные источники, пропуски, несоответствие форматов, качество метаданных. В условиях регуляторики это критично.
- Безопасность и приватность: защита персональных данных, соблюдение закона о персональных данных (в РФ — локализация, хранение, экспорт и регулирование). В ЕС/ЕЭЗ — GDPR; глобальные проекты требуют унифицированной политики.
- Регуляторные требования и комплаенс: финансовые компании обязаны разрабатывать решения с объяснимостью, документировать модели, хранить логи.
- Управление рисками и ответственность: кто отвечает за последствия решений AI, какие политики применяются, как устранять ошибки.
- Непредсказуемость моделей: дрейф данных, деградация качества, необходимость переобучения; планирование времени на поддержание в актуальном состоянии.
- Стоимость и ROI: иногда внедрение может оказаться дорогостоящим, особенно на старте; ROI требует времени и четко расписанных кейсов.
- Организационная интеграция: сопротивление изменениям, консервативная культура, сложности в управлении проектами между ИТ и бизнес‑функциями.
- Этические и социальные аспекты: предвзятость, справедливость, прозрачность для клиентов и сотрудников.
- Ограничения технологий: svært сложная задача в области NLP на русском языке, требующая специфической подготовки данных и инструментов.
Как минимизировать риски и повысить шансы на успех
- Определите конкретные бизнес‑цели и KPI, связывайте ROI с реальными процессами.
- Начинайте с пилотов в рамках одного домена, чтобы достичь быстрых выигрышей и учиться.
- Создайте центр компетенций AI (Center of Excellence) и закрепите роли, принципы и стандарты.
- Внедряйте MLOps с централизованным реестром моделей, мониторингом и безопасной доставкой.
- Инвестируйте в качество данных и управление данными (data governance, metadata, lineage).
- Обеспечьте прозрачность и объяснимость выводов моделей для бизнес‑пользователей и регуляторов.
- Участвуйте в российских и международных сообществах, чтобы следить за регуляторикой и лучшими практиками.
- Обеспечьте человеческую «защиту»: человек в цикл принятия решений на критических этапах и в случае жалоб.
- Включайте просмотр на соответствие требованиям к защите данных и регуляторику.
Зрелость AI в бизнесе — это устойчивое сочетание технологий, процессов и управления, которое позволяет организациям переходить от изолированных пилотов к централизованной, управляемой и бизнес-ориентированной практике применения искусственного интеллекта. Ключевые элементы — это единая инфраструктура данных, управляемые пайплайны обучения и развёртывания, мониторинг и ответственность за решения, а также культура данных на уровне организации. Важна не только технология, но и способность управлять изменениями и превращать данные в ценность для финансирования, цепей поставок, маркетинга и операций.
Вопрос–Ответ (FAQ)
1) Что такое AI maturity и зачем он нужен организации?
AI maturity — это зрелость организации в использовании AI, отражающая наличие управляемой инфраструктуры данных, процессов разработки и развёртывания моделей, а также способность извлекать бизнес‑ценность из AI на постоянной основе. Она нужна, чтобы избежать разрозненных проектов, снизить риски, повысить ROI и обеспечить долгосрочную устойчивость AI‑инициатив.
2) Какие уровни зрелости обычно встречаются в компаниях?
Типичная модель включает 5 уровней: Инициализация (Ad hoc), Основы (Foundations), Внедрение (Operationalization), Масштабирование (Scale) и Трансформация (Transformative). Каждый уровень требует более формализованных процессов, стандартов качества, монетизации данных и инфраструктуры.
3) Какие ключевые технологии входят в архитектуру зрелого AI‑проектa?
Архитектура включает data lakehouse (хранение и обработку данных), Feature Store (управление признаками), Model Registry (управление версиями моделей), MLflow/Kubeflow (плотная MLOps‑платформа), оркестрацию пайплайнов (Airflow, Prefect), мониторинг (Evidently AI, Great Expectations), а также инструменты для объяснимости (SHAP, LIME). Российские решения — ClickHouse для аналитики и CatBoost/DeepPavlov для локальных задач.
4) Какие практические примеры внедрений существуют в финансах, цепях поставок, маркетинге и операциях?
- Финансы: детекция мошенничества, кредитный скоринг, риск‑менеджмент.
- Цепи поставок: прогноз спроса, оптимизация запасов, маршрутизация.
- Маркетинг: сегментация клиентов, предиктивная персонализация, отклик на кампании.
- Операции: предиктивное обслуживание, планирование мощностей, качество продукции.
5) Какие open-source и российские решения стоит рассмотреть?
Open-source: CatBoost (мощная для табличных данных), LightGBM/XGBoost, scikit-learn, Prophet для временных рядов, MLflow/Kubeflow, Apache Airflow, Feast (Feature Store), ClickHouse (аналитика). Российские: CatBoost, DeepPavlov (NLP на русском), ClickHouse (российская разработка), интеграции через Яндекс.Облако.
6) Какие основные риски и ограничения при внедрении AI в бизнес?
Качество данных, регуляторные требования, безопасность, этика, предвзятость, риск дрейфа моделей, сложность интеграции, стоимость и ROI, сопротивление изменениям в организации.
7) Как измерять успех внедрения AI?
Ключевые KPI: точность моделей, ROC‑AUC, экономическая ценность (ROI), время цикла от идеи до внедрения, доля процессов, где применён AI, снижение операционных затрат, улучшение сервиса, качество данных.
8) Что такое MLOps и почему он важен?
MLOps — это набор практик для непрерывной интеграции, разработки и развёртывания ML‑моделей, включая мониторинг, переобучение и управление версиями. Он важен для прозрачности, управляемости, масштабируемости и контроля рисков.
9) Как избежать «срыва» проекта и обеспечить долгосрочную ценность?
Устанавливайте четкие бизнес‑кейсы и KPI, создайте центр компетенций AI, внедрите централизованную инфраструктуру, применяйте подходы с human-in-the-loop на ключевых точках принятия решений, следите за регуляторикой и этикой, инвестируйте в качество данных и обучение сотрудников.
10) Какие шаги можно предпринять уже завтра?
- Определите 1–2 бизнес‑задачи с высоким потенциалом ценности.
- Соберите минимальный набор данных и начальные признаки.
- Запустите пилот с простым алгоритмом (например, CatBoost) и оцените бизнес-эффект.
- Внедрите базовый пайплайн MLOps и мониторинг.
- Начните формирование команд и регламентов по управлению данными и моделями.
Мы помогаем компаниям переходить от экспериментов с AI к промышленным решениям с учетом безопасности данных и реального ROI. Проведем консультацию и предложим дорожную карту внедрения под задачи вашего бизнеса.


