BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс Современная архитектура хранилища данных » Apache Doris – эквивалентная замена Apache Hive, Elasticsearch и PostgreSQL

Apache Doris – эквивалентная замена Apache Hive, Elasticsearch и PostgreSQL

Как компании, предоставляющие услуги по обработке данных, строят свои хранилища данных? Какое-то время назад я  работал инженером по вычислениям в реальном времени на платформе due diligence, которая предназначена для того, чтобы пользователи могли искать данные о бизнесе, финансовых и юридических деталях компании. В ней собрана информация о более чем 300 миллионах организаций по более чем 300 параметрам. В наши с коллегами обязанности входило обеспечение обновления этих данных в режиме реального времени. В этом и заключалась главная функция нашего хранилища данных, ориентированная на клиентов. Кроме того, оно должно было поддерживать нашу внутреннюю маркетинговую и операционную команду в специальных запросах и сегментации пользователей, что являлось новшеством, связанным с ростом нашего бизнеса.

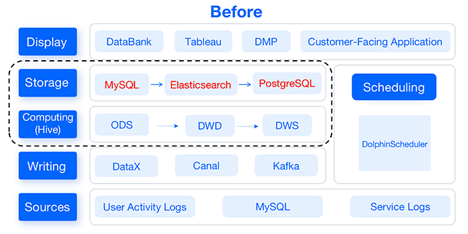
Наше старое хранилище данных состояло из самых популярных на тот момент компонентов, включая Apache Hive, MySQL, Elasticsearch и PostgreSQL. Они поддерживали разные  уровни вычисления и хранения данных:

  • Вычисление данных: Apache Hive служил в качестве вычислительного движка.


  • Хранение данных: MySQL предоставлял данные для DataBank, Tableau и наших приложений, ориентированных на клиентов. Elasticsearch и PostgreSQL служили частью  системы сегментации пользователей DMP: первый хранил данные профилирования пользователей, а второй - пакеты данных о группах пользователей..


Понятное дело, что длинный и сложный конвейер данных требует больших затрат на обслуживание и снижает эффективность разработки. Кроме того, он не способен выполнять специальные сложные запросы. Поэтому в качестве модернизации нашего хранилища данных мы заменили большинство этих компонентов на Apache Doris, open source  аналитическую базу MPP.
 

Поток данных

Отображение движения наших данных.
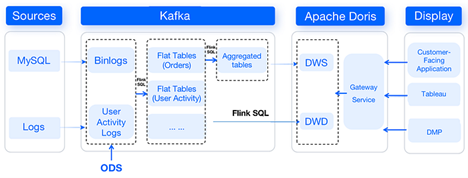
 

Сначала бинлоги из MySQL попадали в Kafka через Canal, а журналы активности пользователей - в Kafka через Apache Flume. В Kafka данные очищались и организовывались в плоские таблицы, которые впоследствии превращались в агрегированные таблицы. Затем данные передавались из Kafka в Apache Doris, который служил нам в качестве хранилища и вычислительного механизма.

Для различных сценариев мы использовали разные модели Apache Doris: данные из MySQL преобразовывались в уникальную модель, данный журналов передавались в  дублирующую модель , а данные DWS - в агрегированную модель .

Так  Apache Doris заменил нам Hive, Elasticsearch и PostgreSQL. Такая трансформация сэкономила нам много сил и средств на разработку и сопровождение конвейера обработки данных. Кроме того, она значительно эффективность сегментации пользователей.


Специальные запросы

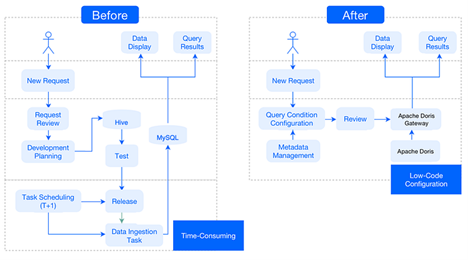
До: Каждый раз, когда появлялся какой-либо новый запрос, мы разрабатывали и тестировали модель данных в Hive и писали задачу планирования в MySQL для того, чтобы наши прикладные платформы, ориентированные на клиентов, могли читать результаты из MySQL. Это был сложный процесс, требовавший много времени и сил по разработке…


После: Поскольку в Apache Doris есть все детализированные данные, при появлении нового запроса он может извлекать метаданные напрямую и настраивать условия запроса. После этого он готов к выполнению специальных запросов. Короче говоря, для ответа на новые запросы требуется только конфигурация на низком уровне кода.
 

Сегментация пользователей

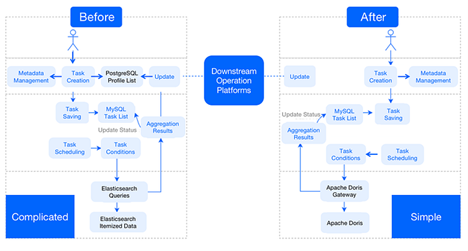
До: После создания задачи сегментации пользователей на основе метаданных соответствующие идентификаторы пользователей записываются в список профилей PostgreSQL и список задач MySQL. Elasticsearch выполняет запрос в соответствии с условиями задачи; после получения результатов он обновляет статус в списке задач и записывает пакет изображений групп пользователей в PostgreSQL. (Плагин PostgreSQL способен вычислять пересечение, объединение и разность множеств битовых карт). Затем PostgreSQL предоставит пакеты групп пользователей для последующих операционных платформ.

Таблицы в Elasticsearch и PostgreSQL были непригодны для повторного использования, что делало такую архитектуру экономически неэффективной. Кроме того, перед выполнением нового типа запросов нам приходилось предварительно определять теги пользователей, а это очень сильно замедляло работу.


После: Идентификаторы пользователей будут записаны только в список задач MySQL. Для первой сегментации Apache Doris выполнит специальный запрос на основе условий задачи. В последующих задачах сегментации Apache Doris будет выполнять микропакетный перебор и вычислять набор различий по сравнению с ранее созданным пакетом групп пользователей, а также уведомлять последующие платформы о любых обновлениях. (Реализовано с помощью функций изображений в Apache Doris).

В этом процессе сегментации пользователей, ориентированном на Doris, нам не нужно определять новые теги заранее. Вместо этого теги могут быть автоматически сгенерированы на основе условий задачи. Конвейер обработки обладает гибкостью, которая может облегчить нам проведение A/B-тестирования на основе групп пользователей. Кроме того, поскольку и детализированные данные, и пакеты групп пользователей находятся в Apache Doris, нам не нужно заботиться о сложности чтения и записи между несколькими компонентами.
 

Как ускорить процесс сегментации пользователей на 70%

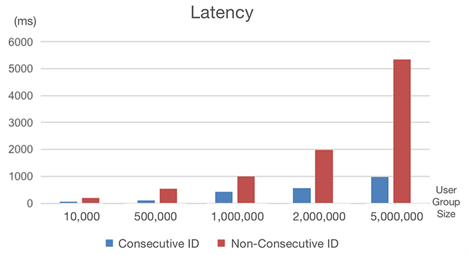
Многие компании делают выбор в пользу случайную генерации идентификаторов пользователей, что приводит к появлению редких и непоследовательных идентификаторов в пакетах групп пользователей. Используя эти идентификаторы в сегментации пользователей, мы вынуждены были слишком долго ждать генерации изображений.

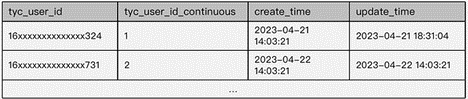
Чтобы решить эту проблему, мы создали последовательные отображения для этих идентификаторов пользователей. В результате мы сократили время ожидания сегментации пользователей на 70 %.
 

Пример

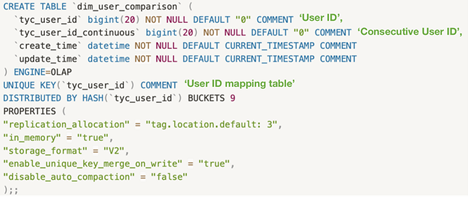
Шаг 1: Создайте таблицу сопоставления идентификаторов пользователей

Для таблиц сопоставления идентификаторов пользователей, где идентификатор пользователя является уникальным ключом, мы используем модель Unique. Сопоставленные последовательные идентификаторы обычно начинаются с 1.
 

Шаг 2: Создайте таблицу группы пользователей:

Для таблиц групп пользователей, где теги пользователей служат ключами агрегации, мы используем модель Aggregate.
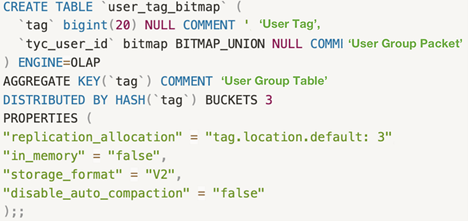
 

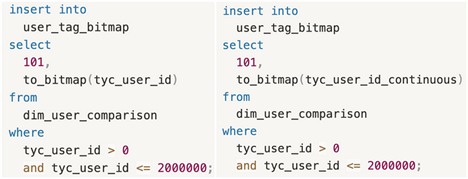
Предположим, что нам нужно отобрать пользователей, чьи идентификаторы находятся в диапазоне от 0 до 2000000.

В следующих фрагментах для сегментации пользователей используются непоследовательные (tyc_user_id) и последовательные (tyc_user_id_continuous) идентификаторы пользователей соответственно. Между их временем отклика существует большой разрыв:

  • Непоследовательные id: 1843 мс
  • Последовательные  id: 543 мс


Заключение

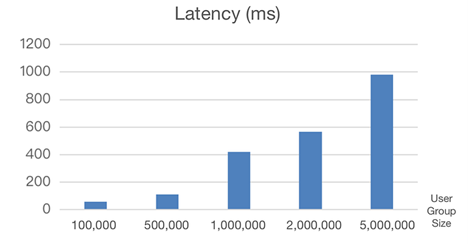
У нас есть 2 кластера Apache Doris, на которых размещаются десятки ТБ данных (каждый день поступает почти миллиард новых строк). Раньше мы наблюдали резкое снижение скорости ввода данных по мере увеличения их объема. Но после модернизации нашего хранилища данных с помощью Apache Doris мы увеличили эффективность записи данных на 75 % (!) Самое главное, наше хранилище данных стало  намного проще и удобнее для разработчиков и сопровождающих специалистов.
 

Наконец, я хотел бы поделиться с Вами интересными находками, ставшими очевидными при первом же контакте с  сообществом Apache Doris:

  • Apache Doris поддерживает транзакции ввода данных, что позволяет обеспечить однократную запись данных.
  • Он хорошо интегрирован в экосистему данных и может легко взаимодействовать с большинством источников и форматов данных.
  • Он позволяет реализовать эластичное масштабирование кластеров с помощью интерфейса командной строки.
  • Он превосходит ClickHouse в запросах на объединение данных.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Потенциал Elasticsearch: глубокое погружение в эффективность поиска
Следующая статья →
Индексирование данных в Elasticsearch с помощью Python
Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • AbbVie – компания, которая стремится решить самые серьезные проблемы здравоохранения. Это биофармацевтическая компания, сфокусированная на исследованиях и разработках.

  • Русклимат
    Русклимат — международный торгово-производственный холдинг, концентрирующий опыт ведущих мировых производителей индустрии климата, мощный потенциал конструкторских бюро и лабораторий индустриального дизайна.
     
    Компания образована в 1996 году. За более чем двадцатилетнюю историю Русклимат прошел путь от локальной компании до мощной вертикально-интегрированной многопрофильной структуры.
     
  • АО «Новосибирскэнергосбыт» является единственным гарантирующим поставщиком электроэнергии на территории г. Новосибирска и Новосибирской области. Предприятие отвечает за электроснабжение клиентов, закупая электроэнергию на оптовом рынке, регулируя поставку электроэнергии через договорные отношения с сетевыми организациями.

  • "Холодильник.ру" - крупнейший в России интернет-магазин бытовой техники и электроники. Компания была основана в 2003 году и за почти 20 лет работы завоевала лидирующие позиции на рынке онлайн ритейла. По данным исследовательского агентства Data Insight, "Холодильник.ру" входит в top-10 крупнейших интернет-магазинов России в категории "электроника и бытовая техника". Компания имеет развитую логистическую инфраструктуру и ежедневно осуществляет более 3500 доставок заказов по всей стране.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.