
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс Современная архитектура хранилища данных » Apache Iceberg и Parquet: архитектура Data Lake 2.0 для высокопроизводительной аналитики

Apache Iceberg и Parquet: архитектура Data Lake 2.0 для высокопроизводительной аналитики

Сегодня мы хотим поделиться с вами ценными инсайтами о переходе на архитектуру Data Lake 2.0 с использованием Apache Iceberg и Apache Parquet - технологий, которые уже сегодня переопределяют стандарты работы с большими данными.

Эволюция архитектур данных - это путь, который прошли многие компании. Все начиналось с классических транзакционных баз данных OLTP, затем появились OLAP-системы. В какой-то момент пришла гениальная идея хранить сырые данные в объектных хранилищах - дешево и масштабируемо. Так родился Data Lake.

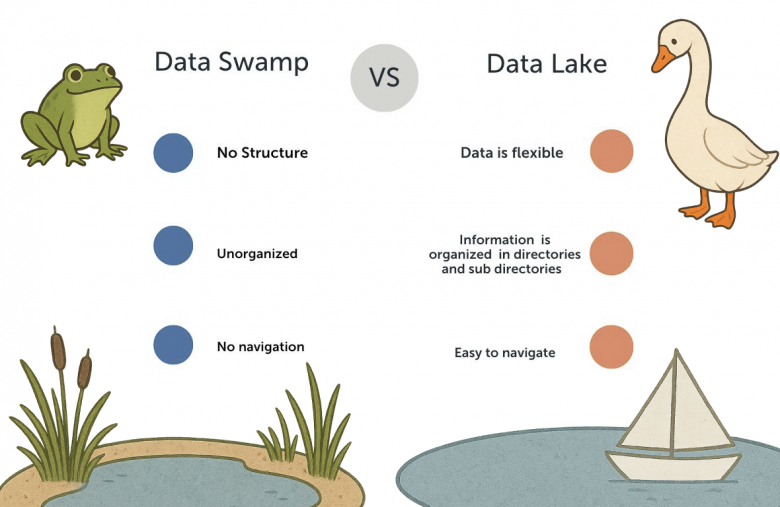
Первое время это казалось идеальным решением. Никаких жестких схем, никаких ACID-транзакций. Но постепенно начали проявляться проблемы с качеством данных, управлением и совместимостью. Data Lake превращалось в Data Swamp - болото данных, где найти что-то полезное становилось все сложнее.


Параллельно существовал классический DWH - красивый, аккуратный, со схемами, транзакциями, высокой скоростью, но дорогой. Проблема была в связанности storage и compute - оплата шла за оба компонента одновременно.

Стало очевидно, что нужен гибридный подход. Появились решения Delta Lake от Databricks и Apache Iceberg как open-source альтернатива, объединяющие лучшее из двух миров: транзакции, эволюцию схемы, дешевое хранение, и при этом работающие как для BI, так и для ML-стриминга.

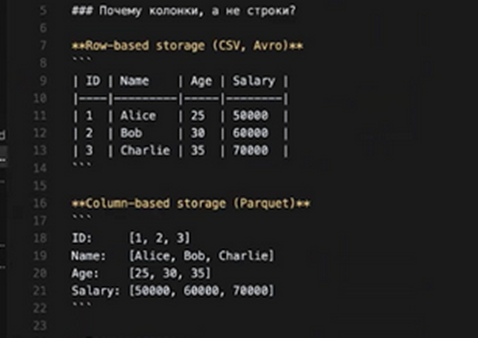
Apache Parquet - это колоночный формат хранения, который стал настоящим прорывом в области больших данных. В отличие от строчных форматов, он обеспечивает лучшее сжатие благодаря однородности данных. С ним эффективнее работает аналитика - можно читать только нужные колонки. И наконец, он оптимально использует CPU-ресурсы благодаря векторизованным операциям.

Структура Parquet включает row groups размером обычно 128 МБ, внутри которых находятся column chunks, а те в свою очередь состоят из pages. В пределах row group хранятся статистики min, max, null count, что впоследствии используется для оптимизации чтения.

Возможности кодирования в Parquet впечатляют. Dictionary encoding позволяет заменять текстовые значения на идентификаторы, экономя до 90 процентов объема. RLE кодирование эффективно для последовательных значений. Delta encoding оптимально для монотонно возрастающих чисел.

Однако при всех преимуществах Parquet имеет серьезные ограничения. Эволюция схемы становится настоящей головной болью - любое добавление колонки требует перезаписи всех файлов. Отсутствие ACID-транзакций приводит к race conditions и неконсистентным чтениям. Метаданные хранятся прямо в файловой системе, что при большом количестве файлов делает LIST-операции чрезвычайно дорогими.


Именно здесь на помощь приходит Apache Iceberg, решающий три ключевые задачи: работу, управление и оптимизацию метаданных. Архитектура Iceberg трех уровней включает Catalog Layer, хранящий указатель на актуальную версию таблицы, что обеспечивает версионирование и возможность откатов.

Iceberg использует двухуровневую систему хранения файлов: manifest files и manifest list. Manifest files создаются для каждой партиции и хранятся в формате Avro, содержа детальную информацию о файлах и статистиках. Manifest list представляет собой сводку по всем манифестам.

Преимущество такого подхода становится очевидным при выполнении запросов. Например, запрос count с фильтром сначала обрабатывается через manifest list, где отсеиваются неподходящие манифесты, затем через manifest files отфильтровываются неподходящие файлы данных. В результате можно получить count, не читая ни одной строки из самих данных.


Iceberg стратегически использует Avro для метаданных и Parquet для данных, комбинируя сильные стороны обоих форматов. Avro легкий и компактный, с отличной поддержкой эволюции схем. Parquet оптимизирован для аналитики с векторизацией, сжатием и эффективным хранением чисел.

На практике это открывает различные паттерны интеграции. Горячие данные можно хранить на SSD с использованием LZ4 сжатия, архивные данные в холодном хранилище с GZIP сжатием. Все это работает со Spark, Flink, Trino, Dremio, StarRocks без существенных ограничений.

Мы провели сравнительное тестирование Iceberg и Hive на продакшен-нагрузках. Использовался Spark-кластер с таблицей в 650 миллионов строк на партицию объемом 65 ГБ. Результаты показали, что Iceberg занимает больше места - 892 ГБ против 334 ГБ у Hive, но это объясняется особенностями хранения метаданных.

Что проверяли – достаточно простые сценарии:

SELECT COUNT(*);

SELECT ... LIMIT 10_000, LIMIT 100 — проверка коротких запросов;

GROUP BY origin — замер группировок.


По производительности записи Iceberg демонстрирует преимущество в 1.5-2 раза. Чтение COUNT запросов выполняется мгновенно благодаря использованию метаданных. LIMIT запросы до 10 тысяч строк быстрее в Hive, но на выборках от 500 тысяч строк Iceberg выходит вперед. DISTINCT операции стабильнее в Hive, GROUP BY показывает схожие результаты.

Главное преимущество Iceberg проявляется в ACID операциях. Обновления и удаления выполняются в 3-10 раз быстрее, поскольку не требуют перезаписи партиций.

Из нашего опыта следует, что Iceberg оптимально подходит для сценариев, требующих работы с метаданными, частых count операций, ACID транзакций, аналитических нагрузок с фильтрацией по времени, эволюции схемы и работы с разными движками. Наибольшая выгода достигается на запросах от 500 тысяч строк.

Однако важно понимать, что Iceberg не панацея. Для небольших датасетов его архитектура может оказаться избыточной. Сложность управления, настройка метаданных и поддержка ACID не окупаются на малых объемах.

Критически важным компонентом является compaction. Без правильной настройки возможно взрывное увеличение количества мелких файлов, что убивает производительность. В наших тестах 95 процентов избыточного объема в 557 ГБ возникло именно из-за проблемы с coalesce.

Риски миграции на Iceberg включают неправильную настройку метаданных, ошибки в конфигурации compaction, неоптимальный выбор форматов хранения для конкретных сценариев. Однако при правильной реализации overhead составляет всего 1 процент.

Мы рекомендуем рассматривать переход на Iceberg в следующих случаях:

  • При работе с тяжелыми метаданными, когда традиционные системы не справляются с нагрузкой
  • При необходимости ACID транзакций в data lake
  • Для больших аналитических выборок с сложной фильтрацией
  • При частых изменениях схемы данных
  • В многодвижковых средах, где разные инструменты работают с одними данными
  • Для реализации time travel queries


Практические примеры из нашего опыта показывают эффективность Iceberg в реальных сценариях. E - commerce компания смогла ускорить выполнение аналитических запросов в 6 раз при сокращении затрат на хранение на 30 процентов. Телеком оператор добился снижения времени обработки данных с 4 часов до 15 минут.

Техническая реализация миграции требует тщательного планирования. Мы рекомендуем начинать с пилотного проекта, охватывающего один два бизнес процесса. Важно правильно настроить стратегию партиционирования, определить оптимальные параметры compaction, выбрать подходящий каталог.

Экономика перехода на Iceberg показывает отличные результаты. Разделение storage и compute позволяет существенно снизить затраты. Использование современных систем хранения с Erasure Coding снижает избыточность с 3 до 2 раз, делая хранение практически бесплатным.

Правильно реализованная архитектура Data Lake 2.0 с Apache Iceberg и Parquet позволяет достичь беспрецедентного уровня эффективности работы с данными. Это не просто технологическое обновление, а стратегическое преобразование data инфраструктуры, дающее конкурентное преимущество в эпоху данных.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Оптимизация производительности баз данных: Стратегии масштабирования и репликации
Следующая статья →
Настройка и использование каталогов для Iceberg Lakehouse
Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • KazanExpress — торговая площадка, на которой представлены товары с бесплатной доставкой за один день в более, чем 70 городах России. Аналитическое решение на базе платформы данных Yandex Cloud позволило компании обеспечить демократизацию данных. Результат — принятие обоснованных решений на всех уровнях, увеличение лояльности партнеров и повышение прозрачности бизнеса.

    Мониторинг ключевых метрик в реальном времени минимизировал недополученную прибыль и обеспечил рост прибыльных направлений, а возможности геоаналитики сервиса Yandex DataLens помогли за короткое время проанализировать локации для открытия более 90 ПВЗ в 25 городах России и заложить основу для роста компании.

  •  ООО «ММК-Информсервис» создает высокотехнологичные решения для эффективной работы предприятий. Разрабатывают и внедряют телекоммуникационные и бизнес-приложения, автоматизируют производство, выстраивают и поддерживают корпоративную IT-инфраструктуру.

  • В «Пивоваренной компании «Балтика» аналитическая платформа Loginom применяется для моделирования процессов или построения отчетов, в том числе для формирования рекомендаций по корректировке плана промоактивностей.
     
  • Российский филиал одного их ведущих мировых производителей и дистрибьютеров косметики Estee Lauder Companies Inc. выбрал аналитическую платформу Loginom для предиктивной аналитики продаж как в офлайн-, так и в онлайн-канале.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.