

Центры компетенций AI: структура, задачи и взаимодействие
Центры компетенций AI (AI Centers of Excellence, CoE) — это организованные структуры внутри компаний, которые отвечают за создание повторяемых, управляемых и масштабируемых практик разработки и внедрения искусственного интеллекта. Их задача — превратить эпизодические проекты в системную, продуктово-ориентированную и управляемую инициативу: от идеи до промышленного использования, мониторинга и улучшения. В рамках курса «Организационная модель AI роли, центры компетенций, продуктовый подход и масштабирование AI-инициатив» мы разберём как строятся такие центры, какие роли и процессы в них задействованы, какие методологии лежат в основании их деятельности и как выбирать подход в зависимости от контекста организации.
Цель главы — дать полную картину: что такое центр компетенций AI, какие задачи он решает, какие архитектуры взаимодействия выбираются между центром и продуктовыми командами, какие инструменты и практики применяются (включая open-source и российские решения), какие риски возникают на разных этапах внедрения и как эти риски снижать. Мы будем говорить как о теории — терминах и методологиях, так и о практике — конкретных примерах, инструментах и подходах к настройке процессов.
Ключевые идеи, которые вынаходим в этом разделе:
- AI CoE — это не просто группа людей, а управляемая платформа знаний, методологий и инструментов, которая обеспечивает единое средство масштабирования AI-инициатив по всей организации.
- Продуктовый подход в контексте CoE означает, что мы думаем не о «пакете технологий», а о «продуктах AI» (модели, пайплайны, данные, сервисы) и их жизненном цикле.
- Взаимодействие между CoE и доменными командами — это двусторонний процесс: CoE предоставляет платформу, стандарты и сервисы; продуктовые команды вносят требования, экспертизу по предметной области и ускоряют внедрение.
- Технические артефакты CoE включают модельный реестр, фичер стор, пайплайны MLOps, метрики качества данных, управление рисками и соответствием требованиям регуляторов.
- Риски: качество данных, управляемость затрат, этика и безопасность, управляемость версиями моделей, устаревание моделей, сопротивление изменениям и нехватка квалифицированных кадров.
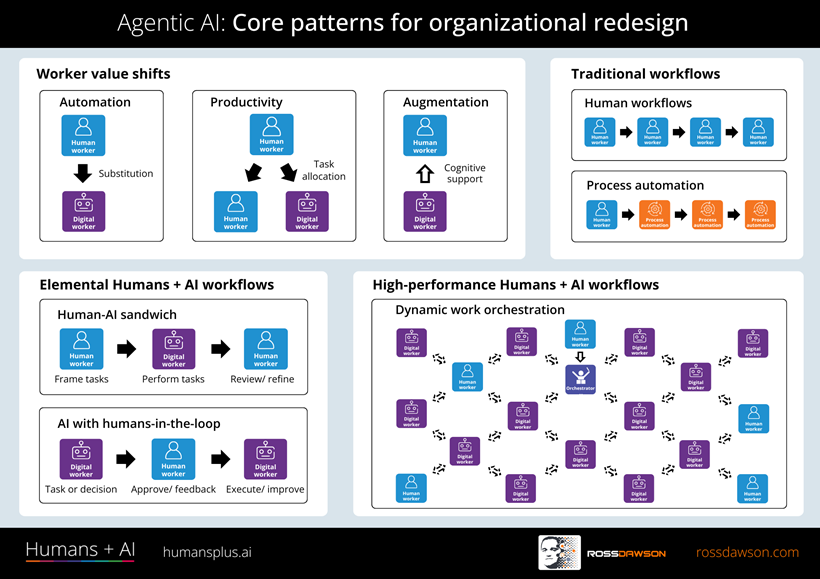
Что такое центр компетенций AI (CoE)
CoE — это структурированная единица в организации, целью которой является консолидация лучших практик, методов разработки и эксплуатации AI-решений. Основные функции CoE:
- Установление стандартов и методологий (модель жизненного цикла, DevOps/MLOps, контроль версий, тестирование, валидация).
- Предоставление платформы и сервисов (архитектурные решения, инфраструктура, инструменты для разработки, обучения, мониторинга и управления данными).
- Поддержка продуктовых команд через консалтинг, обучение и доступ к повторяемым паттернам.
- Мониторинг и управление рисками, соблюдение регуляторных требований, этики, прозрачности моделей.
- Масштабирование: повторное использование артефактов, репозиториев и процессов для разных доменов.
Важные термины и методологии
- AI Center of Excellence (CoE), Center of AI Excellence — единица внутри организации, которая выводит лучшие практики и инструменты.
- Продуктовый подход к AI — рассматривать модель, пайплайн, данные и сервис как продукт с ценностью для пользователей, дорожной картой и жизненным циклом.
- MLOps — набор практик интеграции разработки и эксплуатации моделей: CI/CD для моделей, контроль версий, тестирование, мониторинг и обновление.
- Data governance (управление данными) — политика качества, доступности и использования данных.
- Feature store — central repository for curated features, облегчает повторное использование признаков между моделями и проектами.
- Model registry — реестр моделей и версий, обеспечивает контроль версий, управление релизами и воспроизводимость.
- Data lineage — прослеживаемость источников данных, трансформаций и влияния на результаты моделей.
- Domain-driven design (DDD) в контексте AI — выстраивание архитектуры вокруг бизнес-доменов.
- GitOps и DevOps для MLOps — автоматизация развёртываний, контроль изменений, мониторинг и откат.
- Open-source и российские решения — инструменты и библиотеки, которые применяются в CoE: MLflow, Kubeflow, Airflow, Kedro, DVC, CatBoost, DeepPavlov, Natasha, RuGPT-3, Яндекс.Облако, SberCloud и пр.
Архитектура взаимодействия: как организовать CoE и product команды
- Центр компетенций выступает как «платформа» для повторного использования артефактов, стандартов и сервисов. Он задаёт правила, обеспечивает инфраструктуру и предоставляет сервисы (мониторинг, набор готовых пайплайнов, руководства и обучающие материалы).
- Продуктовые команды используют эту платформу для быстрого вывода решений на рынок. Они фокусируются на доменной экспертизе, постановке задач и формировании требований к данным, функциональности и качеству.
-
Связка между CoE и командами строится через:
- стандартные пайплайны MLOps (готовые этапы от подготовки данных до мониторинга и обновления).
- централизованные каталоги артефактов (модели, признаки, данные, тесты).
- услуги поддержки и консалтинга внутри CoE.
- процессы согласования (RACI-матрицы, SLAs по поставке артефактов, требования к регуляторике).
Модель взаимодействия: типовые варианты
- Центральный CoE с интеграцией через каталоги и сервисы: один центр управляет инфраструктурой, артефактами и сервисами, продуктовые команды подключаются через API и консалтинг.
- Федеративная модель: несколько доменных CoE, которые синхронизированы центральной платформой и наборами общих стандартов.
- Встроенный CoE в продуктовые команды: менее централизованный подход, где экспертиза AI присутствует в каждой доменной команде, а CoE выступает как экспертная поддержка и фонда лучших практик.
- Гибрид: ядро CoE отвечает за базовые сервисы и инфраструктуру, домены разворачивают локальные решения, но используют общие артефакты и каталоги.
Типы артефактов CoE и их роль
- Model registry (реестр моделей): хранение версий моделей, метаданных, управляемое развёртывание и откат.
- Feature store (хранилище признаков): централизованное хранение признаков, их версия и доступность для разных моделей.
- Pipelines и orchestration: управление пайплайнами данных и моделями (AML, оркестрация задач, мониторинг).
- Data lineage: документирование источников данных и их преобразований.
- Метрики качества и доверия: метрики производительности, fairness, безопасность, соответствие требованиям.
- Документация и обучающие материалы: руководства по использованию сервисов, примеры, гайдлайны по best practices.
Преимущества и вызовы различных моделей CoE
- Центральный CoE: консистентность, экономия за счет повторного использования, контроль качества. Но может быть менее agile и сталкиваться с бюрократией.
- Федеративный CoE: ближе к доменным потребностям, быстрее реагирует, но требует высокой координации.
- Встроенный CoE: максимальная адаптация под продукт, но риск локальных дублей и непоследовательности.
- Гибрид: баланс между контролем и скоростью, но требует сложного управления координацией.
Ключевой принцип: управление рисками и этикой
AI-инициатива должна быть полезной, этичной и безопасной. В CoE важно:
- Определить политики этики и прозрачности (что можно использовать, как объяснить результаты, как управлять предвзятостью).
- Обеспечить безопасность данных и ответственности (права доступа, аудит, шифрование, мониторинг аномалий).
- Контролировать качество данных и моделей (валидаторы данных, тесты на устойчивость).
- Учитывать регуляторные ограничения (область применения, локализация данных, требования к отчетности и аудиту).
Практические примеры
Пример 1: Центр компетенций в крупной корпорации (централизованный CoE)
Контекст: крупная финансовая или телеком-компания решает централизовать AI-инициативы для ускорения внедрения и единых стандартов.
Что делает CoE:
- Создаёт единое архитектурное руководство, набор сервисов и инструментов для разработки и эксплуатации моделей.
- Предоставляет репозиторий признаков и реестр моделей.
- Разворачивает пайплайны Data → Feature → Model → Deployment → Monitoring.
- Обучает команды и проводит регулярные ревью проектов.
Структура ролей:
- Глава CoE (A) — отвечает за стратегию и бюджет.
- Архитектор CoE (R) — проектирует платформу и стандарты.
- Инженеры MLOps (R) — развёртывают пайплайны, мониторинг и регистр артефактов.
- Специалисты по данным (C) — обеспечивают качество данных, предобработку и доступ к данным.
- Доменные эксперты (C/I) — формулируют требования и метрики.
Пример табличной модели RACI:
| Роль | Подготовка данных | Обучение моделей | Развёртывание | Мониторинг | Соответствие |
|---|---|---|---|---|---|
| Архитектор CoE | R | A | C | C | I |
| Инженер MLOps | R | R | A | R | I |
| Доменной эксперт | C | C | I | I | C |
| Команды продуктов | I | I | C | C | I |
Пример технологического стека:
- Инфраструктура: Kubernetes, Docker, Terraform (для инфраструктуры как кода).
- Оркестрация: Kubeflow или Airflow.
- Пайплайны: MLflow в роли реестра моделей; Feast как feature store.
- Аналитика и мониторинг: Prometheus/Grafana, SeldonIO для сервисной развёртки моделей.
- Хранилища: Lakehouse-подход (мы используем объёмные дата-реки и дата-озёра).
Пример кода: логирование модели в MLflow
from mlflow import log_metric, log_param, log_artifact
log_param("model_type", "CatBoostClassifier")
log_metric("accuracy", 0.92)
# логирование артефактов и модели
Пример простого пайплайна на Airflow (Python):
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime

def preprocess():
    # загрузка и подготовка данных
    pass

def train():
    # обучение модели
    pass

def evaluate():
    # валидация и сохранение метрик
    pass

with DAG('ml_pipeline', start_date=datetime(2024,1,1), schedule_interval='@daily') as dag:
    t1 = PythonOperator(task_id='preprocess', python_callable=preprocess)
    t2 = PythonOperator(task_id='train', python_callable=train)
    t3 = PythonOperator(task_id='evaluate', python_callable=evaluate)
    t1 >> t2 >> t3
Практическая часть: ключевые артефакты, которые должен обеспечивать CoE
- Каталог признаков (feature catalog): список признаков, их источники, версии, контекст применения.
- Реестр моделей: версия, метрики, условия продакшна.
- Документация и гайдлайны: архитектурные решения, лучшие практики, примеры.
- Мониторинг: метрики качества моделей, качество данных, предупреждения и алерты.
- Безопасность и соответствие: политика доступа, аудит, регуляторные требования.
Пример 2: Федеративная модель взаимодействия между доменными командами
Контекст: Компания с множеством доменов (финансы, здравоохранение, ритейл) хочет сохранить скорость разработки в доменах, но обеспечить единые стандарты.
Роль CoE:
- Определяет общие услуги: общий Feature Store, общие пайплайны МL и политики.
- Предоставляет набор готовых образцов: паттерны для тестирования, проверки данных, проверки на рассогласование.
Роль доменных команд:
- Формулируют требования и метрики, подготавливают данные, ответственны за качество данных.
- Подключают модели в свои пользовательские сервисы.
Преимущества:
- Быстрое внедрение в доменах.
- Единые стандарты и прозрачность.
- Легко масштабировать повторяемые паттерны.
Недостатки:
- Требуется координация и механизм эскалации.
- Возможна ресинхронизация между доменами, если стандарты не соблюдаются.
Пример 3: Встраивание CoE в продуктовые команды
Контекст: стартап или средняя компания, которая хочет быстро вывести минимально жизнеспособный продукт (MVP) и затем масштабировать.
Что происходит:
- CoE предоставляет базовую инфраструктуру и готовые практики.
- Команды работают с прямым доступом к инструментам и сервисам, но с поддержкой CoE в виде наставничества и аудита качества.
- Быстрый цикл цикла участия и обучения.
Преимущества:
- Высокая скорость старта.
- Гибкость и адаптивность.
Недостатки:
- Возможные конфликты по качеству и совместимости, если правила нарушаются.
Важные выводы из практических примеров
- Выбор модели(CoE) зависит от масштаба, культурных факторов, регуляторики и готовности к инвестициям в инфраструктуру.
- Незаменимы общие платформы и артефакты: регистр моделей, feature store, пайплайны, мониторинг, данные и безопасность.
- Важно обеспечить тесную связь между доменными командами и центром компетенций: запросы, обратная связь, требования к качеству, документация и обучение.
Архитектура CoE: рабочий каркас
- Центральная платформа: сервисы и инфраструктура, которые предоставляют основные услуги для всего портфеля AI-проектов.
- Каталоги артефактов: модели, признаки и данные, их версии и зависимости.
- Мониторинг и безопасность: сбор метрик, алертинг, аудит, управление доступом.
- Обучение и поддержка: обучение сотрудников, курсы, гайды и best practices.
- Инструменты и библиотеки: подбор инструментов под задачи домена; поддержание совместимости и обновления.
Типы инструментов и решения (open-source + российские)
Open-source:
- MLflow — управление жизненным циклом моделей, реестр, эксперименты.
- Kubeflow — оркестрация пайплайнов ML в Kubernetes.
- Apache Airflow — оркестрация задач и пайплайнов.
- Kedro — структурирование проекта и пайплайны data science.
- DVC — управление данными и версиями моделей.
- CatBoost — градиентный бустинг, хорошо работает с предсказательными задачами и работает на русском языке.
- DeepPavlov — NLP-библиотека на русском языке, готовые модели и инструменты для разработки чат-ботов и NLP-задач.
- Natasha — российская NLP-библиотека с фокусом на русские тексты (модульный токенизатор, сегментер и др.).
- RuGPT-3 (Sber) — крупная языковая модель русского языка (публичная часть, экспериментальная доступность).
Российские и локальные решения:
- Яндекс.Облако и инструменты для MLOps в рамках экосистемы Яндекс.Облако: YandexML, Yandex DataSphere, мониторинг, безопасность и целый набор сервисов для развёртывания моделей.
- SberCloud (ML Ops, AI-платформа, инфраструктурные сервисы для разработки и эксплуатации моделей).
- CatBoost — открытая библиотека от Яндекса, специально ориентирована на упрощение обучения с категориальными признаками, хорошо поддерживает русский язык.
- DeepPavlov, Natasha — отечественные инструменты для NLP и NLU, применяемые в готовых продуктах и исследованиях.
Пример конфигурации сервисной платформы (упрощённый обзор)
- Kubernetes кластер для развёртывания сервиса моделей и пайплайнов.
- MLflow в качестве Model Registry и Experiment Tracking.
- Feast в качестве Feature Store.
- Kubeflow или Airflow для оркестрации пайплайнов.
- Prometheus/Grafana для мониторинга, Loki для логирования.
- Диагностика и безопасность: OpenPolicyAgent (OPA) для политик доступа, Audit Logs для соответствия.
Пример YAML-оператора для развёртывания MLflow (упрощённый)
apiVersion: apps/v1
kind: Deployment
metadata:
  name: mlflow-deployment
spec:
  replicas: 1
  selector:
    matchLabels:
      app: mlflow
  template:
    metadata:
      labels:
        app: mlflow
    spec:
      containers:
      - name: mlflow
        image: tensorflow/tensorflow:2.12.0
        ports:
        - containerPort: 5000
Пример использования русского NLP-инструмента Natasha
from natasha import Segmenter, NewsEmbedding, NewsTokenizer, Doc
segmenter = Segmenter()
emb = NewsEmbedding()
tokenizer = NewsTokenizer(emb)

text = "Пример текста на русском языке."
doc = Doc(text)
doc.segment(segmenter)
tokens = [part.text for part in doc.tokens]
Пример использования DeepPavlov для задачи классификации
from deeppavlov import build_model, configs
model = build_model(configs.classification.rusentiment, download=True)
print(model(["Этот продукт отличный", "Плохой сервис"]))
Технические ограничения и требования к инфраструктуре
- Потребление ресурсов: обучающие модели требуют значительных вычислительных мощностей (GPU/TPU, CPU, память). Планирование должно учитывать пиковые нагрузки и экономическую эффективность.
- Контроль версий и совместимость: версия модели, версии зависимостей и конфигураций должны быть задокументированы и контролируемы.
- Управление данными: требования к приватности, локализации, обработке персональных данных и регуляторике.
- Этичность и безопасность: мониторинг и фильтрация предвзятости, обеспечение защиты от утечки данных и устойчивости к атакам.
- Масштабируемость: архитектура должна поддерживать горизонтальное масштабирование, автоматическое обновление моделей и откат.
- Обучение внутри организации и внешних поставщиков: соглашения об уровне обслуживания (SLA), ответственность за качество данных и результативность моделей.
Практические техники и методики
- Data mesh / Data fabric (управление данными): распределение владения данными между доменами, прозрачность и доступность.
- Feature store-first подход: создание и повторное использование признаков для разных моделей.
- Model monitoring and drift detection: отслеживание деградации и смещений в данных и в моделях, алертинг.
- Explainability и прозрачность: методы объяснимости, аудит решений и прозрачности для пользователей.
- Регуляторика и аудит: журналирование, хранение версий, возможность отката и аудит операций.
Риски и ограничения
Внутренние риски
- Неполное понимание ценности AI: ROI может быть неполным или задержанным.
- Нехватка квалифицированных кадров: требуются специалисты в области MLOps, Data Engineering, 데이터 Governance и Domain Expertise.
- Конфигурации и управляемость: слабый контроль версий, отсутствие стандартов, несогласованные методологии.
- Культура изменений: сопротивление сотрудников к новым практикам, необходимость обучения и адаптации.
Технические риски
- Качество данных и «грязные» данные: модели могут давать неверные результаты при плохой подготовке данных.
- Управление жизненным циклом моделей: отсутствие регулярного обновления и контроля версии.
- Масштабирование и cost-эффекты: рост затрат при масштабировании моделей и инфраструктуры.
- Безопасность и конфиденциальность: риск утечки данных, вредоносного использования, нарушение регуляторных требований.
- Этические риски: предвзятость, несправедливость алгоритмических решений, проблемы с ответственностью.
Ограничения внедрения
- Технологические: ограничения платформ и инструментов, совместимость библиотек и версий.
- Организационные: неясные процессы, недостаточная поддержка руководства, нехватка времени у команд.
- Регуляторные: локализация данных, требования к аудиту и прозрачности.
- Функциональные: сложность интеграции с существующей IT-инфраструктурой и бизнес-процессами.
Рекомендации по снижению рисков
- Чётко определить цели и KPI проекта AI, связанными с бизнес-ценностью.
- Ввести единые правила разработки и эксплуатации моделей (MLOps) и следить за их соблюдением.
- Развивать культуру обучения и обмена знаниями внутри CoE и доменов.
- Установить механизмы мониторинга качества данных, моделей и безопасности.
- Внедрить регуляторику и аудит с самого начала проекта.
- Периодически проводить аудит артефактов и обновлять их в соответствии с изменениями.
- Обеспечить прозрачность и доступность документированных методологий и решений.
Выводы
- Центр компетенций AI — это не просто набор технических инструментов, а управляемая и разворачиваемая платформа best practices, стандартов и сервисов, которые позволяют масштабировать AI-инициативы в организации.
- Продуктовый подход в рамках CoE обеспечивает концентрацию на ценности для пользователей, повторяемость паттернов и управляемость жизненным циклом моделей.
- Важность CoE состоит в создании единых артефактов: регистры моделей, feature store, пайплайны, мониторинг и регуляторные политики. Это обеспечивает ускорение разработки, снижение рисков и масштабируемость проектов.
- Реализация CoE может быть централизованной, федеративной или гибридной; выбор зависит от структуры организации, регуляторной среды и бизнес-целей.
- Взаимодействие между CoE и доменными командами, а также использование сочетания open-source и российских решений позволяют сочетать скорость внедрения, качество и локальные требования.
- Важно помнить о рисках: качество данных, управляемость затрат, этика и безопасность, а также нехватка квалифицированных кадров. Планирование, мониторинг и дисциплинированный подход к жизненному циклу моделей позволяют минимизировать эти риски.
FAQ (Вопросы и ответы)
1) Какова роль центра компетенций AI по сравнению с командой разработки проекта?
- Центр компетенций AI устанавливает стандарты, обеспечивает инфраструктуру, поддерживает артефакты и сервисы (регистры моделей, feature store, пайплайны, мониторинг). Команды разработки проектов применяют эти сервисы, формируют требования и несут ответственность за результаты в рамках бизнес-целей. CoE делает процессы повторяемыми и масштабируемыми, а команды — адаптируют их к своим доменным задачам.
2) Какие артефакты являются основой CoE и зачем они нужны?
- Основные артефакты: model registry (контроль версий моделей), feature store (повторное использование признаков), пайплайны MLOps, мониторинг качества данных и моделей, data lineage (происхождение данных), документация и обучающие материалы. Они позволяют повторно использовать решения, следить за качеством, управлять релизами и обеспечивать регуляторную и операционную прозрачность.
3) Какие инструменты чаще всего выбирают для CoE (open-source vs российские решения)?
- Open-source: MLflow, Kubeflow, Apache Airflow, Kedro, DVC, CatBoost, DeepPavlov, Natasha. Российские решения: Яндекс.Облако (инструменты MLOps в облаке), SberCloud, CatBoost (разработана в России), Natasha и DeepPavlov (российские NLP-бLib). Выбор зависит от контекста, требований к локализации данных и регуляторики.
4) Каковы основные организационные модели CoE?
- Центральный CoE: единые стандарты и сервисы, консолидация экспертизы и инфраструктуры. Федеративный CoE: несколько доменных CoE, координация через центральную платформу. Встроенный CoE: экспертиза внутри продуктовых команд. Гибрид: ядро CoE и доменные CoE работают вместе.
5) Какие риски наиболее критичны для внедрения CoE?
- Неправильное определение бизнес-ценности и ROI, нехватка квалифицированных кадров, слабые управляемые процессы, проблемы с данными, безопасность и конфиденциальность, регуляторные ограничения и этика.
6) Какие методы можно применять для мониторинга качества моделей?
- Мониторинг производительности по ключевым метрикам (AUC, RMSE и т.д.), мониторинг дрейфа данных и модели, аудит логов, управление версиями и возможность отката, уведомления и алерты.
7) Как обеспечить совместимость между доменными командами и CoE?
- ЧерезCatalogue артефактов, общие политики и стандарты, обучение и коучинг, сервисы поддержки, четко прописанные процессы согласования и SLA по поставке артефактов, а также регулярные ревью.
8) Какие образовательные практики эффективны в CoE?
- Обучающие программы, внутренняя сертификация по стандартам CoE, выпуск гайдлайнов и лучших практик, регулярные код-ревью и сессии обмена знаниями, видеоуроки и лабораторные задания.
9) Какие примеры российских и открытых решений можно применить на практике?
- CatBoost для задач с категориальными признаками; DeepPavlov и Natasha для NLP задач; RuGPT-3 как языковая модель (по мере доступности); Яндекс.Облако и SberCloud для инфраструктуры и MLOps; MLflow, Kubeflow, Airflow для оркестрации и реестра моделей; Feast как feature store.
10) Что учитывать при выборе модели взаимодействия CoE и команд?
- Уровень зрелости организации, регуляторные требования, доступность кадров, масштабы данных, требования к скорости вывода в продакшн и бюджет. В более регламентированной среде предпочтительны центральные стандарты и регистр артефактов; в более гибкой среде — федеративный или гибридный подход.
Мы проектируем AI-решения корпоративного уровня с учетом требований к безопасности, интеграции и масштабируемости: on-premise, приватные облака, RAG, векторные базы данных. Поможем подобрать архитектуру под ваши задачи и ограничения.


