

Архитектура моделей: выбор подходов, feature store и репозитории
В контексте современных задач прогнозирования спроса архитектура моделей выступает не столько как набор технических компонентов, сколько как инструмент достижения бизнес-целей: точности прогноза, скорости реакции на изменения рынка, прозрачности процессов и управляемости модели в рамках регуляторных требований. В этой главе рассматриваются принципы построения архитектур прогнозирования от статических статистических моделей до ML и гибридных подходов, с акцентом на управляемость жизненного цикла моделей, организационные роли и механизмы сотрудничества между командами data science, инженерии данных и бизнес-подразделениями. Особое внимание уделяется концепции feature store как единого источника признаков, а также репозиториям артефактов и данных, их роли в воспроизводимости и аудите процессов.
Архитектура должна отвечать на вопрос: как обеспечить единое и устойчивое взаимодействие между данными, моделями и бизнес-слой, чтобы прогнозы были сопоставимы во времени, легко обновлялись и могли проходить аудит в рамках регуляторных требований. Решение этой задачи требует не только выбора конкретной модели, но и проектирования слоёв данных, контрактов между компонентами, процессов тестирования и внедрения, которые позволяют минимизировать риск утечки данных, деградации качества признаков и «разрушающих» изменений в пайплайнах.
Краткое содержание главы
- Архитектурные парадигмы и концептуальные слои прогнозирования: данные, признаки, модели, доставка прогноза.
- Выбор подходов к прогнозированию спроса: критерии, сценарии применения статистических моделей, ML и гибридов.
- Feature store: роль, структура, управление качеством признаков и линейность данных.
- Репозитории моделей и артефактов: версионирование, воспроизводимость, доступ и безопасность.
- Управление жизненным циклом моделей и процессы MLOps: пайплайны, тестирование, мониторинг и обновление.
Архитектурные парадигмы прогнозирования: от данных к доставке прогноза
Современная архитектура прогнозирования спроса строится вокруг нескольких взаимодополняющих слоёв. На вход поступают данные из множества источников: транзакционные данные, внешние индикаторы, данные о запасах и логистике, данные по продажам в реальном времени. Эти данные проходят через слой обработки признаков, который обеспечивает консистентную семантику и единый контракт по времени обновления признаков. Затем идёт слой моделирования, который может включать в себя как статистические модели (например, сезонно-дифференцированные или режимно-факторные методы), так и современные алгоритмы машинного обучения, а иногда - гибридные схемы, где мануальные сигналы сочетаются с автоматизированными предиктивными сигналами. И, наконец, слой доставки прогнозов к бизнес-пользователям и системам оперативной деятельности: ERP, планировщики цепочек поставок, витрины BI.
Выбор архитектуры определяется не только качеством прогнозов, но и требованиями к скорости развёртывания, масштабируемости и управляемости: монолитная реализация может быть быстрой в начальной стадии, но быстро становится узким местом при росте числа доменов и географий. Модульная архитектура, поддерживаемая orchestration-инструментами и едиными контрактами по данным, обеспечивает независимость компонент, упрощает обновления и тестирование. В рамках этой парадигмы критически важны:
- единая спецификация интерфейсов между сбором данных, расчётом признаков, обучением и службой прогноза;
- контрактность временных меток и согласование горизонтов прогноза между компонентами;
- разделение оффлайн и онлайн стадий: обучающие пайплайны работают с историческими данными, инференс - с минимальной задержкой и с доступом к обновлённым признакам;
- строгая версия признаков, моделей и конфигураций, чтобы повторяемость экспериментов и развертываний была обеспечена.
Такие принципы позволяют избежать характерных для хаотической интеграции проблем: несогласованных версий данных, смещений семантики признаков, различий в логике окон и задержек между компонентами. В рамках методологии цифровой трансформации бизнес-процессы должны поддерживать «contract-first» подход: каждое изменение на уровне данных или признаков имеет явную дорожную карту и согласование с бизнес-инициативами.
Разделение на слои не исключает интеграции: данные могут проходить через единый поток обработки в рамках хранилищ и сервисов, но при этом каждый слой остаётся легко тестируемым и поддаётся мониторингу. Это особенно важно в контексте прогнозирования спроса, где данные часто обновляются в реальном времени и требуют адаптивности в подаче прогноза на оперативном уровне.
Как ориентир стоит привести архитектурную схему в виде контрактной диаграммы: источники данных → обработка признаков → обучаемые модели → онлайн-детали прогноза → оркестрация и доставка. Такой подход позволяет бизнесу и ИТ-структурам говорить на одном языке, снижать риск «разобщения» команд и ускорять внедрение новых методик.
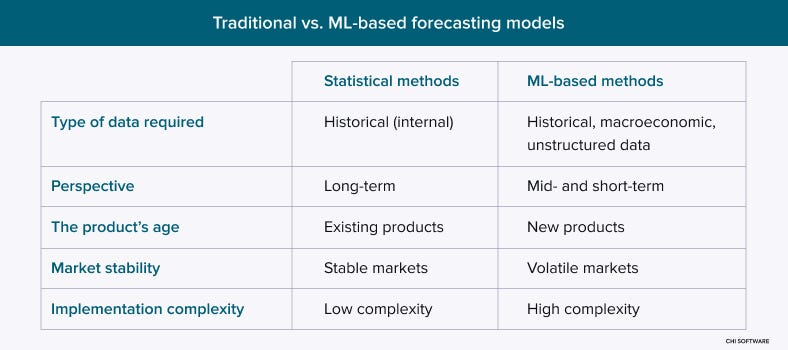
Выбор подходов к прогнозированию спроса: условия применения статистических моделей, ML и гибридов
Одной из ключевых задач при проектировании архитектуры является определение набора подходов, которые будут применяться на разных горизонтах и в разных бизнес-сценариях. Классический набор включает:
- статистические модели: ARIMA, экспоненциальное сглаживание, ETS-решения, регрессионные модели с сезонностью и лагами. Эти методы хорошо работают для стабильных сезонных процессов, быстро обучаются, требуют меньших вычислительных ресурсов и имеют прозрачную интерпретацию. Они особенно полезны для базовых ориентиров и регулятивных сценариев, где важна объяснимость.
- модели машинного обучения: деревья решений и их ансамбли (градиентный бустинг, LightGBM, XGBoost), регрессии с регуляцией, временные ретроспективные контексты, простые нейронные сети для обработки временных рядов. ML-методы хорошо улучшают точность за счёт учета сложных зависимостей, нелинейных эффектов и взаимодействий признаков, особенно когда доступно большое количество признаков и внешних факторов.
- гибридные подходы: сочетание статистических сигналов и ML-обработки. Примеры включают использование эконометрических компонент в качестве признаков для ML-моделей, добавление сигнатур сезонности и трендов из статистических моделей, объединение прогнозов через стекинг или конкатенацию предсказаний. Гибриды часто показывают устойчивый баланс между объяснимостью и точностью, особенно в контекстах с ограниченным набором исторических данных или строгими требованиями к валидности вRegulatory.
Выбор подходов должен основываться на нескольких критериях. Прежде всего - горизонт прогнозирования и требуемая точность. Короткие горизонты часто хорошо закрываются регрессиями и простыми моделями, тогда как длинные горизонты и сложные каналы спроса требуют использования ML-решений и гибридов. Далее - качество и доступность данных: для ML необходим набор качественных признаков и достаточная история событий; для статистических моделей - устойчивые сезонности и стабильные паттерны без частых резких изменений. Важен также уровень задержки и инфраструктурные ограничения: онлайн-инференс с задержкой в доли секунд требует лёгких моделей и быстро доступных признаков, тогда как пакетная обработка на ночь позволяет использовать более сложные алгоритмы и обширные признаки. Наконец, регуляторные требования и бизнес-управляемость: строгие требования к объяснимости и аудиту могут склонять к более простым, хорошо документированным моделям, в то время как бизнес-цели по точности и гибкости могут оправдывать внедрение гибридных и ML-решений.
Важной практикой служит внедрение тестируемой, повторяемой стратегии валидации. В задачах временных рядов характерной является проблема «look-ahead bias» - использование будущих данных в обучении. Эту проблему снимают с помощью подходов по временным разрезам данных, временной кросс-валидации и строгого формирования обучающей и тестовой выборок. Для операций важна устойчивость к дрейфу концепций и данных: модели должны адаптироваться к изменению рыночной конъюнктуры, но без неожиданных колебаний в бизнес-метриках. Именно здесь хорошо работают процедуры автоматизированного мониторинга и периодического ретренинга: накапливая новые данные, система должна оценивать, что именно изменилось и требуется ли обновление модели.
Говоря о практике внедрения, следует помнить: простота - часто лучший выбор на первых стадиях проекта; сложные архитектуры - на последующих шагах с осознанной потребностью в инновациях и масштабировании. В рамках методологии важно документировать обоснование выбора модели, фиксировать цепочку источников данных и признаки, а также устанавливать регламент по ревизиям и аудиту изменений. Это обеспечивает не только качество прогноза, но и управляемость процессов - ключевой фактор в трансформации бизнес-подразделения.
Feature store: роль, структура, управление признаками и линейность данных
Feature store выступает как центральная звено архитектуры, которое обеспечивает единый источник признаков для обучения и инференса моделей. Его задача - систематизировать, версионировать и доставлять признаки в нужном контексте и формате, уменьшая дублирование вычислений и риски рассогласования между обучением и реальным прогнозированием.
Ключевые элементы feature store:
- каталог признаков и их семантики: описание источников, допустимых значений, агрегатов, окна времени, единиц измерения и семантики; «contracts» по времени обновления и согласованию признаков между обучением и инференсом.
- механизм инжекции признаков: процессинг признаков, который может включать вычисление внутри пайплайна или извлечение признаков из готовых матриц; поддержка offline (для обучения) и online (для инференса) режимов.
- версия признаков и детерминированность: каждый признак, его версия, параметры трансформаций, код вычисления и зависимые данные должны быть воспроизводимыми. Это обеспечивает повторяемость экспериментов и развертываний.
- lineage и качество данных: отслеживание источников признаков, их трансформаций и качества: полнота, своевременность, точность; мониторинг сигнатур признаков во времени и обнаружение аномалий.
- безопасность и доступ: реализация принципа минимальных прав доступа, аудит доступа к признакам и возможность ограничить утечки чувствительных данных.
Реализация feature store может опираться на готовые решения, например Feast как открытое решение, или на коммерческие платформы, оснащённые дополнительными сервисами мониторинга качества и соответствия требованиям регуляторов. Важно помнить, что выбор конкретного инструмента должен соответствовать масштабам организации, скорости обновления признаков и требованиям к безопасности.
Типовые паттерны проектирования признаков включают:
- единый набор признаков-компонентов: признаки, связанные с конкретной бизнес-областью, такие как продажи по магазинам, запасы, промо-инициативы и внешние индикаторы.
- группировка признаков по сущностям (entity-centric features): признаки, связанные с конкретной сущностью бизнеса (товар, магазин, регион) и их временные окна.
- онлайн кэширование признаков: предварительная обстановка частоиспользуемых признаков в онлайн-таймингах для снижения задержек инференса.
- управление качеством признаков через пайплайны: автоматические тесты на полноту, тайминг и корректность вычислений.
Роль open-source и контекст локальных практик. В рамках этой главы уместно упомянуть одну-две значимые технологии как ориентиры. Например, Feast как производительное решение для управления признаками, помогающее синхронизировать данные между обучением и инференсом; альтернативные подходы на базе Hopsworks или аналогичных систем могут быть использованы в зависимости от инфраструктурной среды и требований к интеграции. Применение feature store снижает операционные риски, упрощает обновления признаков и улучшает воспроизводимость моделей в течение их жизненного цикла, что особенно важно для бизнес-подразделений, ориентированных на долгосрочную устойчивость прогноза.
Репозитории моделей и артефактов: версионирование, воспроизводимость, безопасность
Артефакты моделей и связанная с ними история экспериментов требуют аккуратного управления. Репозитории и артефакты обеспечивают воспроизводимость, сравнимость и аудит изменений в моделях и данных. Ключевые компоненты:
- регистр моделей (model registry): хранение версий моделей, их метрик, окружений и конфигураций; возможность отката до предыдущих версий и выбор подходящей версии для развёртывания.
- хранилища артефактов: бинарники моделей, конфигурации, токены окружений и данные об экспериментах; связь с набором признаков и данными обучающимися пакетами.
- код и конфигурации: версии кода моделирования и трансформаций; фиксация зависимостей и окружений, чтобы обеспечить воспроизводимость среды выполнения.
- отслеживание экспериментов и метрик: запись параметров экспериментов, параметров гиперпараметров, результатов и сравнение между версиями.
- безопасность и аудит: управление доступом, журналирование операций, соответствие требованиям к защите конфиденциальной информации и регулятивным нормам.
На практике в рамках методологии организации целесообразно сочетать несколько инструментов. Для кода обычно применяют Git как базовую систему контроля версий, обеспечивающую ветвление и аудит изменений. Для артефактов и метрик - MLflow или Kubeflow Metadata в зависимости от технологического стека, которые позволяют сохранять метрики, этапы пайплайна и параметры экспериментов. Для данных и признаков - отдельные линейки версий (data versioning) и интеграция с системой хранения, чтобы обеспечить управляемость версий обучающих наборов и целевых метрик. Важной практикой является запись «data provenance»: откуда пришли данные, какие трансформации применены, какие версии признаков использованы в конкретной версии модели. Это особенно важно для аудита и соответствия регуляторным требованиям.
Эффективная архитектура репозиториев требует ясной политики версионирования и контроля доступа. В рамках корпоративной трансформации рекомендуется:
- устанавливать политики ревизий для данных, признаков и моделей: определять, какие версии можно использовать в продакшене, какие - только в опытной среде;
- внедрять автоматизированные проверки качества данных и признаков, чтобы не пропускать в продакшен некорректные входы;
- обеспечивать прослеживаемость: связь между версией кода, версией модели, версией признаков и данными обучающего набора;
- внедрять стратегии отката: возможность быстро вернуть систему к рабочей версии без риска для бизнеса.
Репозитории и артефакты - это не просто хранилища. Это инфраструктура доверия между командами. Они позволяют проектам двигаться быстрее, сохраняя при этом контроль над качеством, безопасностью и соответствием регуляторным требованиям. В сочетании с feature store и единым контрактом по данным они образуют базис устойчивой архитектуры прогноза спроса.
Управление жизненным циклом моделей и практики MLOps
Эволюция модели от идеи до повседневной эксплуатации требует структурированного жизненного цикла и внедрения практик MLOps. Без надлежащей автоматизации процессы обучения, тестирования и развёртывания превращаются в риск для бизнес-решений и в риск для регуляторного соответствия. Основные элементы жизненного цикла:
- планирование и сбор требований: согласование горизонтов, метрик эффективности, порогов для перерасчёта и обновления моделей; участие бизнес-владельцев в формулировании цели.
- подготовка данных и признаков: ускорение пайплайнов, управление качеством данных, версии признаков, проверка отсутствующих значений и аномалий.
- обучение и валидация: создание обучающих и валидационных наборов с учётом временных зависимостей; использование техник временного разделения и backtesting; фиксация параметров гиперпараметров и сред их изменений.
- оценка рисков и безопасность: анализ на предмет ложноположительных/ложноотрицательных сигналов, drift, качество признаков и риски leakage; проверка политик безопасности и конфиденциальности данных.
- развёртывание и эксплуатация: упаковка моделей в контейнеры, использование model registry, управление окружениями, мониторинг производительности и задержек.
- мониторинг и обновление: непрерывный мониторинг качества прогнозов, дрейфа данных и концепций; определение триггеров для ретренинга и автоматизации обновлений; проведение A/B-тестирования и canary-развертываний.
- аудит и регулятивная отчётность: фиксирование истории изменений, контроль доступа и аудит доступа к данным, признакам и моделям; обеспечение прозрачности по регуляторным требованиям.
Мониторинг в реальном времени особенно значителен для прогнозирования спроса в рознице и цепочках поставок. Необходимо внедрить механизмы drift-детекции (как по данным, так и по концепциям), чтобы своевременно обнаруживать деградацию модели и сигнализировать о необходимости обновления. В сочетании с ретренинг-процессами, которые запускаются автоматически или по инициативе продакт-ответственных, выстраивается устойчивый цикл улучшения качества прогноза.
Важно помнить: архитектура и процесс должны быть адаптируемыми к изменениям в бизнес-модели и в регуляторной среде. Это требует формализованных ролей и процессов, таких как:
- Data Engineer: ответственный за инфраструктуру данных, обработку признаков и их актуализацию.
- ML Engineer/Platform Engineer: реализация pipelines, deployment, мониторинг, обеспечение воспроизводимости.
- Data Scientist: проектирование моделей, анализ признаков, валидация гипотез.
- Product Owner: определение целей прогноза, требования бизнеса и приоритезация задач.
- Compliance и Governance: обеспечение прозрачности, аудита и соответствия требованиям.
Организационные изменения часто идут рука об руку с техническим внедрением: создание кросс-функциональных команд, внедрение единого репозитория артефактов, стандартизация контрактов по данным и признакам, а также развитие культуры документирования и контроля качества. В рамках методологии следует внимательно управлять изменениями, чтобы новые практики действительно внедрялись и приносили бизнес-эффекты.
Key takeaways
- Архитектура прогнозирования требует четкого разделения слоёв данных, признаков, моделей и доставки прогноза, а также контрактности между ними.
- Выбор подходов к прогнозированию должен основываться на горизонте, доступности данных, требованиях к скорости и регуляторных ограничениях; гибридные решения часто дают лучший баланс между точностью и объяснимостью.
- Feature store обеспечивает единый источник признаков, облегчает повторное использование вычислительных преобразований, контроль версий и линейность данных между обучением и инференсом.
- Репозитории моделей и артефактов должны обеспечивать воспроизводимость, аудит, безопасность и управляемость изменений на протяжении жизненного цикла модели.
- Управление жизненным циклом и практики MLOps позволяют систематизировать обучение, валидацию, развёртывание и мониторинг моделей, снижая риски и ускоряя внедрения.
- Организационные изменения должны сопровождать техническую реализацию: роли, процессы управления изменениями, образцы документации, регламенты аудита и регуляторной готовности.
FAQ
1) Как выбрать архитектурную парадигму для прогноза спроса в крупной компании?
- В первую очередь определить требования к скорости развёртывания, масштабу и регуляторным ограничениям. Монолитная архитектура может быть оправдана на старте пилота, но для масштабирования лучше перейти к модульной архитектуре с чёткими контрактами между слоями данных, признаков и моделей. Важно обеспечить единый язык данных и совместимость между обучением и инференсом через feature store и registry, чтобы можно было быстро внедрять новые признаки и модели без риска рассогласования.
2) Что такое feature store и зачем он нужен в прогнозировании спроса?
- Feature store - единый репозиторий признаков с версионированием и механизмами поставки признаков как в обучение, так и в инференс. Он снижает повторные вычисления, обеспечивает совместную семантику признаков и упрощает управление качеством данных. В условиях оперативного спроса и регулярных обновлений признаков это усиливает воспроизводимость и ускоряет развёртывания.
3) Какие примеры открытых инструментов уместны для реализации feature store?
- Feast - популярное открытое решение для управления признаками и их поставки между обучением и инференсом. Второй пример - решения на базе Hopsworks, которые также предлагают функциональность feature store в составе комплексной платформы. Выбор зависит от инфраструктурных условий, совместимости с существующим стеком и требований к мониторингу качества данных.
4) Какие элементы должны быть в регистре моделей и артефактов?
- В регистр моделей следует включать версии моделей, метрики производительности, окружение выполнения и параметры. В артефакты - сами веса моделей, конфигурации обучения, наборы признаков и связь с экспериментальными метриками. Важно обеспечить связь между версией кода, версией признаков и версией данных, использованных в обучении, для возможности воспроизведения результата.
5) Как обеспечить воспроизводимость жизненного цикла моделей?
- Используйте единый контроль версий (Git) для кода, регистр моделей и артефекты, а также систему управления зависимостями и окружениями. Фиксируйте параметры экспериментов, версии данных и признаки, а также сохраняйте детальную метаданную по каждому запуску. Внедрите автоматизированные пайплайны, которые повторяют обучающие и инферентные циклы с контролируемыми версиями.
6) Какие практики MLOps применимы к прогнозированию спроса?
- CI/CD для ML с автоматическим тестированием качества данных, воспроизводимости окружений и регрессионного тестирования моделей; мониторинг drift-данных и концепций; автоматизированные ретренинги при наступлении предельных значений или по расписанию; стратеги тестирования через A/B или canary-развертывания; документирование и аудит изменений для регуляторных целей.
7) Как организовать управление данными и признаками с точки зрения безопасности?
- Применяйте принцип минимальных прав доступа, сегментацию данных, анонимизацию и маскирование чувствительных полей на этапе подготовки признаков; используйте аудит журналов доступа, хранение только необходимых копий признаков и строгую политику хранения версий. В контексте регуляторики это становится основой доверия к системе и снижает риски.
8) Какие организационные изменения чаще всего сопровождают внедрение архитектуры «с учётом MLOps»?
- Формирование кросс-функциональных команд (Data Engineering, ML Engineering, Data Science, Product Owner); внедрение единого репозитория артефактов и контрактов по данным; развитие культуры документирования, регламентов качества и аудита; создание процессов регуляторной готовности и регулярных обзоров эффективности моделей.
9) Как минимизировать риск утечки данных и деградации качества признаков?
- Построить контракты по данным и признакам, внедрить мониторинг качества признаков и drift-детекцию, организовать периодические ревизии признаков и ограничение доступа к чувствительным данным; использовать offline/online разделение, чтобы не «подмешивать» обучающие данные с реального времени без контроля.
10) Какие шаги выполнить на первых шагах по внедрению архитектуры прогноза спроса?
- Определить горизонты и базовые метрики; выбрать минимально жизнеспособную архитектуру с базой на статистических моделях и простых признаках; внедрить feature store для ключевых признаков; создать регистр моделей и базовую пайплайн-задачу для повторяемых обучений; запустить пилот в одном бизнес-доджоне и постепенно масштабировать.
Если ваша компания планирует внедрение продвинутой аналитики или систем прогнозирования на базе AI, важно выстроить правильную архитектуру данных и платформу для аналитики.
Узнайте, как реализовать искусственный интеллект для бизнеса — от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до разработки решений прогнозирования, AI-ассистентов и интеллектуальных систем, интегрированных в бизнес-процессы компании.


