

Процесс разработки и управления проектами прогнозирования: CRISP-DM, Agile, DevOps для ML
Прогнозирование спроса является ключевой функцией цифровой трансформации в бизнесе. Оно сочетает строгую статистику, данные оперативной деятельности и современные подходы машинного обучения. Эффективность прогностических проектов во многом определяется не только точностью моделей, но и умением управлять процессами: от постановки цели и сбора данных до эксплуатации модели и её мониторинга в реальном времени. В рамках этой главы рассматриваются интеграции классических методологий обработки данных и современных практик DevOps и Agile, применимые к проектам прогнозирования спроса, включая организацию команд, пайплайны данных, контроль качества и устойчивую поставку моделей в продакшн.
Данная глава ориентирована на баланс между концепциями и практикой. Рассматриваются как базовые методологические конструкции, так и конкретные инженерные решения, которые обеспечивают воспроизводимость, масштабируемость и управляемость прогностических систем. В конце приведены практические рекомендации по внедрению в рамках компаний с различной зрелостью процессов аналитики, с учётом специфики отрасли, сезонности и динамики спроса.
- Краткое содержание главы
- Специалистам в области data science и инженерии данных: как связать методологию CRISP-DM с архитектурой ML-пайплайнов.
- Руководителям проектов: как организовать работу команды, определить цели, KPI и управление рисками.
- Инженерам DevOps и ML: как строить автоматические пайплайны, обеспечить воспроизводимость и мониторинг моделей.
- Руководство по внедрению: интеграция с существующей инфраструктурой, выбор инструментов и контроль качества.
Концептуальные основы управления проектами прогнозирования
Прогнозирование спроса представляет собой мультидисциплинарную задачу, в которой участвуют бизнес-стратегия, сегментация рынка, операционные ограничения и технологические решения. В основе эффективной организации лежит ясное определение целевых задач: горизонты прогноза (ежедневный, недельный, сезонный), требуемая точность и допустимый риск ошибок. Важным аспектом является выбор уровня абстракции и агрегации данных: от агрегированных временных рядов по SKU до детализированной номенклатуры с элементами Promotions и внешних факторов.
Не менее значимо проработать качественные требования и критерии приемки прогноза. Это включает в себя согласование целевых метрик (например, MAE, RMSE, MAPE, sMAPE), требования к задержке прогноза и ограничение на вычислительные ресурсы. Также важно определить стратегию валидации: как будут моделироваться сезонность и эффект подарков, как учитывать пропуски и выбросы, какие внешние переменные допустимы к включению и на каких горизонтах они работают лучше.
Организационные аспекты включают роли и ответственности, принципы коммуникации между бизнес-подразделениями и командой разработки, а также требования к управлению данными. В контексте прогнозирования спроса критична концепция «право на данные»: наличие доверенных источников, документированная история данных, версии источников и изменений в их структуре. В этом смысле роль этики данных, соответствие регулятивным требованиям и защита персональных данных играют существенную роль для устойчивой эксплуатации моделей.
С точки зрения архитектуры проекта, целесообразно рассмотреть три слоя: слой данных, слой моделей и слой эксплуатации. Слой данных обеспечивает сбор, очистку, агрегацию и качество данных, включая обработку пропусков, согласование временных и категориальных признаков. Слой моделей включает выбор алгоритмов, настройку гиперпараметров и экспериментирование в рамках управляемого процесса. Слой эксплуатации охватывает развёртывание, мониторинг производительности, обновления моделей и автоматизацию бизнес-процессов, которые используют прогнозы.
В рамках гибридных подходов особое значение приобретает балансarity между предсказательной мощностью и операционной устойчивостью. Методы, сочетающие статистические модели с ML-алгоритмами, позволяют использовать сильные стороны каждого класса: интерпретируемость и мониторинг устойчивости статистических моделей наряду с адаптивностью и нелинейной выразительностью ML. Управление проектом должно обеспечивать координацию между анализом данных, инженерией данных, продуктовым управлением и операциями.
CRISP-DM как базовый цикл для прогнозирования
CRISP-DM (Cross-Industry Standard Process for Data Mining) предоставляет структурированный подход к решению задач прогноза спроса и адаптирован к ML-практикам. В контексте прогностических проектов спроса он претерпевает эволюцию: этапы остаются понятными, но акценты смещаются в сторону воспроизводимости, монитории и интеграции в бизнес-процессы.
Ключевые этапы и их адаптация:
- Бизнес-Understanding. Определение целей, критерия успеха, ограничений по времени и ресурсам. Важно согласовать метрики бизнес-эффекта: увеличение продаж, точность запасов, снижение несоответствий. Документированная постановка задачи становится мостом между аналитикой и операциями.
- Data-Understanding. Оценка источников данных, их полноты, качества и временной совместимости. В контексте спроса это включает исторические продажи, промо-акции, ценообразование, погодные факторы и внешние индикаторы экономической активности. Важен процесс фиксации доменных знаний: сезонность, праздничные пики, тренды.
- Data-Preparation. Подготовка данных, создание признаков, обработка пропусков и аномалий, нормализация и трансформации, согласование по временным шкалам. Для прогнозирования спроса особенно полезны техники скользящих окон, лаги, скейлины и индикаторы внешних факторов.
- Modeling. Выбор моделей, включая классические time-series подходы (ARIMA, SARIMA), регрессионные модели с регрессорами-признаками, а также современные ML-алгоритмы (градиентный бустинг, нейронные сети). В контексте гибридных подходов возможно сочетание нескольких моделей через ансамбли или стекирование.
- Evaluation. Оценка моделей не только по общим метрикам, но и по устойчивости к сезонным эффектам, редким событиям и возможностям генерализации на регионы/SKU. Важна схема кросс-валидации, адаптированная под временные ряды (rolling-origin, walk-forward).
- Deployment. Развертывание моделей в продакшн-среду, настройка пайплайнов данных, интеграция с BI и ERP, автоматизация обновления прогнозов. Особое внимание к повторяемости развёртываний и к контролю версий моделей.
- Monitoring and Maintenance. Постоянный мониторинг точности прогноза, данных и концептов. Необходимо фиксировать отклонения (data drift, concept drift), автоматизировать уведомления и регламентировать процесс обновления моделей.
Потребность в артефактах и документации здесь особенно высокая: спецификации потребностей, требования к входным данным, сигнатуры признаков, репозитории кода и данных, регистры экспериментов и версии моделей. В CRISP-DM важна жёсткая управляемость изменений: любые корректировки признаков, гиперпараметров или функций должны сопровождаться доказательствами улучшения и планом повторного тестирования.
| Этап CRISP-DM | Основной вклад в проект прогноза спроса | Типовые артефакты |
|---|---|---|
| Бизнес-Understanding | Определение целей, KPI и ограничений | Бизнес-требования, карта риска, критерии успеха |
| Data-Understanding | Оценка доступности и качества данных | Описание данных, дата-метаданные, отчёты качества |
| Data-Preparation | Подготовка признаков и данных | Data pipeline, признаки, документация трансформаций |
| Modeling | Подбор и настройка моделей | Экспериментальные наборы, гиперпараметры, результаты |
| Evaluation | Проверка на реальном опыте и устойчивость | Метрики, тестовые наборы, планы внедрения |
| Deployment | Развёртывание и интеграция | Образы окружения, пайплайны CI/CD, регистр моделей |
| Monitoring & Maintenance | Поддержка и обновления | Мониторинг, планы обновления, регламент изменений |
CRISP-DM служит прочной основой, но её реализация в ML-проектах требует адаптации к специфике временных рядов и эксплуатации. Важный момент - документирование предпосылок: зачем именно применяется та или иная модель, какие внешние факторы учтены, какова граница ответственности между командой аналитики и бизнес-подразделением. Также следует предусмотреть процедуры для повторного тестирования после входа изменений в данные, чтобы избежать регрессионных ошибок в послеоперационном периоде.
Agile и DevOps для ML: итерации, архитектура и качество
Гибкость и скорость внедрения становятся неотъемлемой частью процесса прогнозирования спроса через Agile и DevOps-практики. Agile обеспечивает быструю интерпретацию бизнес-эмпирических находок, быструю прототипизацию и обратную связь от пользователей. DevOps расширяет эти принципы на инженерную сторону, обеспечивая автоматизацию пайплайнов, единообразие окружений и надёжность эксплуатации.
Agile-аспекты:
- Сплошная визуализация дорожной карты и Backlog. Эпики и истории пользователя фиксируют цели прогноза, требования к точности и временем доставки. В процессе работы следует использовать спринты короткой длительности (2-4 недели) для активного тестирования гипотез и быстрой адаптации к изменениям спроса.
- Итеративное экспериментирование. В рамках каждого спринта создаются и сравниваются альтернативные признаки, модели и подходы к обработке данных. Важно фиксировать результаты: улучшение показателей, устойчивость на сезонных пиках и эффект от внедрения внешних факторов.
- Принцип «готовности к продакшену». Готовность функционала к развёртыванию проверяется на уровне готовности к внедрению: отказоустойчивость пайплайнов, качество данных, прозрачные метрики и реализованная роль владения данным.
DevOps и MLOps для ML:
- Автоматизация пайплайнов. Инфраструктура автоматического извлечения данных, подготовки признаков, обучения моделей и развёртывания обеспечивает повторяемость и уменьшает риск человеческих ошибок. Инструменты оркестрации, такие как Apache Airflow, помогают управлять задачами и зависимостями.
- Управление зависимостями и версиями. Системы контроля версий для кода и данных (например, DVC) позволяют сохранять историю изменений наборов данных и конфигураций моделей. Это критично для воспроизводимости и аудита.
- Регистр моделей и мониторинг. Роль ML-регистров и систем мониторинга предназначена для отслеживания версий моделей, их метрик в проде и сигналов drift. Непрерывное обновление моделей требует четко прописанных триггеров на перерасчёт и откат.
- Контроль качества и тестирование. Включает unit-тесты для пайплайнов, интеграционные тесты на полноту и консистентность данных, а также сценарии регрессионного тестирования прогнозной функциональности в условиях сезонных изменений.
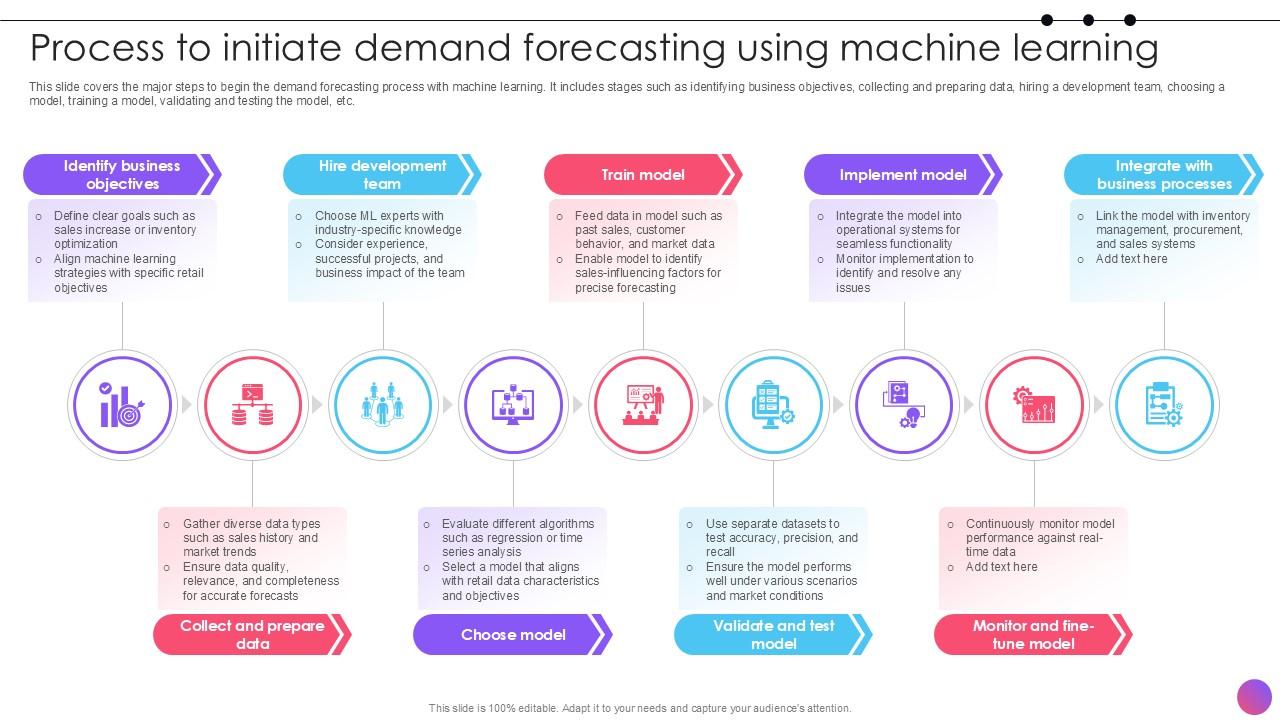
Архитектура и инфраструктура:
- Пайплайны данных как единая нить. Пайплайн должен поддерживать как повторяемость, так и адаптивность. Важна прозрачность: от источников данных до итогового прогноза - каждый шаг должен быть документирован и доступен для аудита.
- Feature store как центральный репозиторий признаков. Наличие централизованного слоя признаков позволяет разделять инженерную и аналитическую роли, снижает дублирование и обеспечивает согласованность данных между моделями.
- Безопасность и соответствие. Принципы минимального доступа, шифрование данных, контроль версий и журналирование действий критически важны в контексте корпоративной среде и регуляторных требований.
В части инструментов можно привести одним-двумя примерами: для оркестрации - Apache Airflow; для экспериментов и версий моделей - MLflow; для версии данных - DVC. Эти решения помогают выстроить связные процессы между аналитикой и инженерией, не перегружая архитектуру лишним инструментарием.
Поскольку прогнозирование спроса часто требует интеграции с системами планирования запасов и продаж, архитектура должна предусматривать взаимодействие с ERP/CRM и BI-платформами. Это включает в себя детальные контракты по API, структурированные обмены данными и согласование форматов временных рядов. Важно обеспечить возможность масштабирования: как по количеству SKU, так и по географическому покрытию, а также по частоте обновления прогнозов.
Архитектура и инфраструктура прогнозирования: пайплайны, данные, модели
Данная часть сосредоточена на технических решениях, которые позволяют превратить стратегические цели в работающие алгоритмы и устойчивые сервисы. В прогнозировании спроса критически важны качественные данные, точность и адаптивность. Архитектура должна поддерживать как разовый анализ, так и непрерывное обновление моделей в условиях изменения рынка и внешних факторов.
Основные принципы:
- Источники данных. Внутренние источники - продажи, запасы, промоакции, ценовые политики; внешние - погодные условия, экономические индикаторы, календарные эффекты. Важно обеспечить согласованность временных меток, единиц измерения и полноту данных в рамках единого хранилища.
- Качество данных. Внедряются предохранители против пропусков и аномалий, автоматические проверки достижимости признаков, контроль консистентности и логика обработки пропусков на этапе подготовки данных. Качество данных напрямую влияет на устойчивость моделей к сезонным и внешним колебаниям.
- Пайплайны и практики тестирования. Пайплайн строится так, чтобы его можно было независимо тестировать на локальном наборе данных и в продакшне. Включаются проверки на корректность трансформаций и контроль версий каждого шага.
- Модели и хранение. Архитектура разделяет хранение признаков, моделей и результатов. Feature store упрощает повторное использование признаков между моделями и этапами анализа. Регистры моделей позволяют управлять версиями и воспроизводимостью.
- Мониторинг и эксплуатация. Мониторинг точности прогноза, data drift, концептуальные сдвиги, задержки развёртывания и ошибки интеграции. Наличие алертинга и регламентов по обновлениям минимизирует риск деградации сервиса.
Инструменты и методы:
- Оркестрация задач. Современные практики требуют надежной оркестрации. Выбор между Airflow, Dagster и Prefect зависит от инфраструктуры и корпоративной культуры. Они обеспечивают планирование, повторяемость и прозрачность выполнения пайплайнов.
- Эксперименты и воспроизводимость. Для отслеживания гиперпараметров и конфигураций необходимы инструменты, которые сохраняют контекст эксперимента: данные, код, параметры и метрики. MLflow - один из популярных инструментов, применяемых для регистрации экспериментов и моделей.
- Управление данными. Версионирование данных и их трансформаций становится обязательным. DVC или подобные решения позволяют хранить данные и конфигурации отдельно от кода, обеспечивая репродукцию целей и результатов.
Сферы внедрения в бизнесе часто требуют адаптации архитектуры под существующую IT-инфраструктуру и регуляторные требования. Важно тщательно просчитать стоимость владения и операционные риски: задержки в обновлениях, зависимость от отдельных сервисов и сложность поддержки в условиях роста числа SKU или географий.
Управление проектами и организационные изменения
Успешное внедрение прогнозирования требует не только технической экспертизы, но и управленческих процессов, которые поддерживают устойчивую поставку моделей и ценность для бизнеса. В контексте гибридного подхода следует учитывать взаимодействие между бизнес-подразделениями, аналитикой, инженерией данных и операциями.
Ключевые организационные практики:
- Роли и ответственности. В проекте прогнозирования спроса важно четко определить роли: Product Owner, Data Scientist, Data Engineer, ML Engineer, DevOps-инженер, Аналитик по бизнес-значимости. Роли должны быть синхронизированы через регламенты по принятию решений и ответственности за данные, модели и результаты.
- Приоритеты и управление рисками. KPI должны быть привязаны к бизнес-целям: точность прогноза, уменьшение излишков/недостачей, улучшение сервиса клиента, сокращение времени цикла изменений. Риск-менеджмент охватывает неопределенности, связанные с данными, сезонностью и изменениями в бизнес-процессах.
- Документация и аудируемость. Все этапы проекта должны быть документированы: гипотезы, методики подготовки данных, применяемые признаки, параметры моделей и выводы аудитов. Это обеспечивает соответствие требованиям к прозрачности и регуляторным нормам.
- Организационные изменения. Внедрение CRISP-DM, Agile и DevOps часто требует изменений в культуре: адаптация к экспериментальному мышлению, увеличение ответственности за качество данных и взаимная ответственность за результат. Важны обучение команд новым практикам, формирование кросс-функциональных команд и создание общих площадок для обмена знаниями.
Процедуры внедрения и коммуникации:
- Регулярные демонстрации бизнес-результатов. Периодические обзоры всех шагов проекта - от данных и признаков до точности прогноза и влияния на операцию - укрепляют доверие руководства.
- Управление изменениями. В контексте ML-проектов часто возникают непредвиденные изменения в данных или бизнес-правилах. Необходимо предусмотреть процесс обработки таких изменений, включая ревизии артефактов, повторную валидацию и регламентный выпуск обновлений.
- Безопасность и доступ. Управление доступами к данным и моделям, соблюдение политики безопасности и конфиденциальности критично для соблюдения регуляторных требований и внутренней политики компании.
Внедрение и эксплуатация прогностических систем
После успешного тестирования и согласования по бизнес-целям наступает период эксплуатации и постоянного улучшения. В этой фазе особое внимание уделяется монитории, устойчивости и адаптивности систем.
Практические рекомендации:
- Мониторинг производительности. Включайте метрики точности, скорость обновления прогноза и устойчивость к сезонности. Определите пороги отклонения и четкие процедуры на случай превышения порога.
- Управление изменениями данных. Ввод изменений в источники данных должен сопровождаться документированными тестами на совместимость, регламентами миграции и уведомлениями для заинтересованных сторон.
- Обновления моделей. Планируйте обновления с учётом сезонности и бизнес-периодов. Обеспечьте откат к предыдущей версии в случае непредвидимых сбоев.
- Взаимодействие с бизнес-пользователями. Непрерывная обратная связь от пользователей прогнозов позволяет своевременно корректировать признаки, модельный подход и требования к системе.
- Аудит и прозрачность. Наличие журналов изменений, версий моделей и данных важно для регуляторной и операционной прозрачности.
Key takeaways
- Прогнозирование спроса требует сочетания методологической дисциплины и инженерной практики для воспроизводимости и устойчивости.
- CRISP-DM обеспечивает структурированное управление проектом, адаптированное к ML и временным рядам.
- Agile и DevOps для ML позволяют быстро тестировать гипотезы, автоматизировать пайплайны и обеспечить непрерывную поставку моделей.
- Архитектура должна поддерживать данные, признаки и модели в виде связной цепи: с единым пайплайном данных, feature store и регистром моделей.
- Управление проектом требует ясных ролей, регламентов по качеству данных, документирования и аудитируемости изменений.
- Эксплуатация прогностических систем требует постоянного мониторинга, механизмов обновления и тесной связи с бизнес-пользователями.
- В гибридной модели особенно важна гармония между точностью и операционной надёжностью, а также прозрачность и управляемость процессов.
FAQ
1) Что такое CRISP-DM и зачем он нужен в прогнозировании спроса?
CRISP-DM - это структурированный цикл data mining, состоящий из этапов бизнес- understand-, data-understanding, data-preparation, modeling, evaluation, deployment и monitoring. В прогнозировании спроса он обеспечивает системный подход к формулированию целей, подготовке данных и валидации моделей, к тому же он помогает связать технические решения с бизнес-целями и регламентами. В ML-практике CRISP-DM становится инкрементальной рамкой: бизнес-цели формируются сначала, затем происходит итеративная подготовка данных и моделирование с непрерывной оценкой на реальных сценариях.
2) Как выбрать между CRISP-DM, Agile и DevOps в рамках одного проекта?
CRISP-DM задаёт фундаментальные мосты между бизнесом, данными и моделями, Agile - темп и адаптивность разработки, DevOps - практики эксплуатации и воспроизводимости. Оптимальная стратегия - использовать CRISP-DM как фундаментальный цикл, дополнительно внедрять Agile-процедуры для итераций и сценариев тестирования, и применять DevOps/MLOps для автоматизации пайплайнов, версий данных и моделей, а также мониторинга в продакшне. В реальности возможна интеграция: CRISP-DM задаёт артефакты и очередность, Agile управляет спринтами и приоритетами, DevOps обеспечивает качество развёртывания и эксплуатации.
3) Какие KPI наиболее подходят для оценки прогноза спроса?
Выбор KPI зависит от бизнес-задач: точность прогноза на уровне запасов и продаж, а также устойчивость к сезонности. Часто применяются RMSE (или RMSE за конкретный период), MAE, MAPE и sMAPE, которые дают представление об ошибке в денежной или количественной шкале. Дополнительно оценивают бизнес-метрики: процент попаданий в целевые диапазоны запасов, сокращение издержек на хранение, сокращение несоответствий и улучшение обслуживания клиентов. Важно сочетать статистические метрики с бизнес-метриками, чтобы обеспечить связь прогноза с операционными результатами.
4) Какие артефакты критически важны для воспроизводимости?
Критичны: детальная версия данных и их источник, признаки, параметры моделей, скрипты обучения и их конфигурации, версии кода и окружения, а также логи экспериментов и результаты метрик. В идеале всё хранится в регистре моделей и системах для управления экспериментами и версиями данных (например, MLflow и DVC), что упрощает откат к предыдущим версиям и аудит изменений.
5) Как обеспечить безопасность и соответствие регуляторным требованиям в ML-проектах?
Необходимо обеспечить управление доступом к данным, журналирование действий, контроль версий и аудируемость изменений. В зависимости от отрасли применяются требования к защите персональных данных, шифрованию и хранению исторических данных. В архитектуре следует предусмотреть разделение ролей, минимальные привилегии доступа и механизмы доверенных источников данных, чтобы снизить риск утечки и нарушений.
6) Как организовать команды для эффективного сотрудничества?
Необходимо создать кросс-функциональные команды с четкими ролями и ответственностью, определить каналы коммуникации и регламенты по принятию решений. Важны регулярные встречи по демонстрации результатов, совместная работа над артефактами и обеспечение доступа к инструментам мониторинга и регистрам моделей.
7) Какие риски наиболее распространены в проектах прогноза спроса и как их минимизировать?
Ключевые риски: нестабильные источники данных, изменение бизнес-правил, сезонные аномалии и регуляторная неопределённость. Минимизация достигается через качественный подход к управлению данными (версионирование, проверки качества), устойчивую архитектуру пайплайнов, детальное документирование и внедрение мониторинга. Также критически важна возможность отката и регламентированные процедуры обновления моделей.
8) Какие практики способствуют устойчивой эксплуатации моделей?
Необходимо обеспечить автоматизированное развёртывание, мониторинг качества данных, drift и концептуальные сдвиги, регулярное обновление моделей и прозрачность для пользователей. Регистрация версий и согласование по бизнес-ценности помогают избежать непредвиденных сбоев и сохраняют доверие к прогнозам.
9) Как учитывать сезонность и внешние факторы в процессах разработки?
Необходимо встроить сезонные индикаторы и внешние переменные в признаки, использовать скользящие окна и текучие методы валидации, а также тестировать модели на периодах с сезонными пикогеном. В агрегациях и моделях учитываются праздничные даты, рекламные кампании и погодные условия, чтобы прогнозы отражали коммерческие и операционные реальности.
10) Как балансировать гибкость и контроль в рамках hybride-подхода?
Баланс достигается через четко прописанные регламенты, регистры экспериментов и моделей, а также четкие критерии готовности к внедрению. Agile обеспечивает адаптивность и скорость, DevOps - воспроизводимость и надёжность, CRISP-DM - структурированность и связь с бизнес-целями. Такой подход позволяет быстро реагировать на изменения спроса без потери управляемости и контроля качества.
Продолжайте развивать методологическую основу вашего проекта, сочетая структурированность CRISP-DM с адаптивностью Agile и надёжностью DevOps для ML. Ваша цель - не только точный прогноз, но и устойчивый, управляемый процесс, который приносит ощутимую бизнес-ценность и способен к масштабированию в условиях динамичного рынка.
Если ваша компания планирует внедрение продвинутой аналитики или систем прогнозирования на базе AI, важно выстроить правильную архитектуру данных и платформу для аналитики.
Узнайте, как реализовать искусственный интеллект для бизнеса — от стратегии до внедрения: от подготовки данных и архитектуры AI-платформы до разработки решений прогнозирования, AI-ассистентов и интеллектуальных систем, интегрированных в бизнес-процессы компании.


