

Архитектура сервисов AI для бизнес-функций: рекомендации, прогнозы, автоматизация
Развитие цифровой трансформации требует не только создания моделей, но и устойчивой архитектуры сервисов, которая обеспечивает управляемый поток данных, воспроизводимые результаты и предсказуемую эксплуатацию. В рамках данной главы рассматриваются принципы проектирования и реализации архитектуры сервисов AI для ключевых бизнес-функций: маркетинга и продаж, финансового планирования, операционного управления и клиентского сервиса. Цель - перевести пилотные кейсы в промышленное использование с учётом требований к надёжности, масштабируемости, безопасности и управляемости.
Эффективная архитектура сервисов AI связывает три слоя: данные и признаки, модели и сервисы, а также управляемость и интеграции с существующими системами. В условиях большой корпоративной сложности критическими становятся вопросы повторяемости экспериментов, контроля версий признаков и моделей, мониторинга производительности на уровне бизнес-результатов и соответствия регуляторным требованиям. В этой главе приводятся архитектурные принципы, паттерны интеграции, а также практические ориентиры по реализации и эксплуатации инновационных сервисов AI в крупной организации.
Краткое содержание главы
- Архитектурная рамка сервисов AI: слои, компоненты и взаимодействия.
- Протоколы интеграции, управление данными и контракты версий.
- Архитектурные паттерны для продвинутой аналитики и производственных сервисов.
- Путь от пилота к промышленному использованию: внедрение, эксплуатация и риски.
Архитектурная рамка сервисов AI для бизнес-функций
Архитектура сервисов AI строится вокруг четырех основных центров: ingestion и подготовка данных, хранение и управление признаками, модельный слой и сервисы инференса, а также оркестрация, мониторинг и безопасность. Каждому бизнес-слою соответствуют требования к скорости реакции, задержкам, надёжности и управляемости.
-
Данные и ввод. Источники данных охватывают внутренние источники (ERP, CRM, SCM, финансовые системы, корпоративные хранилища) и внешние потоки (соцсети, рыночные данные, партнерские данные). Важно обеспечить единый контекст и согласованность метрик во всём конвейере. Для поддержки реального времени и пакетной обработки применяются гибридные режимы: онлайн-поступление событий для оперативных решений и пакетная переработка для долгосрочных прогнозов и ретроспективного анализа.
-
Слой признаков (Feature Store). Признаки - это повторно используемые элементы данных, превращённые в формы, пригодные для моделирования. Feature Store обеспечивает централизованное хранение, версионирование, доступ через единый контракт и возможность мониторинга качества признаков. Для бизнес-процессов критично сохранить воспроизводимость операций: каждый признак имеет источник, временную метку, условия обновления и ограничения по доступу.
-
Модельный слой и реестр моделей. Реестр моделей хранит версии алгоритмов, метрики, зависимости, условия деплоя и роли доступа. В промышленной эксплуатации требуется поддержка воспроизводимости, управляемых наборов тестирования и отката к безопасной версии.
-
Инференс и оркестрация. Сервисы инференса expose API для потребителей и обеспечивают низкую задержку, масштабируемость и устойчивость к перегрузкам. Оркестрация конвейеров обеспечивает автоматическую последовательность шагов: валидацию данных, очистку, вычисление признаков, подачу на модель, расчёт бизнес-метрик и возврат решения пользователю или дочерним системам.
-
Наблюдаемость, безопасность и управление. Наблюдаемость включает трассировку данных, метрики качества моделей, мониторинг задержек и ошибок. Безопасность обеспечивает доступ на основе ролей, шифрование данных в покое и в передаче, защиту от утечек и соответствие регуляторным требованиям. Управление включает версионирование, аудит, документирование и процедуры управления изменениями.
# Пример минимального YAML для разворачивания сервиса инференса в Kubernetes
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ai-inference-service
spec:
  replicas: 2
  selector:
    matchLabels:
      app: ai-inference
  template:
    metadata:
      labels:
        app: ai-inference
    spec:
      containers:
      - name: inference
        image: registry.example.com/ai/inference:1.0.0
        ports:
        - containerPort: 8080
        env:
        - name: MODEL_VERSION
          value: "v1.0.0"
        resources:
          limits:
            cpu: "1"
            memory: "2Gi"
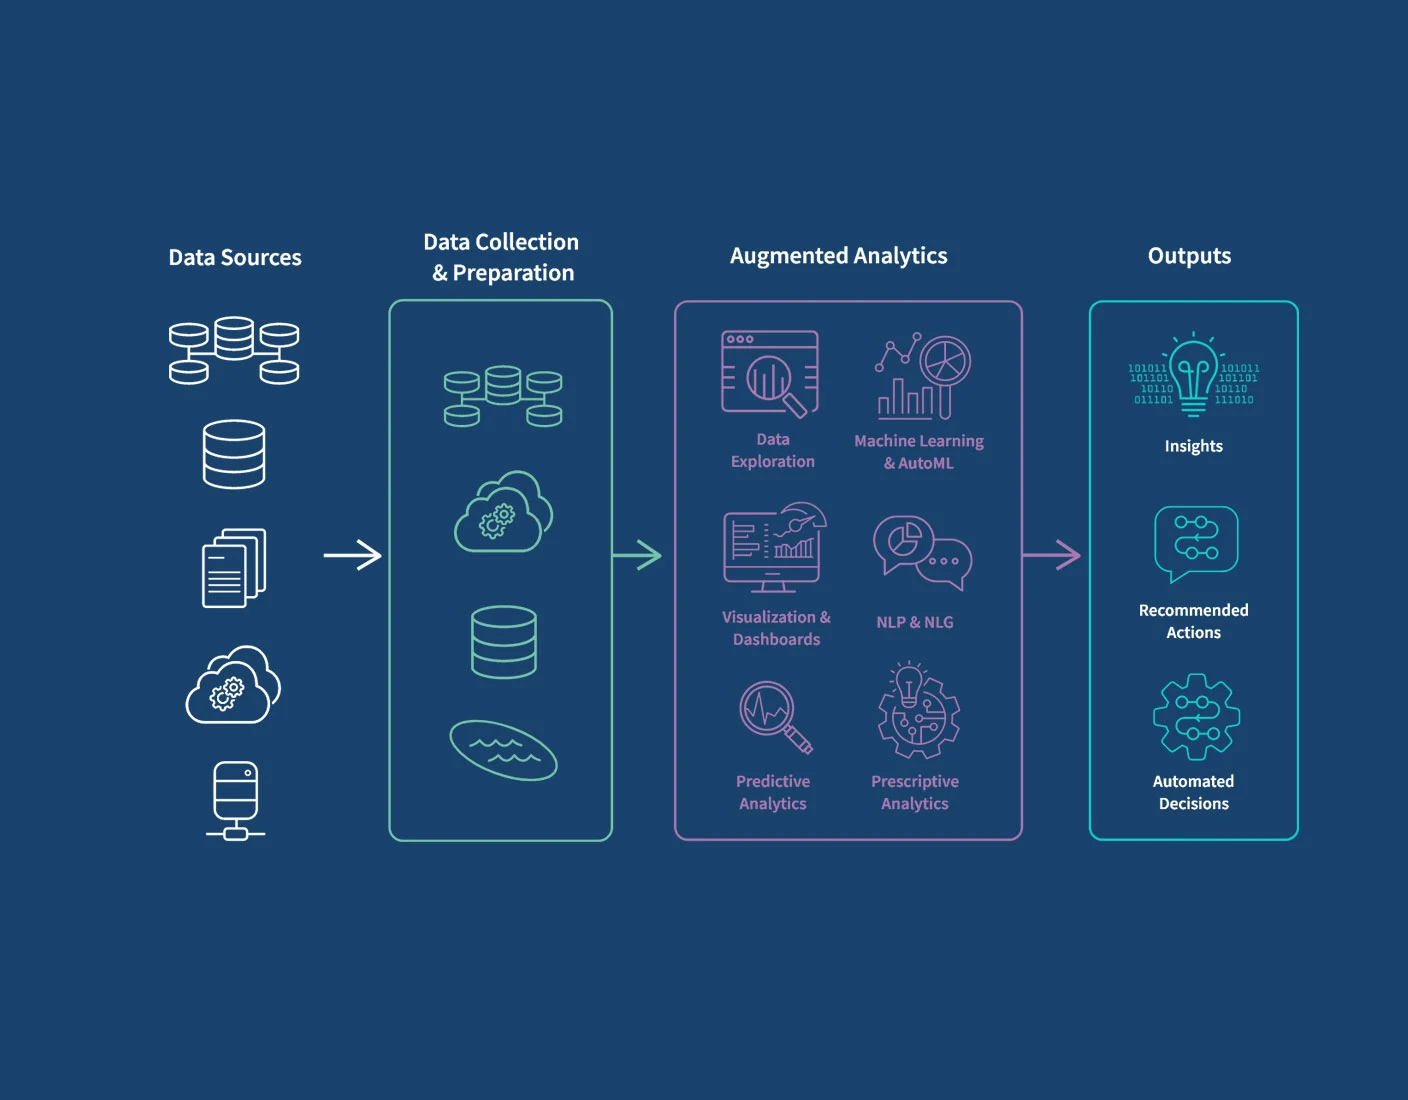
Компоненты архитектуры и их роли
- Данные и входные источники: обеспечение целостности и согласованности данных, стандартизация форматов, создание единого контекста для бизнес-решений.
- Признаки и Feature Store: сохранение повторно используемых признаков, контроль зависимостей и версий, поддержка онлайн- и оффлайн-режимов.
- Модельный реестр: каталог версий моделей, атрибуты качества, условия деплоя, история изменений.
- Сервисы инференса: быстрый и устойчивый доступ к прогнозам, поддержка горизонтального масштабирования и A/B-тестирования.
- Оркестрация и конвейеры: планирование, управление зависимостями и повторяемостью процессов подготовки данных, обучения и инференса.
- Наблюдаемость и мониторинг: сбор метрик качества моделей (ROC-AUC, precision@k, drift), задержки, доступность сервисов, алертинг.
- Безопасность и соответствие: контроль доступа, аудит, защита данных, управление персональными данными, приватность и соответствие регламентам.
- Управление изменениями: процессы ревью, тестирования и инфраструктурные политики, чтобы минимизировать риск перехода в промышленную эксплуатацию.
Протоколы интеграции, управление данными и контракты версий
Интеграции между компонентами должны быть основаны на устойчивых контрактах данных и протоколах обмена. В технологическом плане это означает:
- API-интерфейсы для сервисов инференса и конвейеров данных, где каждый вызов прозрачен и трассируем. Приоритет отдаётся контрактам REST или gRPC с явной спецификой входных и выходных полей, а также версиями API.
- Событийная архитектура для потоков данных. Использование брокеров сообщений (Kafka, NATS) обеспечивает асинхронность, упрощает масштабирование и повторную обработку.
- Форматы и схема данных. Форматы JSON или Avro/Protobuf применяются с регистрацией схем (Schema Registry) для поддержания совместимости и версий.
- Контроль версий признаков и моделей. Каждый признак и каждая модель получают уникальный идентификатор и метаданные, позволяющие воспроизводимость экспериментов и откат.
- Линейность данных и трассировка. Логирование источников данных, персистентность вычислений и ретроспекция значений в каждом шаге пайплайна клиентам и аудиту.
- Безопасность и доступ. Политики доступа, шифрование, контроль соответствия. Гранулированные политики позволяют ограничивать доступ к данным и моделям по ролям и контексту.
Архитектурные паттерны для продвинутой аналитики
- Feature store-driven architecture. Центральное место занимает признак как повторно используемый артефакт. Это снижает дублирование вычислений, ускоряет запуск моделей и упрощает переносимость решений между проектами.
- Model-as-a-service vs embedded inference. В промышленной среде часто применяется model-as-a-service с централизованной инфраструктурой инференса, позволяющей управлять доступом, версиями и мониторингом. В некоторых сценариях возможно внедрять локальные (embedded) инференс-агенты в бизнес-системах для снижения задержек и повышения приватности.
- Конвейеры данных и оркестрация. Инструменты типа Airflow, Dagster или Prefect обеспечивают оркестрацию подготовки данных, обучения и развёртывания моделей, поддерживают повторяемость и тестируемость.
- Архитектура гибридного облака и Edge. В зависимости от чувствительности данных и требований к задержке, инфраструктура может располагаться в частном облаке, общедоступном облаке и на периферии (edge). Такой подход требует согласованности контекстов данных и моделей.
- Управление качеством данных и drift-мониторинг. Постоянный контроль за качеством признаков и колебанием целевых метрик жизненно важен для устойчивого функционирования проектов AI в бизнесе.
- Границы ответственности и управление рисками. Чётко определены роли команд по данным, MLOps и бизнес-единиц, чтобы регулятивная и операционная ответственность была распределена прозрачно.
Безопасность, комплаенс и управляемость
Безопасность - не просто добавка, а интегральная часть всей архитектуры. В рамках сервисной архитектуры AI необходимы:
- Контролируемый доступ и аутентификация. Роли, политики минимального доступа, многофакторная аутентификация там, где требуется.
- Архитектура защиты данных. Шифрование в покое и в передаче, управление ключами, полное ведение журнала изменений.
- Управление данными и приватностью. Принципы минимизации данных, анонимизация и сегментация данных по контекстам использования.
- Модельный риск и мониторинг под надзором. Регулярные проверки качества моделей, тестирование на устойчивость к атакующим сценариям, аудит изменений.
- Соответствие регламентам. Хранение журналов, процедуры контроля доступа и ретенции данных в соответствии с корпоративной политикой и требованиями регуляторов.
Практическая реализация: интеграция компонентов и корпоративный стек
Корпоративная инфраструктура обычно объединяет несколько слоёв: дата-лейк-хаус, хранилище признаков, реестры моделей, инфраструктуру инференса и средства наблюдаемости. Типичный стек включает:
- Хранилище данных и слой подготовки: дата-лейк/хаб данных, поддерживающий как пакетную обработку, так и стриминг.
- Feature Store: централизованный сервис для хранения и версияции признаков, с быстрым доступом онлайн и оффлайн.
- Реестр моделей: управление версиями, окружения, зависимости и условия развёртывания.
- Инференс серверы и служба API: высокоэффективные сервисы с поддержкой горизонтального масштабирования, кэширования результатов и A/B-тестирования.
- Оркестрация и пайплайны: централизованное управление конвейерами обработки данных и обучения, с тестовыми стендами для регрессионного тестирования.
- Наблюдаемость и безопасность: сбор метрик, алертинг, трассировка запросов, аудит и управление доступом.
В промышленной практике решение не должно быть “псевдо-совместимым” набором инструментов: они должны работать как единая система с единым контролем версий и единым механизмом мониторинга. Пример типового разреза: Feat Store как общий источник признаков, MLflow или Kubeflow как реестр моделей, Triton Inference Server для инференса, Prometheus/Grafana для мониторинга, Kafka для потоковой передачи данных, Kubernetes как платформа развертывания и Dagster для оркестрации.
Пример архитектуры в кейсе: рекомендации и прогнозы для коммерческого контента
Рассмотрим кейс рекомендаций по контенту и персонализации на стороне маркетинга и продаж. Источники данных: поведение пользователей на сайте, CRM-данные, данные по рекламным кампаниям и данные внешних поставщиков контента. Цель - прогнозировать вероятность конверсии и предлагать персонализированные рекомендации по контенту.
-
Ингратация и обработка данных. Источники данных поступают в централизованный конвейер, где данные очищаются, нормализуются и обогащаются дополнительными признаками (например, сезонность, интересы, прошлые клики). Признаки сохраняются в Feature Store с версиями и ограничениями доступа.
-
Модели и прогнозы. Модели обучаются на исторических данных, оцениваются по бизнес-метрикам и регистрируются в реестре моделей. Выбор между моделью ранжирования и прогнозной моделью зависит от сценария: ранжирование под персональные подборки или прогноз вероятности конверсии.
-
Инференс и интеграция с каналами коммуникаций. Инференс-сервис предоставляет рекомендации через REST/gRPC API и интегрируется с системой снабжения контентом и платформой рассылок. Лидерство по времени отклика достигается за счёт оптимального размера признаков и выбора соответствующего инфраструктурного слоя (локального деплоймента для критичных каналов или облачного сервера для массовых кампаний).
-
Мониторинг и управление. Метрики включают точность, качество ранжирования, drift признаков и задержку отклика сервиса. В случае ухудшения качества автоматически инициируется тестовый прогон и, при необходимости, откатывается на более старую версию модели. Эти процессы документируются и поддаются аудиту.
-
Риски и управление ими. Управление качеством данных, прозрачность принятия решений и возможность объяснения соответствуют требованиям по управлению рисками. Важно не только достигать бизнес-результатов, но и иметь возможность объяснить прогнозы конечным пользователям и регуляторам.
# Пример простого сценария использования инференс-сервиса
1) В CRM по каждому клиенту поступает событие "просмотр контента".
2) Данные отправляются в Feature Store: текущие признаки клиента и контексты кампании.
3) API инференса получает прогноз конверсии и список рекомендуемых материалов.
4) Результат возвращается в канал коммуникаций и фиксируется в бизнес-метриках.
Развертывание и эксплуатация: ориентиры и шаги
- Определение целевых бизнес-целей. Прогнозируемые бизнес-метрики, допустимая задержка, требуемый объём трафика и требования к SLA.
- Разделение конвейера. Разграничение между подготовкой данных, обучением и инференсом; обеспечение повторяемости и тестирования на каждом этапе.
- Обеспечение воспроизводимости. Введение политики версионирования признаков и моделей, управляемые окружения (dev/stage/prod) и тестовые стенды.
- Построение CI/CD для ML. Включение этапов тестирования моделей на дубликатах набора данных, тестов на регрессии иQuality gates, а затем развёртывание в прод.
- Мониторинг и сигнализация. Набор метрик на уровне качества модели, задержек, потребления ресурсов и бизнес-метрик; настройка алертинга по границам.
- Управление рисками и изменениями. Процедуры ревью изменений, откатов, аудита и документирования.
- План перехода от пилота к промышленному применению. Построение дорожной карты, включая поэтапное масштабирование, лицензирование, управление данными и организационные изменения.
Риски и меры
- Риск деградации качества модели. Меры: drift-мониторинг, регулярное обновление датасетов, регламент тестирования.
- Риск утечки данных. Меры: минимизация объёма персональных данных, псевдонимизация, контроль доступа.
- Риск непрозрачности решений. Меры: объяснимые AI, аудит и документация бизнес-логики.
- Риск низкой доступности сервиса. Меры: отказоустойчивость, горизонтальное масштабирование, механизмы повторной попытки.
Key takeaways
- Архитектура сервисов AI строится вокруг данных, признаков, моделей и управляющих сервисов, обеспечивая воспроизводимость, масштабируемость и безопасность.
- Контракты данных, версии признаков и версии моделей являются основой управляемости и переносимости решений между проектами.
- Применение паттернов feature store-driven architecture и централизованного инференса обеспечивает устойчивость к изменениям бизнес-сценариев и ускоряет внедрение.
- Интеграция через гибридные протоколы API и событийную архитектуру позволяет сочетать оперативность и полноту анализа.
- Управление безопасностью, приватностью и соответствием регламентам критично на всех стадиях цикла разработки и эксплуатации.
- Переход от пилота к промышленному применению требует четко выстроенной дорожной карты, зрелого MLOps-процесса и постоянного мониторинга бизнес-эффективности.
- Эффективная архитектура AI должна быть тесно связана с бизнес-целями и корпоративной стратегией цифровой трансформации.
FAQ
1) Что главное при переходе от пилота к промышленному использованию сервисов AI?
Ответ: Устойчивость архитектуры, управляемость, воспроизводимость и способность масштабироваться. Важно иметь централизованный обработчик признаков и моделей, строгие контракты данных и детальный план миграции с регламентами тестирования и отката.
2) Как обеспечить повторяемость результатов в разных средах?
Ответ: Используйте единый Feature Store и Model Registry, фиксируйте зависимости окружения через контейнеризацию и инфраструктурные описания (IaC). Применяйте версионирование данных, признаков и моделей с привязкой к конкретным конвейерам и контекстам.
3) Какие протоколы выбрать для интеграции сервисов?
Ответ: REST или gRPC для синхронного взаимодействия, Kafka/NATS для асинхронной передачи событий, с явной версией API и схемами данных через Schema Registry. Важно обеспечить контрактность и контроль версий.
4) Как обеспечить безопасность и соответствие требованиям?
Ответ: Реализуйте контроль доступа по ролям, шифрование на входе и в покое, аудит и ретенцию журналов, минимизацию персональных данных и прозрачность моделей для регуляторов и бизнес-пользователей.
5) Какие паттерны особенно полезны в корпоративной среде?
Ответ: Feature store-driven архитектура, централизованный инференс, управляемые конвейеры и слабая связность между компонентами. Эти паттерны повышают переносимость решений, ускоряют внедрение и улучшают управляемость.
6) Что считается критическим индикатором успешности промышленного внедрения?
Ответ: Плавное масштабирование, соответствие SLA по latency, устойчивость к сбоям, и рост бизнес-метрик (конверсия, ROI, качество сервиса). Мониторинг drift и внимательное отношение к качеству данных - ключевые элементы.
7) Как балансировать между локальным и облачным инференсом?
Ответ: Оцените требования к задержкам, приватности и соответствию. Для критичных к задержке процессов целесообразен edge/локальный инференс, для массовых сценариев - централизованный инференс в облаке с поддержкой кэширования и A/B-тестирования.
8) Какие примеры open-source решений уместны в рамках архитектуры?
Ответ: Для функционального стека показательны Feast (Feature Store) и MLflow/Kubeflow (модуль управления моделями). Они позволяют ускорить внедрение и обеспечить совместимость между проектами, но выбор должен зависеть от требований устойчивости, поддержки и интеграций с существующим стеком.
9) Какорганизовать взаимодействие между бизнес-единицами и командами AI?
Ответ: Вводите совместную форму управления продуктом AI: определение бизнес-целей, критериев успеха, расписания выпусков и механизма обратной связи. Важно обеспечить прозрачность и общую видимость бизнес-главных метрик.
10) Какие шаги предпринять для своевременного масштабирования?
Ответ: Начинайте с малого, вопросите бизнес-метрики и проводите экспресс-обучение и тестирование. Постепенно масштабируйте инфраструктуру, внедряйте конвейеры и автоматизацию тестирования, и поддерживайте гибкую архитектуру для адаптации к новым данным и сценариям.
Чтобы искусственный интеллект приносил реальную бизнес-ценность, необходимо выстроить не только модели, но и архитектуру данных, процессы управления и платформу для масштабирования AI-инициатив.
Узнайте, как внедрить искусственный интеллект для бизнеса - от стратегии до внедрения: от оценки потенциала AI и подготовки данных до разработки AI-ассистентов, корпоративных AI-агентов и решений на базе генеративного AI, интегрированных в ключевые процессы компании.


