

Введение в long-term storage: ключевые принципы Thanos, Cortex, Mimir
Мониторинг больших платформ требует не только оперативных показателей и гибких дашбордов, но и устойчивого долгосрочного хранилища удаленных данных. Long-term storage (LTS) обеспечивает хранение исторических метрик на продолжительные периоды времени, поддерживает быструю агрегацию и эффективный доступ к данным из разных кластеров Prometheus, а также обеспечивает отказоустойчивость и экономическую обоснованность эксплуатации. В этой главе рассматриваются ключевые принципы LTS, архитектура трёх ведущих решений - Thanos, Cortex и Mimir - их сравнительный профиль и практические сценарии внедрения на примерах крупных инфраструктур мониторинга.
Первое понимание принципов LTS формирует базу для последующей инженерии мониторинга больших платформ: какие данные сохраняются, как организовывается их доступ, какие операции выполняются на уровне хранения и какие компромиссы делаются ради масштабирования и доступности. В рамках курса мы уделяем внимание не только архитектурам, но и темпоральной стороне данных: какова частота агрегации, как выполняется downsampling, какие политики хранения применяются к архивным блокам, как минимизировать задержки при запросах к историческим данным и как обеспечить согласованность данных при репликациях.
Кратко о содержании главы:
- Определение целей и ограничений long-term storage для Prometheus, включая архитектурные принципы и требования к объектному хранилищу.
- Архитектура Thanos: как организуется доступ к данным, агрегация между кластерами и долговременный хранитель блоков.
- Архитектура Cortex: принципы распределённого хранения и мультиоркестрации по арендаторам, поток Writes/Reads и цепочка данных.
- Архитектура Mimir: эволюция Cortex, новые паттерны масштабирования и операционная координация в межкластерной среде.
- Практические подходы к выбору решения, миграциям, мониторингу и операционной эксплуатации в условиях больших платформ.
Далее следует подробное изложение темы, структурированное по концепциям и практикам реализации.
Основные принципы long-term хранения Prometheus
Long-term storage базируется на идее отделения горячих данных Prometheus (локальное хранение, ускоренная выборка и оперативная аналитика) от холодных данных, которые хранятся в объектном хранилище и доступны через долгосрочные интерфейсы. В таком подходе важны несколько взаимосвязанных аспектов:
- Архитектурная разделенность: TSDB-данные, индекс и метаданные записываются в блоки, которые затем выгружаются в долговременное хранилище. Это позволяет переносить физическую автономность данных без потери логики запроса.
- Объектное хранилище как единая почва: S3, GCS, Azure Blob Storage и аналоги образуют единый слой хранения, на котором строится репликация, хранение и версияция блоков. Важно обеспечить совместимость и режимы защиты данных (версионирование, шифрование, контроль доступа).
- Модели чтения и агрегации: поддерживается глобальный взгляд на данные из разных кластеров. Запросы к историческим данным допускают линейную и параллельную агрегацию, что критично для сценариев с много региональными кластерами.
- Механизмы консистентности и дедупликации: в многокластерных развертываниях данные могут дублироваться. Эффективная дедупликация достигается через согласованные идентификаторы и лейблы источников, а также на уровне маршрутизации запросов.
- Downsampling и компрессия: для длительного хранения применяются политики снижения разрешения (downsampling), чтобы снизить объем данных и ускорить запросы к данным за многие годы. Этими подходами управляет механизм компакшина/агрегирования блоков.
- Мониторинг самого хранилища: критично отслеживать пропускную способность, задержки записи/чтения, долю ошибок в доступе к объектному хранилищу, а также факт наличия устаревших блоков и их очистку по политике хранения.
- Безопасность и доступ: контроль доступа к данным, шифрование в покое и в передаче, управление ключами и аудит операций чтения/записи в долгосрочное хранилище.
Эти принципы применимы как к нативной архитектуре Prometheus, так и к решениям, расширяющим функциональность Prometheus, таким как Thanos, Cortex и Mimir. Везде ключевыми остаются вопросы масштабируемости, устойчивости к сбоям и управляемости ресурсов, включая затраты на хранение и сетевой трафик.
Thanos: единая точка доступа к long-term storage
Thanos строит единый слой долговременного хранения поверх коллекций Prometheus путем добавления к нативному стеку Prometheus дополнительных компонентов. Его цель - обеспечить глобальный взгляд на данные, кросс-кластерную доступность и устойчивость к сбоям за счет использования внешнего объектного хранилища.
Архитектура Thanos базируется на нескольких взаимосвязанных компонентах:
- Sidecar: агент, который присоединяется к каждому экземпляру Prometheus и публикует локальные блоки в объектное хранилище, а также обеспечивает кэширование и индексацию данных для последующего доступа.
- Store Gateway: сервис чтения исторических данных из блока хранения. Он позволяет Querier’у получать данные за длительные периоды без необходимости сохранять копии локально в Prometheus.
- Querier: агрегатор запросов, который может одновременно обращаться к данным из нескольких Prometheus-источников и из долговременного хранилища. Он обеспечивает консолидацию результатов и поддержку многокластерной агрегации.
- Compactor: служба, отвечающая за создание более крупных и более холодных блоков из существующих, включая downsampling. Это позволяет снизить стоимость хранения и ускорить запросы к архивным данным.
- Ruler: компонент для централизованного управления политиками предупреждений и политики аудитирования по всему лезвию данных.
- Object storage: S3-compatible хранилище, GCS или аналоги, где физически размещаются блоки Prometheus.
Ключевые концепты, которые обеспечивает Thanos:
- Глобальная видимость данных: через Querier можно выполнять запросы, охватывающие данные из разных кластеров Prometheus, без необходимости держать все данные локально в каждом экземпляре.
- Дедупликация на уровне запроса: Thanos способен устранять дубликаты, которые возникают, когда один набор данных присутствует в нескольких копиях или кластерах с одинаковыми данными. Это достигается за счет использования внешних лейблов и согласованных идентификаторов источников.
- Эволюция блоков и downsampling: Compactor генерирует новые, более крупные блоки, которые содержат агрегированные версии исходных данных. Это оптимизирует хранение и ускоряет запросы к данным за длительные периоды.
- Инкрементальная загрузка: Sidecar обеспечивает постепенную выгрузку данных в объектное хранилище, минимизируя риск потери данных при сбоe Prometheus и позволяя быстро восстановить доступ к архиву.
- Эффективная интеграция с облачными хранилищами: Thanos широко известен своей поддержкой функций object storage, а также способом конфигурации и мониторинга, который минимизирует операционные риски в условиях ограниченной пропускной способности сети.
Практические аспекты внедрения Thanos:
- Выбор режима развертывания: валидная схема** - разворачивать Thanos как прослойку поверх существующих Prometheus инстансов, чтобы минимизировать воздействие на текущий мониторинг.
- Планирование хранения и расходов: определение политики ретенции, уровня компрессии, числа блоков и частоты компакции, исходя из реальных требований к доступности архива и бюджета.
- Мониторинг компонентов Thanos: настраивать метрики для Sidecar, Store Gateway, Querier, Compactor и Ruler; это обеспечивает раннее обнаружение узких мест и ошибок доступа к данным.
- Безопасность и доступ: обеспечение правильной аутентификации к объектному хранилищу, ограничение прав на чтение/запись и аудит операций.
- Миграционные сценарии: можно начинать с одной или нескольких гілок кластера, постепенно расширяя и тестируя консистентность результатов на реальных запросах.
Thanos особенно эффективен для сценариев с множеством региональных кластеров Prometheus, когда требуется единый глобальный дашборд и единое архивное хранилище. Он хорошо подходит для организаций, которым важна централизованная аналитика по всей экосистеме мониторинга и возможность безопасно хранить данные годами, сохраняя приемлемые эксплуатационные затраты.
Cortex: архитектура и принципы распределенного долгосрочного хранения
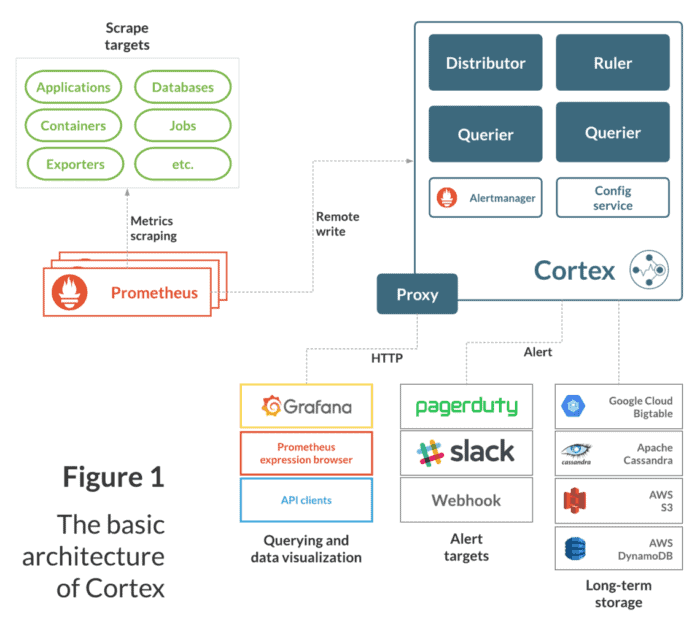
Cortex представляет иной подход к long-term storage, ориентированный на мультиарендность (multi-tenancy) и горизонтальное масштабирование. Архитектура Cortex строится вокруг микросервисной модели, которая разделяет функциональные роли по обработке записи, хранению и выборке данных.
Ключевые компоненты Cortex:
- Distributor: точка входа для прометеевых данных; принимает записи от клиентов и распределяет их по слоям хранения в зависимости от шардирования и арендатора.
- Ingester: держит в памяти часть временных данных перед записью в долговременное хранение; агрегирует и буферизирует записи, обеспечивая устойчивость к пиковым нагрузкам.
- Storage (Blocks): данные сохраняются в виде блоков в объектном хранилище и разбиваются по арендаторам; эти блоки формируют читаемые наборы данных для запросов.
- Querier: выполняет запросы, собирая данные из блоков и агрегируя их по арендаторам; поддерживает параллельную обработку и парадигму горизонтального масштабирования.
- Ruler: сервис управления правилами оповещений и хранением политик.
- Compactor (или Compact/Index): отвечает за создание новых, компактных блоков и поддерживает длительную эволюцию данных через downsampling и ретенцию.
- Index: обеспечивает быстрый доступ к данным по арендаторам и временным окнам.
Особенности Cortex, которые важно учитывать:
- Мультиарендность и изоляция данных: Cortex разделяет данные клиентов (тенанты) через явные метки и конфигурации, что упрощает управление доступом и масштабирование.
- Масштабирование записи и чтения: горизонтальное масштабирование достигается за счет шардинга по tenants и балансировки нагрузки между Distributor и Querier.
- Гибкие варианты хранения: Cortex поддерживает различные бекэнды хранения, включая локальные диски и внешние объектные хранилища; это обеспечивает гибкость в зависимости от бюджета и политики хранения.
- Расширяемость архитектуры: можно нарастить количество инжестеров, дистрибьюторов и кверьеров для достижения желаемых характеристик задержки и пропускной способности.
- Совместимость с Prometheus: Cortex поддерживает Prometheus API, что упрощает миграцию поэтапно и позволяет сохранять существующие методы мониторинга.
Практические аспекты внедрения Cortex:
- Архитектурные решения по разбиению по арендаторам: целесообразно заранее определить принципы разделения данных (по проектам, по окружениям, по зонам ответственности) и сопоставить их с требованиями к SLA и доступности.
- Политики хранения: выбор блока и стратегии компакции, чтобы обеспечить баланс между задержками чтения и затратами на хранение; в Cortex блоки часто формируются различными темпами в зависимости от времени и активности арендаторов.
- Миграции и переходные сценарии: Cortex поддерживает этапную миграцию существующих данных Prometheus в долговременное хранилище; рекомендуется тестировать миграции на стейдж-средах и постепенно расширять объемы.
- Мониторинг и оповещение: в Cortex критически важен мониторинг работы Distributor, Ingester, Querier и Compactor, включая задержки кэширования, пропускную способность и нагрузку на сети.
- Экономика эксплуатации: предпочтение Cortex часто отдается в сценариях с требованием мультиарендности и высокой гибкости масштаба за счет разноуровневого хранения и горизонтального разросения.
Cortex хорошо подходит для крупных организаций с разнообразными арендаторами и необходимостью строгих границ доступа к данным. Его архитектура обеспечивает высокий уровень масштабирования и изоляции, но требует более сложной операционной поддержи и координации между сервисами.
Mimir: современная эволюция Cortex и подход к глобальному long-term storage
Mimir представляет собой развитие идей Cortex, адаптированное под современные требования больших экосистем мониторинга и операционных центров. Хотя конкретная реализация может обновляться со временем, основные принципы Mimir включают:
- Расширенная мультиарендность: поддержка большого числа арендаторов с эффективной маршрутизацией запросов и масштабируемостью по tenant-профилям. Это достигается за счет более гибкого планирования запросов и оптимизации индексации.
- Централизованный контроль над данными: упрощение администрирования за счет единой координации политик хранения, обновления правил и согласованного управления версионированием блоков.
- Расширенная кэширование и индексация: внедрение продвинутых стратегий кэширования и индексов для ускорения запросов к историческим данным и улучшения пропускной способности по арендаторам.
- Более эффективная архитектура чтения: оптимизации путей чтения, включая разделение путей на быстрые и медленные, улучшение планирования запросов и распределение нагрузки.
- Совместимость с Prometheus API и удаленным чтением: сохранение совместимости с существующими инструментами Prometheus и упрощение миграций, а также интеграции с уже используемыми инструментами удаленного сбора данных.
- Улучшенная операционная поддержка: упор на наблюдаемость сервисов, упрощение обновлений, резервирования и DR-политик, а также повышение устойчивости к сетевым сбоям.
Преимущества Mimir по сравнению с чистым Cortex включают более упрощенную операционную модель и улучшенную масштабируемость в условиях глобальных развертываний. Однако внедрение требует тщательного планирования: миграционные стратегии, совместный мониторинг и согласование политик доступа между несколькими регионами и арендаторами.
Практические аспекты внедрения Mimir:
- Архитектурные решения: выбор целевой конфигурации для Distributor/Ingester/Querier и согласование стратегии репликации между регионами.
- Инструменты миграции: поэтапное перемещение данных и конфигураций, минимизация простоя и проверка консистентности запросов перед переводом трафика на новую архитектуру.
- Управление состоянием: обеспечение единообразной политики хранения, ликвидации устаревших данных и мониторинга индексов, чтобы не допускать деградации производительности.
- Оптимизация запросов и кэширования: настройка параметров планирования запросов, уровня кэшей и таймингов, чтобы обеспечить приемлемую задержку для больших наборов данных.
- Безопасность и соответствие: управление доступом к данным, аудит операций и требования к соответствию в многорегиональной среде.
Mimir служит эволюционной платформой для организаций, которым нужна единая, масштабируемая и управляемая инфраструктура долгосрочного хранения данных, объединяющая лучшие практики Cortex и надстройки для больших ландшафтов мониторинга.
Интеграция и эксплуатация long-term storage: паттерны, мониторинг и жизненный цикл
Выбор подхода к long-term storage зависит от масштаба, уровня мультиарендности и требований к задержкам при доступе к данным. Ниже приведены практические ориентиры по развёртыванию и эксплуатации, которые применимы как к Thanos, так и к Cortex и Mimir.
- Архитектурные паттерны внедрения: для локальных и региональных кластеров часто применяют Thanos в связке с несколькими Prometheus-инстансами; для крупных культурных платформ с высокой потребностью в мультиарендности - Cortex или Mimir. В случаях, когда требуется единый глобальный дашборд и упрощение жизненного цикла данных, Thanos выступает как связующее звено; для сложной мультиарендной среды с требованием детального контроля доступа - Cortex или Mimir.
- Хранение и доступ к данным: выбирают объектное хранилище с учетом доступности, стоимости и требований к задержкам. В большинстве сценариев применяется S3-совместимое хранилище или тот же GCS; критически важно обеспечить политики версии, шифрования и доступа на уровне bucket.
- Мониторинг всей цепи: необходимы метрики для каждого слоя - от Prometheus/Sidecar до Compactor, Querier и Store Gateway. Это позволяет обнаруживать задержки чтения, сбои записи в объектное хранилище, а также проблемные блоки и устаревшие данные.
- Управление данными и ретенцией: настройка политики ретенции и ступеней хранения. Глубокая интеграция между политиками хранения, downsampling и периодами сборки блоков снижает стоимость и поддерживает необходимую точность аналитики на нужной длительности.
- Безопасность и соответствие: реализуйте строгие политики доступа и аудит, особенно в субрегиональных или межрегиональных сценариях. Шифрование данных в покое и в передаче, ротация ключей и разделение ролей являются базовыми требованиями.
- Операционная устойчивость: внедрите DR-планы, резервное копирование и тестирование восстановления. Корреляцию с инцидентами необходимо связывать с конкретными сервисами (Sidecar, Querier, Compactor) и блоками данных.
- Миграционные сценарии: для существующих инсталляций Prometheus можно реализовать поэтапную миграцию на Thanos/Cortex/Mimir: начать со сбора данных в текущем кластере, постепенно добавлять долговременное хранение и проверять консистентность, прежде чем переводить трафик на новый слой.
Практические сценарии по выбору решения:
- Нужна единая глобальная видимость и простая операционная модель - Thanos чаще подходит как первый слой для расширенной доступности, репликации и свечивания истоков данных.
- Требуется сильная мультиарендная изоляция и масштабирование записей - Cortex или Mimir будет предпочтительнее, если необходим контроль доступа и гибкая маршрутизация по арендаторам.
- Необходимость эволюции текущей архитектуры Prometheus без радикальных изменений - можно начать с Thanos, а затем по мере роста рассмотреть переход к Cortex или Mimir для более глубокой мультиарендной поддержки.
Key takeaways
- Long-term storage для Prometheus объединяет горячие и холодные данные через архитектуры, основанные на блоках и объектном хранении, что позволяет масштабировать мониторинг и сохранять данные годами.
- Thanos обеспечивает глобальную видимость и централизованный доступ к данным, упрощает сборку исторических данных и снижает риск потери данных за счет Sidecar и Compactor, работающих с внешним хранилищем.
- Cortex фокусируется на мультиарендности и горизонтальном масштабировании, предоставляя изоляцию арендаторов и гибкость в выборе бекэнд-хранилищ, но требует более сложной операционной поддержки.
- Mimir развивает принципы Cortex, улучшая масштабируемость, индексацию и управляемость в условиях больших региональных и мультиарендных развертываний.
- Выбор решения зависит от требований к мультиарендности, скорости доступа к архиву, бюджета на хранение и готовности к операционной сложности. В большинстве крупных организаций разумна комбинация паттернов: Thanos для глобальной видимости и Cortex/Mimir как более автономные слои для арендаторов и специфических сценариев доступа.
- Важной частью является планирование миграции и постепенная внедрительная стратегия: начать с безопасной интеграции к существующим инстансам Prometheus, затем расширять слой долговременного хранения, мониторить и валидировать консистентность результатов.
- Обеспечение высокой доступности и отказоустойчивости требует не только архитектурной настройки, но и регламентов эксплуатации, включая мониторинг, политики ретенции, резервное копирование и тестирование восстановления.
FAQ
- Что такое long-term storage в контексте Prometheus и зачем он нужен?
Long-term storage - это слой долговременного хранения исторических данных метрик, который отделяет архив от горячего массива Prometheus. Он обеспечивает сохранность данных на месяцы и годы, поддерживает глобальный доступ к архиву, а также позволяет снизить стоимость и нагрузку на отдельные кластеры Prometheus при высоких объемах метрик и потребности в ретенции. Такой подход необходим для крупных систем, где задержки при доступе к архивным данным и эксплуатационные риски критичны для бизнес-аналитики и инцидент-менеджмента.
- Какие главные различия между Thanos, Cortex и Mimir?
Thanos ориентирован на единый глобальный слой доступа к данным и упрощение архитектуры, добавляя Sidecar, Querier, Store Gateway и Compactor поверх существующих Prometheus. Cortex - это мультиарендная, горизонтально масштабируемая архитектура с распределением по Distributor, Ingester, Querier и другим компонентам, хорошо подходящая для больших организаций с множеством арендаторов. Mimir - эволюционная ветка Cortex, направленная на улучшение масштабируемости, индексации и операционной управляемости в глобальных развертываниях, сочетая принципы Cortex с улучшенной координацией и мониторингом.
- Какой подход выбрать для своей организации?
Выбор зависит от масштаба, числа арендаторов, требований к глобальной видимости и доступности. Thanos хорошо подходит, когда приоритетом является единая глобальная панель и упрощенная интеграция с текущим Prometheus. Cortex и Mimir - предпочтительны в сценариях с высокой мультиарендностью и необходимостью изоляции данных между арендаторами. В реальных условиях часто применяется гибридный подход: Thanos как общий слой доступа, а Cortex/Mimir - для специфических арендаторов, где нужна более детализированная политика доступа и распределение нагрузки.
- Какие требования к хранению данных учитываются при выборе объекта-складирования?
Ключевые параметры: доступность, латентность для запросов, стоимость хранения и передачи данных, совместимость с S3/GCS, поддержка версий, шифрование и аудит. Важно обеспечить устойчивость к сбоям и возможность быстрого восстановления данных из резервных копий. Также следует оценивать возможность масштаба по регионам и возможность резервирования блоков для DR-планов.
- Какие механизмы дедупликации применяются в многокластерной архитектуре?
Дедупликация реализуется через маршрутизацию запросов к источникам данных с идентификацией источника (external labels). На уровне запроса формируется консолидированная выдача, где дубликаты по тембрам с одинаковыми временными метками устраняются. Это позволяет эффективно объединять данные из разных клонов и кластеров без дублирования результата.
- Каковы принципы стратегий downsampling и компрессии в LTS?
Downsampling выполняется через компакторы, которые создают более крупные блоки с сохранением агрегации и таймстемпов. Это уменьшает объем архива и ускоряет запросы к данным за длительные периоды. Выбор параметров downsampling зависит от частоты сбора метрик, требований к точности аналитики и лимитов на хранение.
- Какие проблемы возникают при миграции с Cortex на Mimir или Thanos, и как их минимизировать?
Основные риски - несовместимости в конфигурациях, различия в маршрутизации данных и нюансы политик арендаторов. Минимизировать можно через поэтапную миграцию: начать с тестовой среды, реализовать параллельную сборку данных через новый слой, провести согласование индексов и тестирование запросов, затем постепенно перенести трафик на новый компонент и деактивировать старые сервисы.
- Какие операционные практики критичны для стабильной эксплуатации LTS?
Необходимо обеспечить мониторинг всех слоев: Prometheus, Thanos Cortex или Mimir, блоки в объектном хранилище, очереди и пропускная способность. Вводите политики резервирования, DR-планы, регулярное тестирование восстановления, аудит доступа и обновлений копий блоков. Также важно поддерживать документацию по настройкам, чтобы команда могла быстро реагировать на инциденты.
- Какую роль играет удаленный сбор и удаленный доступ к данным в LTS?
Удаленный сбор и удаленный доступ к данным позволяют объединить данные из множества регионов и систем мониторинга. Это является основой для единого дашборда и консолидации аналитики. Однако такие подходы требуют тщательного управления задержками, политиками доступа и согласованностью данных между узлами.
- Какие типичные тревоги и признаки проблем встречаются в LTS?
Частые проблемы включают задержки в загрузке блоков, ошибки доступа к объектному хранилищу, несоответствия в данных между кластерами, чрезмерную нагрузку на компактор и ограничения сетевых каналов. Важно иметь наблюдение по каждому компоненту, систематизировать алерты и проводить периодические проверки целостности данных.


