

Доменные границы данных: как определить контексты и согласовать интерфейсы
Децентрализованная архитектура данных Data Mesh предполагает нахождение баланса между автономией команд и необходимостью взаимного использования данных. Главным элементом этой балансировки выступают доменные границы и сопутствующие им интерфейсы - контракты между контекстами, которые позволяют данным свободно перемещаться в рамках согласованной структуры волокон данных. В этой главе разобраны принципы определения контекстов, способы согласования интерфейсов и практические подходы к внедрению контрактной культуры в рамках self-service платформы.
В современных организациях границы доменов данных определяют не только технические, но и бизнес-аспекты: ответственность за данные, ожидания по качеству, доступность и скорость поставки данных под конкретные цели. Правильно выведенные границы позволяют минимизировать зависимость между командами, повысить скорость разработки и обеспечить масштабируемость данных как продукта.
- В основе Data Mesh лежит идея контекстов как доменных границ, где данные управляются и разворачиваются как data products.
- Интерфейсы между контекстами оформляются как контракты: форматы данных, схема, версии, правила соответствия и способы эволюции.
- Управление контрактами требует процессов, инструментов и ролей, нацеленных на устойчивое развитие архитектуры и минимизацию технологических трений.
- Self-service платформа должна поддерживать автономию команд и при этом предоставлять стандарты, каталоги и автоматизацию для согласования контрактов.
Контексты и границы: концептуальная основа
Контекст в Data Mesh - это бизнес-сценарий, функциональная зона ответственности и связанные с ним данные, которым управляет конкретная команда. Контекст не ограничивается конкретной таблицей или API: он охватывает данные, их семантику, качество, нормативные требования, процессы обновления и способы эксплуатации.
Что считать контекстом
Контекст формируется вокруг бизнес-цели или функции, которые требуют устойчивой поставки данных. Примеры: контекст «Пользовательские транзакции», «Маркетинговая аналитика по сегментам», «Операционные данные склада» и т. д. В идеале контекст совпадает с доменом бизнес-ответственности: команда, владеющая бизнес-единицей, отвечает и за данные, и за их качество.
В рамках этого определения полезно рассмотреть следующие аспекты:
- Владение данными - кто несет ответственность за источник, качество и доступность данных;
- Семантика - какие бизнес-значения несут данные, какие показатели они поддерживают;
- Правила обработки - какие трансформации разрешены, какова частота обновления и как обрабатываются ошибки;
- Экосистема потребителей - кто использует данные, какие сценарии потребления поддерживаются.
Границы как инженерная и управленческая концепции
Границы между контекстами следует рассматривать и как архитектурные, и как управленческие: они должны позволять независимую разработку и развёртывание data products, сохраняя при этом совместимость на уровне интерфейсов. В инженерном плане границы выражаются через:
- контрактные сигнатуры данных: набор полей, типы, валидаторы;
- версии схем: как происходят эволюции без нарушения потребителей;
- интерфейсы доступа: API, очереди событий, файлопотоки;
- политики качества: набор SLA по задержкам, полноте, точности и согласованности.
Управленческий аспект заключается в определении ролей и процессов: кто отвечает за контракт, кто отвечает за версионирование, как проходят изменения и какие метрики качества данных являются пороговыми для продвижения изменений в продакшн.
Интерфейсы как контракты: архитектура и спецификации
Интерфейсы между доменными контекстами должны оформлять реальную грань совместного использования данных. Контракт - это не только формат данных, но и ожидаемая семантика, требования к качеству и правила эволюции. Контракты улучшают взаимопонимание между командами и снижают риски совместной эксплуатации.
Форматы контрактов и схем
Контракты обычно описывают три уровня:
- сигнатура данных: набор полей, их названия и типы, обязательность, дефолты;
- сигнатура поведения: ожидаемые событийные или потоковые сценарии, порядки обновления и отслеживание изменений;
- сигнатура качества: пороги полноты, точности, задержки, согласованности.
Для формализации контрактов применяются общепринятые форматы:
- схемы данных в формате JSON Schema, Apache Avro или Protobuf - в зависимости от технологии хранения и обмена;
- спецификации API или событийных контрактов - через описания REST/GraphQL endpoints или через события в шине данных (например, Kafka topic schemas).
Важно поддерживать единый реестр контрактов и версионирование схем. Это позволяет потребителям ориентироваться на конкретные версии, а поставщикам - планировать эволюцию без разрыва совместимости. В качестве примера инструментов можно упомянуть открытые каталоги схем и контрактов, которые интегрируют данные и их контрактную информацию; для обмена схемами применяются, например, сетевые репозитории схем или сервисы версионирования контрактов.
Версионирование и совместимость
Без контроля версий контракты быстро расходятся. Общие подходы:
- контрактная семантика - каждый контракт имеет идентификатор версии, дата выпуска и набор изменений;
- совместимость - строгая/мягкая совместимость: эволюции допускаются, но поддерживаются правила обратной совместимости; моменты нарушения совместимости - этапы миграции;
- миграция схем - наличие миграционных путей: трансформации, дефолты, устаревшие поля помечаются и документируются.
Хорошая практика - внедрение схемного реестра (schema registry) или каталога контрактов, который обеспечивает:
- хранение версий схем;
- валидацию данных на вход и выход;
- уведомления потребителей об изменении контракта;
- автоматическую сборку тестов на соответствие контракту.
В индустриальных реалиях широко применяется концепция схем-менеджмента: каждое изменение схемы сопровождается анонсом, новой версией и набором миграционных шагов. Это снижает риски переходного периода и поддерживает устойчивость потребителей данных.
Валидация контрактов в потоках и пакетах
Контракты должны проверяться на всём пути данных: от источника к потребителю. Включение автоматизированной валидации снижает вероятность ошибок и упрощает управление изменениями. Рекомендации:
- верифицировать данные на входе источника и на выходе потребителя по определённой схеме;
- внедрить CI-пайплайны, которые проверяют соответствие данных версии контракту;
- использовать тестовые наборы данных, которые валидируют все поля и семантику.
Примеры инструментов, применимых для контроля контрактов, включают системы управления схемами и политики валидации, а также сервисы автоматизированной проверки соответствия контрактам. Для случаев, когда организация применяет открытые форматы данных, использование JSON Schema или Protocol Buffers упрощает интеграцию и валидацию на конвейере данных.
Методика выделения доменных контекстов и согласования интерфейсов
Построение доменных границ - это не разовое мероприятие, а последовательный процесс развития архитектуры. Он включает диагностику текущего состояния, формирование целевых контекстов, определение контрактов и настройку процессов эволюции.
Шаг 1. Диагностика текущей архитектуры и бизнес-целей
Начинается с картирования существующих источников данных, потребителей и бизнес-целей. Важно определить:
- где данные являются критическими для бизнеса;
- какие сценарии требуют быстрого доступа и ориентации на данные как продукт;
- какие данные проходят через централизованные сервисы и какие уже находятся в рамках самостоятельной децентрализованной обработки.
На этом этапе полезно создать карту потоков данных, обозначив источники, точки трансформации и потребителей. Это позволяет увидеть узкие места, дублирование данных и потенциальные конфликты согласования.
Шаг 2. Выделение бизнес-границ и владения данными
Контекст стоит определить через бизнес-домен: кто владеет данными, какие политики соответствуют данным, какие требования к качеству требуются для конкретных сценариев. Роли в этом процессе:
- владельцы домена данных, ответственные за качество и доступность;
- аналитики и потребители, которым нужны данные для решений;
- инженеры данных, реализующие поставку данных в рамках контекста.
Цель - сопоставить бизнес-дедлайны с ответственной командой и закрепить это в виде документированной договоренности об ответственности.
Шаг 3. Определение контрактов и интерфейсов
После определения контекстов следует формализовать контракты. На этом шаге нужно:
- выбрать формат контрактов (сигнатуры полей, версии, схемы, валидаторы);
- определить каналы обмена данными (потоки, API, события);
- зафиксировать требования к качеству и SLA;
- определить правила эволюции - как добавлять поля, как обрабатывать изменение форматов.
Рекомендуется вести единый каталог контрактов, который связывает каждую схему с контекстом и версией. Такой каталог нужен как для потребителей контрактов, так и для команд, ответственных за их эволюцию.
Шаг 4. Согласование и тестирование контрактов
Параллельно с формализацией контрактов следует внедрить практику тестирования совместимости между контекстами:
- автоматические проверки на соответствие новых данных текущим контрактам;
- регрессионные тесты на потребителях для проверки корректной обработки изменений;
- пилоты изменений на ограниченных наборах потребителей перед масштабированием.
В этом контексте уместно применение подходов дробного развёртывания (canary releases) и эволюции контрактов с чёткими индикаторами перехода между версиями.
Шаг 5. Инструменты, процессы и управление
Необходима поддержка инструментами и процессами, которые обеспечивают:
- каталог контрактов и версий;
- валидацию и тестирование контрактов в CI/CD;
- мониторинг соответствия контрактам в продакшене;
- алерты при нарушении требований контракта.
С точки зрения инструментов можно использовать:
- Schema Registry и связанные службы для валидации и управления схемами данных;
- каталоги контрактов и метаданных, которые агрегируют информацию о контекстах, версиях и зависимости;
- системы мониторинга качества данных и их соответствия контрактам.
В качестве примера технологий можно упомянуть открытые решения по управлению схемами и контрактами, а также сервисы интеграции данных, которые поддерживают версионирование и автоматическое тестирование. При этом в рамках российского контекста целесообразно держать фокус на открытых форматах и устойчивой интеграции с локальными инструментами ведомственных инициатив там, где это возможно.
Управление контекстами в self-service платформе
Self-service платформа должна не только предоставлять данные в рамках контрактов, но и поддерживать автономию команд, облегчать обмен и ускорять внедрение data products. Ключевые принципы:
- каталоги контекстов и контрактов доступны потребителям через единый интерфейс;
- автоматизированные механизмы верификации соответствия контрактау и политик безопасности;
- шаблоны и инструменты для быстрого создания новых data products в рамках заданного контекста;
- управление качеством данных как встроенная часть процесса доставки данных.
Архитектурная подсистема согласования
Архитектурная подсистема должна обеспечивать:
- связь между контекстами и их контрактами;
- обработку эволюции контрактов с минимальными прерываниями;
- отслеживание зависимости между контекстами и потребителями.
Такая подсистема обеспечивает прозрачность для бизнес-пользователей и разработчиков, позволяет планировать изменения в данных и оперативно решать возникающие проблемы. Важным элементом становится наличие инструментов для автоматического обнаружения несовпадений в контрактной совместимости и уведомления заинтересованных сторон.
Роль данных как продукта
Данные, поставляемые контекстом, должны рассматриваться как продукт со своим охватом потребителей и планами развития. Это означает:
- определение цели использования и бизнес-метрик данных;
- обеспечение доступности и документации;
- наличие приёмочных тестов и дорожной карты эволюции данных;
- прозрачность по версиям, качеству и SLA.
Такой подход позволяет разворачивать независимые data products внутри контекстов и одновременно поддерживать совместимость на уровне контрактов, что критично для масштабирования Data Mesh.
Интеграционные сценарии и примеры
В реальных условиях контексты обычно взаимодействуют через несколько типов интерфейсов:
- потоковые API и подписки на события: характеризуются асинхронной доставкой, задержкой и порядком событий;
- пакетные загрузки: наборы данных, обновляющиеся по расписанию;
- синхронные сервисы API: запрос-ответ, меньшее время задержки, но требующие строгой совместимости контрактов.
Упор на гибкость выбора интерфейсов позволяет организациям адаптироваться к различным условиям потребления и скорости изменений в бизнесе. При этом следует помнить о балансе между автономией контекстов и необходимостью взаимного использования данных.
Риски, антипаттерны и пути их снижения
В процессе определения контекстов и согласования интерфейсов возможно столкнуться с рядом повторяющихся ошибок. Некоторые ключевые антипаттерны и пути их предотвращения.
- Переупрощение границ: слишком широкие или слишком узкие границы приводят к излишним зависимостям или недостаточной автономии. Решение - строить границы совместно с бизнес-юнитами и тестировать на реальных сценариях потребления.
- Игнорирование контрактов: отсутствие четких контрактов порождает нарушения совместимости. Рекомендация - внедрять обязательные контракты и каталоги с версионированием и автоматическим тестированием.
- Несогласованные эволюции: изменения в контракте без уведомления потребителей вызывают сбои. Решение - политика изменений, уведомления и миграционные сценарии.
- Недостаточная прозрачность владения данными: отсутствие ясной ответственности по данным ведет к задержкам и конфликтам. Необходимо закреплять роли и обязанности в governance-моделях.
- Узкие инструменты для self-service: без подходящих инструментов пользователи не получают конкурентное преимущество. Требуется набор шаблонов, автоматизации, каталогов и политики безопасности.
Архитектура и интеграция: как связать контексты и self-service
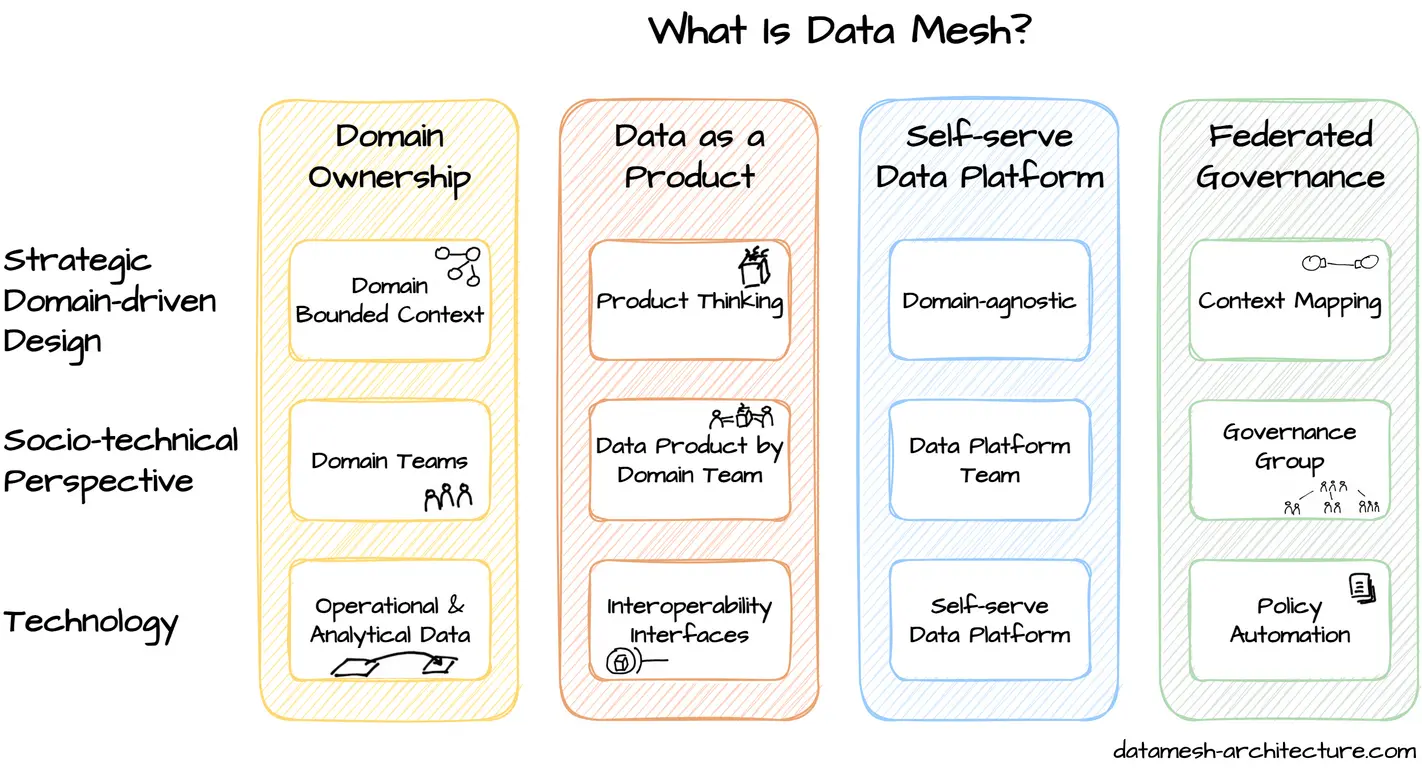
Эффективная архитектура Data Mesh строится на трех слоях: домены данных (контексты), data products и self-service платформа. Контексты должны обладать автономией в поставке данных, а data products - хорошей пригодностью для повторного использования и масштабирования. Self-service платформа должна обеспечивать:
- быстрый старт новых data products на основе существующих контрактов;
- инструменты для публикации, тестирования и мониторинга контрактов;
- автоматическое соблюдение политик безопасности и приватности;
- каталог метаданных и инструментов для обнаружения данных.
Практически это достигается за счет интеграции между контекстами, контрактами и инструментами мониторинга качества данных. Open-source решения и платформы каталогов данных, как OpenMetadata, могут быть использованы для ускорения внедрения: они предлагают организованный подход к управлению метаданными, контрактами и качеством данных. В качестве примера также можно отметить схему управления данными и процессами в рамках потоков, где контрактная эволюция тесно увязана с CI/CD пайплайном.
Russian contexts и локальные требования: при выборе инструментов следует учитывать требования к безопасности, регуляторные ограничения и интеграцию с существующей инфраструктурой. Вариативность технологий не должна приводить к разобщенности: единый подход к контрактам и их каталогам позволяет снижать сложность и повышать скорость внедрения.
Key takeaways
- Доменные границы в Data Mesh определяют ответственность за данные и позволяют каждой командe выпускать data products независимо, но в согласованных рамках.
- Контракты между контекстами включают сигнатуры схем, версии, политики качества и правила эволюции; их целью является устойчивость и предсказуемость взаимодействия.
- Эффективная методика выделения контекстов строится на бизнес-доменификации, определении владения данными, формализации контрактов и автоматическом тестировании совместимости.
- Self-service платформа должна обеспечивать доступ к контрактам, автоматическую валидацию, шаблоны для быстрого развертывания data products и мониторинг соответствия контрактам.
- Управление контрактами требует вовлечения бизнес-ролей, прозрачности версий и чётких процедур миграции, чтобы минимизировать риск изменений.
- Инструменты управления схемами и контрактами (например, схем Registry, каталоги контрактов) помогают упорядочить эволюцию данных и снизить технические долги.
- Антипаттерны, такие как несогласованные границы и игнорирование контрактов, приводят к задержкам и конфликтам; их следует предотвращать через governance-процессы и автоматизацию.
FAQ
- Что такое доменные границы в контексте Data Mesh?
Доменные границы - это границы владения данными и ответственности за их качество внутри конкретного бизнес-домена. Они определяют, какие команды создают и поддерживают data products, какие требования предъявляются к данным и как данные поставляются потребителям. Границы помогают снизить зависимость между командами, повысить скорость поставки данных и обеспечить прозрачность ответственности.
- Как начать определение контекстов без риска конфликтов?
Начните с бизнес-анализа и картирования потоков данных между подразделениями. Определите ключевые бизнес-цели, где данные являются критическими, и кто является владельцем каждого контекста. Затем сформируйте черновые контракты и проведите пилотное внедрение на ограниченном наборе потребителей, чтобы проверить жизнеспособность контекстов и контрактов.
- Какие принципы использовать для формирования контрактов между контекстами?
Контракты должны описывать: сигнатуру данных (поля, типы, валидаторы, обязательность); способ доступа ( API, тема сообщения, пакет); требования к качеству (полнота, точность, задержка, согласованность); версионирование и правила эволюции. Важно обеспечить единый реестр контрактов и автоматическую проверку соответствия на этапе CI/CD.
- Что включает в себя эволюция контрактов?
Эволюция контрактов должна происходить по прогнозируемым сценариям: добавление новых полей с дефолтами, изменение типов с миграцией, удаление полей после уведомления потребителей и периодической поддержки предыдущих версий. Важно определить дедлайны и миграционные планы, чтобы потребители могли адаптироваться.
- Как обеспечить согласование изменений между контекстами?
Устанавливается процесс уведомления заинтересованных сторон, выпуски версий контрактов с аннотациями изменений, а также тестирование совместимости на уровне потребителей и производителей. Регулярные встречи по архитектуре и governance-модели помогают согласовывать планы изменений и отражать их в каталоге контрактов.
- Какие подходы к автоматизации покрытия контрактов применимы на практике?
Используйте схемы в формате JSON Schema/Avro/Protobuf и внедрите schema registry для централизованного хранения версий и проверки соответствия. Настройте CI/CD пайплайны, которые автоматом валидируют изменения контракта и тестируют потребителей на совместимость. Мониторинг качества данных и соблюдения контрактов должен быть встроен в production-окружение.
- Какие риски чаще всего возникают при внедрении границ контекстов?
Основные риски - неполное определение владения данными, слабые контракты, игнорирование эволюции, недостаточный мониторинг и отсутствие четкой governance-модели. Предотвращение достигается через совместное участие бизнес-юнитов, документирование ролей, автоматизацию тестирования и прозрачное управление версиями.
- Какую роль играют инструменты каталогов контрактов?
Каталоги контрактов обеспечивают видимость контекстов, версий и зависимостей, помогают находить потребителей и производителей, упрощают аудит и регуляторную проверку. Они также поддерживают поиск по семантике данных и предоставляют шаблоны для внедрения новых data products.
- Какие технологические решения можно рекомендовать на практике?
Для контрактов применимы форматы схем (JSON Schema, Avro, Protobuf) и управление версиями через schema registry. Для каталогов контрактов - открытые решения, которые интегрируются с метаданными и дают единый источник истины. В реальных ИТ-ландшафтах разумно сочетать открытые форматы со специфическими корпоративными настройками.
- Как связать архитектуру контекстов с целью self-service?
Необходимо обеспечить для каждой команды автономный доступ к данным через готовые data products, при этом поддерживать единый набор правил доступа, качества и версионирования. Self-service платформа должна предоставлять инструменты для быстрого развёртывания новых data products на основе готовых контрактов, автоматическую валидацию и мониторинг, а также управляемые каталоги метаданных.


