

Trino: архитектура параллельной аналитики, коннекторы и протоколы доступа к данным, интеграции и сценарии применения
Введение: контекст и цели анализа по параллельной аналитике внешних источников в Trino
Современная корпоративная аналитика опирается на данные, размещенные в разнородных источниках: реляционные базы данных, NoSQL-хранилища, озера данных и Data LakeHouse, а также потоковые платформы. В условиях стремительной эволюции бизнес-требований важна возможность выполнять SQL-запросы непосредственно к этим источникам без копирования данных, минимизируя задержки, сохраняя целостность источников и обеспечивая управляемость консистентности. В этой связи распределенные движки анализа данных, такие как Trino, предлагают архитектуру Massively Parallel Processing (MPP), которая позволяет горизонтально масштабировать обработку и проводить сложные операторы SQL над большими наборами внешних данных.
Цель данной статьи - системно рассмотреть архитектуру Trino и связанные с ней механизмы: координацию между координатором кластера и рабочими узлами, взаимодействие с клиентскими приложениями и драйверами, модели доступа к данным через коннекторы, схемы отображения нереляционных структур в табличные представления, распределенный план выполнения запросов, протоколы доступа к данным (обычный режим, протокол спулинга и прямой протокол), а также аспекты безопасности, производительности и интеграции с технологическими стековыми решениями. Аналитическая перспектива охватывает не только теоретические основы, но и практические принципы эксплуатации, мониторинга, кейсы применения и оценку конкурентных преимуществ Trino на рынке параллельной аналитики.
Стратегически данная работа выстраивает переход от общего контекста многокластерной аналитики к детальному разбору каждого технического компонента и сценариев использования. Такой подход обеспечивает эволюцию компетенций аналитиков, архитекторов, руководителей data-направлений и ИТ-директоров от концепций MPP и распределенного выполнения к конкретным практикам интеграции внешних источников, проектирования коннекторов, выбора протоколов доступа и методик оптимизации производительности.
Теоретическая база и принципы массово-параллельной обработки (MPP) в Trino
MPP, или Massively Parallel Processing, является краеугольной концепцией современных аналитических систем, направленной на разделение объема вычислений и данных на множество независимых узлов с синхронной или асинхронной координацией. В контексте Trino MPP реализуется через архитектуру, где координационный узел (координатор) отвечает за планирование, распределение задач и агрегацию результатов, а рабочие узлы (workers) исполняют параллельные фазы плана над разделенными фрагментами данных. Основная идея состоит в том, что данные поступают из внешних источников посредством коннекторов, а последующая обработка строится на последовательности операторов, организованных в распределенный план.
Важно отметить, что в Trino отсутствует централизованное хранение данных внутри самого движка. Вместо этого данные остаются на внешних источниках, и Trino выполняет SQL-операторы, получая данные «на лету» через коннекторы. Такой подход требует особой внимательности к распределению сплитов (разделов данных) и к тому, как формируется граф выполнения запроса. Распределение осуществляется так, чтобы нагрузка равномерно распределялась между рабочими узлами, минимизировался обмен данными и обеспечивалась эффективная локализация вычислений near the data, насколько это возможно через планирование и разбиение задач.
В теоретическом плане MPP в Trino опирается на следующие принципы:
- параллелизм на уровне сплитов: каждый драйвер обрабатывает один или несколько сплитов, что обеспечивает масштабируемость пропорционально объему данных и параллелизму источников;
- балансировка нагрузки через координацию: координатор распознает доступные сплиты и сопоставляет их соответствующим задачам на рабочих узлах;
- streaming-интерпретация операторов: каждый оператор SQL реализуется как конвейер обработки, который может потреблять и производить данные параллельно;
- гибкость источников: коннекторы поддерживают различные форматы и модели хранения, что требует адаптивного планирования и адаптивной оптимизации во время выполнения;
- отсутствие копирования для внешних источников: цель - минимизировать/E2E-издержки, связанные с дублированием данных, сохраняя достоверность и актуальность источников.
С точки зрения архитектуры, ключевые элементы MPP в Trino обеспечивают разделение ответственности между планированием и исполнением: планировщик формирует корневую структуру выполнения, затем она передается на уровне этапов и задач, где каждая задача выполняет конкретные драйверы и операторы. В результате достигается эффективная параллелизация, устойчивость к сбоям и возможность масштабирования кластера в условиях роста объема данных и числа коннекторов.
Архитектура Trino: координация, рабочие узлы и взаимодействие с клиентскими приложениями
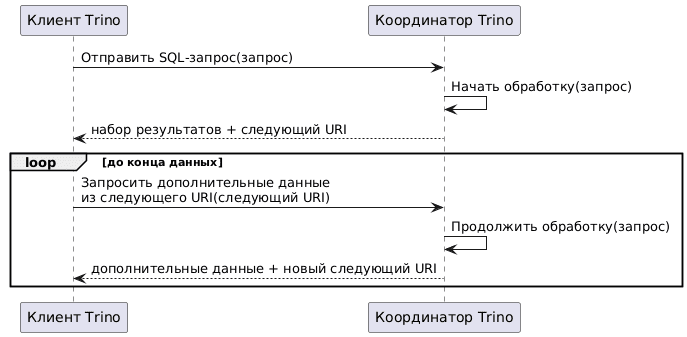
Архитектура Trino строится вокруг трёх ключевых ролей: координатора кластера, рабочих узлов и клиентов/драйверов. Координатор отвечает за глобальное планирование выполнения запросов, управление метаданными и координацию распределенного исполнения. Рабочие узлы выполняют реальные вычисления, обмен данными между собой и с координатором, управляют локальными ресурсами и памятью. Клиенты и драйверы - это внешние приложения, которые отправляют SQL-запросы и получают результаты частями через HTTP-протокол.
Технологическая цепочка запроса начинается с клиентского приложения, которое отправляет SQL-запрос координатору через клиентский протокол на основе HTTP. Координатор анализирует запрос, строит распределенный план выполнения, учитывая доступность коннекторов и источников, затем распределяет задачи по рабочим узлам. На каждом рабочем узле выполняются драйверы, состоящие из последовательности операторов, которые обрабатывают разделения данных (сплиты), выполняют операторы фильтрации, проекции, агрегации, соединения и сортировки. По мере продвижения выполнения данные проходят через обмены между узлами; координационный узел может запрашивать данные у коннекторов и согласовывать, какие сплиты обрабатываются какими задачами. В результате результаты возвращаются клиенту по частям, пока не будут получены все данные.
Особенности взаимодействия с клиентскими приложениями и драйверами включают:
- поддержка HTTP-протокола для обмена SQL-запросами и результатами;
- наличие клиентских драйверов для Go, JavaScript, Python и JDBC, что обеспечивает широкий набор языков и сред выполнения;
- механизм протоколов доступа к данным, предусматривающий как обычный режим, так и режим спулинга для повышения пропускной способности;
- согласование версий драйверов и кластера, включая требования к совместимости версии JDBC и к хотя бы минимальной версии Java для JVM-клиентов.
Координационный узел управляет жизненным циклом запроса: он собирает статистику, следит за выполнением задач, перераспределяет нагрузку при сбоях и занимается сбором агрегированных результатов. Рабочие узлы являются исполнительными единицами, где драйверы выполняют последовательность операторов. Обмены между узлами обеспечивают передачу данных, которые необходимы для реализации стадий и этапов выполнения запроса. Эта координационная схема обеспечивает отказоустойчивость, потому что в случае сбоя на одном узле другие узлы могут подхватить обработку нужных сплитов, а координатор может перераспределить задачи.
Коннекторы и источники данных: реляционные БД, NoSQL, озёра данных, Data LakeHouse и потоковые платформы
Коннекторы - это мост между Trino и внешними источниками. Они инкапсулируют специфику доступа к данным, обеспечивают чтение и, по возможности, запись через стандартизированные интерфейсы. В контекстах корпоративной аналитики широко применяются следующие источники и соответствующие коннекторы:
- Реляционные базы данных (RDBMS): Oracle, PostgreSQL, MySQL, MSSQL и другие популярные СУБД. Коннекторы обеспечивают поддержку ANSI SQL к данным, часто с учетом специфичных функций источников, типичных ограничений по транзакционности и согласованности.
- NoSQL-хранилища: MongoDB, Apache Cassandra, Redis и др. Эти источники часто требуют отображения нереляционных моделей в табличный формат данных, поддерживают гибкую схему и позволяют агрегировать данные без жесткой схематизации.
- Озера данных (data lakes): хранилища, работающие на колонночных форматах (Parquet, ORC, AVRO) и метаданных на основе каталогов (например, Hive Metastore). Коннекторы к озерам данных позволяют читать структурированные, полуструктурированные и вложенные данные, поддерживая схемы эволюции и проверку типов.
- Data LakeHouse: интеграционные решения, сочетающие элементы озер данных и архивы структурированных данных, где поддерживаются транзакции, управление версиями и ACID-свойства на уровне каталога.
- Потоковые платформы: Apache Kafka и др., где коннекторы обеспечивают подключение к потоковым источникам, поддерживают чтение с сохранением порядка, временные метки и более сложные схемы агрегирования на лету.
Коннекторы в Trino не копируют данные в мастер-узел; они читают данные напрямую из источника и передают их операторам выполнения. Это требует согласованности параметров конфигурации, политики доступа, безопасного обращения с учетными данными и согласования версий протоколов между драйверами и коннекторами. Конфигурации коннекторов обычно хранятся в каталоге (catalog), что обеспечивает единообразие и управление версиями. В зависимости от источника коннектор может поддерживать различные режимы чтения, фильтрацию на уровне источника, режимы аутентификации и требования к сетевым подключением.
Модели данных и отображение нереляционных структур в табличные представления
Традиционно SQL-движки заточены под табличную модель. Однако источники данных часто представляют собой полуструктурированные или вложенные форматы, такие как JSON, XML, вложенные структуры Parquet и схемы часовых рядов в потоках. В Trino нереляционные данные отображаются в табличные представления через механизмы:
- преобразование типов и приведение к скалярным и сложным (комплексным) типам, включая структуры, массивы и карты;
- нормализация или денормализация для целей аналитических запросов; при этом возможна «flattening» вложенных структур;
- использование представлений и схем для адаптации к внешним источникам, где структура таблиц может быть эластичной и изменчивой;
- поддержка режимов эволюции схемы, чтобы источники могли добавлять новые поля без нарушения существующих запросов.
Сопоставление нереляционных моделей с таблицами в Trino требует аккуратного проектирования схем и политики версий. Это особенно важно для Data LakeHouse и озер данных, где данные часто хранятся в колонночных форматах с вложенными полями. Расширяемость моделей данных и грамотная абстракция через представления позволяют аналитикам писать единый SQL-словарь, не привязываясь к конкретной организации хранения, что упрощает развёртывание аналитических сценариев и обеспечивает переносимость запросов между окружениями.
Декомпозиция технических компонентов и их взаимодействие
Архитектура Trino основана на принципе модульности и разделения ответственностей. Ключевые компоненты включают:
- планировщик/план выполнения: отвечает за разбор SQL, построение распределенного плана и оптимизацию на уровне логики исполнения;
- координатор: управляет всем жизненным циклом запроса, распределяет задачи и координирует обмен данными между узлами;
- рабочие узлы: выполняют вычисления, обрабатывают сплиты, запускают драйверы и применяют операторы;
- коннекторы: реализуют взаимодействие с источниками, обеспечивают чтение, фильтрацию и, по возможности, запись;
- каталоги (catalogs): хранят конфигурации коннекторов и схемы объектов (метаданные источников);
- обмены (exchanges): сетевые механизмы передачи данных между узлами.
Внутренние слои включают также менеджеров памяти, менеджеров потоков, буферизацию данных между операторами и механизм адаптивного планирования, который может перераспределять ресурсы в соответствии с загрузкой кластера. Эффективная координация между этими компонентами зависит от точной синхронизации времени выполнения, пропускной способности сети и характеристик источников. В частности, распределение сплитов по задачам требует строгого контроля блокировок и обеспечения консистентности данных между этапами выполнения.
Конфигурации коннекторов: параметры, управление и хранение в каталоге
Конфигурации коннекторов - это набор параметров, который описывает доступ к источнику, а также характеристики выполнения чтения/записи. Основные аспекты конфигураций включают:
- параметры аутентификации и авторизации (учётные данные, токены, сертификаты, Kerberos);
- параметры доступа к сетевым ресурсам и тайм-ауты;
- схемы сериализации/десериализации данных (форматы Parquet, ORC, JSON и пр.);
- пул соединений, лимит одновременных запросов и политика повторных попыток;
- специфику обеспечения согласованности и совместимости, включая версию драйвера и источника;
- хранение конфигураций в каталоге кластера, обычно в виде файлов в каталогах etc/catalog, где каждая сущность коннектора представлена отдельным свойством, например hive.properties или jdbc.properties.
Управление каталогами обеспечивает централизованное обновление конфигураций без прерывания выполнения запросов. Важной практикой является верификация совместимости между версией коннектора, версией кластера Trino и версией источника данных, что минимизирует риск несовместимости и ошибок выполнения. Кроме того, для обеспечения безопасности доступа к данным применяется принцип наименьших привилегий и управление секретами через внешние хранилища секретов, чтобы не держать пароли в открытом виде на уровне файлов каталогов.
Распределённый план выполнения запроса: корневая стадия, стадии, задачи, драйверы и сплиты
Распределённый план выполнения запроса в Trino строится как иерархия, напоминающая дерево. Верхняя единица - корневая стадия - отвечает за итоговую агрегацию результатов, полученных из промежуточных стадий. Ниже расположены стадии, каждая из которых представляет собой логическую разделённую часть работы: сканирование источников через коннекторы, фильтрация, агрегации, соединения и другие операторы SQL. На уровне стадий реализуются задачи, которые исполняются на рабочих узлах и обрабатывают разделения данных - так называемые сплиты (splits).
Координатор запрашивает коннекторский источник о доступных сплитах, чтобы определить, какие узлы будут задействованы и какие данные будут обработаны в каждой задаче. Каждая задача содержит один или несколько параллельных драйверов, которые являются конкретными реализациями операторов в виде конвейера обработки. Драйверы действуют как цепочка операторов, проходящая данные от входа к выходу. В самом низу плана драйверы получают данные через сплиты коннекторов и передают их вышестоящим этапам выполнения. На верхнем уровне между этапами данные передаются через промежуточные результаты, которые собираются и агрегируются корневой стадией.
Распределённый план осуществляется с учетом характеристик коннекторов и источников: сетевые задержки, пропускная способность, задержки копирования и временные константы. Координатор управляет отслеживанием того, какие машины обрабатывают какие сплиты и как данные движутся по плану. Этот контролиранный обмен данных обеспечивает корректное выполнение запроса и минимизацию задержек, хотя внешние источники могут вносить дополнительные задержки из-за своей собственной пропускной способности и задержек обработки.
Этапы и задачи: иерархия стадий, взаимодействие между этапами, агрегации
Этапы выполнения запроса в Trino являются основой распределенной архитектуры. Каждый этап выполняется на одном или нескольких узлах и отвечает за обработку поднабора сплитов. Взаимодействие между этапами происходит через передачу промежуточных результатов: данные, полученные на одном этапе, передаются на следующий этап либо как конечная подвыборка, либо как агрегированные значения. Этапы ориентированы на выполнение конкретных операторов: сканирование/чтение через коннекторы, фильтрация, проекции, агрегации и соединения между потоками данных.
Агрегация на корневой стадии обеспечивает возврат итогового результата клиенту, объединяя данные, полученные на более мелких этапах. В рамках эксплуатации архитектуры важно обеспечить корректную синхронизацию между этапами, минимизировать задержки на передачи промежуточных результатов и предусмотреть политики повторной обработки в случае сбоев. Этапы строятся так, чтобы обеспечить баланс между локальной обработкой на узлах и необходимостью передачи данных между узлами. Эффективная настройка параметров, таких как размер буферов, число сплитов и параллельность драйверов, позволяет управлять временем выполнения запроса и ресурсной нагрузкой кластера.
Драйверы и операторы: последовательность операторов, память и параллелизм
Драйвер в Trino представляет собой последовательность физических операторов, образующую конвейер обработки данных. Это минимальная единица параллелизма в архитектуре и не имеет внутреннего разбиения на более мелкие смысловые части. Каждый драйвер имеет вход и выход, но может состоять из множества операторов, выполняемых в памяти. В ходе выполнения драйверы работают над входными данными, применяют операторы над этими данными и передают результаты следующему оператору внутри драйвера или выходу на уровне задачи.
Параллелизм достигается за счет параллельной обработки нескольких драйверов внутри одной задачи и распределения задач по нескольким рабочим узлам. Операторы в рамках драйвера могут включать:
- сканирование (прочитать данные через коннектор);
- проекции (извлечение нужных столбцов);
- фильтрацию (применение предикатов);
- агрегации (GROUP BY, агрегирующие функции);
- соединения (JOIN) и сортировки (ORDER BY).
Память и буферы играют критическую роль в эффективности: данные часто переносятся между операторами в буферизированной форме, в памяти рабочих узлов. Эффективная настройка параметров памяти, включая лимиты и стратегии использования буфера, снижает необходимость частых обращений к диску и улучшает пропускную способность выполнения.
Обмены и сетевые взаимодействия: передачи данных между узлами и синхронизация
Обмены между узлами - это механизмы передачи данных между рабочими узлами и координатором для реализации распределенного выполнения. Они обеспечивают передачу промежуточных результатов между этапами и задачами. В процессе эксплуатации возникают вопросы латентности и пропускной способности сети: скорость передачи данных напрямую влияет на задержки выполнения запроса и общее время ответа.
Ключевые особенности обменов:
- асинхронная передача данных между задачами на разных узлах;
- использование протоколов взаимодействия поверх сети, обеспечивающих надёжность доставки;
- поддержка параллельной передачи множества потоков данных, соответствующих различным сплитам и этапам;
- координация по порядку, чтобы сохранить консистентность результатов в распределенном контексте.
Эффективное функционирование обменов требует оптимизации сетевых путей, минимизации перекрёстной передачи и аккуратной балансировки нагрузки между узлами. В сочетании с адаптивным планированием это позволяет достигать высоких скоростей отклика на запросы и устойчивость к нагрузкам.
Клиентские взаимодействия: драйверы, протоколы HTTP и поддерживаемые языки (Go, Java, Python) и JDBC
Клиентские взаимодействия в Trino осуществляются через драйверы и клиентские библиотеки, которые отправляют SQL-запросы координационному узлу через HTTP-протокол. В частности, поддерживаются драйверы для Go, JavaScript и Python, а также JDBC-драйвер для Java-приложений и приложений, работающих в JVM. JDBC-драйвер совместим с Java 8 и выше, и версия драйвера должна быть идентична версии кластера или новее. Вход через JDBC-драйвер требует предоставления доступа к схемам system.jdbc в журнале аутентификации.
Клиентский протокол поддерживает две модели взаимодействия:
- обычный режим (direct): данные передаются напрямую от рабочих узлов к координатору и далее клиенту; это классический режим, совместимый со старыми клиентами, но может потребовать большей вычислительной мощности на координаторе и больше времени на передачу больших наборов данных;
- режим спулинга (spill protocol): данные первоначально записываются в объектное хранилище кластера, а клиент получает доступ к сегментам данных через URL-адреса секций, что позволяет увеличить пропускную способность и ускорить обработку больших результатов. В spool-подходе данные продолжают хронологически сохраняться в хранилище, пока клиент не извлечет их. Затем данные могут быть удалены из хранилища.
JDBC-драйвер и другие клиенты автоматически используют spool-подход, если он включен и поддерживается, и клиент имеет сетевой доступ к объектному хранилищу. В случаях с ограничениями spool может автоматически переключаться на обычный режим. Важными преимуществами spool-подхода являются значительно более высокая пропускная способность передачи данных и сокращение времени завершения запросов, независимо от того, запрашивает ли клиент все данные или только часть. При этом spool-технология требует наличия хранилища в кластере и возможностей его управления.
Протокол доступа к данным: обычный режим против протокола спулинга, хранение и обработка данных
Разговор о протоколах доступа к данным в Trino встает вокруг двух режимов - обычного протокола и протокола спулинга. В обычном режиме данные передаются непосредственно между рабочими узлами и координатором, клиент получает поток результатов в виде порций. Это простой режим, не требует специальных настроек хранилища данных и подходит для клиентов с ограничениями к поддержке сложных конфигураций. Однако при больших объемах данных такая схема может повышать нагрузку на центральный компонент (координатор) и вызывать задержки из-за высокой скорости ввода-вывода на стороне клиента.
Протокол спулинга предполагает сохранение частичного набора результатов в объектном хранилище кластера. Координатор предоставляет клиенту URL-адреса сегментов, которые клиент может загружать напрямую. Это позволяет значительно увеличить пропускную способность и ускорить завершение запросов, особенно для больших наборов результатов. spool-подход также упрощает работу с клиентами с ограниченной сетевой связностью или ограниченной поддержкой протоколов. Но для его функционирования необходимо соответствующее хранение объектов и доступ к ним у клиента и источников, а также требование соблюдения политики хранения результатов - данные могут удаляться после загрузки клиента.
В практических условиях выбор протокола определяется характером запросов, требованиями к задержкам и пропускной способности, а также доступностью внешних хранилищ. В современных кластерах предпочтение отдается spool-подходу для больших наборов данных и аналитических операций, где важно сократить общее время выполнения.
Протокол спулинга: требования к клиентам, преимущества по пропускной способности и времени завершения
Протокол спулинга требует определённых условий на стороне клиентов и инфраструктуры:
- доступ к объектному хранилищу, используемому в кластере Trino;
- современные клиентские драйверы, поддерживающие spool-подход;
- настройка кодировок и параметров, связанных с обработкой и хранением данных;
- согласование версий драйверов и кластера, включая требования к совместимости.
Преимущества spool-подхода включают:
- значительно более высокую пропускную способность передачи больших наборов данных;
- более быструю агрегацию и завершение запросов за счет прямого чтения из хранилища клиентом;
- возможность освобождения координатора от обработки больших результатов до момента потребления клиентом.
Сложности spool-подхода заключаются в необходимости наличия надежного хранилища, контроля за временем хранения, а также согласования между частями кластера и клиентами. В ситуациях, где клиенты не поддерживают spool-подход, протокол автоматически переходит к обычному режиму.
Прямой протокол: особенности, ограничения и совместимость с устаревшими клиентами
Прямой протокол - это режим, при котором данные передаются напрямую от рабочих узлов к координатору и далее клиенту. Этот режим не требует специальных объектов хранения и настроек для spool, что упрощает конфигурацию и обеспечивает совместимость с устаревшими драйверами и приложениями. Однако он нередко уступает spool-подходу по производительности на больших объемах данных, поскольку данные обрабатываются и передаются «онлайн» через центральный канал, создавая потенциальную нагрузку на координатор и сеть.
Особенности прямого протокола:
- отсутствие зависимости от объектного хранилища и его операций хранения;
- совместимость с более старыми клиентскими версиями и драйверами;
- меньшая нагрузка на систему для небольших результативных наборов и сценариев с ограниченным количеством данных.
Реализация прямого протокола может быть предпочтительна в средах с ограниченной инфраструктурой хранения, проблемами доступа к внешним хранилищам или когда требуется простая конфигурация без поддержки spool.
Безопасность доступа и конфигурации: безопасные параметры доступа к источникам и схемам
Безопасность доступа к источникам и схемам - критически важный аспект эксплуатации Trino в корпоративной среде. Основные направления безопасности включают:
- управление учётными данными: хранение секретов и credentials в защищенных хранилищах (например, Vault, Kubernetes Secrets, AWS Secrets Manager) и их циклическая ротация;
- использование AES-256 или иных современных механизмов шифрования для передачи данных и хранения sensitive-данных;
- настройка доступа на основе ролей и политик: разграничение прав на уровне источников, проектов и схем;
- минимизация прав доступа: предоставление доступа только к необходимым схемам и данным, не по умолчанию - полный доступ;
- включение аудита и мониторинга доступа к источникам: запись логов запросов, операций исполнения и изменений конфигураций;
- использование безопасных соединений: TLS/SSL для коммуникаций между клиентами, координатором и рабочими узлами;
- контроль обновлений: своевременная установка патчей и обновлений для коннекторов и драйверов, чтобы устранить уязвимости и повысить совместимость.
Безопасность должна быть встроена на этапе проектирования архитектуры: от выбора источников, путей доступа, политики шифрования, до хранения конфигураций и ключей доступа в каталоге. Это обеспечивает защиту данных и соответствие требованиям регулирования.
Производительность и оптимизация: роль спулинга, метрики эффективности и оптимизационные подходы
Производительность выполнения запросов в Trino определяется рядом факторов, среди которых ключевыми являются:
- режим доступа к данным (спулинг vs прямой) и способность spool повышать пропускную способность;
- распределение сплитов и балансировка нагрузки между узлами;
- оптимизация плана выполнения, включая выбор операторов и порядок их применения;
- пропускная способность сети и эффективность обменов между узлами;
- оптимизация коннекторов и источников, включая режим чтения, фильтрацию на источнике и использование индексов.
Роль spool-подхода особенно заметна в сценариях с большими набороми результатов. Спулинг снижает давление на координатор и сеть, позволяя клиенту загружать данные по частям напрямую из объекта хранения. Это улучшает общую производительность E2E. При этом spool может потребовать дополнительной настройки: стратегий хранения, кодировок и доступности объектов.
Метрики эффективности включают:
- задержку выполнения (latency) и скользящее среднее время завершения;
- пропускная способность (throughput) - количество строк или байтов, обрабатываемых в единицу времени;
- использование памяти в узлах;
- долю времени, затрачиваемую на сетевые обмены и чтение коннекторов;
- долю ошибок и повторных попыток, связанных с источниками и коннекторами.
Оптимизационные подходы включают:
- настройку числа сплитов и параллельности драйверов;
- выбор подходящего протокола доступа (spooling vs direct) в зависимости от сценария;
- кэширование на уровне кластера и коннекторов, если доступно, для повторно выполняемых запросов;
- мониторинг и настройку параметров сети и очередей;
- внедрение раннего вычисления фильтров и проекций на источниках, если коннектор позволяет, для уменьшения объема передаваемых данных.
Интеграция технологических стеков: взаимодействие с Kafka, озёрами данных и Data LakeHouse
Trino обеспечивает тесную интеграцию с современными технологическими стекaми, включая:
- Apache Kafka как потоковую платформу: подключение к топикам, чтение событий в реальном времени, агрегации и объединения в SQL-проектах, а также последующая доставка результатов в консистентной форме. Коннекторы для Kafka позволяют использовать описанные режимы доступа и схемы обработки потоковых данных.
- Озёра данных: Parquet/ORC-форматы и каталогизация метаданных. Trino способен эффективно работать с данными в озерах, поддерживая разнообразные форматы, схемы и версии файлов. Это обеспечивает гибкость обработки и обеспечение совместимости между системами.
- Data LakeHouse: концепция объединения возможностей озер данных и транзакционного хранения, где транзакционные характеристики и ACID-свойства применяются к данным, хранящимся в озерах и более формализованных слоях. В контексте Trino Data LakeHouse представляет собой среду, в которой данные хранятся в озерах, но управляются и обрабатываются с соблюдением строгих транзакционных свойств и согласованности.
- Интеграции с другими данными стеков: SIEM, мониторинг, BI и ETL/ELT-процессы, которые требуют доступа к данным из разных источников без копирования.
Такая интеграция позволяет организациям строить сквозные аналитические конвейеры и реальные сценарии без копирования данных, что снижает затраты на хранение и ускоряет доступ к свежим данным.
Кейсы применения в реальных сценариях: примеры использования без копирования данных
Без копирования данных Trino применяется в ряде реальных сценариев:
- объединение данных из нескольких источников в единую аналитическую пластину без физического переноса, что ускоряет получение ответов на запросы и уменьшает риск несогласованности копируемых данных;
- реализация кросс-обзоров по данным из Hadoop/Parquet и реляционных БД в рамках единого SQL-запроса, что упрощает аналитические сценарии и снижает затраты на инвидированный ETL;
- потоковая аналитика через Kafka и каналы озер данных: обработка событий в реальном времени и создание ускоренного потока анализа без задержек копирования;
- Data LakeHouse сценарии, где транзакционность и консистентность сохраняются, а данные читаются напрямую из озера;
- сценарии безопасной аналитики, когда данные должны оставаться в исходных системах и доступ предоставляется через коннекторы с политиками доступа.
Эти кейсы демонстрируют ценность Trino как движка для аналитических сценариев без необходимости загружать данные в другой репозиторий, что сокращает время отклика и обеспечивает управляемость.
Возможности применения в различных экономических секторах: финансы, розничная торговля, промышленность и гос сектор
- Финансы: запросы к различным системам для оперативной аналитики, риск-менеджмент, проверки соответствия, регуляторные требования и аудиты без копирования конфиденциальных данных в сторонние хранилища.
- Розничная торговля: консолидация данных из ERP, CRM, витрин и киосков в единую когерентную аналитику; быстрый анализ продаж и запасов в реальном времени через коннекторы к источникам.
- Промышленность: анализ сенсорных данных, MES (Manufacturing Execution System) и ERP, сбор данных из разных систем, мониторинг процессов без излишнего копирования.
- Государственный сектор: анализ данных из множества ведомственных систем, регуляторная отчетность и аудит, с учетом требований к безопасности и сохранности данных.
Во всех указанных секторах ключевой преимуществом является возможность проводить кросс-источник анализ без необходимости копирования данных, что сокращает время реакции, экономит ресурсы и упрощает соответствие политики безопасности.
Анализ рисков, уязвимостей и ограничений: метрики эффективности, мониторинг, безопасность и отказоустойчивость
Риски и ограничения включают:
- задержки доступа к внешним источникам и зависимость от их производительности;
- сложность поддержки множества коннекторов и версий;
- необходимость управления секретами и политиками безопасности;
- потенциальные риски при агрегации большого числа сплитов и сложных операторов;
- потребность в мониторинге и аудите для соблюдения регуляторных требований.
Метрики эффективности и мониторинг:
- latency и throughput по запросам;
- процент успешных выполнений запросов и частота ошибок;
- использование памяти на узлах и нагрузка на сеть;
- детальная трассировка выполнения запросов и анализ узких мест;
- показатели доступности и отказоустойчивости, включая точки восстановления после сбоев.
Для снижения рисков применяются стратегии:
- четкое разделение ролей, безопасный доступ к источникам и рабочим узлам;
- автоматическое масштабирование кластера в зависимости от нагрузки;
- предиктивная аналитика и мониторинг на основе метрик KPIs;
Конкурентный анализ решений и их дифференциация: сравнительный обзор и конкурентные преимущества Trino
На рынке параллельной аналитики Trino конкурирует с решениями, ориентированными на хранение больших данных и потоковую/аналитическую обработку. В сравнении с альтернативами:
- Presto и первоначальные версии оригинального проекта - Trino является ответвлением Presto, с улучшенной поддержкой коннекторов, более активной дорожной картой и ориентированностью на инфраструктурную гибкость, включая spool-подход.
- Spark SQL и его экосистема часто эффективна в пакетной обработке больших данных, но может требовать копирования данных и ресурсов в рамках своих транзакционных окон; Trino лучше подходит для кросс-источников без копирования и для быстрого SQL-запроса.
- Коммерческие решения, такие как Redshift Spectrum, BigQuery и Athena, предлагают интеграцию в проприетарные экосистемы и иногда ограничивают гибкость в отношении источников; Trino обеспечивает более широкую совместимость с разнообразными источниками и кастомизацию через коннекторы.
- Преимущества Trino включают масштабируемость, гибкость коннекторов, отсутствие копирования данных и возможность работы с потоками и озерами.
Дифференциация Trino происходит за счет открытой архитектуры, поддержки spool-подхода, широкого набора коннекторов и способности интегрироваться с Data LakeHouse и Kafka для сценариев реального времени, что позволяет строить единый аналитический слой над разнородными источниками без жесткой привязки к одному поставщику или формату.
Обучение и квалификация: курсы TRINO, аудитории, длительность и ближайшая дата
Обучение по Trino ориентировано на профессиональных участников дата-экосистемы: аналитиков, архитекторов, инженеров, руководителей data-направлений и ИТ-директоров. В рамках подготовительных образовательных программ предлагаются курсы, охватывающие теоретическую базу, практическую настройку и эксплуатацию кластера. В указании материалов встречаются элементы: архитектура MPP, принципы планирования, конфигурации коннекторов, протоколы доступа к данным, безопасность, мониторинг, а также практикум по интеграции с Kafka и Data LakeHouse.
Пример базовой программы включает:
- основы MPP и архитектуры Trino;
- настройка конфигураций коннекторов и каталогов;
- проектирование схем отображения нереляционных структур;
- разбор распределенного плана выполнения и стадий;
- работа с протоколами доступа к данным (обычный, spool, прямой);
- безопасность, мониторинг и оптимизация;
- интеграцию с Kafka и озерами данных;
- кейсы без копирования данных и сценарии применения в отчетности и аналитике.
Ближайшая дата курса TRINO: 27 апреля 2026 года. Продолжительность курса - 16 академических часов. Стоимость обучения - 51 200 (валюта, указана в локальном контексте). Это предложение ориентировано на профессиональные подготовку и повышение квалификации специалистов в области Big Data и аналитики данных.
Перспективы развития и выводы
Перспективы развития Trino включают дальнейшее расширение коннекторной экосистемы, усиление адаптивного планирования, повышение эффективности spool-подхода и расширение функциональных возможностей в данных и стриминге. Важной частью развития остаются улучшение безопасности доступа к внешним источникам, улучшение мониторинга и диагностики, а также расширение практик проектирования для Data LakeHouse и интеграции с потоковыми платформами. Будущие направления охватывают:
- углубление поддержки новых форматов и источников, включая специфические базы данных и платформы;
- развитие более гибких и адаптивных стратегий планирования и распределения;
- расширение возможностей для целей регуляторной аналитики и аудита;
- усиление образовательной базы и профессиональной квалификации через архитектурно-обоснованные курсы и программы сертификации.
Обобщая, Trino представляет собой мощную платформу для параллельной аналитики внешних источников без копирования данных. Архитектура MPP, гибкость коннекторов, разнообразие протоколов доступа к данным и возможность интеграции с потоковыми и озерными технологиями делают Trino центральным элементом современных аналитических конвейеров. В условиях постоянно изменяющейся технологической среды подходы к проектированию и эксплуатации Tно остаются критическими для достижения высоких показателей производительности, безопасности и управляемости данных.
Вопрос-Ответ:
-
Вопрос: Что такое MPP и как он реализуется в Trino?
Ответ: MPP - это архитектура, основанная на разделении вычислений и хранения между многочисленными узлами. В Trino координатор планирует запрос и распределяет задачи между рабочими узлами, где каждый драйвер обрабатывает сплиты и операторы, а обмены обеспечивают передачу промежуточных результатов между узлами. -
Вопрос: Как Trino обеспечивает доступ к внешним источникам без копирования?
Ответ: Через коннекторы, которые читают данные напрямую из источников и передают их операторам без физического копирования в кластер. Используется распределенный план и сплиты, что позволяет выполнить запрос на стороне источников. -
Вопрос: Что такое spool-подход и какие преимущества он приносит?
Ответ: spool-подход - это протокол спулинга, когда результаты записываются в объектное хранилище кластера и клиент получает URL-адреса сегментов. Преимущества: повышенная пропускная способность и более быстрое завершение запросов, особенно для больших наборов данных. -
Вопрос: Какие сектора бизнеса наиболее активно применяют Trino?
Ответ: Финансы, розничная торговля, промышленность и гос сектор - эти отрасли требуют кроссисточниковой аналитики без копирования данных и высокой скорости отклика. -
Вопрос: Какие требования к безопасности учитываются в конфигурациях коннекторов?
Ответ: Обеспечение безопасного доступа к источникам и схемам, хранение учетных данных в защищенных хранилищах, TLS, контроль доступа на основе ролей, аудит и мониторинг. -
Вопрос: Какие преимущества дает возможность отображать нереляционные структуры как табличные данные?
Ответ: Позволяет писать единый SQL-запрос к различным источникам без жесткой привязки к формату данных; упрощает аналитические конвейеры и обеспечивает переносимость запросов. -
Вопрос: Каковы ключевые элементы архитектуры Trino?
Ответ: Координатор, рабочие узлы, коннекторы, каталоги, драйверы, обмены данных и механизмы планирования, формирования и выполнения запросов. -
Вопрос: Какие сценарии использования связаны с Data LakeHouse?
Ответ: Интеграция озер данных и транзакционного хранения, поддержка ACID на уровне источников, анализ без копирования и контроль версий данных. -
Вопрос: Какие факторы влияют на выбор режима протокола доступа к данным?
Ответ: Объем результирующих данных, требования к пропускной способности, доступность внешних хранилищ, поддержка клиентских драйверов и инфраструктура кластера. -
Вопрос: Как Trino обеспечивает безопасность при работе с коннекторами?
Ответ: За счет конфигураций каталога, политики доступа, шифрования данных в пути и в покое, а также аудита логов запросов и операций. -
Вопрос: Какие направления обучения полезны для специалистов, работающих с Trino?
Ответ: Курсы по TRINO, архитектуре MPP, конфигурациям коннекторов, протоколам доступа к данным, безопасности, мониторингу и интеграции с Kafka и озерами данных. -
Вопрос: Какие показатели мониторинга следует поддерживать для устойчивой работы Trino?
Ответ: latency и throughput запросов, нагрузка на сеть и память, процент ошибок, длительность стадий и агрегаций, показатели доступности узлов и обменов. -
Вопрос: Какие преимущества обеспечивает интеграция Trino с Kafka?
Ответ: Возможность обработки потоковых данных в SQL-форме, объединение с данными из озер и реляционных источников без копирования, поддержка реального времени и аналитических конвейеров. -
Вопрос: В чем основное отличие spool-подхода от прямого протокола?
Ответ: spool-подход использует объектное хранилище и повышает пропускную способность, а прямой протокол передает данные напрямую через сеть, чаще требует меньше настроек, но может быть менее эффективен на больших данных. -
Вопрос: Какие категории источников данных поддерживаются коннекторами Trino?
Ответ: Реляционные БД, NoSQL, озера данных, Data LakeHouse и потоковые платформы. -
Вопрос: Какой подход к моделированию схем обеспечивает гибкость при отображении нереляционных структур?
Ответ: Применение гибких схем, вложенных типов и представлений, а также денормализация для аналитических целей, чтобы писаться единый SQL против разных источников. -
Вопрос: Какие аспекты реализации снабжают возможность без копирования данных в кластере?
Ответ: Архитектура коннекторов и диспетчеризация сплитов, а также планирование, позволяющее считывать данные напрямую из источников и передавать их через операторы без передачи копий в хранилище кластера. -
Вопрос: Что следует учесть при выборе ближайшей даты для обучения TRINO?
Ответ: Наличие академических программ, потребности в квалификации сотрудников, план внедрения и доступность сотрудников на соответствующем периоде, а также организационные требования к обучению. -
Вопрос: Какие выводы можно сделать относительно применения Trino в будущей корпоративной архитектуре?
Ответ: Trino предлагает масштабируемую, гибкую и безопасную архитектуру для анализа внешних источников без копирования. В сочетании с spool-подходом, коннекторами и интеграциями с Kafka и озерами данных Trino обеспечивает эффективный единый аналитический слой, адаптируемый к текущим и будущим требованиям бизнеса и регламентациям.
Эта статья призвана предоставить целостную картину архитектуры Trino и ее практического применения. Разделы охватывают теоретическую базу MPP, детальное описание компонентов архитектуры, конфигурации и режимы работы с данными из внешних источников, а также реальные сценарии внедрения по секторам экономики и индустриальным кейсам. В контексте растущей сложности корпоративной аналитики особенно важно понимать, как архитектура Trino позволяет гибко строить консьюмерские конвейеры без копирования данных, обеспечивая при этом безопасность, управляемость и высокую производительность.