

Платформа Big Data: от стартапа до крупной технологической компании
Как развивалась платформа данных в компании Coupang
Coupang стремится провести революцию на рынке электронной коммерции, переосмыслив опыт мобильных покупок с помощью инновационных услуг, таких как доставка "последней мили". Для достижения этой цели сотрудники компании полагаются исключительно на решения, основанные на данных. Соответственно, для того, чтобы обеспечить соответствие серьезным требованиям в области масштабирования, доступности, параллелизма и быстрого роста объема данных, команда специалистов платформы Больших данных Coupang постоянно трудится над ее развитием и совершенствованием.
В этой статье мы расскажем Вам об эволюции платформы данных в Coupang, а также о дорожной карте будущих инвестиций компании.
Этап I: Реляционные базы данных (2010-13 гг.)
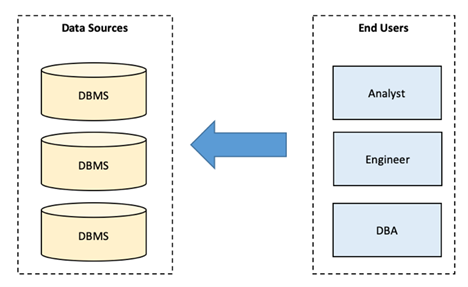
Как и многие другие начинающие компании, в первые несколько лет своего существования мы полагались исключительно на реляционные базы данных (MySQL и Oracle) и использовали их для хранения, обработки и получения данных. Учитывая относительно небольшой объем данных, которым мы оперировали в то время, такое решение вполне нас устраивало.
Однако, как только была сформирована команда Data Science & Platform, главной задачей которой был поиск тенденций в области данных, которые способствовали бы развитию бизнеса, количество запросов в сфере аналитики и число пользователей баз данных начало стремительно расти. В итоге скорость обработки всех запросов существенно снизилась, и нам пришлось выйти за рамки реляционных баз данных.
Примерно в это же время данные как дисциплина стали привлекать к себе все больше и больше внимания, во многом благодаря растущему объему инвестиций в данные со стороны крупных технологических компаний. Данные стали рассматриваться как неотъемлемый ресурс не только для традиционных бизнес-моделей, но и для новых приложений и сервисов, основанных на данных, которые становились все более популярными. Мы в Coupang также смотрели на платформы Big Data как на решение многих наших проблем.
Этап II: начало эпохи Big Data (2014-16 гг.)
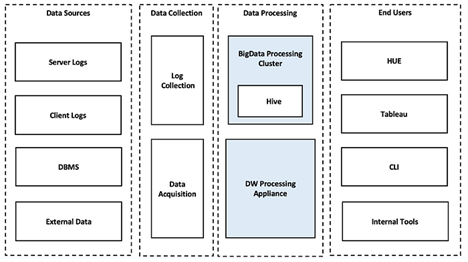
Поскольку существующие реляционные базы данных уже не справлялись с огромным объемом данных, компания Coupang приняла решение инвестировать в инфраструктуру Big Data, такую как Hadoop и базы данных с массивно-параллельной обработкой (MPP).
Чтобы эффективно использовать данные для принятия бизнес-решений, были разработаны приложения, основанные на данных, и сформированы необходимые отделы. Например, необходимо было регистрировать и собирать данные о взаимодействии с клиентами, которые впоследствии будут обрабатываться в инфраструктуре Big Data и использоваться в поиске, рекомендациях и аналитике клиентов. Для этого была создана команда по сбору логов. В конечном итоге именно эта команда и продвинула вперед инфраструктуру Coupang, обеспечив централизацию и доступность данных о клиентах. Данные стали играть еще более важную роль в развитии бизнеса, чем когда-либо прежде, будь то еженедельные обзоры деятельности компании (WBR) или еженедельное измерение основных показателей эффективности работы каждого отдела.
Ограничения
Однако по мере роста числа активных пользователей и запросов такие системы, как MPP, с ограниченными возможностями одновременного выполнения запросов начали серьезно тормозить рабочий процесс. Из-за таких ограничений Hive и MPP зависали с 8 утра до полуночи.
Еще одним проблемным местом стало оборудование, используемое для выполнения самых различных задач, включая оперативную отчетность, бизнес-аналитику, ETL и науку о данных. Некоторым пользователям приходилось выполнять свои самые важные запросы либо рано-рано утром, либо поздно вечером.
Кроме того, эта инфраструктура работала в локальных лабораториях, что затрудняло добавление узлов в кластеры и масштабирование. Несмотря на применение широкого спектра инженерных и процессных методов, большинство из них давали лишь временное облегчение, а инфраструктура данных все-равно была все время перегружена.
В быстро развивающейся компании постоянно растущий объем задач в области науки о данных и бизнес-аналитики требовал внедрения новой, более эффективной версии платформы данных. Столкнувшись с такими интересными задачами, мы, как команда разработчиков данных, увидели множество возможностей для потенциального роста.
Этап III: Перестройка и переход к долгосрочному решению (2016-17 гг.)
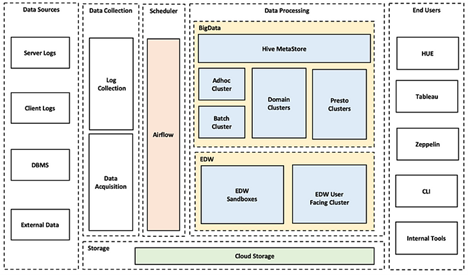
Для того, чтобы устранить все эти серьезные недостатки, в конце 2016-2017 годов мы перешли на облачную инфраструктуру. Наша команда перепроектировала платформу данных и перестроила несколько слоев для масштабирования в облако. Такое решение было основано на следующих факторах:
- Растущий трафик. Большая часть трафика на платформах электронной коммерции идет через поиск, что требует наличия инфраструктуры данных для сбора и обработки данных о взаимодействии клиентов с каталогами. Чтобы не нарушать работу поиска в часы пикового трафика, нам нужна была надежная и прочная инфраструктура данных, способная выдержать стремительный рост числа пользователей;
- Увеличение числа пользователей. По мере роста объема получаемых данных росло и число пользователей платформы, потребности которых были самыми разнообразными. Например, платформе Experimentation and Pricing нужны были Большие данные; финансовый отдел планировал объединить разнородные данные; маркетинговые команды нуждались в интеграции данных из социальных сетей. Наша платформа данных должна была удовлетворять потребности сотен пользователей, выполняющих тысячи запросов каждый день.
Учитывая эти два фактора, мы создали масштабируемую платформу данных, способную ответить на самые разнообразные запросы огромного количества пользователей.
Рассмотрим некоторые уровни нашей платформы данных более подробно.
Инфраструктура Big data
Используя Hadoop и другие инструменты для работы с Большими данными на основе контейнеров, мы масштабировали платформу данных в соответствии с растущими потребностями, позволяя пользователям обрабатывать большие объемы данных.
Сбор журналов
Сбор данных о взаимодействии с клиентами в мобильных приложениях и на веб-сайтах - обычная практика работы с данными в современном мире. В Coupang мы сосредоточились на том, чтобы можно было собирать и обрабатывать журналы действий пользователей для получения различных сведений о клиентах.
Корпоративное хранилище данных
Корпоративное хранилище данных (EDW) было перестроено в виде схемы «звезда» на базе облачных систем MPP.
Существовало три основных типа кластеров хранилища данных:
- Платформа сбора данных (Data Acquisition Platform,DAP): Транзакционные данные, используемые для отчетности и системных приложений, которым требуются исходные наборы данных, были перенесены в облачное хранилище данных под названием DAP;
- «Песочница» (Sandbox): поскольку многие команды хотели проводить специальный анализ, создавая собственные таблицы или наборы данных, мы предоставили им специализированные “песочницы”, содержащие наборы данных, необходимые каждой конкретной команде;
- Отчетность (Reporting): В этих кластерах, ориентированных на пользователя, хранились все производственные данные, которые использовались в запросах к данным.
В целом наша новая платформа Больших данных была легко масштабируемой и доступной и удовлетворяла потребности как наших клиентов, так и внутренних бизнес-пользователей.
Ограничения
Однако у платформа данных все еще были определенные недостатки в области параллелизма данных, масштабирования MapReduce и DW и качества регистрируемых данных:
- Операционные задачи, связанные с Большими данными. Каждая команда хотела иметь свой собственный кластер Hadoop, и по мере роста числа кластеров возникали операционные трудности, связанные с неэффективной практикой написания заданий на обработку данных, простаиванием кластеров и т. д.;
- Подрыв доверия к качеству данных. Из-за стремительного развития бизнеса и разработки соответствующих приложений у некоторых журналов не было четкой спецификации. Незамеченные изменения или ошибки зачастую подрывали доверие к качеству данных. Пришлось с нуля разрабатывать новую систему инструментария, чтобы вновь заслужить доверие к имеющимся данным.
Этап IV: Большие данные как сервис (2019 год - настоящее время)
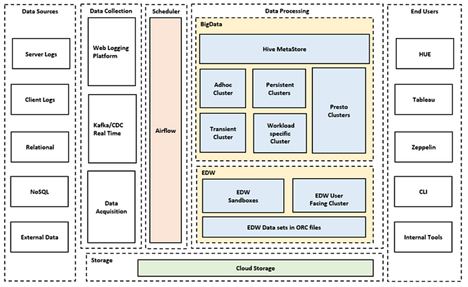
К 2019 году платформа данных была усовершенствована для обслуживания многочисленных бизнес-задач компании Coupang. Мы внедрили в существующую платформу данных и EDW различные политики и практики, которые позволили решить операционные проблемы, возникшие в связи с быстрым расширением бизнеса. Кроме того, мы разработали принципиально новый инструментарий веб-логирования, что позволило вернуть утраченное доверие к используемым данным. Новая платформа не только повысила эффективность работы, но и в разы увеличила производительность всех наших инженерных и операционных команд. Ниже мы подробнее расскажем о некоторых основных изменениях, которые мы внесли.
Инфраструктура Больших данных
Наша платформа для работы с Большими данными использует несколько типов кластеров Hadoop. За последние несколько лет нам пришлось полностью пересмотреть политику управления кластерами и стратегии развертывания, чтобы поддержать бурный рост нашего бизнеса. Чтобы гарантировать стабильность и масштабируемость платформы, мы внесли изменения в следующие области:
- Жизненный цикл кластера: Мы управляем кластерами Hadoop с различными жизненными циклами в зависимости от рабочей нагрузки. Жизненный цикл кластера жестко контролируется с учетом экономической эффективности и рабочих нагрузок. Кластеры разных типов имеют доступ к общему метахранилищу Hive и облачному хранилищу, благодаря чему все пользователи могут беспрепятственно использовать одни и те же таблицы Hive. Новая политика в бласти жизненного цикла позволила нам значительно повысить производительность и эффективность работы;
- Политика масштабирования: Раньше мы использовали автоматическое масштабирование, предоставляемое облачным сервисом, но оно не удовлетворяло все потребности потребителей данных. Поэтому мы дополнительно внедрили функцию масштабирования на основе расписания, которая увеличивает масштаб после анализа времени концентрации трафика. Смешанное использование масштабирования по расписанию и автомасштабирования значительно улучшило работу платформы;
- Резервный образ виртуальной машины: Нам нужно было установить на вычислительный аппарат кластера Hadoop различное программное обеспечение, включая ОС, Hadoop и экосистему, а также агенты мониторинга и безопасности. Мы создали образ виртуальной машины с необходимым программным обеспечением и различными плагинами, который управлялся с помощью Packer. Было подготовлено несколько различных образов виртуальных машин для разных рабочих нагрузок потребителя. После внедрения резервного образа машины время установки кластера сократилось более чем на 60 %.
Платформа для ведения веб-журналов
С первых дней деятельности Coupang корпоративная платформа для сбора данных о взаимодействии с клиентами основывалась на базе внешнего решения, которое было несовершенным и не обладало всеми необходимыми нам функциями. Поэтому многие доменные команды использовали еще один внешний сервис для расчета метрик и визуализации данных. Чтобы решить эту проблему, была разработана и внедрена совершенно новая платформа. После длительного и сложного процесса миграции и проверки эта новая платформа полностью заменила старую.
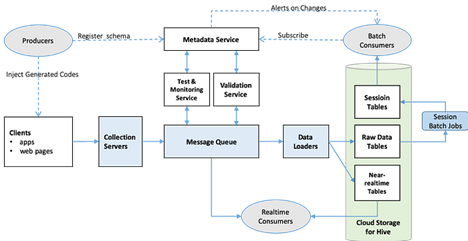
Вот достаточно простое решение, касающееся журналов. Сначала производители регистрируют схемы в службе метаданных. Обычно они генерируют (статически-типизированные) коды из схем и автоматически внедряют сгенерированный код в соответствующее приложение или веб-сайт, что позволяет значительно минимизировать человеческие ошибки. При выпуске клиенты создают реальные журналы для конвейера, где серверы сбора получают журналы и выдают сообщения в очередь сообщений. Затем загрузчики данных «потребляют» сообщения для сохранения в облачном хранилище. В качестве первых потребителей данных сеансовые пакетные задания создают сеансовые данные с дополнительными атрибутами для всех потребителей пакетных данных.
Давайте обсудим некоторые ключевые компоненты платформы для ведения веб-журналов:
- Конвейер сбора данных (серверы сбора, очередь сообщений, загрузчики данных): Используя управляемый сервис MQ от команды Platform Service, наша новая платформа протоколирования обеспечивает поток данных в режиме реального времени. Пользователи могут применять свою собственную логику SLA и ETL, используя очереди, предоставляемые WLP;
- Сервис метаданных: В новой платформе все данные журнала должны иметь зарегистрированную схему с владельцем и зарегистрированными потребителями. Этот единый источник истины о структуре данных является основой для других сервисов, таких как UI-коды производителей и запросы потребителей;
- Сервис валидации: Служба валидации проверяет каждый журнал в конвейере на соответствие схеме в службе метаданны, не вмешиваясь в процесс доставки данных. Результаты периодически сохраняются и сообщаются производителям и потребителям журналов; периодически в режиме реального времени запускаются оповещения;
- Служба тестирования и мониторинга: Новая платформа предоставляет сервис для отслеживания и проверки журналов любого пользователя или устройства как для QA-тестирования, так и для производства в режиме реального времени. Этот сервис также обеспечивает проверку на основе сценариев, проверяя семантику и синтаксис для QA-тестирования.
Хранилище корпоративных данных
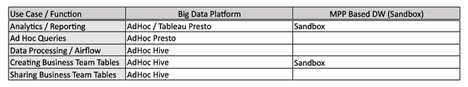
Среда хранилища основных данных нашей платформы данных состоит из файлов ORC, доступных через Hive/Hue и Presto/Zeppelin. Хотя среды DW на основе MPP (Sandbox) по-прежнему являются основным инструментом, предлагаемым пользователям EDW, они представляют собой лишь небольшое подмножество EDW. Их основная функция заключается в предоставлении среды, в которой пользователи могут создавать таблицы для управления своим доменом, которые, при необходимости, могут быть использованы для краткосрочной отчетности. Для долгосрочной отчетности или совместного использования пользователям рекомендуется перенести управляемые таблицы в файловые таблицы в облачном хранилище, что позволит повысить масштабируемость и надежность.
Субкомпоненты
Помимо улучшений в платформе Больших данных и платформе по ведению веб-журналов, в платформе данных Coupang появились и другие важные нововведения:
Проверка качества данных
Для проверки точности точность данных команда данных создала структуру, которая сравнивает количество строк и целые строки данных, используя HASH строки. В рамках технического тестирования мы также выполняем проверки DQ. Фреймворк также позволяет отдельным разработчикам подключать связанные с бизнесом SQL-запросы для дополнительной проверки точности данных. Кроме того, мы используем фреймворки с открытым исходным кодом для проверки ограничений или качества данных на основе пороговых значений, что особенно характерно для таблиц Больших данных.
Уведомление о нарушениях в данных
В нашей компании, полностью полагающейся на данные, своевременные уведомления о любых отклонениях в данных позволяют нам оперативно реагировать на неблагоприятную ситуацию. Data Notifier предупреждает нас об отклонениях в данных практически сразу же после их записи. Например, представьте, что в прошлом месяце была выпущена новая версия Coupang для Android, в которой была обнаружена ошибка в протоколировании, из-за которой данные не записывались должным образом. Раньше на то, чтобы заметить какую-либо потерю данных, уходило не менее трех дней, поскольку приходилось ждать, пока пользователи установят приложение. С Data Notifier любые аномалии можно обнаружить в течение двух часов после выпуска приложения.
Соглашение об уровне обслуживания (SLA)
Благодаря нашей новой платформе данных мы ежедневно отправляем пользователям уведомления по электронной почте, чтобы они знали, готовы ли их таблицы или нет. Кроме того, для того, чтобы повысить уровень обслуживания, мы работаем над созданием онлайн системы отчетов о соглашениях об уровне обслуживания, доступной абсолютно всем пользователям.
Инструмент для поиска данных (Data Discovery Tool)
С помощью данного инструмента пользователи могут отправлять теги и описания для таблиц или колонок в платформе данных. Эти метки и описания будут видны другим пользователям. Такой инструмент обеспечивает возможность самообслуживания при поиске данных, упрощает процесс поиска данных и в разы повышает производительность сотен пользователей платформы данных Coupang.
Система управления EDW
Система управления EDW - это фреймворк для создания и управления конвейерами данных, автоматизации сбора данных, а также автоматизации создания Airflow DAG с использованием метаданных. Кроме того, данный фреймворк выполняет функции мониторинга и обратного заполнения, что значительно повышает производительность работы с данными. Система управления EDW также предоставляет функцию быстрого обнаружения SLA для помощи инженерам, работающим по вызову.
Что дальше?
Благодаря многочисленным преобразованиям нашей платформы Big Data, проведенным в 2019 году, мы смогли предоставить нашим пользователям более эффективную и надежную систему управления данными и их обнаружения. Однако в Coupang и не думают останавливаться на достигнутом и активно смотрят по сторонам в поисках того, что же еще можно усовершенствовать и улучшить. Ниже мы расскажем о некоторых проектах, которые позволят вывести нашу платформу Big Data на совершенно новый уровень.
Слой абстракции Hadoop
В данный момент мы работаем над созданием слоя абстракции Hadoop, который упростит процесс отправки заданий и управление кластером Hadoop. С точки зрения конечного пользователя, данный слой устранит технические детали различных ресурсов Hadoop и предоставит простой интерфейс выполнения заданий (Airflow Operator, Python, Rest API) для отправки заданий Hive и Spark. Он также сможет контролировать ресурсы кластера Hadoop и выделять необходимое количество ресурсов для каждого задания, повышая эффективность системы в целом.
Мониторинг качества журналов
Функционирование журналов в приложении после его выпуска может измениться по самым разным причинам. Поэтому для обеспечения качества данных QA-тестирования на этапе релиза совершенно недостаточно. Для обеспечения безотказной работы QA мы разрабатываем полнофункциональный сервис мониторинга качества журналов, который выполняет все важные проверки логов на реальных устройствах с полной автоматизацией на протяжении всего жизненного цикла выпускаемых приложений. Более того, система мониторинга качества будет проверять качество атрибутов из нашего лог-конвейера, что повысит доверие к данным.
Обнаружение схемы
Служба метаданных - это единый источник истины для всех схем всех журналов. Схема журнала - это что-то вроде договора между производителями и потребителями, который обеспечивает доверие к данным журнала. Поэтому все потребители должны получать уведомления о любых изменениях в схеме журнала и о любых новых зарегистрированных схемах, которые еще не запущены в производство. Благодаря подобным уведомлениям потребители данных смогут ознакомиться с изменениями и подготовить свои последующие задания. Мы работаем над инструментом автоматического обнаружения схем на платформе для ведения веб-журналов, который будет собирать и анализировать запросы от потребителей, чтобы найти все связанные схемы и автоматически обновить их без непосредственного участия пользователей.
Заключение
Платформа Больших данных Coupang - это результат сотрудничества нескольких команд по всему миру, включая такие команды, как сама платформа Больших данных, корпоративное хранилище данных, платформа для ведения веб-журналов и управление техническими программами.
Наша концепция платформы Больших данных заключается в предоставлении интуитивно понятных и надежных инструментов для управления, обработки и визуализации данных в больших масштабах. В ближайшем будущем мы надеемся разработать инструменты, которые позволят нашим внутренним пользователям с легкостью создавать масштабные приложения для работы с данными и принимать качественные решения, основанные на данных.


