

Поиск, индексация и производительность каталога
Поиск и индексация являются сердцем корпоративного каталога данных: они превращают набор метаданных в инструмент быстрого обнаружения ценных активов, поддержания соблюдения норм и ускорения цифровой трансформации. Глава фокусируется на архитектуре поискового слоя, схемах индексации и практиках обеспечения высокой производительности в крупных data-платформах: от проектирования индексов до эксплуатации и мониторинга.
В современных условиях каталогов данные становятся быстро изменяющейся сущностью: новые источники metadata поступают из систем управления данными, репозитории кода, BI-инструменты и сервисы данных. Эффективный поиск требует не только инфраструктуры ускорения запросов, но и продуманной модели метаданных, обработки естественного языка и устойчивости к изменениям. Рассматриваемые подходы применимы к крупным корпоративным средам с разветвлённой экосистемой источников и потребителей.
- Архитектура поискового слоя и индекса
- Модели данных каталога и схемы индексации
- Поисковые алгоритмы, ранжирование и контекст
- Интеграции, протоколы доступа и производительность
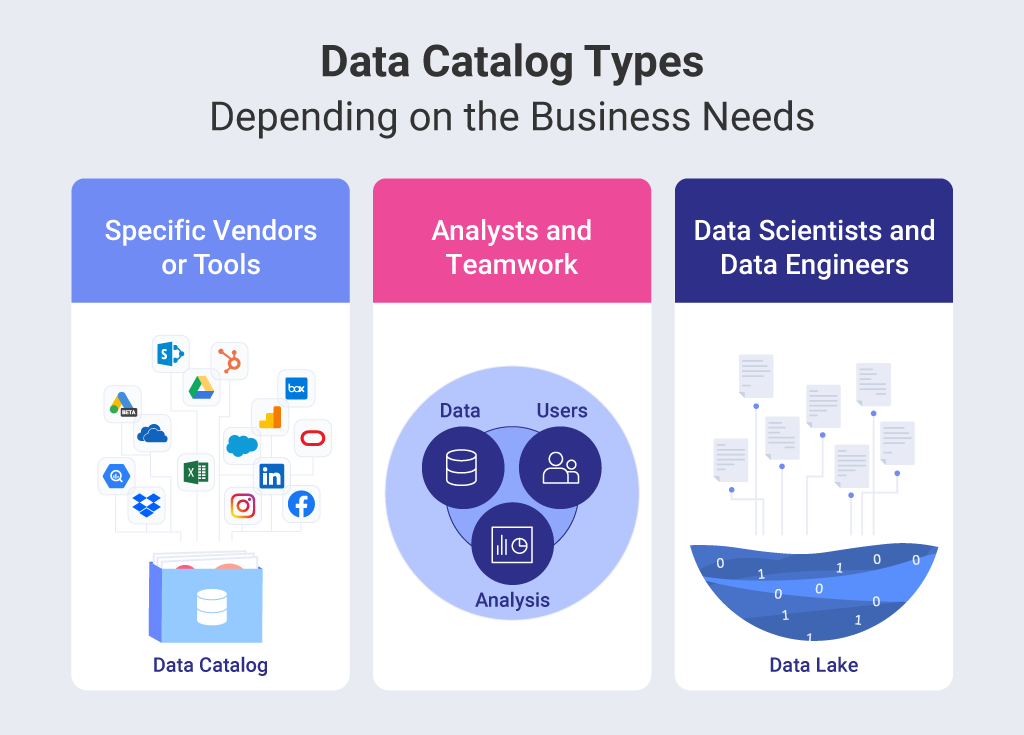
Архитектура поиска и индексации
Архитектура поискового слоя в каталоге данных представляет собой многоуровневую систему, где данные метаданных проходят через конвейер извлечения, трансформации и загрузки (ETL/ELT) и затем попадают в индекс, оптимизированный под быстрый поиск и гибкую фильтрацию. Типичная реализация строится на распределённом движке поиска (например, OpenSearch или Elasticsearch), который обеспечивает горизонтальную масштабируемость, высокую доступность и поддержку полнотекстового поиска.
Ключевые принципы архитектуры:
- Разделение обязанностей: источник метаданных и индексный слой. Метаданные собираются из источников (каталог источников, хранилища метаданных, BI-системы и пр.), валидируются и нормализуются перед попаданием в индекс.
- Инвертированный индекс как основа:инфраструктура поиска. В основе лежит инвертированный индекс: каждое слово или токен связывается с документами, содержащими его. Это обеспечивает очень быстрый поиск по фразам и по ключевым понятиям.
- Обеспечение согласованности и задержек. В корпоративной среде допустимо небольшое временное расхождение между обновлениями метаданных и их отражением в поисковом индексе. Важно иметь механизмы для обновления и повторной индексации при изменении моделей метаданных, а также возможность «горячего» обновления некоторых полей без полной переиндексации.
- Поддержка многообразия источников. Каталог должен собирать данные из разных систем: Hive Metastore, Data Catalog API корпоративной платформы, репозитории документов и т.д. Каждая источниковая система имеет свои особенности форматов, задержек и уровней доступа, что требует адаптивной стратегии интеграции.
- Репликация и шардинг. Для обеспечения устойчивости и низкой задержки чтения инфраструктура применяет шардинг индексов и репликацию. Правильная балансировка нагрузки между нодами и прозрачная маршрутизация запросов — залог устойчивой доступности.
- Кэширование запросов. Часто повторяющиеся запросы к каталогу становятся узкими местами. В качестве кэширования применяются локальные кэши на уровне API и распределённые кэши на уровне поискового слоя, с учётом времени жизни токенов и обновления индексов.
- Контекст и мультиязычность. В корпоративной среде часто встречаются данные на нескольких языках. Архитектура должна поддерживать языковые анализаторы, стемминг и лемматизацию для соответствующих языков, чтобы улучшить релевантность и полноту покрытия.
Стратегия интеграции поиска с существующей инфраструктурой предполагает:
- Выбор поискового движка с учётом Требований к латентности, объёма индекса и поддержки нужных анализаторов. В/open-source решениях доминируют Elastic/OpenSearch; в рамках гибридного подхода допускается использование альтернатив вроде Solr для отдельных проектов.
- Обеспечение безопасного доступа к данным индекса. Необходимо реализовать контроль доступа на уровне API и индекса, интеграцию с системами аутентификации и авторизации, а также аудит доступа к метаданным.
- Этапность ввода в эксплуатацию. Рекомендуется начать с ключевых доменов (например, бизнес-термины, наборы данных, критические активы) и затем наращивать покрытие, расширяя коннекторы и схемы индексации.
{
  "mappings": {
    "properties": {
      "id": {"type": "keyword"},
      "name": {"type": "text", "analyzer": "russian"},
      "description": {"type": "text", "analyzer": "russian"},
      "type": {"type": "keyword"},
      "owner": {"type": "keyword"},
      "created_at": {"type": "date"},
      "updated_at": {"type": "date"},
      "tags": {"type": "keyword"},
      "glossary_terms": {"type": "text", "analyzer": "russian"},
      "data_platform": {"type": "keyword"},
      "sensitivity": {"type": "keyword"},
      "source_system": {"type": "keyword"},
      "dependencies": {"type": "nested", "properties": {
        "ref": {"type": "keyword"},
        "relation": {"type": "keyword"}
      }}
    }
  }
}
В реальной среде архитектура может включать несколько индексов или шаблонов индексации под разные домены (например, объекты данных, термины бизнес-лексикона, политики доступа). В качестве примера можно рассмотреть использование «динамических шаблонов» для полей, которые варьируются между источниками, и статичных схем для наиболее критических объектов. В чисто техническом плане важно обеспечить стабильный режим обновления индексов: для критически важных активов — мгновенная переиндексация, для менее критичных — пакетная во время окна низкой нагрузки.
Модели данных каталога и схемы индексации
Модели данных каталога должны быть достаточно формализованными, чтобы обеспечивать точное сопоставление между объектами и их контекстами, но в то же время гибкими для быстрого внедрения новых типов метаданных. Основной подход — определить набор сущностей (assets) и их атрибутов, обеспечить связь между сущностями и поддержать эффективные запросы по атрибутам, тегам, фамилии владельца, источнику и контексту.
Ключевые принципы:
- Определение «ядра» и расширяемых полей. Ядро включает идентификатор, имя, тип, источник, владелец и временные метки. Остальные поля — расширяемые: описание, теги, термины из глоссария, зависимости, чувствительность и пр.
- Нормализация и денормализация. Для ускорения чтения в индексе чаще применяется денормализация: повторение ключевых контекстов (например, платформа данных) в каждом документе. Но для сложных связей лучше сохранять ссылки на внешние документы (nested или parent-child структуры).
- Поддержка контекста. Поиск должен учитывать контекст запроса: пользовательские роли, проектные пространства, лицензии и политика доступа. Этим достигается более релевантный отклик без раскрытия лишних данных.
- Релевантность и ранжирование. Релевантность определяется не только текстовым совпадением, но и контекстуальным фактором: свежесть данных, частота обновления, близость к домену пользователя и доверие к источнику.
Схемы индексации обычно строятся вокруг двух уровней:
- Инженерный индекс. Содержит технические поля, необходимые для точного поиска и фильтрации: id, type, source_system, created_at, updated_at, owner, tags, и т. п.
- Контекстный индекс. Содержит поля для расширенного поиска и ранжирования: name, description, glossary_terms, data_platform, dependencies, глубинные связи между объектами, отношение к данному активу.
{
  "mappings": {
    "properties": {
      "id": {"type": "keyword"},
      "name": {"type": "text", "analyzer": "russian"},
      "description": {"type": "text", "analyzer": "russian"},
      "type": {"type": "keyword"},
      "source_system": {"type": "keyword"},
      "owner": {"type": "keyword"},
      "created_at": {"type": "date"},
      "updated_at": {"type": "date"},
      "tags": {"type": "keyword"},
      "glossary_terms": {"type": "text", "analyzer": "russian"},
      "data_platform": {"type": "keyword"},
      "sensitivity": {"type": "keyword"},
      "dependencies": {"type": "nested", "properties": {
        "ref": {"type": "keyword"},
        "relation": {"type": "keyword"}
      }},
      "search_boost": {"type": "float"}
    }
  }
}
В рамках индекса логически целесообразно различать такие сущности, как наборы данных, таблицы, процессы обработки и бизнес-термины. Для каждого типа можно определить свой набор полей и спецификатор весов (boost) для повышения релевантности тех объектов, которые чаще запрашивает пользователь или которые связаны с критическими бизнес-процессами. Важным аспектом является поддержка тегирования и семантических связей между объектами: кастомизация политики индексации под отраслевые домены и внутреннюю терминологию.
Оптимизация моделей данных для секций каталога, которые чаще всего подвергаются поисковым запросам, делает существенно быстрее соответствовать требованиям пользователей. Например, для термино-семантики можно создавать отдельный слой глоссария и индексацию его терминов с привязкой к соответствующим активам, что позволяет быстро находить все данные, связанные с конкретным понятием.
Поисковые алгоритмы, ранжирование и контекст
Поиск в каталоге — это смесь полнотекстового поиска, фильтрации по структурированным полям и контекстуального ранжирования, основанного на бизнес-смысле. Эффективная система поиска должна поддерживать:
- Полнотекстовый поиск по имени, описанию и терминам. Использование языковых анализаторов (для русского языка — соответствующий анализатор с нормализацией, стеммингом и устранением общих слов) существенно повышает полноту покрытия.
- Фильтрацию по структурированным полям. Важно уметь быстро ограничивать результаты по источнику данных, платформе, уровню чувствительности, владельцу, времени обновления и другим атрибутам.
- Фасетный и контекстный поиск. Возможность группирования результатов по категориям, тегам и зависимостям, а также использование контекстной информации (активность пользователя, принадлежность к проекту) для улучшения релевантности.
- Ранжирование на основе контекста. Релевантность должна учитывать не только совпадение лексем, но и контекст: свежесть и качество метаданных, частота обновления, согласованность между объектами и их зависимостями.
Алгоритмические аспекты:
- Анализатор языка. Включает токенизацию, нормализацию и устранение шумов. В русскоязычном контексте применяются лингвистические анализаторы, поддерживающие склонение и регистрацию имен собственных.
- Токены и нормализация. Разумная настройка денормализации и привязки синонимов помогает объединить запросы пользователей к одному набору объектов.
- Ранжирование. Комбинация разных факторов: релевантность текстового совпадения, доверие к источнику, качество и полнота метаданных, свежесть, близость к домену пользователя. Часто применяется линейная комбинация весов с настройкой через A/B-тестирования.
- Контекстная фильтрация. Включение политик доступа, проектов и ролей пользователя в ранжирование позволяет защитить конфиденциальные данные и снизить шум.
Практические подходы к реализации:
- Использование предикатов и фильтров для ускорения выполнения поисковых запросов. Разделение запросов на две фазы: предварительная фильтрация по структурированным полям, затем полнотекстовый поиск по оставшимся документам.
- Расширенные возможности индекса. Добавление полей-«суффиксов» и объектов со связанными документами позволяет проводить более точный поиск по зависимостям и связям между элементами каталога.
- Поддержка синонимов и мультиязычного запроса. Включение синонимных словарей и настройка несколькими языковыми анализаторами улучшает результаты поиска в многоязычных средах.
- Мониторинг релевантности. Встроенная аналитика по кликам, времени на страницу и конверсии позволяет корректировать веса полей и состав индекса.
Кодовый пример: конфигурация ранжирования в индексе может включать поле search_boost для критически важных активов. Ниже пример JSON-объекта, который может использоваться в конфигурации ранжирования:
{
  "query": {
    "function_score": {
      "query": { "match": { "description": "показатели продаж" } },
      "boost": "5",
      "functions": [
        { "field_value_factor": { "field": "search_boost", "weight": 1.2, "missing": 1 } },
        { "filter": { "term": { "data_platform": "CRM" } }, "weight": 2.0 },
        { "filter": { "range": { "updated_at": { "gte": "now-90d/d" } } }, "weight": 1.5 }
      ],
      "score_mode": "sum",
      "boost_mode": "multiply"
    }
  }
}
Управление контекстом запроса и персонализация требуют осторожности: слишком глубокая персонализация может привести к «пузырю» информации, ограничивающему обзор. Поэтому архитектура должна поддерживать параметры запроса на уровне API с предопределёнными режимами (общий, региональный, проектный), чтобы не нарушать принципы прозрачности и соблюдения политики доступа.
Интеграции и протоколы доступа
Интеграция каталога поиска с внешними системами — это комплекс мероприятий, включающий обмен метаданными, обеспечение актуальности индекса и безопасный доступ к данным. Важными аспектами являются:
- API-совместимость. Каталог должен поддерживать открытые REST/GraphQL API для запросов данных, обновления метаданных и администрирования. API-декоративные слои позволяют внешним системам легко взаимодействовать с индексами и получать релевантные данные.
- Аутентификация и авторизация. В рамках корпоративной инфраструктуры применяются SSO, OAuth2 или OIDC, а также поддержка ролей и политик доступа. Прозрачная интеграция с IAM-системами обеспечивает соответствие требованиям к безопасности и конфиденциальности.
- Коннекторы к источникам. Для эффективной индексации необходимы коннекторы к Hive Metastore, системам управления данными, репозиториям метаданных, BI-платформам и сервисам документирования. Коннекторы должны поддерживать механизм «изменение по событию» (CDC) и «пакетная загрузка» на разных скоростях.
- Инфраструктура индексов. В зависимости от размера организации и скорости изменений используется горизонтальное масштабирование, включая разделение по доменам (data domain), пространствах проектов и уровням доступа. В некоторых случаях применяются отдельные инстансы для исходных систем и для целевого индекса каталога.
- Мониторинг и аудит. Оперативный мониторинг индексов, журналирование операций и аудит доступа необходимы для соответствия регулятивным требованиям и внутренним политикам прозрачности.
Пример интеграционного сценария:
- Интеграционный коннектор собирает метаданные из Hive Metastore, преобразует их в единый формат и отправляет в индексный слой через конвейер событий.
- При каждом обновлении метаданных запускается процесс повторной индексации соответствующего документа, чтобы сохранить актуальность информации в каталоге.
- Клиентское приложение выполняет запросы через REST API, применяя политики ограничений и распределяя нагрузку между нодами индексного кластера.
Безопасность и управление доступом в рамках поискового слоя требуют чётких границ: даже если пользователь имеет доступ к конкретной сущности в каталоге, поиск не должен раскрывать данные за ограниченной областью без соответствующих прав. Это достигается за счёт интеграции с политиками доступа и проверки разрешений на уровне каждого запроса, включая фрагменты фильтрации, применяемые к индексу.
Производительность, мониторинг и устойчивость
Производительность каталога определяется не только временем отклика поискового запроса, но и способностью поддерживать высокую пропускную способность индекса и устойчивость к сбоям. Основные направления:
- Масштабирование. Горизонтальное масштабирование индексов и нод OpenSearch/Elasticsearch, динамическая перераспределения шардов и реплик, контроль за нагрузкой и латентностью.
- Кеширование и ускорение запросов. Локальные и распределённые кэши, хранение часто запрашиваемых фрагментов документов и результатов — снижают задержку и снимают давление с индексного слоя.
- Оптимизация конвейера индексации. Пакетная загрузка, параллелизация обработки и минимизация дельты между обновлениями источников и их отражением в индексе. Важно обеспечить устойчивость к перегрузкам и способность выдержать пики активности.
- Мониторинг производительности. Нормализация метрик: латентность запроса, скорость индексации, размер индекса, использование памяти, диск I/O, доля ошибок и доступность нод. Все эти параметры должны быть доступны через дашборды и алертинг.
Практические рекомендации:
- Настройка TTL и политика обновления. Установка разумного времени жизни полей, которые быстро изменяются, чтобы не перегружать индекс повторной индексацией. Для критически важных данных — более частые обновления, для менее динамичных — пакетная обработка.
- Тонкая настройка анализатора. Выбор языкового анализатора и конфигурации с учётом конкретного домена и языковых особенностей пользователей. В случае русскоязычных данных — тестирование и настройка корректной лемматизации и стемминга.
- Быстродействие запросов через маршрутизацию. Применение адаптивной маршрутизации запросов к нодам с меньшей нагрузкой и учёт политики доступа при явном разделе нагрузок.
- Стратегия резервного копирования и восстановления. Регулярное создание снимков индекса и тестирования восстановления в тестовой среде. Обеспечение быстрого восстановления критических данных в случае сбоя.
С точки зрения эксплуатации особенно важно обеспечить:
- Предсказуемые времена отклика: цель часто ставится в пределах 100–300 мс для обычных запросов и в пределах секунды для сложных полнотекстовых запросов.
- Высокую доступность. Резервирование и автоматическое переключение при сбоях, мониторинг критических узлов и резервирование сети.
- Гибкость к изменениям. Возможность быстро добавлять новые домены, новые атрибуты и новые анализаторы, не разрушая существующую инфраструктуру индекса.
Практические сценарии реализации: кейсы и примеры
- Развертывание каталога в крупной организации с несколькими источниками данных. В подобной среде эффективна стратегия «многоиндексности»: отдельные индексы для разных доменов (наборы данных, процедуры обработки, термины бизнес-глоссария) с унифицированной схемой метаданных. Это обеспечивает локальные оптимизации индексации и упрощает управление доступом к конкретным доменам.
- Инкрементная индексация и CDC. В условиях частого обновления метаданных, например, в системах управления данными, применение CDC коннекторов позволяет быстро отражать изменения в индексе. Важно минимизировать дельту между источником и индексом, а также обеспечить повторную индексацию, когда изменяются ключевые поля.
- Русскоязычный поиск и аналитика. Для корпоративной платформы с большим объёмом текстов на русском языке применяются анализаторы русского языка и тестированная конфигурация с учётом особенностей языка. В случаях, когда часть данных имеет латинский или смешанный язык, следует поддержать мультиязычный режим анализа с корректной нормализацией.
- Интеграции с внешними BI и хранилищами знаний. Применение RESTful API и механизмов аутентификации обеспечивает согласованный доступ к данным каталога для аналитиков и бизнес-пользователей, а также безопасную интеграцию с другими системами обмена данными.
- Управление качеством метаданных и политики качества. Внедрение процессов проверки качества метаданных на этапе входа и периодического аудита позволяет поддерживать высокую достоверность и полноту индексируемых атрибутов, что напрямую влияет на релевантность поисковых запросов.
Key takeaways
- Инвертированный индекс и распределённый поисковой движок — фундамент архитектуры каталога данных.
- Модели данных должны балансировать между нормализацией и денормализацией, обеспечивая скорость поиска и точность контекстной информации.
- Релевантность поиска строится из сочетания полнотекстового совпадения, контекста и политики доступа, с учётом рекомендаций по ранжированию.
- Интеграция с источниками метаданных требует продуманных коннекторов, CDC и подходов к обновлениям, обеспечивающих актуальность индекса.
- Производительность достигается через масштабирование, кеширование, оптимизацию конвейера индексации и мониторинг критических метрик.
- Безопасность и аудит доступа должны быть встроены в архитектуру на уровне запросов и индексов.
- Эффективная эксплуатация требует практик по тестированию, внедрению и эволюции индексации под новые домены и источники.
FAQ
1) Что такое каталог данных в контексте поиска и индексации?
- Каталог данных — это единая платформа метаданных, которая обеспечивает поиск, описание и взаимосвязи между активами данных, их источниками, владелицами и контекстом использования. Поиск в каталоге опирается на инвертированный индекс и схемы индексации, позволяя быстро находить данные по названиям, описаниям, терминам и структурированным атрибутам.
2) Какие главные параметры влияют на производительность поиска?
- Основные параметры: размер индекса, конфигурация шардирования, уровень репликации, настройки анализаторов, политика кэширования, частота обновления индекса и эффективность коннекторов к исходным системам. Важна балансировка между временем индексации и временем задержки поиска.
3) Какую роль играет анализатор языка и как выбрать подходящий?
- Анализатор языка формирует токены, нормализует слова и удаляет шумы. Для русского языка критично выбрать анализатор с поддержкой лемматизации, стемминга и корректных правил знаков препинания, чтобы обеспечить устойчивую релевантность и полноту результатов. В рамках OpenSearch/Elasticsearch можно использовать готовые аналайзеры и настраиваемые словари.
4) Как обеспечить корректную защиту данных в процессе поиска?
- Корректная защита достигается синхронной интеграцией с системами аутентификации и авторизации (SSO/OIDC), применением политик доступа к уровням индекса и фильтров на уровне API. Важна аудит операций и возможность ограничения вывода данных для пользователей без требуемых прав.
5) Какие практики применяются для интеграций с источниками метаданных?
- Практики включают: коннекторы к системам хранения метаданных, CDC-синхронизацию изменений, конвейеры ETL/ELT, единый формат входящих данных и унификацию схем. В случае больших организаций целесообразно реализовать несколько конвейеров для разных доменов, сохраняя единый контракт по полям и типам.
6) Как измерять релевантность и улучшать её со временем?
- Релевантность оценивается по кликам, времени на страницу и конверсиям. Регулярно проводят A/B-тестирования вариантов ранжирования и признаков, применяют машинное обучение для адаптивной настройки весов полей, а также корректируют анализаторы и словари в зависимости от реального поведения пользователей.
7) Какие риски существуют при массовой индексации и как их снизить?
- Риски включают перегрузку индекса во время пиков активности, задержки обновления метаданных и неправильную маршрутизацию запросов. mitigations: контроль нагрузки через очереди и rate limiting, стратегию incremental updates, мониторинг latency checks нод, резервирование и документирование процессов восстановления.
8) Какую роль играет безопасность при интеграции с источниками данных?
- Безопасность должна быть встроена с самого начала: безопасные каналы передачи, контроль доступа к данным, шифрование в покое и в передаче, а также аудит. Важно аккуратно управлять правами на уровне метаданных и avoid leakage through search results.
9) Может ли каталог поддерживать мультиязычный поиск и термины?
- Да. Реализация мультиязычного поиска требует поддержки нескольких языковых анализаторов и мультиязычных глоссариев, синхронизированных с доменными терминами. Это особенно полезно в глобальных организациях, где данные и пользователи работают на разных языках.
10) Как подготовиться к масштабированию каталога в будущем?
- Необходимо заранее спроектировать архитектуру индекса с учетом роста данных, добавить горизонтальное масштабирование, обеспечить модульность коннекторов и реализацию унифицированной политики обновления. Помимо этого полезно внедрять процессы DevOps для развёртывания и обновления, автоматизацию тестирования и практики инфраструктуры как кода.
Глава охватывает ключевые аспекты поиска, индексации и производительности каталога в корпоративной data-платформе. Приведённые принципы и практики позволяют создать устойчивый, масштабируемый и безопасный инструмент для обнаружения активов данных, поддержки соблюдения норм и ускорения цифровой трансформации.


