

Сравнение аналитических in-memory баз данных
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: Дмитрий Павлов @kapustor
В последние два месяца лета в управлении хранилищ данных (Data Warehouse, DWH) Тинькофф Банка появилась новая тема для кухонных споров.
Всё это время мы проводили масштабное тестирование нескольких in-memory СУБД. Любой разговор с администраторами DWH в это время можно было начать с фразы «Ну как, кто лидирует?», и не прогадать. В ответ люди получали длинную и очень эмоциональную тираду о сложностях тестирования, премудростях общения с доселе неизвестными вендорами и недостатках отдельных испытуемых.
Цель тестирования — присмотреть себе быструю аналитическую in-memory базу данных, отвечающую нашим требованиям, и оценить сложность её интеграции с остальными системами хранилища данных.
Также мы включили в тестирование две СУБД, не позиционирующиеся как in-memory решение. Мы рассчитывали на то, что имеющиеся в них механизмы кэширования, при условии примерного соответствия объёма данных объёму оперативной памяти серверов, позволят этим СУБД приблизиться в производительности к классическим in-memory решениям.
Описание кейса использования
Предполагается, что выбранная в результате тестирования СУБД будет работать в качестве front-end БД хранилища для выборочного набора данных (2-4 Тб, однако объём данных может расти со временем): принимать на себя запросы от BI-системы (SAP BusinessObjects) и часть ad-hoc запросов некоторых пользователей. Запросы, в 90% случаев, это SELECT'ы c от 1 до 10 join-ами по условиям равенства и, иногда, условиям вхождения дат в интервал.
Нам нужно, чтобы такие запросы работали значительно быстрее, чем они работают сейчас в основной БД хранилища — Greenplum.
Также важно, чтобы количество одновременно выполняемых запросов не сильно влияло на время выполнения каждого запроса — оно должно быть примерно постоянным.
На наш взгляд, целевая БД должна обладать следующей функциональностью:
- горизонтальная масштабируемость;
- возможность выполнять локальные join-ы — использовать «правильный» ключ распределения в таблицах
- поколоночное хранение данных;
- умение работать с кэшем и большим объёмом доступной памяти.
Загрузка данных в целевую систему предполагается из основной БД хранилища — Greenplum, а потому для нас также важно наличие способа быстро и надёжно доставить данные (желательно, инкрементально) из Greenplum в целевую БД.
Также важна возможность интеграции с SAP BO. К счастью, с этой системой хорошо работает почти всё, что имеет стабильный ODBC-драйвер для Windows.
Из мелких, но весомых требований можно выделить оконные функции, резервирование (способность хранить несколько копий данных на разных нодах), простота дальнейшего расширения кластера, параллельная загрузка данных.
Стенд для тестирования
На каждую БД было выделено два физических сервера:
- 16 физических ядер (32 с HT)
- 128 Гб ОП
- 3.9 Тб дискового пространтства (RAID 5 из 8 дисков)
- Сервера связаны 10 Гбит-ой сетью.
- ОС для каждой БД была выбрана исходя из рекомендаций по установке этой самой БД. То же касается настроек ОС, ядра и прочего.
Критерии тестирования
- Скорость выполнения тестовых запросов
- Возможность интеграции с SAP BO
- Наличие быстрого и подходящего способа импорта данных
- Наличие стабильного ODBC-драйвера
- В случае, если продукт не распространяется свободно, удалось в адекватное время связаться с представителями компании производителя и получить инсталляцию (дистрибутив) БД, необходимую для тестирования
БД, вошедшие в тестирование
Greenplum
Старый, добрый, хорошо знакомый нам Greenplum. Строго говоря, Greenplum не является in-memory БД, однако экспериментально доказано, что за счёт свойств XFS, на которой он хранит данные, при определённых условиях он ведёт себя как таковая.
Так, например, при чтении, если количество памяти достаточно, а также если данные, запрашиваемые запросом, уже лежат в памяти (закэшированы), диски для получения данных затронуты не будут вообще — все данные Greenplum возьмёт из памяти. Надо понимать, что такой режим работы не свойственен для Greenplum, а потому специализированные in-memory DB должны (в теории) справляться с такой задачей лучше.
Для тестирования Greenplum был установлен по умолчанию, без зеркал (только primary-сегменты). Все настройки дефолтные, таблицы сжаты zlib.
Yandex Clickhouse
Колоночная СУБД для аналитики и отчётов в реальном времени от известного поискового гиганта.
СУБД установлена с учётом рекомендаций производителя, движок для локальных таблиц — MergeTree, поверх локальных таблиц были созданы Distributed-таблицы, которые и участвовали в запросах.
SAP HANA
HANA (High performance ANalytics Appliance) позиционируется как универсальный инструмент для аналитической и транзакционной нагрузки. Умеет хранить данные поколоночно. Имеются нужные для продуктовой базы Disaster recovery, зеркалирование и репликация. HANA позволяет гибко настроить партиции (шарды) для таблиц: как по hash, так и по интервалу значений.
В наличии многоуровневое партиционирование, на разных уровнях можно применять различные типы партиций. В одну партицию можно записать до 2 миллиардов записей.
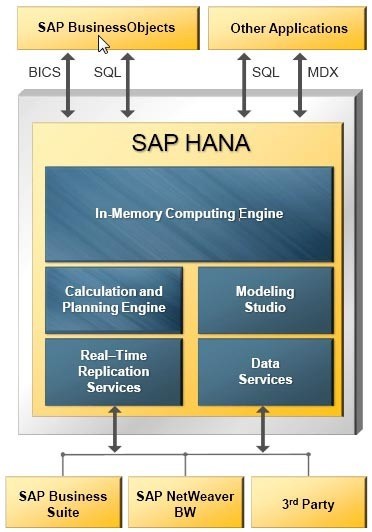
Архитектура решения на базе SAP HANA
Одна из интересных возможностей этой СУБД — потабличная настройка «unload priority» — приоритета выгрузки из памяти, от 1 до 10. Она позволяет гибко управлять ресурсами памяти и скоростью доступа к таблицам: если таблица используется редко, то ей устанавливается наименьший приоритет. В таком случае таблица будет редко загружаться в память и будет одной из первых выгружаться при нехватке ресурсов.
Exasol
Продукт в России практически неизвестный, тёмная лошадка. Из крупных компаний с этой СУБД работают только Badoo и ещё пара не-IT компаний, чьё имя на слуху — полный список есть на официальном сайте.
Вендор обещает феерически быструю аналитику, стабильность камня в лесу и простоту администрирования на уровне кофемолки.
Работает Exasol на своей ОС — ExaOS (свой дистрибутив GNU/Linux на основе CentOS/RHEL). Установка СУБД как минимум необычна, так как это не установка отдельного куска ПО на готовую ОС, а установка ОС на отдельную лицензионную машину (в нашем случае виртуальную) из скачанного образа и минимальная настройка (разбиение дисков, сетевые интерфейсы, разрешить загрузку по PxE) рабочих нод.
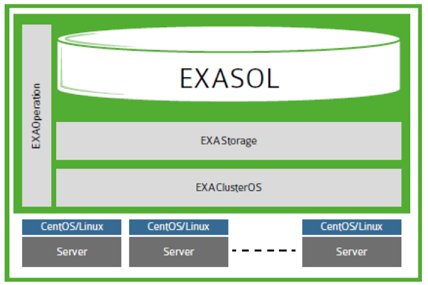
Упрощённая архитектура Exasol
Красота этой системы в том, что, так как на ноды ничего устанавливать не надо (ОС, параметры ядра и прочие радости), добавление новой ноды в кластер происходит очень быстро. С того момента, как сервер установлен и скоммутирован (bare-metal, без ОС), можно ввести ноду в кластер менее чем за полчаса. Все управление базой осуществляется через веб-консоль. Лишним функционалом она не перегружена, но и урезанной ее назвать нельзя.
Данные хранятся в памяти поколоночно и неплохо сжимаются (настроек сжатия при этом обнаружить не удалось).
Если при обработке запроса надо данных больше чем есть ОЗУ, база начнет использовать своп (спилл) на диски. Запрос не упадет (привет Hana и memSQL), просто будет работать медленней.
Exasol автоматически создает и удаляет индексы. Если вы делаете запрос впервые и СУБД решает, что с индексом запрос будет работать быстрее, то индекс будет создан в процессе отработки запроса. А если этот индекс 30 дней никому не был нужен, то база сама его удалит.
Вот какая умная лошадка.
Memsql
In-memory СУБД на основе mySQL. Кластерная, присутствуют аналитические функции. По умолчанию хранит данные построчно.
Чтобы сделать поколоночное хранение, нужно при создании таблицы добавить специальный индекс:
KEY `keyname` (`fieldaname`) USING CLUSTERED COLUMNSTORE
При этом rowstore-данные хранятся в памяти всегда, а вот columnstore-данные, в случае нехватки памяти, могут быть автоматически сброшены на диск.
Ключ дистрибуции называется SHARD KEY. Автоматически для каждого поля в shard key создается btree индекс.
Базовая версия — полностью бесплатная, без ограничений по объему данных и оперативной памяти. В платной версии есть high availability, онлайн бэкапы и ресторы, репликация между дата-центрами и управление правами пользователей.
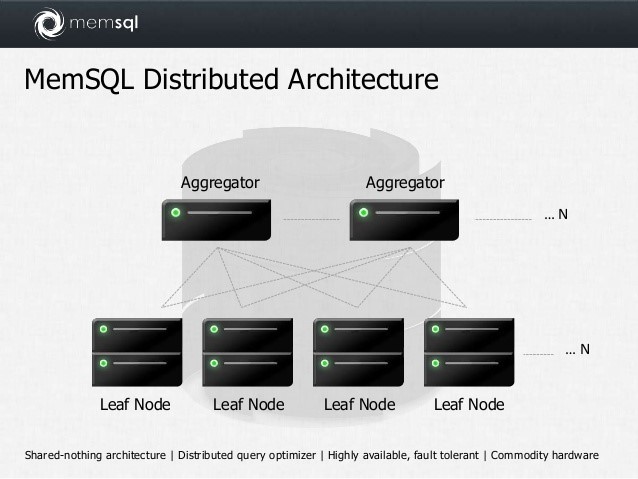
Упрощённая архитектура Memsql
Impala
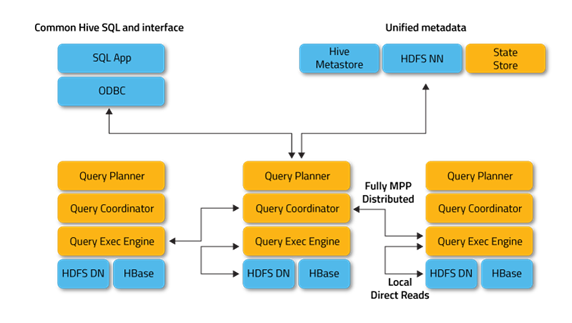
Продукт Cloudera, SQL движок, разработанный на С++, входит в экосистему Apache Hadoop. Работает с данными, хранящимися в HDFS и HBase. В качестве хранилища метаданных использует HiveMetastore, входящий в состав СУБД Hive. В отличие от Hive, не использует MapReduce. Поддерживает кеширование часто используемых блоков данных.
Позиционируется как СУБД для обработки аналитических запросов, требующих быстрого ответа. Умеет работать с основными BI-инструментами. Полная поддержка ANSI SQL, присутствуют оконные функции.
Impala доступна в виде пакета и парцела в репозитории Cloudera. При проведении тестирования использовался дистрибутив Cloudera CDH 5.8.0. Для установки был выбран минимальный набор сервисов для работы Impala: Zookeeper, HDFS, Yarn, Hive. Большая часть настроек использовалась по умолчанию. Для Impala было выделено суммарно 160 Гб памяти с обоих серверов. Для контроля утилизации ресурсов серверов контейнерами использовались cgroups.
Были выполнены все оптимизации, рекомендованные в статье, а именно:
- в качестве формата хранения таблиц в HDFS был выбран Parquet;
- оптимизированы типы данных, где это можно было сделать;
- предварительно выполнялся сбор статистики для каждой таблицы (compute stats);
- данные всех таблиц были записаны в кэш HDFS (alter table … set cached in …);
-
оптимизированы join’ы (насколько это было возможно).
На первоначальном этапе планирования тестирования и определения СУБД для участия Impala была отброшена, поскольку мы уже работали с ней несколько лет назад и на тот момент она не выглядела production-ready. Ещё раз посмотреть в сторону «Антилопы» нас убедили коллеги по отрасли, убеждая, что за прошедшее время она очень похорошела и научилась грамотно работать с памятью.
Ещё немного информации об Impala
Состав:
Impala Daemon – основной сервис, который служит для принятия, обработки, координирования, распределения по кластеру и выполнения запроса. Поддерживает интерфейсы ODBC и JDBC. Также имеет CLI-интерфейс и интерфейс для работы с Hue (Web UI для анализа данных в Hadoop). Выполняется в качестве демона на каждом из воркеров кластера.
Impala Statestore – используется для проверки состояния инстансов Impala Daemon, работающих в кластере. Если на каком-либо воркере выходит из строя Impala Daemon, то Statestore уведомляет об этом инстансы на остальных воркерах, чтобы запросы к ушедшему в offline инстансу не передавались. Как правило, работает на мастер-ноде кластера, не является обязательным.
Impala Catalog Server – этот сервис служит для получения и агрегации метаданных из HiveMetastore, HDFS Namenode, HBase в виде структуры, поддерживаемой Impala Daemon. Также этот сервис используется для хранения метаданных, используемых исключительно самой Impala, таких, например, как пользовательские функции. Как правило, работает на мастер-ноде кластера.
Некоторые важные для нас характеристики всех БД, собранные в одну таблицу на Google Docs
Результаты тестирования
Описание и текст тестовых запросов, используемых в тестировании
Результаты указаны в секундах выполнения запроса.
|
Запрос |
Greenplum |
Exasol |
Clickhouse |
Memsql |
SAP Hana |
Impala |
|
N1 |
14 |
< 1 |
- |
108 |
6 |
78 |
|
N2 |
131 |
11 |
- |
- |
127 |
Error |
|
N3 |
67 |
85 |
- |
- |
122 |
733 |
|
T1 |
14 |
1.8 |
64 |
70 |
20 |
100 |
|
T2 |
17 |
4.2 |
86 |
105 |
20 |
127 |
|
D1 |
1393 |
284 |
- |
45 |
1500 |
- |
|
D2 |
> 7200 |
1200 |
- |
> 7200 |
Error |
- |
Выявленные нюансы в работе БД
Yandex Clickhouse
В процессе тестирования выяснилось, что эта БД для наших задач не подходит — джойны в ней представлены только номинально. Так, например:
- поддерживается только JOIN с подзапросом в качестве правой части;
- условия в join-е не пробрасываются внутрь подзапроса;
- распределённые join-ы выполняются неэффективно.
Оказалось практически невозможным переписать «тяжёлые» запросы (N1-N3) на синтаксис Clickhouse. Также печалит ограничение по памяти — результат любого из подзапросов в любом запросе должен вмещаться в память на одном (!) сервере из кластера.
Несмотря на то, что для BI-задач эта БД оказалась непригодна, по результатам тестирования она нашла применение в хранилище в другом проекте.
Отдельно хочется отметить очень подробную и удобную документацию, доступную на официальном сайте (к сожалению, пока она покрывает не все аспекты использования БД), а также поблагодарить разработчиков Yandex за оперативные ответы на наши вопросы при проведении тестирования.
SAP HANA
Основную часть по настройке серверов и оптимизации запросов произвели коллеги из одной консалтинговых компаний, являющихся представителями SAP в России. Без них посмотреть на базу и оценить ее преимущества мы бы не смогли: как показала практика, для работы с HANA требуется наличие опыта.
Очень интересно показала себя HANA при подсчете количества строк join-а таблицы самой на себя:
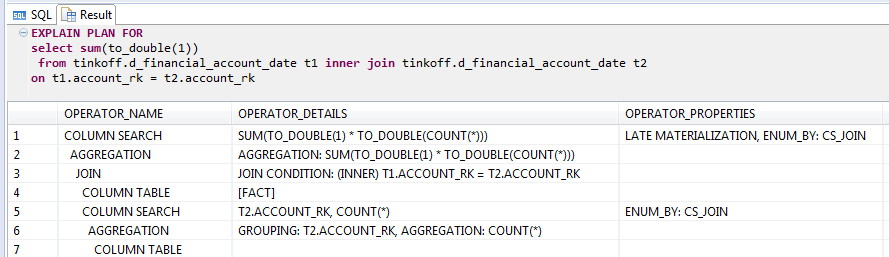
EXPLAIN запроса с join-ом таблицы самой с собой в HANA
Оптимизатор вычисляет результат с помощью статистики даже не выполняя join. Неплохой трюк, но если в where дописать условие, которое всегда True, например «1 = 1», то трюк не сработает и мы получим 25 минут, почти столько же сколько и у Greenplum.
На текущий момент HANA при выполнении запроса не умеет размещать промежуточные результаты запросов на диске. Поэтому если памяти не хватает, сессия обрывается, и пользователь остается без результатов.
Как выяснилось в процессе тестирования, даже при условии, что данные двух таблиц, участвующих в join-е, распределены по нодам кластера правильно, join по факту выполняется только на одной ноде кластера. Перед выполнением запроса данные со всего кластера просто переливаются на одну ноду и уже там происходит обсчет join-а. За отведенное под тестирование время победить такую логику и заставить join выполняться локально не смогли.
Кстати, производитель рекомендует по возможности использовать однонодовую конфигурацию БД, что и подтверждают результаты нашего тестирования – заставить конфигурацию из двух машин оптимально работать в разы сложнее, чем из одной.
Exasol
Главное впечатление от работы с базой — работает очень быстро и удивительно стабильно, прямо вот так, из коробки. Практически во всех наших тестах видно преимущество в скорости по сравнению с другими СУБД. Однако, в отличие от многих других СУБД, это черный ящик — у вас нет возможности даже подключиться к ноде по ssh и запустить iotop, htop и так далее. Отсутствие контроля своих же серверов, безусловно, заставляет напрячься. Хотя справедливости ради надо отметить, что все нужные данные по работе базы и нагрузке на железо есть в системных view внутри базы.
Имеются JDBC,ODBC драйверы, отличная поддержка ANSI SQL и некоторых специфических особенностей Oracle (select 1 from dual, как пример). Еще в БД уже встроены JDBC-драйверы для подключения к внешним базам (Oracle, PostgreSQL,MySQL и другим), что очень удобно для загрузки данных.
EXASOL позволяет посмотреть план только выполненных запросов. Это связано с тем, что план создается на ходу во время выполнения за счет анализа промежуточных результатов. Отсутствие классического explain работе не мешает, но с ним привычнее.
Быстрая, удобная, стабильная, не требует долгого тюнинга — поставил и забыл. В общем, какая-то вся правильная. Но черный ящик, что настораживает.
Отдельно хочется отметить адекватность поддержки, которая оперативно отвечала на абсолютно все наши возникшие вопросы.
Memsql
Ставится просто и быстро. Админка красивая, но не сильно толковая. Примеры: можно добавлять ноды в кластер, но удалять из админки нельзя/сложно/неочевидно; можно видеть текущие и завершенные запросы, но никаких подробностей о них увидеть нельзя.
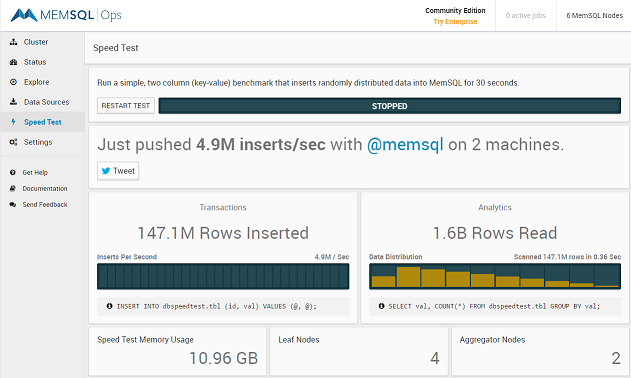
В админке memsql можно твиттить число записей в секунду
При работе MemSQL очень любит нагрузить процессоры, ошибок с переполнением памяти почти не было.
MemSQL перед тем, как соединить две таблицы, делает repartitioning (перераспределение данных по нодам) по ключу join-а.
В нашем случае мы можем таблицу data_bal и date хранить со сложным shard key (account_rk, valid_from_dt), для scd-таблицы ключ шардирования будет (account_rk, scd_valid_from_dt). Соединением между data_bal и date в таком случае будет происходить быстро, далее при выполнении запроса данные будут перераспределены по account_rk и scd_valid_from_dt, и на следующем шаге уже по account_rk для соединения с таблицей financial_account. Как уверяет поддержка, repartitioning – это очень затратная по времени операция.
Таким образом, наши запросы оказались тяжеловатыми для базы из-за большого количества разноплановых join-ов. В Greenplum join-ы между перечисленными таблицами происходят локально, и, соответственно, быстрее, без перераспределения по узлам, так называемого Redistribute Motion.
В целом, MemSQL видится отличной СУБД для миграции с MySQL и не самой сложной аналитики.
Impala
Установка кластера Cloudera, в состав которого и входит Impala, достаточно проста и хорошо задокументирована.
Однако, стоить отметить, что скоростью работы Impala относительно других БД не отличилась — к примеру, запрос, который подсчитывал count(*) в d_financial_account_not_additive, работал в Impala 3,5 минуты, что значительно больше, чем у соперников, у которых результаты — это десятки секунд и меньше.
Также мы провели интересный эксперимент: как было написано ранее, во view d_financial_account_not_additive есть два join-а. В каждом из них происходит соединение по account_rk с типом данных integer, а также по полям с типом данных дата. В Impala нет типа данных date, поэтому мы использовали timestamp. Ради интереса была сделана замена timestamp на bigint, в котором хранился unix timestamp. Результат запроса сразу улучшился на минуту. На следующем шаге данные из account_rk и поля с датой, это valid_from_dt и scd_valid_from_dt, были объединены, чтобы обеспечить join только по одном полю. Это было сделано нехитрым способом:
account_valid_from = account_rk * 100000 + cast(unix_timestamp(valid_from_dt)/86400 as int)
Join по одному полю дал нам еще около полуминуты выигрыша, но в любом случае это в несколько раз больше чем у других СУБД.
Основные запросы работали в несколько раз дольше. Запрос N2 падал из-за нехватки памяти, поэтому по нему нет результатов.
На текущий момент в Impala отсутствует распределение данных по узлам с hash-распределением, поэтому для используемых запросов мы вряд ли бы получили хорошее время выполнения.
Вместо заключения
Мы сознательно не хотим делать вывод из результатов тестирования вида «база А показала себя хорошо в том-то и том-то, а база Б — умеет твитить из админки в том-то и том-то, поэтому А лучше Б», предоставив это читателям. Надеемся, данный текст поможет кому-то открыть для себя новые продукты на рынке СУБД для ETL и BI, а кому-то — принять окончательное решение в выборе.
Эксперимент считаем состоявшимся, на основе его результатов, учитывая всё множество критериев, в данный момент выбираем СУБД для использования в BI-проекте.
Статья публикуется от имени четырёх человек, проводивших тестирование:
— Максим Белоусов
— Дмитрий Немчин (aka 4etvegr)
— Георгий Безруких
— Дмитрий Павлов (aka kapustor)
Иллюстрации, так чудесно описавшие тестируемые БД, взяты из концепта Virtua Hamster (так и не вышедшая игра для Sega 32).
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: Дмитрий Павлов @kapustor


