

Стратегический выбор AI/ML стека в 2025 году: практическое руководство по построению эффективной инфраструктуры машинного обучения
Современный ML/AI стек превратился в сложную многоуровневую архитектуру, где ошибка на любом этапе может привести к значительным финансовым потерям и потере конкурентных преимуществ. В этом материале мы систематизируем наш практический опыт и предложим комплексный подход к построению AI-инфраструктуры, который позволит избежать распространенных ошибок и максимизировать эффективность ваших инвестиций в искусственный интеллект.
Согласно данным авторитетных исследований, внедрение AI в бизнес-процессы выросло с 50% до 72% всего за последний год. Это означает, что пока ваша команда оценивает преимущества различных фреймворков, конкуренты уже запускают промышленные решения на оптимизированных технологических стеках.
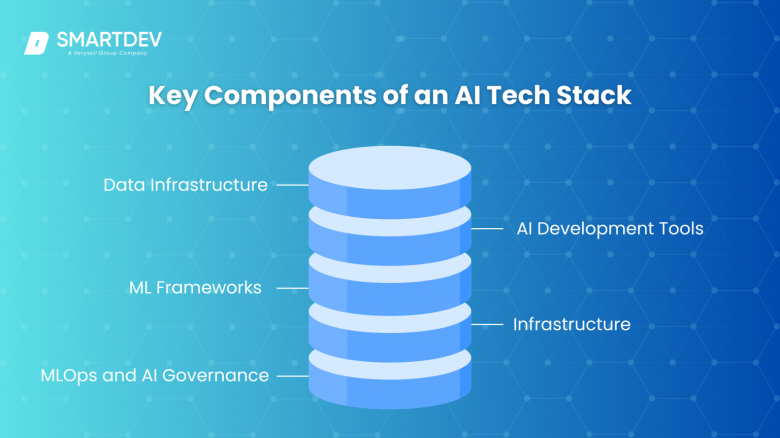
Основная проблема современного AI/ML ландшафта — не недостаток инструментов, а их избыточность. Современный стек представляет собой семиуровневую архитектуру, где каждый уровень предлагает десятки конкурирующих решений. Наша задача — помочь вам выбрать именно те компоненты, которые будут соответствовать вашим бизнес-целям и технологическим возможностям.
Любой разработчик знает, что между блокнотом Jupyter и реальным приложением лежит целая вселенная. Современный ML/AI стек - это многоэтажная сложная конструкция, где каждый этаж может сломаться от неправильно настроенной зависимости.
Слой данных: фундамент успешной AI-стратегии
Правило "garbage in, garbage out" остается актуальным как никогда. Слой данных — это основа, на которой строятся все последующие компоненты AI-системы.
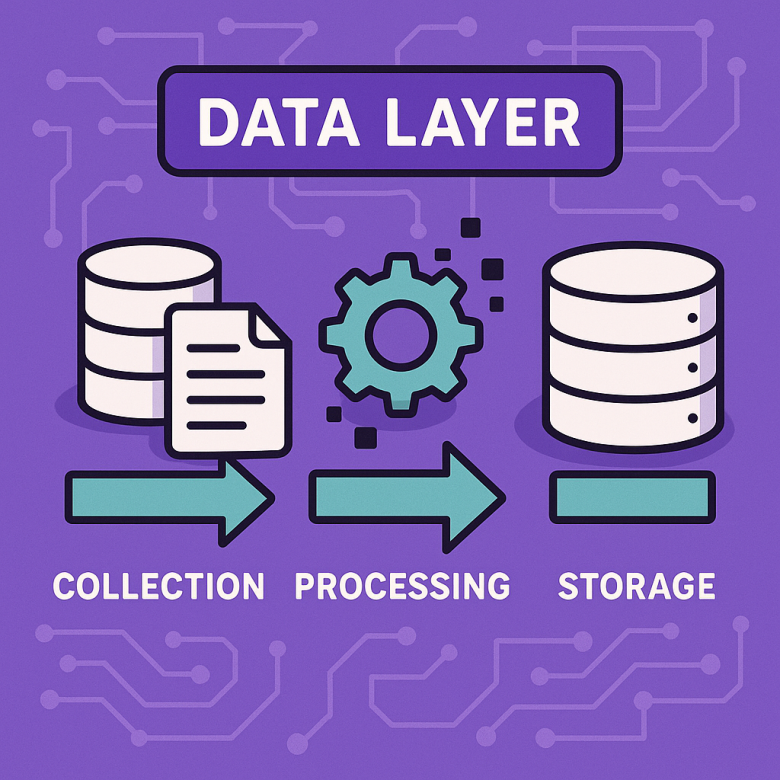
Современные ML-системы потребляют данные из множества источников: PostgreSQL для транзакционных данных, MongoDB для логов, Snowflake для аналитики, Kafka для потоковой обработки.
Для решения задачи интеграции данных мы рекомендуем следующие современные ELT-инструменты:
- Airbyte для open-source решений
- Fivetran для корпоративных клиентов
Критически важный аспект — версионирование данных и воспроизводимость экспериментов. В нашей практике мы используем комбинацию DVC для версионирования данных и MLflow для отслеживания экспериментов. Для комплексного решения задач управления ML-жизненным циклом мы рекомендуем ClearML, который предоставляет единую платформу для управления данными, моделями и экспериментами.
Примечание:
ClearML (ранее известный как Allegro Trains) — это open-source платформа с полным набором инструментов для MLOps (Machine Learning Operations). Её главная цель — помочь исследователям и инженерам по машинному обучению организовать, отслеживать, воспроизводить и автоматизировать весь жизненный цикл моделей ML/DL.
Проще говоря, ClearML — это ваш "единый центр управления" для всех этапов машинного обучения: от эксперимента на ноутбуке до развертывания модели в продакшене.
Без подобных инструментов ML-разработчики сталкиваются с хаосом, который состоит в:
- Потере экспериментов: "А какие именно гиперпараметры я использовал для той лучшей модели?"
- Невоспроизводимости: "Почему я не могу получить те же метрики, даже с теми же данными и кодом?"
- Сложности масштабирования: "Как запустить 100 экспериментов с разными параметрами и легко сравнить их?"
- "Стеной" между Research и Production: "Как перенести эту модель из Jupyter Notebook в работающее приложение?"
ClearML решает эти проблемы, предоставляя единую, интегрированную платформу.
Система состоит из двух основных частей:
- ClearML Server ("Серверная часть"): Это центральный хаб, который состоит из Web Server (веб-интерфейс для пользователя), File Server (хранит артефакты, модели, логии), API Server (обрабатывает запросы от клиентов) и Elasticsearch + MongoDB (для хранения метаданных и быстрого поиска).
- ClearML Python Package ("Клиентская часть") - небольшая библиотека, которую вы устанавливаете в свое окружение и добавляете в код. Она взаимодействует с сервером.
Простой пример работы
from clearml import Task
import argparse

# Инициализируем эксперимент
task = Task.init(project_name="My Project", task_name="My Experiment")

# Аргументы командной строки теперь автоматически логируются
parser = argparse.ArgumentParser()
parser.add_argument("--lr", default=0.001, type=float, help="learning rate")
args = parser.parse_args()

# Логируем кастомные метрики
for epoch in range(100):
    loss = 0.99 ** epoch  # Ваша реальная функция потерь
    accuracy = 1 - loss   # Ваша реальная точность
    logger = task.get_logger()
    logger.report_scalar(title="Metrics", series="loss", value=loss, iteration=epoch)
    logger.report_scalar(title="Metrics", series="accuracy", value=accuracy, iteration=epoch)

# Сохраняем и логируем модель
torch.save(model.state_dict(), "final_model.pth")
task.upload_artifact("trained_model", artifact_object="final_model.pth")

print("Готово! Результаты уже на вашем ClearML сервере.")
ClearML — это мощная, всеобъемлющая и при этом простая в использовании платформа MLOps. Если вы устали от хаоса в машинном обучении и хотите сделать свой workflow организованным, масштабируемым и воспроизводимым, то ClearML — один из лучших выборов на сегодняшний день, особенно благодаря своей open-source природе и сквозному охвату задач.
Вернемся к нашему основному обсуждению и приведем пример из нашей практики:
Для клиента из ритейл-сегмента мы реализовали систему версионирования данных на основе DVC, что позволило сократить время воспроизведения экспериментов с 2 недель до нескольких часов и значительно повысить согласованность результатов между средами разработки и производства.
Настоящее «веселье» начинается на этапе обработки. Pandas справляется со своими задачами, пока ваш датасет помещается в память. Как только речь заходит о терабайтах, приходится выбирать Apache Spark или Dask. Кстати, в ML-соревнованиях наметился один очень интересный тренд: все больше команд выбирают Polars — библиотеку на Rust, которая показывает очень хорошую производительность.
Feature stores вроде Feast решают следующую проблему: когда модель отлично работает в эксперименте, но в продакшене не так хороша. Причина проста — данные на тренировке и в продакшене обрабатываются совершенно по-разному!
К самым распространенным ошибкам на данном этапе стоит отнести несогласованность данных между средами разработки и производства, отсутствие стратегии версионирования данных, а также неоптимальный выбор инструментов обработки для конкретных объемов данных.
Слой моделирования: где искусственный интеллект встречается с реальностью
TensorFlow, PyTorch, scikit-learn — это классика, но 2025-й внес свои изменения.
Исследовательские лаборатории захвачены JAX, MONAI стал стандартом в медицинской визуализации, а SpeechBrain активно развивается в аудиоприложениях.
JAX — это библиотека от Google Research, которая ускоряет и обобщает численные вычисления в Python, особенно те, что распространены в машинном обучении и научных исследованиях. Это не просто еще один фреймворк для глубокого обучения, а скорее компилятор для численных вычислений, который сочетает в себе NumPy-совместимый API, автоматическое дифференцирование, JIT-компиляцию (Just-In-Time), векторизацию и параллелизацию и поддержку GPU/TPU.
JAX предоставляет модуль jax.numpy, который является почти полной заменой стандартного NumPy:
import jax.numpy as jnp
import numpy as np
# Код выглядит почти идентично NumPy
x_np = np.array([1., 2., 3.])
x_jnp = jnp.array([1., 2., 3.])
# Но операции могут выполняться на GPU/TPU
result = jnp.dot(x_jnp, x_jnp)  # Ускоряется на доступном hardware
JIT- компиляция - одна из самых мощных функций для ускорения:
import jax
def slow_function(x):
    # Какая-то сложная вычисления
    for i in range(1000):
        x = 0.99 * x + 0.01 * x ** 2
    return x
# Компилируем функцию для ускорения
fast_function = jax.jit(slow_function)
# Первый вызов компилирует функцию, последующие - быстрые
result = fast_function(jnp.array([1.0, 2.0]))
Важно: JIT-компиляция накладывает ограничения — функции должны быть "pure" (чистыми) без побочных эффектов.
JAX — это не просто еще один фреймворк для ML, а фундаментально другой подход к численным вычислениям. Он предоставляет мощные примитивы (grad, jit, vmap, pmap), которые можно комбинировать для создания высокопроизводительных вычислений.
Если вы готовы принять функциональную парадигму и нуждаетесь в максимальной производительности и гибкости, JAX может стать исключительно мощным инструментом в вашем арсенале. Для стандартных же задач прототипирования могут быть более удобны PyTorch или Keras.
MONAI (Medical Open Network for AI) — это open-source фреймворк на основе PyTorch, специально разработанный для задач медицинской визуализации. Он предоставляет специализированные инструменты для работы с 3D-данными, медицинскими форматами файлов и специфичными для медицины трансформациями данных.
Проект был создан для стандартизации и ускорения разработки AI-решений в медицинской визуализации.
MONAI предоставляет богатый набор трансформаций, учитывающих особенности медицинских данных, включает современные архитектуры, адаптированные для медицинских задач, предоставляет функции потерь, учитывающие особенности медицинских данных и легко работает с медицинскими форматами через monai.data.
Пример работы с реальными данными
from monai.apps import DecathlonDataset

# Загрузка датасета из медицинского конкурса
dataset = DecathlonDataset(
    root_dir="./data",
    task="Task01_BrainTumour",
    section="training",
    download=True,
    transform=train_transforms
)

# Автоматическая загрузка и предобработка медицинских данных
dataloader = DataLoader(dataset, batch_size=2, num_workers=4)
MONAI — это не просто обертка вокруг PyTorch, а полноценная экосистема для медицинского AI, которая решает специфические проблемы медицинской визуализации: стандартизирует процесс разработки моделей для медицины, ускоряет разработку за счет готовых компонентов, обеспечивает воспроизводимость исследований и оптимизирует работу с медицинскими данными и форматами.
Если вы работаете в области медицинского AI, MONAI значительно упростит ваш workflow, предоставив проверенные, оптимизированные и стандартизированные инструменты для всего цикла разработки — от предобработки данных до развертывания моделей.
SpeechBrain — это open-source проект на основе PyTorch, предоставляющий полный набор инструментов для разработки систем обработки речи. Это не просто библиотека, а end-to-end платформа для создания современных речевых приложений.
Проект создан с целью сделать передовые речевые технологии доступными для всех исследователей и разработчиков.
SpeechBrain позволяет строить полные пайплайны обработки речи от сырого аудиосигнала до финального результата, предоставляет сотни предобученных моделей через Hugging Face Hub, его библиотека построена вокруг понятия "мозга" (Brain) — абстракции для организации обучения.
В основном SpeechBrain используется в следующих случаях:
- Автоматическое распознавание речи (ASR)
- Идентификация и верификация говорящего
- Улучшение качества речи (Speech Enhancement)
- Синтез речи (Text-to-Speech)
- Классификация звуковых событий
- Распознавание эмоций по голосу
- Мульти-модальные системы (аудио + текст)
Пример полного приложения
import speechbrain as sb
from speechbrain.pretrained import SpeakerRecognition, EncoderDecoderASR

class VoiceBiometricsSystem:
    def __init__(self):
        self.asr_model = EncoderDecoderASR.from_hparams(
            source="speechbrain/asr-crdnn-commonvoice-en"
        )
        self.speaker_model = SpeakerRecognition.from_hparams(
            source="speechbrain/spkrec-ecapa-voxceleb"
        )
        self.registered_speakers = {}

    def register_speaker(self, speaker_id, audio_files):
        """Регистрация нового пользователя"""
        embeddings = []
        for audio_file in audio_files:
            emb = self.speaker_model.encode_file(audio_file)
            embeddings.append(emb)

        # Усреднение эмбеддингов
        self.registered_speakers[speaker_id] = torch.mean(
            torch.stack(embeddings), dim=0
        )

    def authenticate(self, audio_file):
        """Аутентификация по голосу"""
        # Распознавание речи
        text = self.asr_model.transcribe_file(audio_file)

        # Верификация говорящего
        current_embedding = self.speaker_model.encode_file(audio_file)

        best_score = -1
        best_speaker = None

        for speaker_id, registered_embedding in self.registered_speakers.items():
            score = self.speaker_model.similarity(
                current_embedding, registered_embedding
            )
            if score > best_score:
                best_score = score
                best_speaker = speaker_id

        return best_speaker, best_score, text

# Использование системы
system = VoiceBiometricsSystem()
system.register_speaker("user1", ["user1_voice1.wav", "user1_voice2.wav"])

speaker, confidence, transcript = system.authenticate("test_audio.wav")
print(f"Speaker: {speaker}, Confidence: {confidence:.3f}")
print(f"Transcript: {transcript}")
SpeechBrain — это мощная, но при этом простая в использовании платформа для разработки речевых технологий. Её основные преимущества – это быстрый старт (предобученные модели для всех основных задач), гибкость (легкое создание кастомных архитектур), производительность (state-of-the-art результаты и активное сообщество.
Если вы работаете с речевыми технологиями, SpeechBrain предоставляет идеальный баланс между простотой использования и мощностью, позволяя сосредоточиться на решении прикладных задач, а не на реализации низкоуровневых компонентов.
В целом, выбор фреймворка для построения моделей перестал быть предметом ожесточенных споров и превратился в инженерную задачу. На основе анализа 79 победных решений в ML-соревнованиях мы видим четкие тренды 47 решений использовали PyTorch против 4 на TensorFlow, 76 решений были реализованы на Python.
Современные тренды в моделировании в целом можно представить следующим образом: Transfer learning стал стандартом для большинства практических задач; методы эффективной оптимизации (LoRA, квантизация) позволяют сократить потребление ресурсов на 90%; для конкретных доменов появились специализированные фреймворки (например, MONAI для медицинской визуализации).
LoRA и квантизация — это два ключевых метода для эффективной работы с большими моделами.
LoRA — это метод параметрически-эффективной тонкой настройки больших моделей, особенно трансформеров. Основная идея: вместо тонкой настройки всех параметров модели, мы обучаем только небольшие "адаптеры", которые потом добавляются к оригинальным весам.
Основные преимущества LoRA:
- Эффективность памяти: Обучаются только адаптеры (0.1-1% от общего числа параметров)
- Быстрое обучение: Меньше вычислений градиентов
- Модульность: Можно иметь несколько адаптеров для разных задач
- Стабильность: Меньше риска катастрофического забывания
Пример:
Для клиента из финансового сектора мы применили технику LoRA для дообучения крупной языковой модели на специализированных финансовых документах. Это позволило сократить вычислительные затраты в 7 раз по сравнению с полным дообучением модели.
Квантизация — это метод сжатия моделей путем уменьшения точности представления чисел (обычно с 32-битных -точных чисел до 8-битных целых чисел).
Основные преимущества квантизации:
- Уменьшение памяти: 4x уменьшение для INT8, 8x для INT4
- Ускорение inference: INT операции быстрее на большинстве hardware
- Энергоэффективность: Меньше потребление энергии
- Доступность: Запуск больших моделей на hardware
В целом, LoRA и квантизация — это мощные методы, которые сделали работу с большими моделями доступной для широкого круга разработчиков.
LoRA позволяет эффективно адаптировать модели под конкретные задачи.
Квантизация делает возможным запуск больших моделей на consumer hardware.
Вместе они создают QLoRA — золотой стандарт для эффективной тонкой настройки
Эти технологии являются ключевыми для демократизации искусственного интеллекта и позволяют запускать state-of-the-art модели даже на скромном оборудовании.
Теперь рассмотрим основные риски слоя моделирования.
Во-первых, это выбор неподходящего фреймворка для конкретной задачи.
Во – вторых, это игнорирование современных методов оптимизации.
И, в – третьих, это недооценка важности воспроизводимости экспериментов.
Инфраструктурный слой: оптимизация вычислительных ресурсов
Инфраструктурные решения определяют экономическую эффективность ваших AI-инициатив. Наша статистика показывает, что более 80% победителей ML-соревнований используют GPU NVIDIA, причем A100 стала в два раза популярнее следующего по популярности GPU.
Ключевые компоненты инфраструктурного стека можно представить следующим образом:
- NVIDIA GPU с экосистемой CUDA
- Ray для распределенных вычислений
- Kubernetes + Kubeflow для оркестрации ML-workloads
Важно: Выбор между облачной и локальной инфраструктурой должен основываться на тщательном анализе долгосрочных затрат и требований к безопасности данных.
Слой обслуживания и мониторинга: промышленная эксплуатация моделей
Переход от эксперимента к промышленной эксплуатации — самый критичный этап AI-проекта. Наши рекомендации по технологиям обслуживания моделей следующие. Для REST API лучше всего использовать FastAPI; для комплексного управления моделями – BentoML, а для высокопроизводительных сценариев - NVIDIA Triton.
BentoML — это open-source платформа для создания, развертывания и масштабирования сервисов машинного обучения. Он решает ключевую проблему MLOps: как превратить обученную модель в надежный, масштабируемый production-сервис.
Главная философия BentoML: "Write once, run anywhere" — создайте сервис один раз и запускайте его где угодно.
BentoML упаковывает модель, код и зависимости в самодостаточный артефакт — Bento, создает API – сервисы и поддерживает практически все популярные ML-фреймворки.
В каких случаях используется BentoML:
- ML микросервисы используются для создания независимых сервисов для каждой модели
- Real-time inference — низколатентные предсказания
- Обработка больших объемов данных
- A/B тестирование моделей,одновременное развертывание нескольких версий
- Edge развертывание — запуск на периферийных устройствах
BentoML — это мощный, но при этом простой в использовании фреймворк, который решает ключевую проблему MLOps: как надежно перевести модель из стадии экспериментов в продакшен.
Его главные преимущества – это универсальность (работает с любыми ML-фреймворками), простота (минимальный код для создания production-сервисов), гибкость (множество вариантов развертывания), а также надежность (встроенные механизмы для использования в production).
Если вы ищете способ быстро и надежно развертывать свои ML-модели, BentoML — отличный выбор, который сэкономит вам много времени и избавит от головной боли с инфраструктурой.
В целом, мониторинг промышленных ML-систем должен включать традиционные метрики производительности (задержка, пропускная способность), обнаружение дрейфа данных и концептуального дрейфа, а также мониторинг качества предсказаний в реальном времени.
Пример:
Для e-commerce клиента мы недавно реализовали систему мониторинга дрейфа данных на основе Evidently AI, что позволило обнаруживать деградацию качества моделей на ранних стадиях и сократить потери от некорректных рекомендаций на 23%.
Типовые технологические стеки для различных бизнес-сценариев
На основе нашего опыта мы выделили несколько основных типов стеков, каждый из которых оптимален для конкретных бизнес-задач и организационных контекстов.
Python AI Stack: универсальное решение для исследований
Python AI Stack» — это набор библиотек и инструментов Python, которые образуют экосистему для разработки искусственного интеллекта, особенно для машинного обучения и глубокого обучения.
Основные тренды и выводы:
- для глубокого обучения выбирайте такие инструменты, как PyTorch/TensorFlow. PyTorch стал доминирующим фреймворком в исследованиях, а TensorFlow остается самым сильным в промышленном развертывании;
- для классического ML больше всего подойдет Scikit-learn. Главная библиотека для классического машинного обучения, включающая в себя реализацию алгоритмов (линейная регрессия, SVM, случайный лес, k-means и т.д.), инструменты для предобработки данных (StandardScaler, OneHotEncoder), метрики для оценки моделей + утилиты для разбиения данных на train/test и кросс-валидацию;
- для компьютерного зрения самый оптимальный вариант – OpenCV;
- для NLP больше всего подходит Hugging Face, предствляющий тысячи предобученных моделей для задач классификации, генерации текста, перевода и др.
Python AI Stack — это зрелая, мощная и быстро развивающаяся экосистема, которая делает Python лучшим языком для работы в области искусственного интеллекта. Особенно подходит для исследовательских команд, стартапов в области computer vision и NLP, а также для проектов с нестандартными алгоритмами.
Modern Full-Stack AI Stack: максимальная скорость разработки
Modern Full-Stack AI Stack — это современный набор инструментов для создания законченных AI-приложений — от прототипа до масштабируемого продакшена, где AI-модель является ядром продукта.
В отличие от "просто обучить модель", здесь речь идет о полноценной архитектуре приложения.
Вот ключевые компоненты современного Full-Stack AI стека:
- для frontend: Next.js + TypeScript + Vercel
- для доступа к языковым моделям больше всего подходит Together AI
- для бессерверной базы данных - Neon
Пример архитектуры современного Full-Stack AI приложения (Чат-бот с RAG)
Пользователь
    |
[Фронтенд: React + Vite]  <-> [Бэкенд: FastAPI на Python]
                                    |
                                    |-> [LangChain/LlamaIndex]
                                    |       |
                                    |       |-> [LLM: GPT-4 через API / Llama 3 локально]
                                    |       |
                                    |       |-> [Векторная БД: Weaviate] <-(запрос)
                                    |               ^
                                    |               | (индексирование)
                                    |       [Загрузчик документов: PyPDF, Unstructured]
                                    |
[Мониторинг: LangSmith] <-----------|
Поток данных организован следующим образом:
- Пользователь задает вопрос во фронтенде.
- Фронтенд отправляет запрос на бэкенд (FastAPI).
- Бэкенд, используя LangChain, формирует промпт.
- LangChain отправляет запрос в векторную БД (Weaviate) для поиска релевантных фрагментов из ваших документов.
- Найденные фрагменты и оригинальный вопрос отправляются в LLM.
- LLM генерирует контекстный ответ, который возвращается через бэкенд пользователю.
- Весь запрос и ответ логируются в LangSmith для отладки и анализа.
Данный стек позволяет создавать мощные, масштабируемые и поддерживаемые AI-продукты, а не просто "модель в Jupyter Notebook". Его основные преимущества, это в первую очередь, рекордная скорость прототипирования, встроенная AI-интеграция и минимальные операционные затраты.
Enterprise AI Stack: безопасность и соответствие требованиям
Enterprise AI Stack — это специализированная архитектура для внедрения AI в крупных организациях, где безопасность, соответствие требованиям и управляемость являются критически важными, часто даже более важными, чем чистая производительность модели.
Ключевые отличия Enterprise AI Stack от обычного:
|
Аспект |
Standard AI Stack |
Enterprise AI Stack |
|---|---|---|
|
Данные |
Открытые датасеты, публичные данные |
Конфиденциальные данные, PII, IP |
|
Безопасность |
Basic Auth, API Keys |
SSO, RBAC, Zero-Trust, Encryption |
|
Соответствие |
Не приоритет |
GDPR, HIPAA, SOC2, PCI DSS |
|
Развертывание |
Public Cloud, демо-серверы |
Private Cloud, On-Premise, VPC |
|
Стоимость |
Оптимизация за скорость |
Оптимизация за безопасность и compliance |
Основные тренды и выводы:
- Java Spring Boot + DJL (Deep Java Library) + корпоративные базы данных - выбор организаций, для которых соответствие требованиям и безопасность – главный приоритет;
- В данном случае крайне важна интеграция с существующими ERP/CRM системами
В целом, Enterprise AI Stack — это не просто технологический выбор, а стратегическая инвестиция в безопасное и ответственное использование искусственного интеллекта, которая защищает компанию от юридических, репутационных и финансовых рисков. Критически важно для ,анков, страховых компаний, организаций здравооранения и государственных проектов.
Edge AI Stack: обработка на устройстве
Edge AI Stack — это архитектура для запуска моделей искусственного интеллекта непосредственно на устройствах (пограничных устройствах), а не в облаке. Это фундаментально меняет требования к производительности, энергопотреблению и безопасности.
Основные тренды и выводы:
- для мобильных устройств наиболее часто выбирают TensorFlow Lite
- для кроссплатформенной оптимизации самым оптимальным вариантом является ONNX Runtime.
Edge AI Stack — это не просто "урезанная" версия облачного AI. Это отдельная, быстроразвивающаяся дисциплина, требующая глубоких знаний в hardware, embedded-системах и оптимизации, чтобы выжать максимум производительности из ограниченных ресурсов. Оптимален для IoT устройств, автономных систем, приложений с требованиями низкой задержки.
MLOps Stack: промышленное машинное обучение
MLOps Stack — это набор инструментов и практик для промышленной эксплуатации ML-моделей, где важны воспроизводимость, масштабируемость и надежность, а не только точность модели.
Основные тренды и выводы:
- для оркестрации процессов больше всего подходит сочетание Kubernetes + Kubeflow
- для управления жизненным циклом моделей - MLflow
- Автоматизированные CI/CD pipelines
Пример реализации пайплайна:
# Kubeflow Pipelines example
@dsl.pipeline
def ml_training_pipeline():
    # 1. Extract and validate data
    data_op = components.load_data()
    validation_op = components.validate_data(data_op.outputs['data'])

    # 2. Feature engineering
    features_op = components.create_features(data_op.outputs['data'])

    # 3. Model training with hyperparameter tuning
    train_op = components.train_model(
        features_op.outputs['features'],
        hyperparameters={'learning_rate': 0.01}
    )

    # 4. Model evaluation
    eval_op = components.evaluate_model(train_op.outputs['model'])

    # 5. Conditionally register model
    with dsl.Condition(eval_op.outputs['accuracy'] > 0.9):
        register_op = components.register_model(
            train_op.outputs['model'],
            eval_op.outputs['metrics']
        )
MLOps Stack превращает машинное обучение из "искусства" в инженерную дисциплину, где модели становятся надежными, масштабируемыми и управляемыми software components. Необходим для организаций с десятками моделей в production, требовательных к воспроизводимости и масштабируемости.
Стратегические рекомендации по выбору стека
На основе нашего опыта внедрения AI-решений мы сформировали ключевые принципы выбора технологического стека:
Во-первых стоит начинать с бизнес-задачи, а не с технологий. Четко определите, какую проблему вы решаете и для кого. Критична ли объяснимость решений или главное — производительность? Ответы на эти вопросы определяют архитектуру, а не модные технологии.
Во-вторых, реалистично оценивайте компетенции команды. Лучший стек бесполезен, если ваша команда не может его эффективно использовать. Оцените текущий уровень экспертизы и возможности обучения.
В-третьих, балансируйте между стабильностью и инновациями. Применяйте правило 80/20: основа стека должна состоять из проверенных компонентов, экспериментировать можно с 20% стека, которые не критичны для работы системы.
В-четвертых, инвестируйте в документацию и управление знаниями. Техническая сложность — не самая большая проблема ML-проектов. Создавайте дизайн-документы для каждого проекта с четким описанием задач, целей, рисков и метрик.
В – пятых, планируйте эволюцию с самого начала. Заложите возможности для масштабирования без преждевременной оптимизации. Контейнеризация через Docker решает проблемы совместимости и упрощает переход между окружениями.
В – шестых, учитывайте требования безопасности и соответствия. Безопасность нельзя добавить в конце разработки. Убедитесь, что ваш стек поддерживает шифрование, контроль доступа, маскирование данных.
И обязательно контролируйте расходы с первого дня. Планируйте устойчивость бюджета не только для фазы запуска, но и для долгосрочной эксплуатации. Балансируйте производительность и стоимость.
Будущее AI-стеков: подготовка к завтрашнему дню
Темп трансформации AI-стеков ускоряется с каждым днем. На основе анализа текущих трендов мы выделили следующие ключевые направления развития:
- AI-агенты становятся полноценными участниками разработки, способными самостоятельно выполнять сложные задачи
- AutoML фреймворки интегрируются прямо в MLOps конвейеры, ускоряя развертывание решений
- Edge AI перестает быть экзотикой благодаря компактным языковым моделям
- Объяснимый AI и инструменты управления моделями становятся обязательными требованиями
Выбор AI-стека — это стратегическое решение, определяющее успех ваших AI-инициатив на годы вперед.
Ваш стек должен эволюционировать вместе с вашим продуктом. Начинайте с минимально жизнеспособного стека и добавляйте сложность только когда это действительно необходимо.
Правильный выбор AI-стека — это баланс между скоростью разработки, производительностью, стоимостью и долгосрочной поддерживаемостью. Нет универсального решения, но есть методологический подход к выбору оптимального варианта для вашего контекста.
Не позволяйте сложности выбора технологий замедлить ваше движение к AI-лидерству. Обращайтесь к экспертам, мы с удовольствием поможем построить AI-инфраструктуру, которая станет конкурентным преимуществом вашего бизнеса.


