

Датасеты: фундамент успешного искусственного интеллекта. Полное руководство от экспертов
Датасет, или выборка данных, — это не просто набор разрозненной информации. Это тщательно структурированная и организованная коллекция данных, специально подготовленная для обучения, валидации и тестирования моделей машинного обучения. Именно на примерах из датасета алгоритм учится распознавать закономерности, принимать решения и делать прогнозы. Можно сказать, что датасет — это учебник, по которому учится искусственный интеллект. Качество этого учебника напрямую определяет, станет ли модель гениальным «отличником» или неспособным к практическому применению «двоечником».
Архитектура датасета
Любой датасет состоит из двух ключевых компонентов:
- Данные. Это непосредственно объекты исследования, сырая информация. В зависимости от задачи данные могут быть представлены в абсолютно любом формате: текстовые документы, фотографии и изображения, аудиозаписи, видеоролики, показания сенсоров, числовые таблицы и многое другое.
- Разметка (аннотации). Это метаданные, то есть дополнительная информация, которая описывает, классифицирует или поясняет сами данные. Разметка является опциональной, но для задач контролируемого обучения она необходима. Именно разметка превращает бессмысленный для машины набор пикселей или символов в обучающий пример.
Так, в случае изображений разметка — это ограничивающие рамки вокруг объектов, семантическая сегментация (выделение объектов), ключевые точки (например, суставы человека для позоопределения) или просто метка класса («кошка», «собака», «автомобиль»).
В случае такстов разметка включает выделение именованных сущностей (имена людей, названия компаний, локации, даты), определение тональности (позитивный, негативный, нейтральный отзыв), часть речи и синтаксические связи.
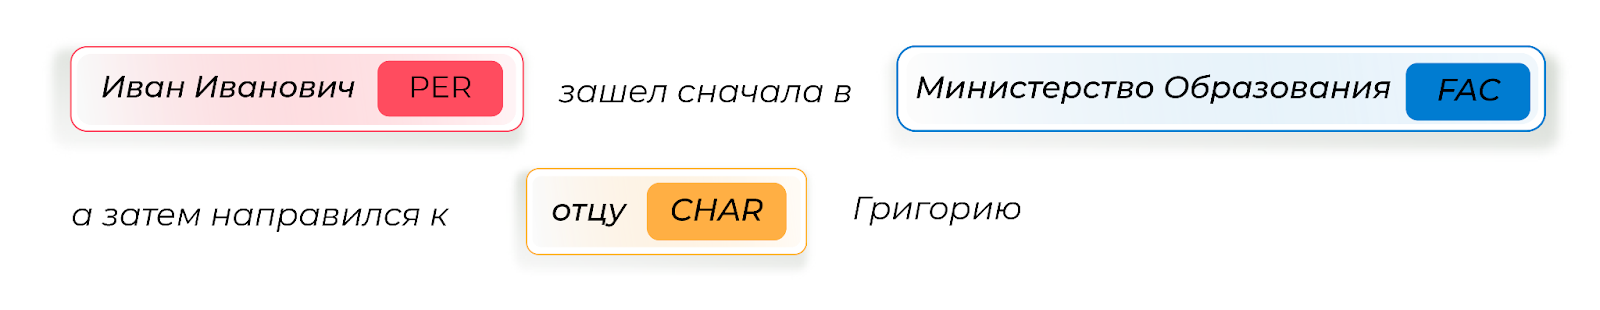
В случае аудио – файлов это может быть текстовая расшифровка речи, метка эмоции или идентификация говорящего.
Ярким примером размеченного датасета является знаменитый ImageNet, содержащий миллионы изображений, каждое из которых помечено меткой класса, указывающей, что именно изображено на картинке — от пород собак до видов растений.
Примечание:
ImageNet — это масштабная база данных аннотированных изображений, предназначенная для исследований в области компьютерного зрения. Она содержит более 14 миллионов изображений, каждое из которых вручную аннотировано и отнесено к одной из более чем 21 тысячи тематических категорий (классов) согласно иерархической системе WordNet (где каждый узел-понятие описан сотнями или тысячами изображений). Классы организованы в иерархию. Например, понятие «собака» включает в себя множество подкатегорий для разных пород.
Главная цель создания ImageNet — предоставить исследователям огромный и качественно размеченный ресурс для обучения моделей машинного обучения задаче распознавания и классификации изображений.
Проект был запущен в 2009 году группой ученых из Принстонского и Стэнфордского университетов под руководством Фей-Фей Ли.
Однако настоящую мировую известность ImageNet получил благодаря ежегодному конкурсу ImageNet Large Scale Visual Recognition Challenge (ILSVRC), который проводился с 2010 по 2017 год. Участники должны были обучить свои модели на подмножестве ImageNet (около 1,2 млн изображений, 1000 классов) и достичь наименьшей ошибки в классификации. Команда под руководством Джеффри Хинтона (University of Toronto) представила сверточную нейронную сеть AlexNet. Она не просто победила, а совершила прорыв, сократив ошибку классификации почти в два раза по сравнению с предыдущими лучшими методами (с ~26% до ~15%). Ключевой фактор успеха AlexNet - использование глубокой сверточной нейронной сети (CNN), обученной на мощностях графических процессоров (GPU). Это наглядно доказало, что глубокие модели, обученные на огромных данных, радикально превосходят все существовавшие на тот момент алгоритмы. Это событие стало отправной точкой для взрывного роста интереса к глубокому обучению и сверточным сетям, которые сегодня являются основой практически всех технологий компьютерного зрения.
Классификация датасетов: выбираем правильный инструмент для задачи
Понимание типов датасетов помогает выбрать правильный подход к решению каждой конкретной бизнес-задачи.
Классификация по типу данных:
- Изображения (ImageNet, ObjectNet): используются для компьютерного зрения — распознавание лиц, беспилотное вождение, диагностика по снимкам.
- Тексты (корпус «Прожито», датасет «Размечено»): применяются в обработке естественного языка (NLP) — чат-боты, машинный перевод.
- Аудио/Видео (ESC-50, Kinetics-700): Необходимы для распознавания речи, идентификации звуков среды, анализа действий и эмоций в видео.
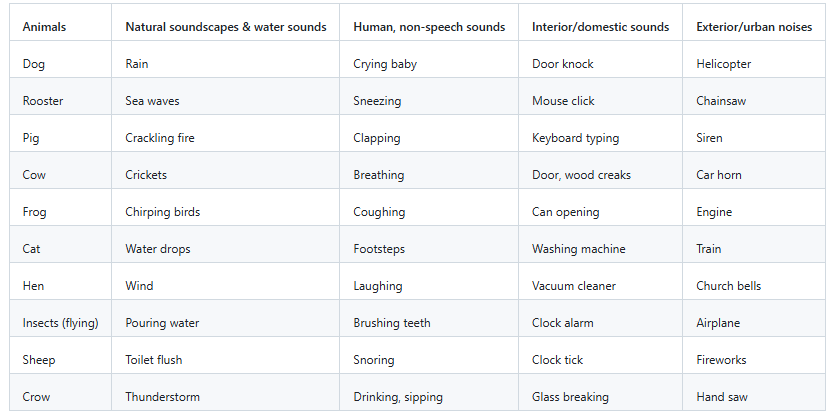
Примечание:
Корпус «Прожито» и датасет «Размечено» — это уникальные и важные проекты в области цифровой гуманитаристики и обработки естественного языка (NLP) для русского языка, особенно ориентированные на исторические материалы.
«Прожито» — это масштабный общественный проект по созданию универсального корпуса личных дневников XIX–XXI веков.
Это не просто архив, а полноценный электронный корпус (структурированная база данных) текстов, который постоянно пополняется силами волонтеров. Проект ставит перед собой задачу собрать, оцифровать и сделать доступными для исследователей и всех интересующихся личные дневники самых разных людей — от известных писателей и ученых до простых инженеров, школьников и солдат.
Это бесценный источник для изучения «истории снизу», менталитета, повседневной жизни, языка и реакции людей на ключевые исторические события (революции, войны, советский быт, перестройка).
Главная цель «Прожито» — сохранение и активация этого культурного слоя, предоставление инструментов для работы с ним (поиск, навигация, анализ).
«Размечено» — это производный проект от корпуса «Прожито», но с сугубо технической, machine learning направленностью.
«Размечено» — это публично доступный размеченный датасет, созданный специально для обучения моделей машинного обучения задаче распознавания именованных сущностей (NER — Named Entity Recognition) в исторических русскоязычных текстах.
Эти два проекта идеально дополняют друг друга, образуя полный цикл работы с культурным наследием:
«Прожито» выступает как поставщик сырого, но ценнейшего исторического материала.
«Размечено» выступает как технологический мост, который создает инструменты (ML-модели) для извлечения структурированной информации из этого материала.
Их общая цель — не просто сохранить тексты, а «оживить» их, сделать их содержание машиночитаемым, доступным для сложного анализа и, в конечном итоге, для нового понимания нашей истории.
Таким образом, эти проекты находятся на стыке гуманитарных наук и искусственного интеллекта, демонстрируя, как современные технологии могут быть применены для изучения прошлого.
Классификация по способу получения:
- Реальные данные собираются из реального мира. Это «золотой стандарт», но часто его сбор дорог, трудоемок и сопряжен с юридическими ограничениями (персональные данные). Пример — проект CheXpert, где врачи-эксперты вручную размечали рентгеновские снимки для обучения диагностических AI-моделей.
- Синтетические данные генерируются искусственно с помощью алгоритмов, 3D-моделирования или других методов (например, с помощью GAN-сетей или языковых моделей). Это отличное решение, когда реальных данных мало, они конфиденциальны или необходимо смоделировать редкие или опасные ситуации (например, аварии для беспилотников). Однако риском здесь является «симуляционно-реалистичный разрыв» — когда модель, обученная на идеальных синтетических данных, плохо работает с неидеальным реальным миром.
Классификация по наличию разметки:
- Размеченные датасеты требуются для контролируемого обучения. Процесс разметки — это, как правило, самое дорогое и времязатратное место в проекте, но оно критически важно.
- Неразмеченные датасеты используются для неконтролируемого обучения (например, кластеризация) или для обучения моделей с самоконтролем (self-supervised learning).
Три кита качественного датасета: репрезентативность, объем и качество
Создание хорошего датасета — это не просто сбор случайной информации. Он должен быть репрезентативным, то есть достаточно точным и полным, чтобы отражать все многообразие реального мира, с которым столкнется модель после развертывания.
Во-первых, нужно обращать свое внимание на разнообразие данных - данные должны покрывать все возможные сценарии. Например, если вы создаете модель для беспилотного автомобиля, ваш датасет должен содержать изображения и видео, снятые в разное время суток, при разной погоде (дождь, снег, туман, яркое солнце), с разных ракурсов, с разными типами объектов на дороге. Датасет ObjectNet был создан именно для борьбы с однообразием: фрилансеры специально фотографировали объекты в нестандартных позах и условиях (например, чайник на боку, стул на столе), чтобы модель училась распознавать объекты в любой ситуации, а не только в «стерильных» условиях других датасетов.
Самая распространенная ошибка в данном случае заключается в использовании датасета только с изображениями людей со светлым типом кожи для системы распознавания лиц приведет к тому, что модель будет делать грубые ошибки при работе с людьми с темным цветом кожи. Это классический пример смещения выборки (bias).
Во-вторых, стоит учитывать объем данных. Вопрос «сколько нужно данных?» не имеет универсального ответа. Он зависит от сложности задачи и модели. Для простой классификации изображений может хватить тысяч примеров, тогда как для обучения больших языковых моделей (LLM) типа GPT необходимы миллиарды текстовых токенов. Недостаточный объем данных — прямая дорога к переобучению (overfitting), когда модель идеально запоминает примеры из обучающей выборки, но совершенно не способна обобщать знания и работать с новыми, невиданными данными.
В-третьих, важно учитывать качество данных. Данные должны быть достоверными, точными и консистентными. Основным риском в данном случае является низкое качество разметки — самый распространенный и критичный риск. Если один асессор пометил кошку как «собаку», а другой как «кошку», модель получит противоречивые сигналы и не сможет обучиться корректно. Шум в данных, пропущенные значения, выбросы (аномальные значения) — все это «отравляет» датасет и ведет к обучению некорректных и небезопасных моделей. Отличным примером важности соблюдения качества данных может служить модель для диагностики COVID-19 по рентгеновским снимкам, обученная на некачественно размеченных данных, где снимки от разных аппаратов не были унифицированы, может научиться определять не заболевание, а тип аппарата, на котором был сделан снимок.
Жизненный цикл данных в ML-проекте: обучение, валидация и тестирование
Для эффективного и честного обучения модель данные обычно разделяют на три независимых набора:
Во-первых, это тренировочный набор (Training Set, ~70-80%). Это основной массив данных, на котором модель непосредственно «учится». Здесь она подбирает веса и параметры своих алгоритмов.
Далее переходим к валидационному набору (Validation Set, ~10-15%). Этот набор используется для тонкой настройки гиперпараметров модели и для проверки ее работы на промежуточных этапах. Он помогает предотвратить переобучение, так как показывает, как модель справляется с данными, которых она не видела во время обучения.
И, наконец, тестовый набор (Test Set, ~10-15%).Это самый главный набор для объективной оценки. Его используют единожды в самом конце, после того как модель полностью обучена и все параметры настроены. Тестовый набор имитирует «боевые» условия. Результат на тестовом наборе — это и есть объективная метрика качества вашей модели.
Важно: Никогда нельзя использовать тестовые данные для обучения или валидации. Это приведет к «утечке данных» (data leakage) и завышенным, неадекватным оценкам производительности модели, которые не повторятся в реальной жизни.
Подробный разбор датасета Titanic
Датасет «Titanic» с платформы Kaggle — это хрестоматийный пример для начала работы в Data Science. Он содержит информацию о пассажирах знаменитого лайнера и о том, выжили они или нет.
Задача состоит в том, чтобы построить модель бинарной классификации, которая предсказывает (1/0), выживет ли пассажир, основываясь на его характеристиках: класс каюты, пол, возраст, количество родственников на борту и т.д.

В целом данный датасет учит решать следующие задачи:
- Предобработка данных: в этом датасете много пропущенных значений (например, возраст или номер каюты). Студент учится обрабатывать эти пропуски: удалять строки, заполнять средними/медианными значениями или использовать более сложные методы.
- Feature Engineering (создание признаков): можно создать новые признаки на основе существующих. Например, «размер семьи» = количество родственников на борту + 1 (сам пассажир). Или извлечь титул (Mr., Mrs., Miss.) из поля «Имя», который может быть сильным предиктором.
- Анализ смещения: данные исторические и неполные. Модель, обученная на них, может уловить и усилить исторические и социальные biases (например, приоритет при спасении пассажиров 1-го класса и женщин).
- Оценка качества: позволяет попрактиковаться в использовании метрик Accuracy, Precision, Recall, F1-score и ROC-AUC.
Где найти интересные датасеты?
В первую очередь мы рекомендуем обратить внимание на публичные платформы (Kaggle, HuggingFace, UCI Repository).
Kaggle, Hugging Face и UCI Machine Learning Repository — это три кита, на которых держится мир data science и machine learning для исследователей, студентов и практиков. Это основные источники данных, моделей и инструментов для работы.
Kaggle (приобретена Google) — это многофункциональная онлайн-платформа, которая сочетает в себе социальную сеть для специалистов по данным, хостинг для датасетов и кодноутбуков, а также площадку для проведения ML-соревнований с денежными призами. Компании (от стартапов до Google, Netflix или NASA) размещают свою задачу и данные, а сообщество соревнуется в создании лучшей модели машинного обучения. Задачи бывают самыми разными: от предсказания выживших на «Титанике» (учебное) до сложнейших проблем в области медицины, беспилотного вождения и космоса. Победители получают денежные призы, а главное — репутацию и признание, что является мощным пунктом в резюме.
Сильные стороны: невероятно активное и большое сообщество, геймифицированный подход к обучению и решению задач, отличная облачная инфраструктура с бесплатным доступом к GPU/TPU.
Слабые стороны: может доминировать «соревновательный» подход, где цель — не всегда создать универсально хорошую модель, а «взломать» лидерборд, что иногда leads к overfitting.
Hugging Face — это «GitHub для Machine Learning». Изначально стартап, сфокусированный на NLP, он превратился в крупнейшую в мире open-source платформу для сообщества ИИ, где можно делиться моделями, датасетами и демонстрационными приложениями.
Ключевые функции и возможности:
- Transformers (библиотека и модель): прославились благодаря одноименной open-source библиотеке transformers на Python, которая предоставляет тысячи предобученных моделей (BERT, GPT, RoBERTa, T5 и др.) для решения задач NLP (текстовая классификация, генерация, перевод, summarization и т.д.). Главная ценность — единый API для тысяч моделей. Скачал библиотеку — и получил доступ к state-of-the-art моделям в несколько строк кода.
- Model Hub: платформа для обмена моделями. Любой пользователь может загрузить свою обученную модель (не только NLP, но и для компьютерного зрения, аудио и др.) для общего доступа. У каждой модели есть своя страница с документацией, примерами использования и возможностью протестировать её прямо в браузере.
- Datasets Hub: огромная коллекция датасетов для обучения ML-моделей. Так же, как и с моделями, любой может загрузить свой датасет. Сопровождается библиотекой datasets, которая упрощает загрузку и предобработку данных.
- Spaces: возможность создавать и хостить интерактивные демо-приложения (на базе Gradio или Streamlit) для своих ML-моделей. Это позволяет легко показать работу модели коллегам, заказчикам или сообществу без необходимости разворачивать сложную инфраструктуру.
UCI Machine Learning Repository — это один из старейших и самых известных архивов датасетов, созданный в 1987 году Калифорнийским университетом в Ирвайне (University of California, Irvine). Это классика, с которой начинали практически все data scientists. Датасеты здесь изначально собирались и курировались для исследовательских и образовательных целей. Многие из них стали «иконами» и benchmarks для проверки новых алгоритмов ML. Примеры классических датасетов: Iris (классификация цветков ириса), Wine (определение происхождения вина по хим. анализу), Adult (предсказание дохода человека) и, конечно, Titanic. Каждый датасет тщательно описан: есть информация об авторах, источниках, количестве instances и атрибутов, есть подробное описание каждого признака (feature description). Данные, как правило, уже предварительно очищены и готовы к использованию для обучения моделей.
Также стоит обратить внимание на государственные порталы открытых данных (data.gov, data.mos.ru). Это действительно денный источник для социально-экономических и государственных проектов. Риск в данном случае заключается в том, что данные могут быть неактуальными, иметь разрозненные форматы и требовать огромной работы по очистке и унификации.
Обязательно обратите на специализированные проекты («Прожито», «Если быть точным»). Здесь собраны уникальные данные для нишевых задач. Риск – очень узкая направленность и зачастую малый объем.
Не забывайте и про самостоятельный сбор (Веб-скрейпинг на Scrapy, сбор через API). Он дает полный контроль над данными. Однако здесь стоит учитывать следующие риски:
- Юридические: нарушение авторских прав, правил использования сайта (robots.txt), законодательства о персональных данных (GDPR, 152-ФЗ).
- Технические: блокировки IP, изменение структуры сайта, что ломает парсеры, сбор нерелевантного или дублирующегося мусора.
- Качественные: без строгой процедуры контроля качества самостоятельно собранные данные будут крайне зашумленными.
Создание качественного датасета — это не побочная задача, а сложный, многоэтапный проект, требующий экспертизы в области data science, юриспруденции и предметной области. Экономия на качестве данных на старте проекта гарантированно ведет к многократному перерасходу бюджета на последующих этапах на переобучение моделей, исправление ошибок и, в худшем случае, к полному провалу проекта и репутационным издержкам.
Не позволяйте плохим данным похоронить ваши амбициозные AI-проекты!


