

Структуры логов, метрик и событий
Эта глава посвящена структурам логов, метрик и событий в контексте внедрения SIEM в рамках курса «Использование BI и DWH при внедрении SIEM системы Security Information and Event Management». Здесь мы собираем знания о том, как логи, метрики и события организованы, как они выглядят на практике, какие форматы используются и зачем нужна единая архитектура хранения и обработки. Мы обучаемся с нуля: что такое лог, что такое метрика, чем событие отличается от инцидента, какие элементы данных в них заложены, и как эти данные связываются между собой через BI/ETL-DWH конвейер и SIEM-движок.
Определения и ключевые термины
- Лог (лог-запись) — структурированная или полуструктурированная запись о каком-либо событии, возникающем в информационной системе: это может быть запрос к базе данных, действие пользователя, сетевой пакет, уведомление от устройства, сообщение об ошибке и т. д. Лог обычно содержит временную отметку, источник, метки типа и текст сообщения.
- Событие — факт, который можно интерпретировать как транзакцию в системе. Событие может включать набор полей лога и дополнительную информацию: IP-адрес, пользователя, действие, результат выполнения, код ошибки и т. д.
- Метрика — числовой показатель, отражающий состояние или поведение системы в течение времени: средняя задержка запроса, число ошибок за минуту, загрузка CPU, количество подключений и т. д. Метрики обычно хранятся в измерениях времени и агрегируются для анализа трендов.
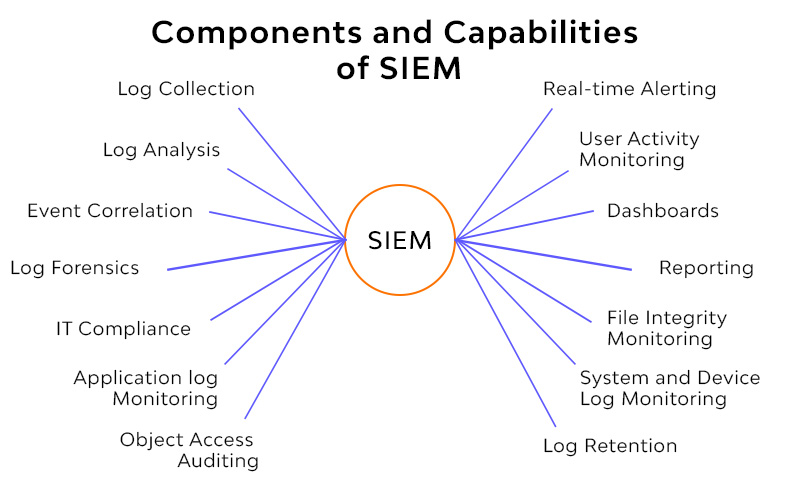
- SIEM (Security Information and Event Management) — система, объединяющая сбор, нормализацию, корреляцию и анализ событий и логов для обнаружения угроз, инцидентов и соответствия требованиям. SIEM связывает данные из разных источников, применяет правила и модели для выявления аномалий и suspicious activity.
- BI/DWH контекст — сбор, хранение и обработка больших массивов бизнеси операционных данных (логов, метрик, событий) в виде структурированных фактов и измерений в хранилище данных, с целью аналитики, дэдупликации, дашбордов и принятия решений. В SIEM и BI/ETL-проектах мы строим общий конвейер: данные из источников попадают в единое хранилище, затем BI-слой выполняет агрегацию и подготовку к отчётности, а SIEM-платформа обеспечивает детекцию и реагирование на угрозы.
Форматы и схемы сохранения:
- Традиционные форматы: Syslog (RFC 5424/3164), Windows Event Log, различные CSV/JSON-лог-файлы, логи веб-серверов (Nginx, Apache) и базы данных (лог-запросы, транзакции).
- Структурирование: JSON, Common Event Format (CEF), Log Event Data Model (LEEF) — популярные схемы для нормализации поля log, которые позволяют унифицировать разнородные источники.
- Временная привязка: синхронизация времени через NTP, корректная временная зона, тикеты по времени в форматах UTC или локальных временных зон, чтобы корреляции между источниками были корректными.
Архитектура хранения данных:
- Хранилище логов: ленточно-письменные или файловые хранилища, базы данных временных рядов, колоночные хранилища.
- Хранилище индексов: поисковый движок (Elastic/OpenSearch/ Graylog) для быстрого доступа к логам и быстрого выполнения запросов.
- Хранилище фактов/измерений для BI: SQL-ориентированное DWH (например, PostgreSQL, ClickHouse, Snowflake, по контексту проекта) с моделями типа «fact» и «dimension».
Связь между BI и SIEM:
- BI/ETL-DWH слой позволяет строить долгосрочную аналитику: тренды, показатели эффективности, аудит данных и т. д.
- SIEM слой осуществляет корреляцию и детекцию угроз в реальном времени или near-real-time, связывая данные из разных источников, чтобы превратить логи и метрики в инциденты.
Роли и ответственность:
- Инженер по данным: сбор, нормализация и загрузка логов в хранилища.
- Аналитик SIEM: настройка правил корреляции, создание детекторов, интерпретация инцидентов.
- Архитектор BI/DWH: проектирование моделей данных, интеграция с SIEM, обеспечение скорости и качества запросов.
- Специалист по информационной безопасности: определение угроз, тактик и процедур реагирования.
Схемы структурирования и принципы нормализации
- Структурированные логи: логирование в заранее заданной схеме, где каждый элемент имеет конкретное имя и тип данных (например, timestamp, src_ip, dst_ip, user, event_type, action, outcome, device_id, severity).
- Полуструктурированные логи: JSON или ключ-значение форматы, где поля присутствуют не обязательно во всех записях, но базовый набор заранее определен.
- Нормализация полей: создание единой схемы на уровне конвейера, чтобы разные источники могли сопоставляться по одному набору полей. Это уменьшает временные задержки на агрегацию и корреляцию.
- Распознавание и обогащение: на стадии входа добавить дополнительные данные (геолокация IP, владельцы/пользователи из AD, данные CMDB), чтобы упростить последующую корреляцию.
- Временные поля: единый timestamptype (в формате UTC), поддержка миллисекунд и микросекунд там, где требуется высокая точность, линейная временная шкала без «куда пропадают» данные.
Методики организации структур данных
- Унификация форматов: выбор одного или двух форматов для входящих логов (например, JSON с полями по схеме, иCEF/LEEF как совместимого стандарта), чтобы минимизировать переработку данных.
- Правила именования и типизации: единая система типов и имён полей, чтобы последующая логическая корреляция была корректной.
- Модели хранения и индексации: планирование разбиения по времени (например, ежедневные индексы в Elastic/OpenSearch), определение маппингов (тип данных: дата, ip, текст, ключевые слова), создание динамических шаблонов и правила для автоматического добавления полей.
- Временная синхронизация и корреляция: обеспечение точного времени и согласованности между источниками. В случае задержек между источниками используем правила корреляции по окнам времени (например, события в рамках 5–60 секунд рассматриваются как связанные).
- Контроль качества данных: механизмы валидации форматов, простые sanity checks на пустые поля, наличие обязательных полей, базовые проверки целостности и полноты.
Практические примеры
Пример 1: базовая инфраструктура на открытом стеке (Elastic/OpenSearch, Logstash/Beats, Kibana)
- Архитектура: центральный SIEM-ступеньный стек на базе Elastic Stack или OpenSearch. Источники логов: сетевые устройства, серверы приложений, базы данных, веб-серверы, оконные журналы.
- Ингестия: Filebeat/Winlogbeat собирают логи, Logstash (или OpenSearch Ingest Pipelines) распаковывает и нормализует их, применяет grok-паттерны или JSON-полезности, преобразует в единый формат с полями: timestamp, source, host, event_type, severity, message, user, ip, username, action, result, device_id, app_name и т. д.
- Хранение: логи индексируются в Elastic/ OpenSearch. Индексы могут быть дневными или по проекта/сервисам. Применяются маппинги по полям и динамические шаблоны для новых источников.
- Аналитика и визуализация: Kibana/OpenSearch Dashboards строят дашборды по количестве событий, по источникам, по типам событий, по критичности. SIEM-правила корреляции реализованы через правила в SIEM-модуле (например, Elastic SIEM или OpenSearch SIEM) или через TheHive/ wob.
- Примеры корреляций: попытка входа с неизвестного IP и неудача в сочетании с попытками доступа к критичным ресурсам; аномалии по частоте обращений к административным портам; повторные запросы к БД в короткий интервал.
- Обогащение: данные о пользователях (AD/LDAP), данные CMDB, геолокация по IP, контекст IP-адресов и устройств.
Пример 2: готовка к сбору, нормализации и корреляции с помощью Wazuh
- Wazuh — открытое решение на базе OSSEC, поддерживает сбор логов, мониторинг целостности файлов, обнаружение угроз и интеграцию с Elastic Stack.
- Архитектура: агентов Wazuh на узлах (серверы, рабочие станции) отправляют логи и данные об изменениях в Wazuh менеджер; менеджер отправляет события в Elastic через логсташ или напрямую.
- Нормализация: Wazuh имеет собственные правила и décodеры, которые преобразуют логи в единый формат, добавляют контекст и коррелируют на стороне Wazuh и в Elastic.
- Аналитика: через TheHive можноenкировать инциденты, а через сам SIEM Elastic — детектировать угрозы, строить дашборды по безопасности.
- Обогащение и контроль доступа: интеграция с LDAP/AD, настройка ролей, разграничение доступа к данным, аудит изменений конфигурации.
Пример 3: российские решения в контексте BI/SIEM
- InfoWatch Analytics: российская платформа, ориентированная на аналитическую обработку больших объемов данных и безопасность информации. Она может выступать как подсистема для сбора и анализа данных, интегрируясь с BI/DWH-процессами и SIEM-процессами для повышения видимости риска по данным компаний.
- Group-IB Threat Detection System (TDS) или аналогичные предложения группы Group-IB: платформа, объединяющая анализ угроз, инцидентов и топологию угроз; может интегрироваться с SIEM и BI-слоями для корреляции и аналитики по инцидентам.
- Positive Technologies PT SIEM или аналогичные решения PT Security: российские решения для SIEM и аналитики, локализация и поддержка на русском языке, ориентированные на корпоративные рынки РФ и стран СНГ.
- Принципы интеграции: российские решения часто предлагают готовые коннекторы к источникам логов, встроенные правила корреляции, возможности экспорта в SQL/BI-среды, локализацию интерфейсов и документацию на русском. В реальной системе они обычно работают в связке с BI/DWH слоем: данные из SIEM поступают в хранилище для дальнейшей аналитики и отчетности.
Концептуальные шаги внедрения и технические параметры
- Планирование источников данных: определить все ключевые источники логов и метрик: сетевые устройства (маршрутизаторы, firewall), серверы ОС (Windows/Linux), базы данных, приложения, оркестрация контейнеров, Kubernetes, платформы облака.
- Выбор форматов и схем: закрепить единый формат входящих данных (JSON/CEF/LEEF) и определить набор обязательных полей. Примеры обязательных полей: timestamp, source, host, event_type, severity, message. Дополнительно: user, ip, action, outcome.
- Конвейер обработки: сборка, нормализация, обогащение, хранение, индексация. Компоненты могут быть распределенными и масштабируемыми: агенты-источники -> сборщики/шлюзы (Logstash/Filebeat) -> агрегационные узлы (Elasticsearch/OpenSearch) -> BI/DWH слой (PostgreSQL/ClickHouse/ Snowflake) -> SIEM корреляция (Elastic SIEM, TheHive, Wazuh, и т. д.).
-
Моделирование данных для BI: проектирование схемы фактов и измерений. Пример модели:
- Факты: fact_security_events (event_id, timestamp, event_type_id, source_host_id, dest_host_id, user_id, severity_id, message, is_incident).
- Измерения: dim_time (time_id, timestamp, hour, day, month), dim_host (host_id, hostname, ip_address, os_type, location), dim_user (user_id, username, domain), dim_event_type (event_type_id, name, category), dim_severity (severity_id, level).
- Связи: множество фактов к измерениям через внешние ключи.
- Инфраструктура хранения: использовать гибридное хранилище. Логи и индексы — в Elastic/OpenSearch (массивы по времени, быстрый поиск, корреляционные запросы). BI-слой — в PostgreSQL/ClickHouse или аналогах для долговременной аналитики и дэшбордов. Временные задержки между слоями зависят от требуемой скорости обнаружения угроз и объема данных.
- Корреляционные правила и детекция: настройка правил в SIEM–движке. Примеры: последовательности действий («необычный вход с несколькими неудачными попытками», «попытка доступа к критическим сервисам»), анализ ошибок, попытки эксплуатировать известные CVE и т. д. Правила могут строиться на частотном анализе, паттернах поведения и сигнатурах.
- Обогащение и контекст: подключение к AD/LDAP для идентификации пользователей; контекст CMDB для определения владения активами; геолокационные данные по IP для выявления необычной активности (например, вход из стран, где не ожидается трафик от данного пользователя).
- Безопасность и соответствие: хранение ЛОГОВ в локальном, а не в публичном облаке по требованию локализации данных; управление доступом к данным, журналирование изменений конфигураций, регулярное резервирование и тестирование восстановления.
Практические советы по реализации
- Начинайте с MVP: выберите 2–3 критичных источника логов и создайте базовую модель данных и несколько корреляционных правил. Постепенно расширяйте запас источников и правила.
- Плавное расширение к BI: параллельно добавляйте источники BI-доступа и начните моделировать факты/измерения для бизнес-аналитики на уровне безопасности — например, связь событий с трафиком по отделам или регионам компании.
- Тестирование и имитации: регулярно проводите тестовые инциденты и симуляции, чтобы проверить полноту корреляций и устойчивость конвейера.
- Мониторинг производительности: следите за задержками конвейера, использованием памяти и диска, ростом индексов и графиками latency.
- Безопасность конфигураций: применяйте принцип минимального необходимого доступа, мониторинг изменений конфигурационных файлов, аудит пользователей и ролей.
Риски и ограничения
- Объем данных и масштаб: логи и метрики растут экспоненциально. Необходимо планировать хранение, долговременное архивирование и умножение вычислительных мощностей. Участь BI-слоя для долгосрочной аналитики требует оптимизации запросов и управления индексами.
- Кардинальность и специфика полей: поля, такие как IP-адреса, имена пользователей и сессии, могут иметь высокую кардинальность. Это влияет на производительность индексов, требования к памяти и скорости поиска. Необходимо использовать подходы к агрегации, маскированию, нормализации.
- Качество данных: неполные или некорректные логи приводят к ложным отрицаниям или ложным срабатываниям детекции. Внедряем процессы валидации и обогащения на ранних стадиях конвейера.
- Временная синхронизация: несовпадение времени между источниками усложняет корреляцию. Требуется согласование времени, единая временная зона и учёт задержек вашего конвейера.
- Конфиденциальность и локализация: данные безопасности часто содержат персональные данные и корпоративную информацию. В РФ действуют требования локализации и защиты персональных данных. Это требует надежной архитектуры защиты, строгого контроля доступа и процессов обработки данных.
- Зависимость от поставщиков: коммерческие SIEM-решения и интеграционные коннекторы зависят от вендора и версии. При смене поставщика или обновлении может потребоваться адаптация конфигураций и схемы данных.
- Ограничения по компетенциям: эффективная работа с BI и SIEM требует специалистов по данным, аналитиков безопасности и инженеров по инфраструктуре. Небходима командная работа и документирование процессов.
- Локальные нормативы и безопасность: важно учитывать требования регуляторов по хранению данных, мерзкому доступу и аудитам. Неправильная обработка данных может привести к штрафам и репутационным потерям.
Структуры логов, метрик и событий — фундаментальная часть любой SIEM-инициативы в контексте BI и DWH. Единая модель данных и унифицированный конвейер сбора-обогащения-аналитики позволяют не только эффективно обнаруживать угрозы и инциденты, но и извлекать бизнес-ценность из логов. Ваша система должна поддерживать гибкое добавление источников, устойчивые методы нормализации и обогащения, продуманную модель данных для BI, а также эффективную корреляцию в SIEM. Важно помнить о рисках, связанных с масштабируемостью, качеством данных, временем синхронизации и локализацией. Начинайте с MVP, сосредоточьтесь на качестве ключевых источников и правил корреляции, затем постепенно расширяйте конвейер, добавляйте новые источники данных и развивайте BI-аналитику.
FAQ — Вопросы и ответы
1) Что именно мы называем структурой лога и почему это важно для SIEM и BI?
Структура лога — набор полей (timestamp, source, host, event_type, severity, message и др.), который описывает каждое событие. Это важно потому что единая структура позволяет быстро сопоставлять данные из разных источников, выполнять корреляцию в SIEM и строить аналитические модели в BI. Без единообразной структуры сложность обработки увеличивается, появляется риск пропуска важных инцидентов и ухудшается качество аналитики.
2) Какие форматы логов стоит использовать на старте проекта?
На старте разумно выбрать структурируемый формат JSON или заранее определенную схему CEF/LEEF для совместимости с большинством SIEM-решений. Также полезно поддерживать Syslog-форматы для сетевых устройств. Важно обеспечить единый набор полей и конверсию всех источников к ним.
3) Как связать логи с метриками и данными BI?
Логи и метрики объединяются через общие идентификаторы (host, IP, user, время) и общую временную шкалу. BI-слой строит факты и измерения вокруг событий: например, факт_security_events может быть связан с измерениями времени, пользователей, хостов и типов событий. Метрики, такие как количество ошибок в секунду, добавляются как дополнительные измерения, помогающие видеть тренды и аномалии.
4) Какие практические инструменты можно применить в открытом доступе?
Популярные наборы: Elastic Stack (Elasticsearch/OpenSearch, Logstash/Beats, Kibana/OpenSearch Dashboards), Wazuh (облегчает сбор и корреляцию на базе Elastic), TheHive (инциденты), Vector (для обработки потоков логов), Grafana для визуализации. Эти инструменты поддерживают множество форматов, хорошо масштабируются и доступны в открытом виде.
5) Какие российские решения можно использовать вместе с BI/DWH?
Российские варианты включают InfoWatch Analytics и Group-IB Threat Detection System (TDS) либо PT Security (Positive Technologies) SIEM-линию; эти продукты локализованы, имеют соответствующие модули анализа, отраслевые решения и поддержку на русском языке. Они могут интегрироваться с BI/DWH через коннекторы, экспорты в SQL-форматы или API.
6) Какие этапы помогут избежать перегруза системы данными?
Начинайте с минимального набора источников критических систем и постепенно расширяйте конвейер. Важна архитектура на уровне индексов и долговременного хранения; используйте агрегацию, фильтрацию и обогащение на ранних стадиях, применяйте хранение по времени (daily или partitioned индексы), настройте политику архивирования и удаления старых данных.
7) Какие ключевые показатели эффективности (KPI) SIEM/Bi/DWH проекта стоит отслеживать?
KPI могут включать: среднее время обнаружения (MTTD), среднее время реагирования (MTTR), точность детекции (precision/recall), объём обрабатываемых логов в минуту/час, задержка от сбора до индексации, доля инцидентов, покрытие источников, число ложных срабатываний, качество обогащения данных (доля записей с достаточным контекстом).
8) Как обеспечить качество данных и корректность корреляций?
Установите правила валидации форматов, обязательные поля, проверки на полноту, тестовые данные и симуляции инцидентов. Назначьте ответственных за контроль качества, регулярно проводите аудиты данных, обновляйте схемы и правила корреляции под изменяющуюся среду.
9) Какие риски связаны с локализацией и хранением данных в РФ?
Основные риски — соблюдение локальных регуляторов, защита данных, юридическое соответствие, ограничения на размещение внешних сервисов и обработки персональных данных. Важно реализовать локальные политики хранения (локализацию данных на территории РФ при необходимости), контроль доступа, аудит и мониторинг изменений.
10) С чего начать внедрение в компании и как оценивать прогресс?
Начните с определения целей проекта (например, улучшение обнаружения инцидентов, повышение видимости активности, поддержка регуляторных требований). Затем спроектируйте MVP: ограниченный набор источников, единая схема логов, базовые правила корреляции и дашборды. После успешной демонстрации расширяйте источники, добавляйте обогащение и углубляйте BI-аналитику. Регулярно оценивайте KPI и корректируйте план внедрения.


