

Управление портфелем AI-инициатив и дорожной картой продуктов
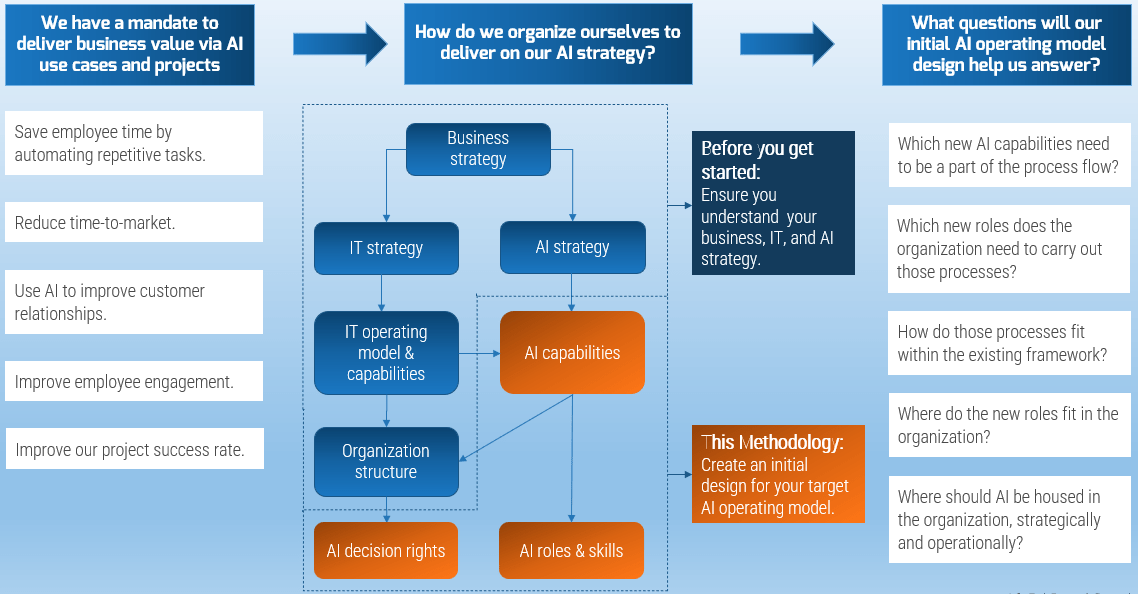
Современная организация не может масштабировать AI-инициативы без четкой структуры: портфеля проектов, продуктовой логики, роли центров компетенций и связующих процессов между бизнес-целями и технологическими возможностями. Эта глава даст понятие портфельного управления AI, объяснит, как превратить стратегию в последовательность продуктов и проектов, какие методики работают на практике и какие риски стоит учитывать. Вы научитесь формировать дорожную карту продуктов AI, оценивать ценность и риск, строить координацию между бизнес-юнитами, инженерией данных и operations (MLOps), а также пользоваться инструментами как открытого, так и российского происхождения.
Мы будем рассматривать следующее: как устроить портфель AI-инициатив, какие роли и компетенции необходимы, какие методы отбора и приоритизации применять, как синхронизировать дорожную карту с бизнес-целями, как оценивать стоимость владения и окупаемость проектов, и как преодолевать ограничения внедрения на разных стадиях.
Основы портфельного управления AI-инициатив
Ключевые концепции:
- Портфель AI-инициатив — совокупность запусков и проектов, связанных с данными, моделями и бизнес-эффективностью. В рамках портфеля мы управляем не одним проектом, а совокупностью проектов, которые совместно достигают стратегических целей.
- Продуктовый подход — каждая инициатива в портфеле ориентирована на создание продукта или продуктового компонента (модуль, сервис, API), который имеет ценность для пользователя и бизнес-мользи.
- Центры компетенций (CoE/CoP) — формальные структуры, которые развивают экспертизу: данные, ML-модели, инфраструктура, этика и соответствие требованиям, управление жизненным циклом моделей.
- Масштабирование AI-инициатив — переход от местных пилотов к повторяемым, масштабируемым решениям через стандартизированные процессы, инструменты MLOps, общую архитектуру и дорожную карту продуктов.
Теоретические основы можно свести к трем осям:
- ценность — насколько решение увеличивает доход, снижает издержки, улучшает риск-менеджмент или качество сервиса.
- Риск — технические, операционные, регуляторные и этические риски, связанные с внедрением.
- Затраты — капиталовложения, операционные издержки, стоимость владения данными и инфраструктурой.
Формула оценки ценности может выглядеть как сочетание бизнес-метрик и качественных факторов. Эту логику удобно закреплять с помощью методик приоритизации: RICE, WSJF, или портфельный Kanban.
Методы отбора и приоритизации
RICE-оценка:
- Reach (охват) — сколько пользователей/процессов выиграют.
- Impact (влияние) — предположительная полезность для каждого пользователя.
- Confidence (уверенность) — уверенность в оценках.
- Effort (усилие) — ресурсы на реализацию. RICE score = (Reach × Impact × Confidence) / Effort
WSJF (Weighted Shortest Job First) — приоритет по отношению к стоимости задержки (Cost of Delay) разделённому размером работы:
- Cost of Delay / Job Size
- Включает экономические аспекты задержки и размер реализации.
Portfolio Kanban — визуализация потоков работы: идеи, исследования, прототипы, MVP, масштабирование; ограничение на WIP (work in progress) для поддержания высокого качества и скорости.
OKR на портфельном уровне — связь целей бизнеса с набором инициаций: ключевые результаты формируются по каждому планируемому выпуску продукта.
Дорожная карта продукта в контексте AI
Дорожная карта продукта AI должна описывать:
- Этапы цикла жизни продукта: исследование, прототип, пилот, внедрение, масштабирование, эксплуатация и эволюцию.
- Вехи и зависимости между проектами: например, обучение модели требует чистых данных и инфраструктуры, а затем требует интеграции в сервисы.
- Критерии готовности (Definition of Ready/Done): набор требований к данным, тестированию, мониторингу и безопасности.
- Метрики продукта: точность, задержка, доступность, среднее время восстановления (MTTR), ROI и NPV.
Шаблон дорожной карты (упрощённый):
- Год 1: пилоты по 3-4 направлениям, формирование CoE, базовые данные, прототипы.
- Год 2: внедрение MVP в 2-3 направлениях, расширение инфраструктуры, усиление мониторинга.
- Год 3+: масштабирование на бизнес-подразделения, устойчивые сервисы, центр компетенций становится автономным.
Роли и центры компетенций
Ключевые роли:
- Правленияи/руководители направления AI (C-level либо делегированные директоры): формулируют стратегию портфеля.
- Product Manager для AI (AI Product Manager): отвечает за ценность продукта, дорожную карту и требования.
- Data Engineer и ML Engineer: работают над инфраструктурой данных и моделями.
- Data Scientist/ML Researcher: исследование и разработка моделей.
- MLOps инженеры: разворачивают, мониторят и управляют жизненным циклом моделей.
- Data Steward/GP (Governance & Privacy): отвечает за качество данных, безопасность и соответствие требованиям.
Центры компетенций:
- Центр компетенций по данным (Data & DataOps) — управление данными, качество, каталог данных.
- Центр компетенций по ML (ML CoE) — выбор технологий, пайплайны, обучение и сертификация.
- Центр компетенций по этике и рискам — управление приватностью, ответственностью, моделями риска.
- Центр компетенций по продукту — методологии продуктового управления AI.
RACI таблица (упрощённая):
| Роль | Ответственность | Участвует в | Консультирует |
|---|---|---|---|
| AI-Strategy Lead | A | Portfolio, roadmaps | Вышестоящее руководство |
| AI Product Manager | A/R | Roadmap, backlog | Архитектура и CoE |
| ML/DS Engineer | C | Реализация, пайплайны | Product Manager |
| MLOps Engineer | C | деплой, мониторинг | CoE, Security |
A = Accountable, R = Responsible, C = Consulted, I = Informed
Архитектура портфеля и инфраструктура
Общие принципы:
- Централизованные сервисы лицензирования и доступа к данным, единая платформа MLOps.
- Стандартизированные пайплайны данных и моделей: сбор данных, очистка, валидация, обучение, тестирование, деплой.
- Обеспечение наблюдаемости: мониторинг точности модели, латентность, задержки, деградация качества, уведомления.
- Безопасность и соответствие нормам: IAM, доступ по ролям, аудит, приватность.
Типовая архитектура:
- Источники данных → Data Lake / Data Warehouse → Data Prep & Feature Store → Model Training & Validation → Model Registry → Deployment & Serving → Monitoring & Feedback → KQ (Knowledge & Quality) циклы.
Пример стеков инструментов:
- Обработка данных: Apache Spark, Apache Kafka, Airbyte, DBT.
- Модели: PyTorch, TensorFlow, CatBoost (российская CatBoost библиотека Yandex, особенно полезна для табличных данных).
- MLOps: MLflow или аналогичные решения, Kubeflow, Kedro, DVC для версионирования данных и пайплайнов.
- Развертывание: Docker, Kubernetes, Istio, ArgoCD.
- Мониторинг: Prometheus, Grafana, OpenTelemetry, Evidently AI для мониторинга качества моделей.
- Облачные решения: Яндекс.Облако (Yandex.Cloud) и Сбер ОнЛайн, а также многоплатформенные варианты.
Пример кода: расчёт RICE-оценки (Python)
def rice_score(reach, impact, confidence, effort):
    """
    РАСЧЕТ RICE-оценки для приоритизации AI-инициатив.

    :param reach: число пользователей или процессов, которых затронет инициатива
    :param impact: предполагаемое влияние (0.0-1.0)
    :param confidence: уверенность в оценках (0.0-1.0)
    :param effort: объем усилий в человеко-месяцах
    :return: RICE-оценка (чем выше, тем выше приоритет)
    """
    if effort <= 0:
        raise ValueError("Effort must be > 0")
    return (reach * impact * confidence) / effort

# Пример использования
print(rice_score(1000, 0.8, 0.9, 6))  # ~120.0
Пример YAML-карты для простого дорожного плана (Argo/Kubernetes)
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: ai-portfolio-pipeline-
spec:
  entrypoint: ai-portfolio
  templates:
  - name: ai-portfolio
    steps:
    - - name: discovery
        template: discovery
    - - name: evaluate
        template: evaluate
    - - name: build-pipeline
        template: build-pipeline
  - name: discovery
    container:
      image: python:3.11
      command: ["bash", "-lc", "python -m discovery.run --config config.yaml"]
  - name: evaluate
    container:
      image: python:3.11
      command: ["bash", "-lc", "python -m portfolio.evaluate --config config.yaml"]
  - name: build-pipeline
    container:
      image: docker/compose
      command: ["bash", "-lc", "docker-compose up -d && pytest tests/portfolio.py"]
Пример конфигурации DVC для версионирования данных
# Инициализация DVC
dvc init
# Добавление набора данных
dvc add data/raw/customer_transactions.csv
# Коммит в Git
git add data/.dvc __dvc_repository__ dvc.lock
git commit -m "Add raw data with DVC versioning"
# Отслеживание изменений модели
dvc run -n train_model \
  -d train.py -d data/processed/features.csv \
  -o models/model.pkl \
  "python train.py --config config.yaml"
Практические примеры
Пример 1: крупная корпорация внедряет портфель AI-инициатив
Контекст:
- Бюджет под портфель AI распределен на 5-6 направлений: клиентский сервис, ценообразование, управление цепочками поставок, риск-менеджмент, HR.
- Создан центр компетенций по данным и ML, внедрены начальные MLOps-контуры.
- Применяются RICE и WSJF для отбора проектов; дорожная карта на 2-3 года с промежуточными вехами.
Что работает хорошо:
- Единая платформа данных и пайплайны; повторно используемые компоненты (feature store, набор тестов).
- Нормализация бизнес-метрик, которые теперь являются частью ROI-показателей.
- Построение культуры: постоянное обучение и сертификация сотрудников по ML и Data Governance.
Проблемы и решения:
- Регуляторное давление — внедряем согласование этических и правовых рисков на ранних этапах.
- Коммуникационные барьеры — создаём общий язык между бизнес-юнитами и инженерами через CoE и продуктовые спринты.
Пример 2: российский стартап внедряет MLOps-пайплайн
Контекст:
- Стартап занимается прогнозированием спроса на ритейл-товары.
- Используется CatBoost для табличных данных; инфраструктура в Яндекс.Облаке.
- Внедрён пайплайн: сбор данных → очистка/валидация → обучение → валидация → деплой → мониторинг.
Уроки:
- Выбор инструментов, адаптированных под локальные требования: CatBoost хорошо работает на табличных данных и поддерживает русские наборы данных без необходимости сложной предобработки.
- Яндекс.Облако предоставляет управляемые сервисы для ML, включая Data Processing, Compute и Deployment.
- Важно: настройка мониторинга на деге-датах моделей и автоматическое отклонение отклонений.
Пример 3: open-source проект инкорпорирован в продукт
Контекст:
- Команда внедряет open-source решение для очистки текста и извлечения информации.
- Проект адаптируется под корпоративные данные, интегрируется через API.
- Включены процессы for governance: лицензии, безопасность, журнал изменений, ответственность за данные.
Уроки:
- Эффективная адаптация открытых инструментов требует четкой политики обновлений и совместимости версий.
- Включение в дорожную карту — заранее планируйте миграции, тестирование совместимости и процедуры аудита.
Архитектура портфеля и данные
- Источники данных: транзакционные базы, логи, данные клиентов, внешние источники.
- Хранение: Data Lake/ Warehouse, Data Catalog, Feature Store.
- Модели: от базовых линейных регрессий до сложных трансформеров для обработки естественного языка.
- Инфраструктура: контейнеризация, оркестрация, мониторинг.
Основные принципы:
- Повторное использование компонентов (pipelines, features, сервисы) для ускорения реализации.
- Наблюдаемость и мониторинг: качество моделей и сервисов, SLA по времени ответа.
- Безопасность: контроль доступа, шифрование, аудит.
Инструменты и практические решения
Open-source решения:
- MLflow — трекер экспериментов, управление моделями, воспроизводимость.
- DVC — управление версиями данных и пайплайнов.
- Kedro — структура проектов и пайплайны.
- Kubeflow — оркестрация ML-пайплайнов в Kubernetes.
- CatBoost — эффективная библиотека для табличных данных.
- PyTorch, TensorFlow — фреймворки для обучения моделей.
Инфраструктура и Deployment:
- Docker, Kubernetes, ArgoCD — деплой и управление версиями.
- Prometheus, Grafana — мониторинг.
- OpenTelemetry — трассировка.
Российские решения:
- Яндекс.Облако (Yandex.Cloud) — управляемый ML и инфраструктура, сервисы для хранения и обработки данных, управление моделями, безопасность.
- CatBoost — отечественная инициатива для табличной аналитики (часть экосистемы Яндекса).
- Сбер ИИ/СберCloud — платформа для ML, сервисы для обучения, развёртывания и мониторинга.
Примеры кода и конфигураций
Пример кода: настройка мониторинга качества модели (Python)
import numpy as np
import pandas as pd
from evidently import Portfolio
from evidently.dashboard.tabs import RegressionPerformanceTab

# Пример простого валидационного набора
y_true = pd.Series([3, -0.5, 2, 7])
y_pred = pd.Series([2.5, 0.0, 2, 8])

portfolio = Portfolio(tabs=[RegressionPerformanceTab()])
portfolio.calculate(pd.DataFrame({'y_true': y_true, 'y_pred': y_pred}))
report = portfolio.render_html()
with open("model_performance_report.html", "w") as f:
    f.write(report)
Пример конфигурации MLflow для трекинга экспериментов
# Настройка MLflow
export MLFLOW_TRACKING_URI=http://localhost:5000
export MLFLOW_TRACKING_USERNAME=user
export MLFLOW_TRACKING_PASSWORD=pass

# Запуск эксперимента
mlflow run . -e train --experiment-name ai_portfolio --version 1
Пример конфигурации Kubernetes для сервиса модели
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ai-model-serving
spec:
  replicas: 3
  selector:
    matchLabels:
      app: ai-model
  template:
    metadata:
      labels:
        app: ai-model
    spec:
      containers:
      - name: model
        image: myregistry/ai-model:latest
        resources:
          limits:
            cpu: "1"
            memory: "2Gi"
        ports:
        - containerPort: 8080
Управление данными и безопасностью
- Правила доступа по ролям (RBAC) в облаке и в Kubernetes.
- Контроль качества данных: профилирование, дефекты, пропуски, присутствие выбросов, согласование с бизнес-правилами.
- Этические принципы и приватность: минимизация данных, аудит, обработка персональных данных в соответствии с требованиями законодательства.
Риски и ограничения внедрения
Технические риски
- Низкое качество данных и их непоследовательность.
- Недостаточная совместимость между сервисами и инструментами.
- Перегрузка инфраструктуры; проблемы масштабирования.
- Быстрые изменения в требованиях к модели (например, регуляторные изменения).
Организационные риски
- Неясность ролей и ответственности в портфеле.
- Сопротивление изменениям и культурные барьеры в компании.
- Неполная поддержка руководства и нехватка ресурсов для центра компетенций.
- Разрывы между бизнес-целями и технической реализацией.
Этические и правовые риски
- Приватность и утечки данных.
- Непрозрачность моделей (черный ящик).
- Возможная дискриминация или предвзятость моделей.
- Соответствие требованиям регуляторов и отраслевых стандартов.
Экономические риски
- Непредсказуемая окупаемость проектов.
- Затраты на инфраструктуру и лицензии.
- Неэффективное распределение бюджета между проектами.
Ограничения внедрения
- Мaturity-уровень организации: недостаток квалифицированных сотрудников.
- Неполная поддержка стандартов и процессов со стороны управления.
- Время цикла разработки: от идеи до внедрения может занимать месяцы.
- Сложности в интеграции с устаревшими системами и данными.
Как минимизировать риски:
- Внедрять процессы governance и этики на ранних стадиях.
- Использовать быстрые пилоты и прототипы, чтобы проверить гипотезы.
- Внедрять повторяемые пайплайны и шаблоны архитектуры.
- Обеспечивать обучение и сертификацию сотрудников.
- Постепенно наращивать масштабы на основании данных и реальных показателей.
Выводы
- Эффективное управление портфелем AI-инициатив требует системного подхода: от отбора и приоритизации идей до культивации центров компетенций и реализации дорожной карты продукта.
- Продуктовый подход обеспечивает устойчивость и ценность для бизнеса, а также позволяет пересекать функциональные границы между бизнес-единицами, данными и инженерией.
- Инфраструктура и инструменты должны быть выбраны так, чтобы поддерживать повторяемость, безопасность и масштабируемость: от Open-source до российских решений (CatBoost, Яндекс.Облако, СберИИ и пр.).
- Риск-менеджмент и этические аспекты должны быть встроены в каждую фазу портфеля и дорожной карты, чтобы обеспечить устойчивое внедрение AI.
Вопрос–Ответ (FAQ)
1) Что такое портфель AI-инициатив и зачем он нужен?
- Это совокупность проектов и инициатив, связанных с данными, моделями и бизнес-целями, управляемая как единый портфель. Он нужен для координации усилий, экономии ресурсов, единообразия архитектуры и прозрачности в выборе приоритетов.
2) В каком порядке приоритизировать проекты?
- Используйте RICE и WSJF для количественной оценки: охват, влияние, уверенность и усилия. Дополнительно учитывайте стратегические цели и риски. Ведите Portfolio Kanban, чтобы визуализировать поток работ и ограничить WIP.
3) Какие роли являются критичными для AI-портфеля?
- AI Strategy Lead, AI Product Manager, ML/Data Engineer, MLOps Engineer, Data Scientist, Data Steward, а также представители CoE, ответственные за этику и комплаенс.
4) Как построить дорожную карту продукта AI?
- Определите фазы цикла жизни продукта (исследование, прототип, пилот, деплой, масштабирование, поддержка). Установите вехи, зависимости и критерии готовности. Включите измеримые показатели эффективности (KPI).
5) Какие инструменты стоит использовать вOpen-source стеке?
- MLflow (трекер и управление моделями), DVC (версионирование данных), Kedro (структура проектов), Kubeflow (пайплайны), CatBoost (табличные данные), PyTorch/TensorFlow (модели).
6) Какие российские решения и локализация стоит учитывать?
- Яндекс.Облако (Yandex.Cloud) — управляемые ML-сервисы и инфраструктура. CatBoost — библиотека, высочайшая производительность на табличных данных. Сбер ИИ/СберCloud — платформа для разработки и эксплуатации ML-сервисов. Включайте требования по локализации данных, регулированию и соответствию норм.
7) Какое место занимает этика и приватность в портфеле?
- Этика и приватность должны быть встроены в governance: политики обработки данных, аудит, контроль доступа, безопасность, снижение предвзятости моделей и прозрачность решений.
8) Что делать, если данные плохи или недоступны?
- Используйте подходы к управлению качеством данных, активное извлечение значимых признаков, обработку пропусков, создание synthetic data там, где это уместно, и переориентируйтесь на дополнительные источники данных.
9) Какие риски чаще всего мешают масштабированию AI?
- Низкое качество данных, нехватка квалифицированных специалистов, отсутствие единой инфраструктуры, сопротивление изменениям и ограничение бюджета. Планирование риска и гибкость дорожной карты помогают снижать риски.
10) Как внедрять AI в существующие бизнес-процессы без хаоса?
- Следуйте поэтапной модели: пилоты → MVP → доклад по ROI и рискам → интеграция в бизнес-процессы с четкими SLA и мониторингом. Обеспечьте управление изменениями, коммуникацию с бизнес-пользователями и обучение сотрудников.
Мы проектируем AI-решения корпоративного уровня с учетом требований к безопасности, интеграции и масштабируемости: on-premise, приватные облака, RAG, векторные базы данных. Поможем подобрать архитектуру под ваши задачи и ограничения.


