

Модели затрат: вычисления, хранение, перемещение
Аналитические платформы работают на стыке больших данных и вычислительных требований, что делает управление затратами сложной и критически важной задачей. В условиях волатильного спроса на ресурсы, расширенной мультиоблачной инфраструктуры и разнообразия сервисов, эффективная модель затрат становится не столько вопросом бюджета, сколько архитектурной особенностью самой платформы. Эта глава посвящена моделям затрат, их структурированию и практическим подходам к учету, распределению и оптимизации расходов на вычисления, хранение и перемещение данных в контексте cost-management аналитических систем.
В современных условиях важна не только точность расчётов, но и прозрачность моделей, способность масштабироваться под разные сценарии использования и поддерживать управляемые режимы финансирования. Рассматриваемые подходы ориентированы на техническую реализацию: архитектурные решения, протоколы взаимодействий, алгоритмы расчета и интеграции с инструментами мониторинга. Мы исходим из предположения, что целевой аудитории являются инженеры по данным, DevOps и архитекторы платформ, которым нужно не только понять «что считать», но и определить «как считаться» в рамках конкретного контекста организации.
- Обоснованное моделирование затрат требует четкого разделения драйверов расходов на вычисления, хранение и движение данных, а также учёта управляемости и воздействия на производительность.
- Эффективность cost-management достигается через сочетание архитектурной прозорливости, процессов управления затратами и технологических инструментов, поддерживающих прозрачность и автоматизацию.
- Важными элементами являются тегирование ресурсов, распределение по центрам ответственности, контроль доступа к данным о расходах и регулярная калибровка моделей затрат под фактическое поведение системы.
Архитектура затрат и драйверы расходов
В аналитической платформе стоимость складывается из нескольких взаимосависимых компонентов. Ключевые блоки включают вычислительные кластеры (для ETL/ELT процессов, аналитических запросов и обучения моделей), систему хранения (хранилище raw/curated/serving слоя данных, промежуточное кэширование), а также сетевые взаимодействия и служебные сервисы управления инфраструктурой. Прямые затраты, такие как стоимость виртуальных машин или контейнеров, напрямую зависят от конфигурации и долговременной политики использования: on-demand против reserved/spot и от скорректированной по фактическому спросу эластичности.
- Архитектурный паттерн: разделение стадий вычислений и хранения с явной границей между control plane и data plane упрощает прогнозирование затрат и позволяет задавать разные режимы масштабирования для разных элементов стека.
- Эластичность и тайминг: выбор между постоянной загрузкой и автошкалированием критично влияет на стоимость. В некоторых сценариях разумна комбинация вариантов: постоянный пул небольшого размера для контролей и периодические пулы для пиковых запросов.
- Категории хранения: hot storage для оперативной обработки иServing слои с более высокой доступностью и меньшими задержками, cold storage для архивирования и long-term retention. Между ними присутствуют политики жизненного цикла и конвертация форматов данных для оптимизации затрат на хранение.
- Передача данных: внутренняя передача в рамках одного облака и региона дешевле внешних каналов, а межрегиональные операции и egress часто становятся одним из самых значительных драйверов затрат.
- Протоколы и интеграции: REST/gRPC API для управления ресурсами, стандартные протоколы безопасности, обмен метаданными и аудитом. Важна интеграция с системами мониторинга затрат, чтобы обеспечить единый источник данных.
Архитектурные паттерны
- Многоуровневая архитектура расходов: разделение источников затрат по слоям (инфраструктура, данные, сервисы) и возможность их виртуального выделения в рамках бюджета конкретного проекта.
- Контроль доступа и сегментация: бюджетирование и распределение затрат через тегирование и центры ответственности. Прозрачность достигается за счет согласованных схем тегирования и единых правил отчетности.
- Модели оплаты и агрегации: поддержка на уровне инфраструктуры нескольких провайдеров с консолидированием затрат в единой витрине. Это требует согласованных стратегий агрегации и согласования форматов экспорта данных расходов.
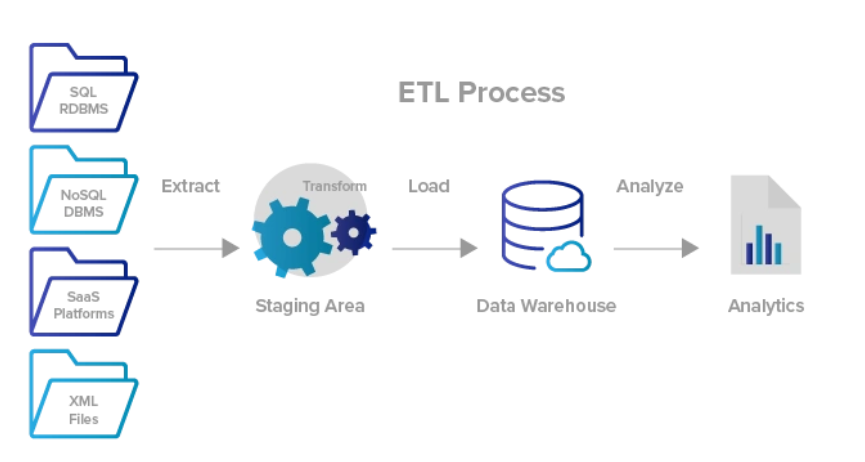
- Инструменты и данные: внедрение централизации витрины затрат, сбор метрик и распределение по проектам через единый конвейер ETL, который учитывает уникальные требования каждого провайдера.
В рамках технической реализации полезно рассмотреть примеры интеграций с инструментами мониторинга затрат. Для открытых решений на Kubernetes часто применяют Kubecost и OpenCost - они позволяют маппировать расходы на поды, namespace и сервисы, связывая их с тегами и проектами. В рамках российского рынка для оценки затрат можно опираться на нативные возможности Яндекс.Облако и других платформ, где доступны механизмы экспорта затрат и политики бюджетирования. Комбинация внешних инструментов и внутренних правил управления позволяет создать единый цикл планирования, мониторинга и оптимизации затрат.
## Пример упрощенной функции расчета общей стоимости
## (числа условны; для реальных сценариев требуется привязка к API провайдера)
def total_cost(hours, vcpu_rate, storage_gb, storage_rate, data_transfer_gb, egress_rate):
    compute = hours * vcpu_rate
    storage = storage_gb * storage_rate
    transfer = data_transfer_gb * egress_rate
    return compute + storage + transfer
Модели затрат и их сущности
Стоимость аналитической платформы формируется как сумма нескольких базовых элементов: вычисления, хранение, перемещение данных и управляемые сервисы. При этом важна не только величина каждой компоненты, но и ее динамика во времени, а также возможность адаптации под конкретные сценарии работы команды аналитиков, дата-ученых и бизнес-организации.
- Основные драйверы затрат:
- Вычисления: стоимость виртуальных машин, контейнеров, серверлес-исполнения, автоматическое масштабирование и пиковые нагрузки на запросы и обучение моделей.
- Хранение: различия между горячим и холодным хранением, формат данных (плотность сжатия), частота доступа, резервирование и политики жизненного цикла.
- Передача данных: внутрирегиональная, межрегиональная и внешняя передача, а также стоимость кэширования и репликации.
- Управляющие сервисы: оркестрация, мониторинг, security и прочие управляемые сервисы, которые добавляют накладные расходы, но необходимы для стабильности и безопасности.
- Модели оплаты:
- On-demand (плата за фактическое использование) и резервы (Reserved Instances или Savings Plans) для предсказуемых пиков.
- Спотовые/преребуемые ресурсы в рамках допустимой волатильности нагрузки.
- Компонентная тарификация: стоимость часто выражается как сумма себестоимости по каждому элементу стека (вычисления, хранение, сеть) и агрегируется в стоимость проекта.
- Этапы расчета и распределения:
- Метки и распределение по проектам/отделам: tagging strategy и соответствие тегам бюджету.
- Выбор единиц учёта: cost per query, cost per GB processed, cost per GB stored, cost per vCPU-hour.
- Валидация и корректировка: периодическая калибровка моделей затрат на основе фактических данных использования и изменений цен на инфраструктуру.
Ключ к эффективному управлению затратами - это способность сопоставлять стоимость конкретной операции с ее бизнес-ценностью. Например, высокая стоимость сложного аналитического запроса может быть оправдана, если он обеспечивает критичное для бизнеса своевременное принятие решения. С другой стороны, повторяющиеся дешевые операции, но частые, могут потребовать оптимизации через кэширование, материализованные представления или перераспределение вычислительных ресурсов.
-
Важно учитывать не только текущую стоимость, но и будущее поведение нагрузки: как изменится расход при росте числа пользователей, изменении скорости загрузки данных, или внедрении нового типа вычислительных задач.
-
Ввод в архитектуру принципов затрат должен сопровождаться планом «снижения затрат» на уровне дизайна: выбор оптимальных форматов хранения, вынесение части задач в периоды низкой цены, применение методов ускорения обработки.
-
Для контроля и прозрачности целесообразно связывать данные затрат с бизнес-сьюзами: какие проекты или команды несут ответственность за затраты, какие метрики служат критериями эффективности и окупаемости инвестиций.
## Пример SQL-подхода к агрегации затрат по тегам (упрощенный пример)
SELECT
  project_tag AS project,
  service_tag AS service,
  SUM(cost) AS total_cost,
  AVG(rate_per_unit) AS avg_rate
FROM cost_export
GROUP BY project_tag, service_tag
ORDER BY total_cost DESC;
Современные инструменты поддержки моделирования затрат включают как коммерческие решения облачных провайдеров, так и открытые проекты. Kubecost и OpenCost являются примерами open-source инструментов, позволяющих распределять затраты по подам и сервисам в Kubernetes, связывать их с тегами и проектами, а также строить графики использования и прогноза затрат. В рамках российского контекста полезна интеграция с аналогичными витринами затрат Яндекс.Облако и инфраструктурными сервисами, которые предоставляют экспорт затрат и политики бюджетирования для внутренних подразделений.
-
Уровень детализации затрат на уровне сервисов должен соответствовать требованиям бизнеса: для одних проектов достаточно агрегатов по каждому приложению, для других - по функциональным блокам (ETL, BI, ML). Гибкость в выборе уровня агрегации и форматов экспорта данных критически важна.
-
Внутренние политики использования (policy-as-code) позволяют обеспечить единообразие расчета затрат по всем проектам и снизить риск ошибок в учете.
Влияние хранения и перемещения данных на стоимость
Хранение и перемещение данных существенно влияют на экономику аналитической платформы. Тесная связь между форматом данных, стратегиями хранения и механизмами передачи приводит к различным профилям затрат, которые при правильном управлении дают ощутимую экономию.
- Уровни хранения: горячее (active/интерактивный доступ), тёплое (часто используемые данные для повторных запросов), холодное (архивы, редко используемые наборы). Каждая категория имеет свой профиль затрат и требования к времени доступа.
- Форматы и сжатие: выбор форматов столбцовых хранилищ (Parquet, ORC) и агрессивное сжатие снижают стоимость хранения и сетевых операций. Однако слишком сильное сжатие может повлиять на скорость обработки. Баланс достигается через профилирование нагрузки и типы запросов.
- Передача данных: сетевые затраты зависят от объема, направления и региона. Передача внутри региона и внутри облака дешевле, чем между регионами и/или между провайдерами. Репликации для обеспечения доступности и снижения задержек увеличивают затраты, их следует обосновать бизнес-кейсом.
- Архитектура хранения-вычисления: перенос больших объёмов данных между слоями может повысить сетевые расходы. Рекомендуется минимизировать объём переноса и локализовать вычисления рядом с данными, если это возможно.
Практические принципы управления хранением и переносом данных:
- Политика жизненного цикла: автоматическое перемещение данных в холодное хранение спустя заданный период, удаление устаревших данных в соответствии с регламентами.
- Внедрение слойности: хранение наиболее востребованных наборов данных на быстрых носителях, а архивирование менее используемых материалов - в менее дорогих платформах.
- Оптимизация форматов: выбор эффективных форматов и включение сжатия там, где это приемлемо для задачи; раздельное хранение исходных данных и обработанных вариантов.
- Учет сетевых сценариев: учет затрат на egress и cross-region replication, планирование маршрутов передачи, контроль за количеством копий.
## Пример того, как можно моделировать стоимость хранения и передачи в простой форме
def storage_cost(size_gb, storage_rate_per_gb):
    return size_gb * storage_rate_per_gb

def egress_cost(size_gb, egress_rate_per_gb):
    return size_gb * egress_rate_per_gb

## Пример применения
hot_cost = storage_cost(500, 0.023)  # горячее хранение
cold_cost = storage_cost(1000, 0.004)  # холодное хранение
egress = egress_cost(200, 0.09)

total = hot_cost + cold_cost + egress
С учетом различий между облачными провайдерами и локальными инфраструктурами целесообразно использовать единый подход к моделированию затрат, который обеспечивает видимость по слоям хранения и движения данных. Kubecost и OpenCost позволяют связывать затраты с конкретными сервисами и проектами, а также предоставляют инструменты для анализа влияния изменений политики хранения на общую стоимость. В сочетании с локальными правилами бюджетирования данная практика позволяет снижать издержки без снижения функциональности аналитических рабочих нагрузок.
Методы учёта, распределения и отчетности по затратам
Эффективное управление затратами требует не только точного расчета, но и прозрачной отчетности и справедливого распределения расходов между командами и проектами. В этом контексте ключевые принципы включают тегирование, распределение затрат по центрам ответственности, а также регулярную сверку фактических затрат с плановыми.
- Тегирование и сегментация: четкая стратегия тегирования ресурсов и сервисов, привязка затрат к конкретным бизнес-объектам (проектам, витринам услуг, отдела). Это позволяет агрегировать затраты и формировать точные бюджеты.
- Центры ответственности и консолидированная витрина затрат: создание единых центров затрат, где агрегируются расходы по проектам или департамента по единым правилам и форматам экспорта.
- Политика бюджетирования и alerts: настройка порогов расходов и уведомлений, автоматическая блокировка или ревизия операций при нарушении бюджета.
- Отчетность и аудит: регулярные отчеты по затратам за выбранный период, сравнительный анализ с предыдущими периодами, детальный разбор по категориям и проектам. Важно обеспечить возможность экспорта данных в формате, удобном для бизнес-пользователей и аудита.
Практические шаги реализации
- Определение политики тегирования: какие ресурсы тегируются, какие теги обязательны, и как они используются в отчётности.
- Архитектура витрины затрат: единая база данных или дата-каталог, куда складываются данные по расходам из разных источников (облачная платформа, сервисы мониторинга, внутренние системы).
- Автоматизация агрегаций: настройка ETL-процессов для загрузки затрат и расчета KPI по каждому проекту.
- Поддержка сценариев «показывать/оказывать» (showback/chargeback): принципы распределения затрат между подразделениями, бюджетирование и учет пользователей.
- Построение дашбордов и оповещений: инструменты визуализации и мониторинга затрат, доступные бизнес-пользователям.
- Валидация и аудит: периодическая сверка затрат с юридическими и бухгалтерскими учетами, контроль версий моделей затрат.
## Пример запроса к витрине затрат:
SELECT
  project_id,
## SUM(cost) AS total_cost,
  SUM(CASE WHEN service = 'compute' THEN cost END) AS compute_cost,
  SUM(CASE WHEN service = 'storage' THEN cost END) AS storage_cost
FROM cost_ledger
GROUP BY project_id
ORDER BY total_cost DESC;
OpenCost и Kubecost предоставляют готовые политики и шаблоны отчетности, помогающие быстро внедрить единый стандарт расчета затрат и упорядочить доступ к данным. В рамках российского рынка можно использовать встроенные в Яндекс.Облако механизмы экспорта затрат и бюджетирования для построения полной картины расходов по проектам. В сочетании с локальными процессами согласования и аудита такая архитектура позволяет не только отслеживать текущие траты, но и прогнозировать будущее потребление и корректировать стратегию использования вычислительных ресурсов и хранения данных.
Инструменты мониторинга, оптимизации и управление изменениями
Эффективное управление затратами предполагает непрерывное наблюдение за расходами и оперативное применение мер оптимизации. В качестве базовой архитектуры целесообразно использовать сочетание инструментов облачного провайдера, открытых решений и внутреннего контроля.
- Инструменты мониторинга затрат:
- Облачные панели и решения провайдеров (AWS Cost Explorer, GCP Cloud Billing, Azure Cost Management) дают базовую видимость по сервисам и проектам.
- Kubecost и OpenCost предоставляют детальную привязку затрат к подам, контейнерам и самим сервисам Kubernetes, что полезно для гибкой оптимизации вычислительных рабочих нагрузок.
- Инструменты витрины затрат, адаптированные под российские провайдеры, обеспечивают соответствие локальным требованиям по учету и бюджетированию.
- Методы оптимизации:
- Right-sizing и предиктивное масштабирование: анализ текущих и прогнозируемых нагрузок, коррекция размеров инстансов и ресура резерва, чтобы минимизировать перерасход.
- Использование резерва и спотовых ресурсов там, где это допустимо с точки зрения требований к доступности и задержкам.
- Оптимизация хранения: выбор форматов, компрессии, политики жизненного цикла и кэширования для минимизации затрат на хранение и сетевые операции.
- Оптимизация сетевых расходов: минимизация объемов egress, локализация вычислений там, где данные находятся, и использование оптимальных маршрутов.
- Управление изменениями и политики:
- Правила «policy-as-code» для автоматизации бюджетирования, тегирования и ограничения доступа к ресурсам с высокой стоимостью.
- Регулярные ревизии моделей затрат и обновления ценовых гипотез, чтобы отражать изменения на рынке и внутри организации.
- Автоматизированные тесты экономической целесообразности изменений архитектуры и конфигурации платформы.
## Пример простого правила выявления аномалий затрат
def detect_anomalies(current, baseline, threshold=0.2):
    diff = (current - baseline) / baseline
    return diff > threshold
Эффективная стратегия мониторинга затрат должна сочетать автоматизацию, прозрачность и тесное взаимодействие с бизнес-пользователями. Kubecost и OpenCost предоставляют механизмы для настройки предупреждений на уровне проектов и сервисов, что позволяет оперативно реагировать на неожиданные рост затрат. В свою очередь, нативные инструменты провайдеров дополняют картину, обеспечивая общую видимость по всем уровням инфраструктуры. В этом контексте целесообразно выстраивать регулярные итерации по оптимизации и обучать команду принятым практикам, чтобы затраты не только контролировались, но и становились управляемым активом, поддерживающим бизнес-цели.
Интеграции и протоколы взаимодействия с облачными провайдерами
Эффективное управление затратами требует единых протоколов взаимодействия между платформой и облачными провайдерами. В рамках архитектуры следует выделить механизмы экспорта затрат, унификацию форматов данных и обеспечение безопасного доступа к учетным данным.
- Экспорт затрат и конвергенция форматов: экспорты CUR/Cost and Usage (AWS), Billing export (GCP) и Cost Management (Azure) должны попадать в единый конвейер витрины затрат. Важно согласовать частоты экспорта, уровень детализации и формат агрегации.
- Интеграция с витриной затрат: консолидированная витрина должна принимать данные из различных источников и приводить их к единому схеме тегов, проектной иерархии и единицам измерения.
- Протоколы и безопасность: использование безопасных сервисных учетных записей, ролей и ключей, аудит доступа к данным по затратам, шифрование данных на repose и в канале передачи.
- Архитектура интеграции: горизонтальная масштабируемость конвейера загрузки данных, устойчивые очереди (например, Kafka) и этапы обработки (Нормализация, агрегация, инференс по бюджету).
- Партнерство с провайдерами: использование готовых механик бюджетирования и рекомендаций по оптимизации, адаптированных под нужды бизнеса и регуляторных требований.
Примерно так строится устойчивый цикл управления затратами: экспорт затрат из облака - нормализация - агрегация - связывание с бизнес-единицами - визуализация - коррекция конфигураций и политик. В рамках российского контекста полезна синхронизация с локальными сервисами бюджета и финансовой аналитикой, чтобы обеспечить единый, прозрачный и контролируемый процесс принятия решений.
- Концептуальные принципы: единый источник правды для затрат, прозрачная структура данных и понятные политики распределения, возможность адаптировать правила под изменения в бизнес-структуре и политике цены.
- Примеры интеграций: AWS/Azure/GCP совместно с Kubecost/OpenCost; Яндекс.Облако для локальной интеграции с бюджетной и финансовой компанией.
Key takeaways
- Модели затрат аналитических платформ должны учитывать вычисления, хранение и передачу данных как взаимосвязанные драйверы, а не независимые блоки.
- Эффективное управление затратами достигается через структурированное тегирование, распределение затрат по центрам ответственности и единые витрины затрат.
- Выбор архитектурного паттерна для размещения ресурсов влияет на стоимость и качество обслуживания; критически важна локализация вычислений близко к данным и разумная эластичность.
- Хранение и перемещение данных требуют баланса между форматом, сжатием, политиками жизненного цикла и географией размещения; оптимизация должна быть встроенной частью дизайна.
- Инструменты мониторинга затрат (как облачные решения provider-специфичны, так и open-source Kubecost/OpenCost) должны использоваться в сочетании с корпоративными процессами бюджета и аудитом.
- Гибридные и мультиоблачные стратегии требуют единого конвейера экспорта затрат и согласованных правил агрегации, чтобы обеспечить прозрачность и управляемость.
- Политика управления изменениями, включая policy-as-code и автоматизированные оповещения, позволяет поддерживать бюджет и минимизировать риск перерасхода.
FAQ
Вопрос: Что понимать под "моделями затрат" в контексте аналитических платформ?
Модели затрат - это набор конвенций, формул и правил, позволяющих превратить расход ресурса в управляемую валюту для бизнеса. Они включают драйверы вычислений, хранения и передачи данных, режимы оплаты, методы распределения затрат между проектами и отделами, а также правила бюджетирования и прогнозирования. Модель должна быть прозрачной, документированной и легкой для обновления по мере изменений в инфраструктуре или ценах.
Вопрос: Какова роль тегирования в управлении затратами?
Тегирование - это средство привязки затрат к конкретным бизнес-объектам: проектам, командам, сервисам. Без корректного тегирования невозможно точно сопоставлять расходы с ответственными за них направлениями. Эффективная практика включает обязательные теги, единые правила именования и автоматическую проверку соответствия тегов в конвейере развертывания и мониторинга.
Вопрос: Какие инструменты лучше использовать для контроля затрат в Kubernetes?
Открытые инструменты Kubecost и OpenCost предоставляют детализированную разбивку затрат по подам, неймспейсам и сервисам Kubernetes, а также связывают их с тегами и проектами. В комплект к ним можно подключить облачные панели провайдеров для общей видимости по всей инфраструктуре. В зависимости от региона и провайдера можно также использовать локальные инструменты бюджетирования, предлагаемые облачными платформами.
Вопрос: Как организовать баланс между скоростью выполнения процессов и стоимостью?
Необходимо строить архитектуру вокруг принципа right-sizing и гибкого масштабирования. Для критичных операций можно оставить более быстрые, но дорогие ресурсы, а для фоновых и периодических задач - дешевые источники, спотовые или резервированные, с учётом требований по доступности. Кроме того важно использовать кэширование и материализованные представления там, где это снижает повторную обработку без потери точности.
Вопрос: Какие данные должны попадать в единый витрин затрат?
Витрина затрат должна включать данные по вычислениям (vCPU-hour), хранению (GB-месяц, тип хранения), передаче (GB egress), управляемым сервисам и региональным расходам. Форматы экспорта должны поддерживать единые единицы измерения и идентификаторы проектов/команд, чтобы обеспечить корректную агрегацию и сопоставление.
Вопрос: Как обеспечить соответствие затратам требованиям регуляторики и аудита?
Необходимо внедрить контроль доступа к данным затрат, журналирование изменений моделей затрат и версионирование конфигураций бюджета. Регулярно проводите аудит соответствия тегов, политик бюджетирования и источников экспорта затрат. Включите в процесс проверки тесты на корректность агрегаций и сверку с бухгалтерскими данными.
Вопрос: Какие методики прогнозирования затрат наиболее эффективны?
Эффективны методы анализа трендов на основе истории использования и ценовых изменений, сценарное планирование под разные режимы нагрузки (пиковый, умеренный, базовый), а также моделирование влияния изменений архитектуры на стоимость. Важна регулярная калибровка моделей затрат с опорой на фактические данные использования и внедренные меры оптимизации.
Вопрос: Как связать стоимость с бизнес-ценностью?
Включение бизнес-показателей в модели затрат, таких как окупаемость проектов, скорость принятия решений и доступность аналитики, помогает обосновать инвестиции в инфраструктуру и оптимизации. Пример: если конкретный детализированный SQL-запрос обеспечивает критическую операцию бизнеса, можно обосновать выделение ресурсов и, наоборот, перераспределение в менее критичные задачи для экономии.
Вопрос: Какие риски чаще всего возникают в моделях затрат и как их минимизировать?
Основные риски - неверные теги, задержки в экспортах затрат, расхождение форматов, недооценка сетевых затрат и изменения в ценах провайдеров. Минимизация достигается через внедрение policy-as-code, автоматизацию верификации тегов и соответствия, регулярную сверку затрат с данными бюджета, а также внедрение предупреждений об аномалиях и стресс-тестов архитектуры.
Вопрос: Какой подход применить к мультиоблачной среде?
В мультиоблачной среде целесообразно строить единый конвейер экспорта затрат и унифицированную витрину данных в рамках общего формата метрик. Это требует четкой политики тегирования и согласованных правил распределения расходов между облачными провайдерами, а также инструментов, которые позволяют сравнивать ценовые показатели и выбрать оптимальные комбинации ресурсов. В этом контексте open-source решения и провайдерские панели должны дополнять друг друга, обеспечивая полноту и прозрачность данных.
Эта глава предоставила систематизированное видение моделей затрат аналитических платформ: от архитектурных причин, обуславливающих формирование затрат, до практических подходов к учету, распределению и снижению расходов. В условиях цифровой трансформации стоимость должна рассматриваться как управляемый элемент инфраструктуры, а не как побочный эффект. Принципы, описанные здесь, позволяют обеспечить не только контроль затрат, но и поддержку инноваций за счет прозрачности, предсказуемости и способности к гибкой адаптации под меняющиеся бизнес-требования и технологические реальности.


