

Введение в AI Maturity: цели, контекст и ценность
AI-мaturity (зрелость AI) — это многомерная концепция, которая оценивает, на каком уровне организация управляет данными, моделями и процессами, чтобы приводить AI-инициативы в устойчивый бизнес-результат. В современном мире многие проекты искусственного интеллекта остаются экспериментами в лабораториях и нишевых командах. Зрелость модели зрелости позволяет увидеть не только техническое исполнение, но и готовность организации к масштабированию, управлению рисками, этике и устойчивой эксплуатации.
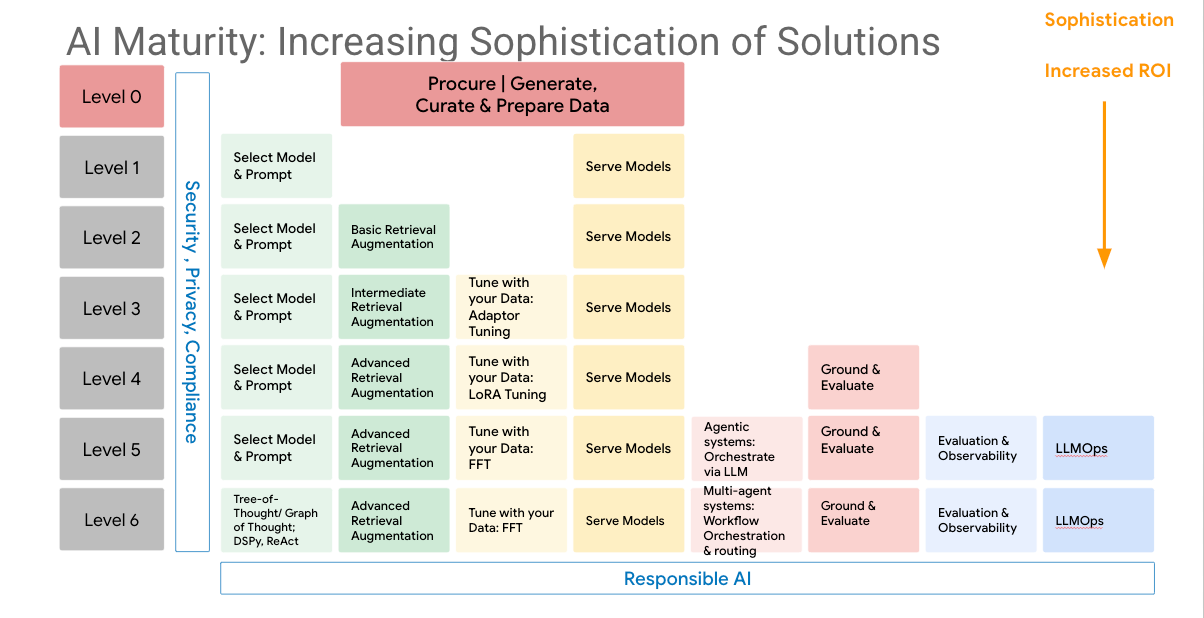
Зачем нужна оценка зрелости AI?
- Стратегическое выравнивание: чтобы убедиться, что усилия по AI поддерживают бизнес-цели и приносят ожидаемую ценность.
- Управление рисками: моделирование риска на этапе проектирования, мониторинг в продакшене и автоматическое реагирование на drift.
- Масштабирование: переход от отдельных успешных проектов к общекорпоративной архитектуре и инфраструктуре MLOps.
- Этические и регуляторные требования: обеспечение прозрачности, управления данными и соответствия правилам (локализация данных, хранение журналов, безопасная эксплуатация моделей).
Ключевые понятия
- Мaturity model (модель зрелости): набор уровней/путей, по которым оценивается способность организации реализовывать и эксплуатировать AI-решения.
- Governance (управление): совокупность политик, процедур и ролей, которые обеспечивают надзор за данными, моделями и процессами.
- MLOps: практики, инструменты и методологии, объединяющие разработку моделей и их эксплуатацию.
- Data quality и data lineage: качество данных, их происхождение и трассируемость изменений.
- Model risk management и monitoring: контроль риска моделей, мониторинг производительности и поведения в реальном времени.
- KPI и бенчмаркинг: конкретные метрики для оценки эффективности и сравнения с отраслевыми аналогами.
Модель зрелости как набор уровней
- Уровень 1 — Ad hoc и хаос: данные фрагментарны, нет общего каталога данных, эксперименты проводятся в изоляции, отсутствуют регистры моделей.
- Уровень 2 — Foundational: базовая инфраструктура данных и инфраструктура ML-пайплайнов, начальная систематизация экспериментов, но производство часто вынуждено вручную.
- Уровень 3 — Managed: формальные процессы, регистр моделей, мониторинг критических метрик, базовый набор политик кибербезопасности и соответствия.
- Уровень 4 — Quantitatively managed: управляемые бюджеты, ROI-метрики, детальное управление зависимостями, расширенное тестирование и валидация, действительно масштабируемые пайплайны.
- Уровень 5 — Optimized: непрерывная оптимизация, автоматическое обновление моделей, корпоративная архитектура, глобальное использование и автономная адаптация к изменениям среды.
Основные направления оценки
- Стратегия и управление: видение AI-стратегии, софт-горизонты, приоритеты проектов, связь с бизнес-целями.
- Архитектура и пайплайны: данные, инфраструктура, инструменты, конвейеры разработки и вывода в продакшн.
- Качество данных и обработка: качество, полнота, консистентность, управляемость изменений данных.
- Удаленная и локальная безопасность: политика доступа, данные под GDPR-аналоги, локализация, аудит журналирования.
- Этика и риск: управление предвзятостью, прозрачность моделей, возможность аудита решений.
- Команда и культура: компетенции, обучение, управление изменениями, взаимодействие между бизнесом и техподразделениями.
Метрики и KPI
- Стратегические: ROI, увеличение выручки за счет AI, снижение затрат, ускорение time-to-market.
- Технологические: стабильность пайплайнов, время развертывания, процент покрытых бизнес-задач автоматизацией.
- Этические и регуляторные: соблюдение правил обработки данных, число инцидентов, объем мониторинга и аудита.
- Данные и качество: точность входных данных, полнота, соответствие требованиям качества.
- Операционные: активность мониторинга, скорость обнаружения и исправления дрейфа, частота регрессионного тестирования.
Таблица: уровни зрелости и их характеристики
| Уровень | Основные черты | Примеры процессов | Метрики |
|---|---|---|---|
| 1 Ad hoc | Нет единых стандартов, данные разрознены | Лабораторные эксперименты, без регистров | Нет устойчивых KPI, отсутствуют регламенты |
| 2 Foundational | Базовая инфраструктура данных, первые пайплайны | Инвентаризация данных, базовый мониторинг | Включение данных в пайплайны, начальный мониторинг |
| 3 Managed | Регистрация моделей, governance, контроль качества | Управляемые пайплайны, базовый аудит | Время развёртывания, качество данных, регламентированные проекты |
| 4 Quantitatively Managed | Метрики ROI, управляемые бюджеты, полноценный мониторинг | Model registry, drift monitoring, cost control | ROI, стабильность, частота обновлений |
| 5 Optimized | Масштабирование, автоматизация, непрерывное улучшение | Распространение по предприятиям, автономная оптимизация | Непрерывный рост Business KPIs, минимизация ошибок |
Практические примеры: как начать путь к зрелости
Пример A: Самостоятельная проверка (self-assessment)
- Шаги: собрать ответы по ключевым вопросам для каждого направления; определить зоны риска и приоритетности для пилотного проекта.
- Вопросы: есть ли регистр моделей? каковы политики доступа? как часто выполняется мониторинг производительности? какие данные используются в модели?
Пример B: Связывание KPI проекта с бизнес-целью
- Укажите цель проекта (например, снизить churn, повысить конверсию) и сопоставьте с конкретными метриками: точность предикта, экономический эффект, время отклика пайплайна.
Пример C: Путь к практическим решениям в рамках конкретного кейса
- Кейс: детектирование мошенничества. Этапы: сбор данных, обработка, выбор признаков, обучение, мониторинг, настройка тревог, регуляторный контроль.
Практические примеры: open-source и российские решения
Open-source инструменты, которые часто применяются на разных уровнях зрелости:
- MLflow: отслеживание экспериментов, реестр моделей, повторяемость
- Kubeflow: end-to-end конвейеры ML-процессов
- Apache Airflow / Dagster: оркестрация ETL и пайплайнов
- Feast: хранение и доступ к фичам (feature store)
- Great Expectations: качество данных и тесты данных
- DVC (Data Version Control): управление версиями датасетов
Российские решения и площадки (примерные названия и применения):
- Яндекс DataSphere (YDS): платформа для обработки данных, разработки моделей, интеграция с пайплайнами MLOps, мониторинг и реестр моделей — широко применяется в российских проектах и помогает в управлении данными и моделями на scale.
- СберКлауд/СберAI: набор сервисов MLOps (регистрация моделей, мониторинг, управление версиями, обеспечение безопасности) для эксплуатации моделей в продакшене в рамках экосистемы Сбербанка и партнерских проектов.
- DeepPavlov и сопутствующие экосистемы: открытая NLP-библиотека и набор инструментов, которые можно использовать в тестовой среде и для локализации решений под RU-рынок.
- Локальные проекты и интеграции: интеграции платформ под требования российского законодательства, локализация инструментов мониторинга и аудита, использование локальных источников данных и политик доступа.
Архитектура MLOps
- Рекомендованная конструкция: Data Lake/Delta Lake или подобная система хранения данных; слой подготовки данных; feature store; модельный регистр; пайплайны обучения; пайплайны деплоя; мониторинг и алерты.
- Взаимодействие команд: бизнес-аналитика и продукт-менеджеры формируют требования, инженеры данных подготавливают данные, инженеры ML — модели, платформенные инженеры — инфраструктуру и пайплайны; оценка рисков — риск-менеджеры и комплаенс.
Инструменты (open-source)
Data quality и governance:
- Great Expectations: создание и исполнение тестов данных, валидация входов в пайплайн;
- на усмотрение: Apache Atlas/Amundsen для каталогизации и отслеживания данных.
Эксперименты и регистр моделей:
- MLflow: отслеживание параметров, метрик и артефактов; реестр моделей;
- DVC: контроль версий наборов данных и моделей.
Оркестрация и пайплайны:
- Apache Airflow / Dagster / Prefect: оркестрация конвейеров обучения и деплоя;
- Kubeflow: полноценная платформа для конвейеров ML в Kubernetes.
Фичи и обучение:
- Feast: где и как брать фичи для использования в моделях;
- Notebook-окружения и вычислительные кластеры (Jupyter, JupyterHub, Zeppelin).
Обеспечение качества и мониторинг:
- Prometheus/Grafana: мониторинг инфраструктуры и моделей;
- сервисы мониторинга drift и аномалий (custom alerting на основе метрик).
Пример технической реализации: YAML/кодовые фрагменты
Пример 1: простой трекер экспериментов с использованием MLflow (Python)
# mlflow_demo.py
import mlflow
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

X, y = load_iris(return_X_y=True)
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)

mlflow.set_experiment("ai_maturity_demo")

with mlflow.start_run():
    model = RandomForestClassifier(n_estimators=150, random_state=42)
    model.fit(X_train, y_train)
    preds = model.predict(X_val)
    acc = accuracy_score(y_val, preds)

    mlflow.log_param("model_type", "RandomForest")
    mlflow.log_param("n_estimators", 150)
    mlflow.log_metric("accuracy", float(acc))

    # артефакт
    mlflow.artifact("model.pkl", "path/to/save/model.pkl")
Пример 2: базовый конвейер Kubeflow Pipelines (псевдокод, упрощенный)
from kfp import dsl

@dsl.pipeline(name="ai-maturity-demo", description="Простой пример MLOps-пайплайна")
def ai_maturity_pipeline():
    prepare = dsl.ContainerOp(
        name="data-prep",
        image="docker.io/ai/prep",
        arguments=["--input", "/data/raw", "--output", "/data/clean"]
    )
    train = dsl.ContainerOp(
        name="train-model",
        image="docker.io/ai/train",
        arguments=["--data", prepare.outputs["/data/clean"]],
    )
    evaluate = dsl.ContainerOp(
        name="evaluate-model",
        image="docker.io/ai/eval",
        arguments=["--model", train.outputs["model"]],
    )
    # логирование метрик
    log = dsl.ContainerOp(
        name="log-metrics",
        image="docker.io/ai/logger",
        arguments=["--metrics", evaluate.outputs["metrics"]],
    )
Пример 3: фрагмент конфигурации Feast (feature store)
# feast.yaml
project: ai_maturity_demo
registry: data/registry.db
provider: default
online_store:
  type: redis
  host: localhost
  port: 6379

entities:
  - name: customer_id
    join_keys: [ customer_id ]

features:
  - name: customer_features
    path: feature_repo.json
    entities: [ customer_id ]
Российские решения и адаптация под требования
- Яндекс DataSphere (YDS) позволяет объединить обработку данных, обучение моделей и мониторинг в единой среде. Это особенно полезно на этапе перехода от отдельных экспериментов к масштабируемым пайплайнам и управлению версиями моделей.
- СберКлауд/MLOps-инструменты для эксплуатации моделей в продакшене включают реестр моделей, мониторинг и управление безопасностью доступа. Подходит для организаций, которым важны регуляторные требования и локализация данных.
- Дизайн решений под RU-рынок часто предполагает локальные правила обработки данных, локализацию журналирования, соответствие правилам хранения и передачи данных в рамках российского законодательства.
Риски и ограничения внедрения
Технические риски
- Данные: качество, полнота и согласованность данных — основа любых ML-решений; плохие данные ведут к искажению моделей.
- Drift: концептуальный дрейф и дрейф входных данных требуют активного мониторинга и переобучения.
- Прозрачность и объяснимость: в некоторых сферах требуется объяснимость решений, особенно в финансах и здравоохранении.
- Мониторинг затрат: рост расходов на инфраструктуру и вычисления может оторваться от ожидаемой бизнес-ценности.
Организационные риски
- Культура и сотрудничество: без тесной координации между бизнесом, данными и инженерной командой невозможно достичь масштаба.
- Квалификация сотрудников: необходимы навыки в области данных, ML и эксплуатации систем.
- Соответствие и безопасность: требования к хранению данных, аудитории и управлению доступом.
Регуляторные и этические риски
- Защита персональных данных, локализация данных, требования к аудиту.
- Этические риски — предвзятость моделей, недопустимые решения, дискриминация.
Ограничения внедрения
- Не все организации готовы к переходу на продакшн: зачастую требуется реформа бизнес-процессов, внедрение новой инфраструктуры и изменение политики управления.
- Стоимость внедрения: на старте ROI может выглядеть неочевидно; важно планировать поэтапное внедрение и демонстрацию бизнес-ценности.
- Зависимость от поставщиков: выбор инструментов может привести к связке с конкретной экосистемой (к примеру, RU-заказчики часто смотрят на локальные решения и поддержку).
Выводы
- AI maturity — это не просто набор инструментов; это системная практика, объединяющая стратегию, данные, технологии и культуру организации.
- Уровни зрелости помогают структурировать путь от хаоса к масштабированию и устойчивой эксплуатации AI.
- Важными компонентами являются governance, data quality, monitoring, и способность к быстрому обучению и адаптации моделей в продакшене.
- Практическая реализация требует сочетания open-source инструментов и российских решений, чтобы обеспечить локализацию, безопасность и соответствие требованиям.
- Риски внедрения включают технические, организационные и регуляторные аспекты; управление ими требует планирования, обучения и последовательного роста.
Выводы по разделу: чтобы начать путь к AI-мaturity, следует:
- определить бизнес-цели и KPI;
- оценить текущее состояние по каждому направлению;
- выбрать набор инструментов и платформ (с учётом RU-реалий);
- разработать дорожную карту перехода по уровням зрелости;
- внедрить управление изменениями, обучение и мониторинг.
FAQ (Вопросы и ответы)
1) Что такое AI maturity и зачем она нужна организации?
AI maturity — это оценка того, насколько организация готова эффективно разрабатывать, внедрять и эксплуатировать AI-решения в масштабе. Она нужна для системного достижения бизнес-целей, снижения рисков, повышения скорости вывода продуктов на рынок и обеспечения управляемости проектов.
2) Какие уровни зрелости существуют и что означает каждый из них?
Уровни обычно варьируются от Ad hoc (хаос, без регламентов) до Optimized (масштабное внедрение и непрерывное улучшение). Примерные характеристики включают: наличие data governance, регистр моделей, мониторинг и управляемость расходов, способность адаптироваться к изменениям и автоматизировать процессы.
3) Какие KPI стоит использовать для оценки AI-мaturity?
Ключевые KPI: ROI AI-проектов, время вывода в продакшн, точность данных и моделей, стабильность пайплайнов, количество регистрируемых моделей и их соответствие требованиям аудита, показатели качества данных, кредитоспособность моделей и процент автоперекрестного тестирования.
4) Какие практики помогают перейти к следующему уровню зрелости?
Практики включают: формирование единой стратегии AI, создание регистров моделей и фичей, внедрение пайплайнов MLOps, мониторинг дрейфа и выработку политик безопасности, установку данных и дата-г治理, обучение команд, и регулярные аудиты.
5) Какие инструменты и платформы наиболее полезны для зрелости AI?
Open-source: MLflow, Kubeflow, Feast, Great Expectations, Apache Airflow, DVC. Российские решения: Яндекс DataSphere (YDS), СберКлауд/СберAI решения для MLOps. Они позволяют управлять данными, регистром моделей, пайплайнами и мониторингом в условиях локального соответствия.
6) Какие риски и ограничения часто возникают при внедрении?
Риски: качество данных, drift и предвзятость, безопасность и регуляторные требования, высокий первоначальный бюджет. Ограничения: недостаточная готовность бизнес-подразделений, нехватка квалифицированных сотрудников, сложность перехода к продакшну и необходимость изменения процессов.
7) Как начать оценку зрелости в своей организации?
1) Сформируйте команду и определите руководство по AI; 2) создайте базовую карту текущего состояния по направлениям (данные, инфраструктура, регламенты, мониторинг); 3) проведите self-assessment с использованием чек-листов; 4) определите приоритетные пилоты и KPI; 5) выберите инструменты и внедрите пилот; 6) расширяйте масштаб с учетом контроля затрат, аудита и мониторинга.
8) Как связать технологическую зрелость с бизнес-целями?
Связь достигается через формальные KPI и ROI, которые отражают стоимость данных, качество вывода моделек и влияние на ключевые бизнес-показатели. Включение бизнес-задач в дорожную карту AI-мaturity обеспечивает приоритетность проекта и ясные точки оценки.
9) Какие примеры российских и международных решений лучше рассмотреть на первом этапе?
Начните с ориентиров на уровне инфраструктуры: MLflow для трекинга экспериментов, Feast для фичей, Kubeflow или аналог для конвейеров, Great Expectations для качества данных, а также ознакомьтесь с Яндекс DataSphere и СберКлауд как российскими решениями для реализации пайплайнов и мониторинга в локальном контексте.
10) Как измерять прогресс по мере внедрения?
Регулярно проводите повторную оценку по тем же направлениям, отслеживайте KPI и регистрируйте изменения в регистре моделей и пайплайнах. Ведите аудит данных, мониторинг drift и отслеживание влияния изменений на бизнес-показатели.
Если вы рассматриваете AI как часть цифровой трансформации компании, мы поможем сформировать дорожную карту, оценить риски и запустить пилот с понятными метриками эффективности.


