

Безопасность, доступ и приватность
Безопасность, доступ и приватность — краеугольные камни любого проекта по внедрению Customer Data Platform (CDP) в контексте использования BI и Data Warehouse (DWH). Когда мы объединяем данные из разных источников, нормализуем их, совместно используем для аналитики и персонализации, риск утечки или неправомерного использования персональных данных возрастает пропорционально масштабу инфраструктуры и количества участвующих сторон. Цель данной главы — объяснить теоретические основы, познакомить с терминами и методологиями, привести практические примеры реализации на открытых и отечественных решениях, разобрать типичные риски и ограничения, а также дать понятный план действий для нового сотрудника.
Мы работаем с данными клиентов: их идентификаторы, контактные данные, поведение в цифровых каналах, покупки и взаимодействия. Любая аналитика здесь строится на чувствительной информации, которая подчиняется законам о персональных данных и требованиям внутренней безопасности. В CDP мы должны обеспечить конфиденциальность, целостность и доступность данных на протяжении всего жизненного цикла: от момента их сбора до архивирования и удаления. Важно помнить: безопасность — это не просто отдельная задача ИТ-отдела, это коллективная ответственность data owners, data stewards, инженеров по данным и бизнес-пользователей аналитики.
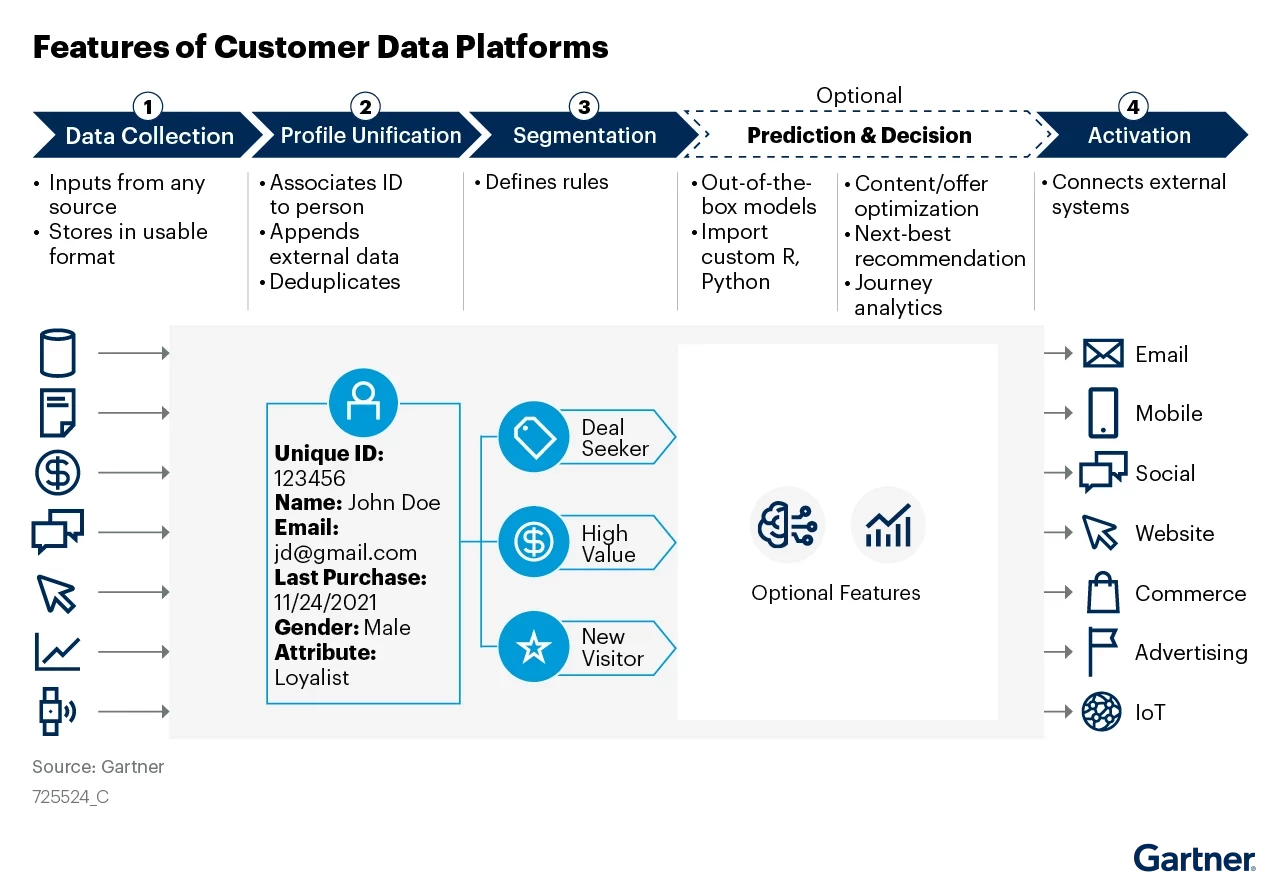
Ключевые термины
- CDP (Customer Data Platform) — платформа для объединения и унификации данных клиентов из множества источников, обеспечения единого профиля клиента, поддержки сегментации, персонализации и аналитики.
- DWH (Data Warehouse) — целостный репозиторий структурированных данных для бизнес-аналитики и отчетности.
- PII (персональные данные) — данные, по которым можно идентифицировать субъекта (имя, телефон, адрес электронной почты и т. п.). В некоторых случаях данные считаются чувствительными и требуют особой защиты.
- Локализация данных — требования хранить данные на территории конкретной юрисдикции (например, в РФ) и подчиняться соответствующим законам.
- RBAC/ABAC/DABAC — модели управления доступом: роль-базированное (RBAC), атрибутно-базированное (ABAC), динамическое атрибутное (ABAC) или гибридное.
- Zero Trust — концепция доверять никому и ничему по умолчанию внутри сети: постоянная проверка доступа, минимизация поверхностей атаки, микроразделение сетей.
- Data governance — набор политик, стандартов и процедур по управлению качеством данных, доступами, безопасностью и соответствием требованиям.
- Data lineage — прослеживаемость происхождения данных: кто создал, какие преобразования применял, куда ушли данные.
- Privacy by design / Security by design — встроенные принципы конфиденциальности и безопасности во время проектирования системы.
Методологии и принципы
- Принцип наименьших привилегий (least privilege): каждому пользователю и сервису предоставляются только те права доступа, которые необходимы для выполнения задач.
- Множественные уровни защиты: аутентификация, авторизация, шифрование, мониторинг, аудит, управление инцидентами.
- Безопасность по умолчанию (secure by default): инфраструктура проектируется так, чтобы безопасные настройки были включены «из коробки» и сложнее было снизить уровень защиты.
- Шифрование в пути и на хранении: данные шифруются при передачe по сети и в состоянии покоя. Используются современные алгоритмы и ключи управления.
- Анонимизация и псевдонимизация: данные заменяются неидентифицируемыми значениями (или заменяются токенами), когда это возможно, чтобы снизить риск идентификации.
- Управление ключами и секретами: централизованные сервисы для генерации, хранения, ротации и аудита ключей и секретов (например, динамические учетные данные под запрос).
Типы рисков
- Риск утечки или несанкционированного доступа к персональным данным.
- Риск неправильной настройки доступа и перераспределения прав (из-за сложности RBAC/ABAC).
- Риск утраты целостности данных в ходе ETL-процессов или преобразований.
- Риск лицензирования и соответствия требованиям локальных законов (GDPR, 152-ФЗ в РФ и пр.).
- Риск зависимости от конкретного поставщика и стеков технологий, приводящий к vendor lock-in.
- Риск внешних и внутренних угроз, включая инсайдерские действия и внешние атаки (SQL-инъекции, неправильные политики в Data Lake, открытые бакеты и т. п.).
Практические принципы реализации приватности в CDP
- Инфа-архитектура: выделение сегментов данных (PII, PII-ограниченные, анонимизированные) и строгие политики доступа к каждому сегменту.
- Идентификация и разрешение: создание единого профиля клиента (single customer view) через корректную идентификацию и совпадение идентификаторов, но с учётом политик приватности и возможности отнесения данных к определённой точке во времени.
- Управление данными в локализации: если закон требует локализации, хранение и обработка соответствующих данных должны происходить в регионах РФ, или через сертифицированные региональные провайдеры, отвечающие требованиям локализации.
- Непосредственная защита данных на этапе обработки: минимизация обработки персональных данных в каждом ETL-процессе, применение анонимизации или псевдонимизации перед передачей в аналитические слои.
- Контроль над экспериментами и персонализацией: тестовые сегменты и демо-данные должны быть обезличены, персонализированные рекомендации — только на основании обезличенных сигнальных данных или согласованных данных с явной коммерческой целью.
Практические примеры
Общий образ действий для CDP в BI/DWH-проекте
- Источники данных: CRM-системы, ERP, веб-аналитика, мобильные приложения, колл-центр, маркетинговые платформы.
- Ингестинг: данные поступают в конвейер через коннекторы ETL/ELT, Kafka или другие очереди сообщений. Важна поддержка форматов Parquet/ORC для эффективного хранения.
- Единый профиль клиента: применяем механизм идентификации и консолидации идентификаторов (merge по email, phone, user_id) с учетом возможной псевдонимизации.
- Хранилище: DWH для аналитики и хранилище «би» в формате столбцового хранения (Colum-oriented storage) для ускорения агрегаций.
- Материальные слои: сырые данные (raw), очищенные и преобразованные (cleansed), агрегированные (aggregated), обезличенные для BI-аналитики.
- Контроль доступа: реализуем RBAC/ABAC для каждого слоя данных, используем аудит и мониторинг активностей.
- Приватность: применяем маскирование или токенизацию для полей PII в аналитических наборов, что позволяет сохранять полезность данных без прямой идентификации.
Пример 1. Открытое решение: стек на базе Apache и открытого ПО (Open-source)
Сценарий: сбор клиентских данных из CRM, веб-аналитики и колл-центра; построение единого профиля; предоставление сегментов BI-командам без прямой передачи PII.
- Ингест: Apache Kafka как транспорт данных; Nifi — оркестрация потоков, преобразование форматов.
- Хранилище: PostgreSQL как CDS-подсистема для единообразных идентификаторов, ClickHouse как быстрый аналитический слой; Data Lake на базе S3-совместимого хранилища (minio или open-source альтернативы).
- Обогащение и обработка: Apache Spark для ETL/ELT, Spark SQL для аналитики.
- Идентификация и приватность: псевдонимизация PII через токенизацию и хеширование (SHA-256 с солью); ограничение доступа к PII через политики Row Level Security (RLS) в PostgreSQL; аудит доступа через PostgreSQL Audit или Apache Ranger.
- Управление доступом: RBAC в PostgreSQL, ABAC через внешние политики (например, через Apache Ranger для всего Hadoop-экосистемы, включая HDFS, Hive/Presto).
- Безопасность: TLS 1.2+ на каналах передачи; Vault HashiCorp для управления секретами и динамическими учетными данными к базам; шифрование на хранении — TDE в PostgreSQL; ключи в Hardware Security Module (HSM) или облачном KMS (MinIO + Vault + HSM-симуляция).
- Приватность и соответствие: политика минимизации данных, хранение только необходимых полей, регулярная вычетка и удаление устаревших данных, DPIA (evaluations of the impact on privacy) по каждому источнику.
Пример 2. Российское решение: использование локальных сервисов Яндекс.Облака (Yandex.Cloud) и локальной инфраструктуры
Сценарий: тот же набор источников данных, но часть инфраструктуры разворачивается в РФ с локализацией и соответствием локальным требованиям.
- Инфраструктура: Яндекс.Облако предлагает управляемые сервисы для баз данных (PostgreSQL, ClickHouse), сервисы для BI (DataLens), аналитическую платформу DataSphere, а также оркестрацию и потоковую обработку (Kafka, Data Transfer).
- Безопасность и доступ: IAM в Яндекс.Облаке, сегментация сетей через виртуальные частные облака (VPC), шифрование данных на хранении и в канале (TLS). Ключи управления хранением могут храниться в KMS Яндекс.Облака или локально в РФ, с соблюдением локализационных требований.
- Приватность: возможность развернуть обработку PII в локальном регионе, применить маскирование на уровне представления, использовать DataLens и DataSphere для безопасной аналитики и визуализации, сохраняя географическую локализацию данных и соблюдая требования к конфиденциальности.
- Управление доступом: RBAC на уровне Яндекс.Облака, политика доступа к данным в KMS и в хранилище; аудит действий пользователей и сервисов через встроенные журналы аудита.
- Приватность в практических сценариях: идентификация клиентов через безопасные токены, псевдонимизация и маскирование полей, хранение «маркеров» сегментов без прямого сопоставления к реальным именам в BI-средах.
Углубленный разбор механизмов защиты и практических технологий, которые применяются в CDP с BI/DWH
Аутентификация и управление доступом
- Многофакторная аутентификация (MFA) и единая входная система (SSO) для сотрудников аналитических и бизнес-отделов.
- RBAC и ABAC: роли сотрудников (data engineer, data steward, analyst, security admin) должны иметь ограниченные наборы прав. В ABAC учитываются атрибуты пользователя, контекст запроса, источник данных и режим доступа.
- Вектор доступа к данным: доступ к PII и к агрегированным данным. Важно разделить каналы доступа: аналитика BI без PII и работа с PII внутри защищенного слоя ETL-процессов.
Шифрование и безопасность данных
- Шифрование в транзите: TLS 1.2/1.3 между источниками, конвейерами и хранилищами.
- Шифрование на хранении: данные в базе и в файловом хранилище шифруются с использованием ключей, управляемых через KMS (в облаке или локальные HSM). В российских условиях можно использовать локальные решения или региональные KMS с поддержкой ГОСТ/ГИП.
- Управление секретами: HashiCorp Vault или аналогичные решения для динамических секретов (например, временные учетные данные к базам данных) и централизованного хранения ключей.
- Безопасность на уровне базы: RLS в PostgreSQL для ограничения строк отдельных таблиц в зависимости от ролей и контекста запроса; аудит SQL-запросов.
Приватность и обработка данных
- Маскирование и токенизация: PII поля—маскирование в представлениях, токены для аналитических слепков, использование детерминированной токенизации для сопоставления профилей без раскрытия исходных значений.
- Анонимизация и псевдонимизация: применение техник k-anonymity, generalization, suppression там, где аналитика не требует точной идентификации.
- Диапазоны и дифференциальная приватность: поиск баланса между точностью аналитики и приватностью. В некоторых случаях целесообразно использовать библиотеки, поддерживающие дифференциальную приватность для статистических выборок и агрегатов.
Управление данными и их качество
- Data governance: каталог данных (data catalog), линейность данных (data lineage), политики качества данных, процедуры аудитa изменений.
- Data quality checks: автоматические проверки на полноту, корректность форматов, дубликаты, несоответствия в идентификаторах.
Архитектура и инфраструктура
- Архитектура модульна: разделение ETL/ELT звеньев, слой хранения, слой аналитики, слой BI, слой приватности.
- Zero Trust: микросегментация сети, минимальные доверия к сетевым ресурсам, постоянная верификация доступа и мониторинг аномалий.
- Контроль изменений и аудит: журналирование всех операций над данными, хранение логов на безопасном носителе и врети replays для расследований.
Обеспечение соответствия требованиям
- Юридическая и нормативная база: 152-ФЗ о персональных данных ( локализация, хранение и обработка), закон о кибербезопасности, регулятивные требования к обработке персональных данных в банковской/ритейловой среде.
- DPIA: анализ воздействия на приватность для новых проектов или новых источников данных.
- Политики хранения и удаления: определение сроков хранения, безопасного уничтожения данных (data shredding) и политики архивирования.
Инструменты и решения (примерный перечень)
- Open-source: Apache Kafka, Apache NiFi, Apache Spark, Apache Flink, Apache Airflow, PostgreSQL (с RLS), ClickHouse, Vault, JWT-based SSO, TLS, GCM/CTR режимы шифрования, Apache Ranger/Knox для контроля доступа, Apache Atlas или Amundsen для дата- catalog и data lineage, MinIO в качестве S3-совместимого хранилища, Dremio или Apache Superset для BI-дашбордов.
- Российские решения и сервисы: Яндекс.Облако (DataLens, DataSphere, управляемые PostgreSQL и ClickHouse, KMS), локальные развёртывания и интеграции через региональные центры обработки данных, поддержка ГОСТ и локализации. Примерынастройки включают использование отечественных крипто-решений (КриптоПро) и локальных сертифицированных модулей.
Риски и ограничения
-
Юридические и регуляторные
- Неполное соблюдение закона о персональных данных: отсутствие DPIA, неясные правила локализации, передача данных в другие юрисдикции без согласия.
- Неправильное использование персональных данных для персонализации без явного согласия.
-
Технические
- Неправильная настройка доступа к данным PII, что приводит к утечке через журналы, копии или сбоев в конфигурациях RLS/ABAC.
- Ошибки в идентификации и объединении идентификаторов: ложные совпадения, потеря связи между профилями, дубликаты.
- Слабые ключи шифрования, устаревшие протоколы, неверная ротация ключей, проблемы с интеграцией KMS/HSM.
- Vendor lock-in: привязка к специфическим сервисам, сложности миграции при смене поставщика.
- Зависимость от качества данных: плохое качество входящих данных приводит к искажению аналитики и неверным бизнес-решениям.
-
Организационные
- Недостаточная квалификация сотрудников в области безопасности данных и приватности.
- Недостаток совместности между бизнес- и ИТ-частями, что приводит к несогласованности политик доступа и мониторинга.
- Недостаточно эффективный процесс мониторинга и реагирования на инциденты: задержки в обнаружении инцидентов, неполные отчеты.
-
Ограничения технологий
- Реализация сложных моделей идентификации и сопоставления может требовать значительных вычислительных ресурсов и продвинутых методик машинного обучения.
- Внедрение локализации данных может ограничить доступ к глобальным данным или усложнить сотрудничество с внешними подрядчиками.
- Разделение слоев данных между PII и обезличенными данными может увеличить сложность архитектуры и потребовать дополнительных процессов синхронизации.
-
Практические ограничения
- Внедрение RBAC/ABAC требует детального планирования ролей и атрибутов. Неправильная настройка может привести к излишним ограничениями или, наоборот, к утечкам.
- Обеспечение полной трассируемости (data lineage) и аудита может потребовать дополнительных средств и ресурсов.
- Поддержка отечественных решений требует адаптации к локальным требованиям и нормативной базы. Не все международные решения идеально сочетаются с российскими требованиями, поэтому часть компонентов может быть локализована и настроена отдельно.
Безопасность, доступ и приватность — неотъемлемые элементы любой архитектуры CDP в BI/DWH. Они должны быть встроены в дизайн системы на раннем этапе, а не добавлены как «последний штрих». В процессе внедрения важно сочетать теоретические принципы: least privilege, zero trust, data governance, privacy by design — с практическими решениями: шифрованием, управлением ключами, маскированием и псевдонимизацией, жесткими политиками доступа и аудитом. Российские решения и локализация данных позволяют соблюдать требования 152-ФЗ и региональных законов, но в то же время требуют внимательного подхода к совместимости услуг, управлению ключами и обеспечению достаточного уровня защиты инфраструктуры. В сочетании с открытым стеком это позволяет строить гибкую, масштабируемую и безопасную архитектуру CDP, которая поддерживает эффективную аналитику и персонализацию без компромиссной защиты приватности.
FAQ — Вопрос–Ответ
Что такое CDP и зачем он нужен в BI/DWH?
CDP — это платформа для объединения данных клиентов из разных источников в единый профиль, который затем можно использовать для сегментации, персонализации и аналитики в BI и DWH. Она обеспечивает согласованность данных, ускоряет доступ к сегментам аудитории и повышает точность аналитики за счет унифицированного профиля клиента.
Какие основные принципы безопасности важны для CDP?
Основные принципы: принцип наименьших привилегий, шифрование в транзит и на хранении, управление ключами и секретами, аудит и мониторинг действий, внедрение zero trust, privacy by design и privacy by default, управление жизненным циклом данных (очистка, удаление, архивирование).
Какую роль играет локализация данных в контексте российского законодательства?
В России закон 152-ФЗ требует локализации персональных данных и хранения данных на территории РФ, а также соблюдения условий обработки и передачи ПД. В рамках CDP это значит хранение и обработку соответствующих данных в регионах РФ или в сертифицированных центрах обработки данных с соблюдением требований локального регулирования и аудита.
Какие технологии можно считать открытым стеком для CDP в BI/DWH?
Open-source стек может включать Kafka для потоковых данных, NiFi для оркестрации, Spark/Flink для обработки, PostgreSQL и/или ClickHouse для хранения и аналитики, Data Catalog (Atlas/Amundsen) для управления данными, Vault для секретов, Apache Ranger/Knox для управления доступом, и проблемно-способности для визуализации (например, Superset) или BI‑платформы.
Какие российские решения можно применить в CDP?
Российские решения включают Яндекс.Облако (DataLens, DataSphere, управляемые базы данных и KMS), локальные развёртывания и поддержка региональных центров обработки данных, соответствующих локализации и сертификации. Это позволяет сочетать локальные требования к хранению с современными аналитическими возможностями и инструментами BI.
Какие методы защиты PII особенно важны в CDP?
Важны маскирование и токенизация полей PII, псевдонимизация и анонимизация, применение RBAC/ABAC для ограничения доступа, использование шифрования на хранении и в канале, а также мониторинг и аудит любых операций над PII. В некоторых случаях применяют дифференциальную приватность для агрегированных статистических показателей.
Как минимизировать риск утечки данных при интеграции источников?
Применяйте принцип наименьших привилегий, сегментацию доступа к данным, строгие политики доступа к PII, использование токенизации и маскирования на стадии ETL/ELT, а также аудит и мониторинг всех операций над чувствительными данными. Разграничивайте доступ к сырым данным и обезличенным данным.
Что делать, если возникает инцидент с компрометацией данных?
Немедленно активируйте план реагирования на инциденты: изолируйте подсистемы, прекратите несанкционированную обработку, проанализируйте логи и аудит, уведомите ответственные стороны и регулятора, проведите DPIA повторно, примите меры по устранению причин доступа, восстановлению целостности данных и обновлению политик безопасности.
Какие практики обеспечивают устойчивость и масштабируемость CDP в BI/DWH?
Модульная архитектура, разделение слоев хранения и обработки, автоматическое масштабирование ETL/ELT процессов, централизованное управление секретами и ключами, регулярный аудит и мониторинг, использование репликаций и резервного копирования, а также хорошая документация по политикам доступа и обработке данных.
Как начать внедрение безопасной CDP в компании?
Начните с профильной оценки: определите источники данных, типы данных, регуляторные требования и существующие политики безопасности. Затем спланируйте архитектуру с учетом локализации, настроите RBAC/ABAC, выберите подходящие инструменты (открытый стек и/или российские решения), внедрите шифрование и управление ключами, выполните DPIA и разработайте план реагирования на инциденты. Постепенно добавляйте контроль над данными, линейку аудита и мониторинга, и проводите обучение сотрудников безопасному обращению с данными.


